ContinualSkillBench:大模型智能体真能自主进化出通用技能吗?
ContinualSkillBench: Can LLM Agents Truly Evolve Their Capabilities?
赋予大语言模型(LLM)调用外部“技能库”(Skill Libraries)的能力,是让智能体走出玩具Demo、迈向复杂工作流的核心设计。从 Claude Code 到各类专业代码与业务 Agent,业内习惯预设一组由人类专家编写好的规范文档与操作脚本。然而在现实部署中,环境动态变化、专业长尾需求无穷无尽,指望人类穷尽所有技能显然不切实际。
ArXiv URL:https://arxiv.org/abs/2608.03874v1
这就引出了一个极具吸引力的构想:给 Agent 一串循序渐进的任务和环境反馈,让它在执行过程中自主沉淀、更新自己的技能库,实现真正意义上的“终身进化”。
来自北京通用人工智能研究院(BIGAI)与北京大学的研究团队在最新工作中,通过构建动态评测基准 ContinualSkillBench,对这一假说进行了严格检验。实验结论给当前火热的“自我演进智能体”泼了一盆清醒的冷水:虽然串行交互能带来平均 16.9% 的任务表现提升,但显式的“技能提炼”并没有想象中那么神效——其整体表现与单纯保留上下文反馈(In-Context Learning)几乎持平(0.602 vs 0.605)。 更致命的是,能力稍弱的模型极其容易陷入“技能碎片化”的陷阱:技能越建越多,却几乎无法被后续任务有效复用。
从零开始还是持续进化?我们需要怎样的技能基准
过去针对 Agent 技能的评测,多半采用静态设计:要么像传统基准那样提供固定工具集测最终成功率,要么像 SkillsBench 一样,对比“有人类写好的技能”与“无技能”的差距。但这种评测无法解答一个根本问题:智能体能否从长程任务流中自主提炼出跨任务复用的高阶经验?
直接微调参数进行持续学习(Continual Learning)容易导致灾难性遗忘,因此当前最前沿的落地方向是上下文持续学习(In-Context Continual Learning)。为了给这种动态演化机制提供一个严谨的试验场,研究团队构建了 ContinualSkillBench。
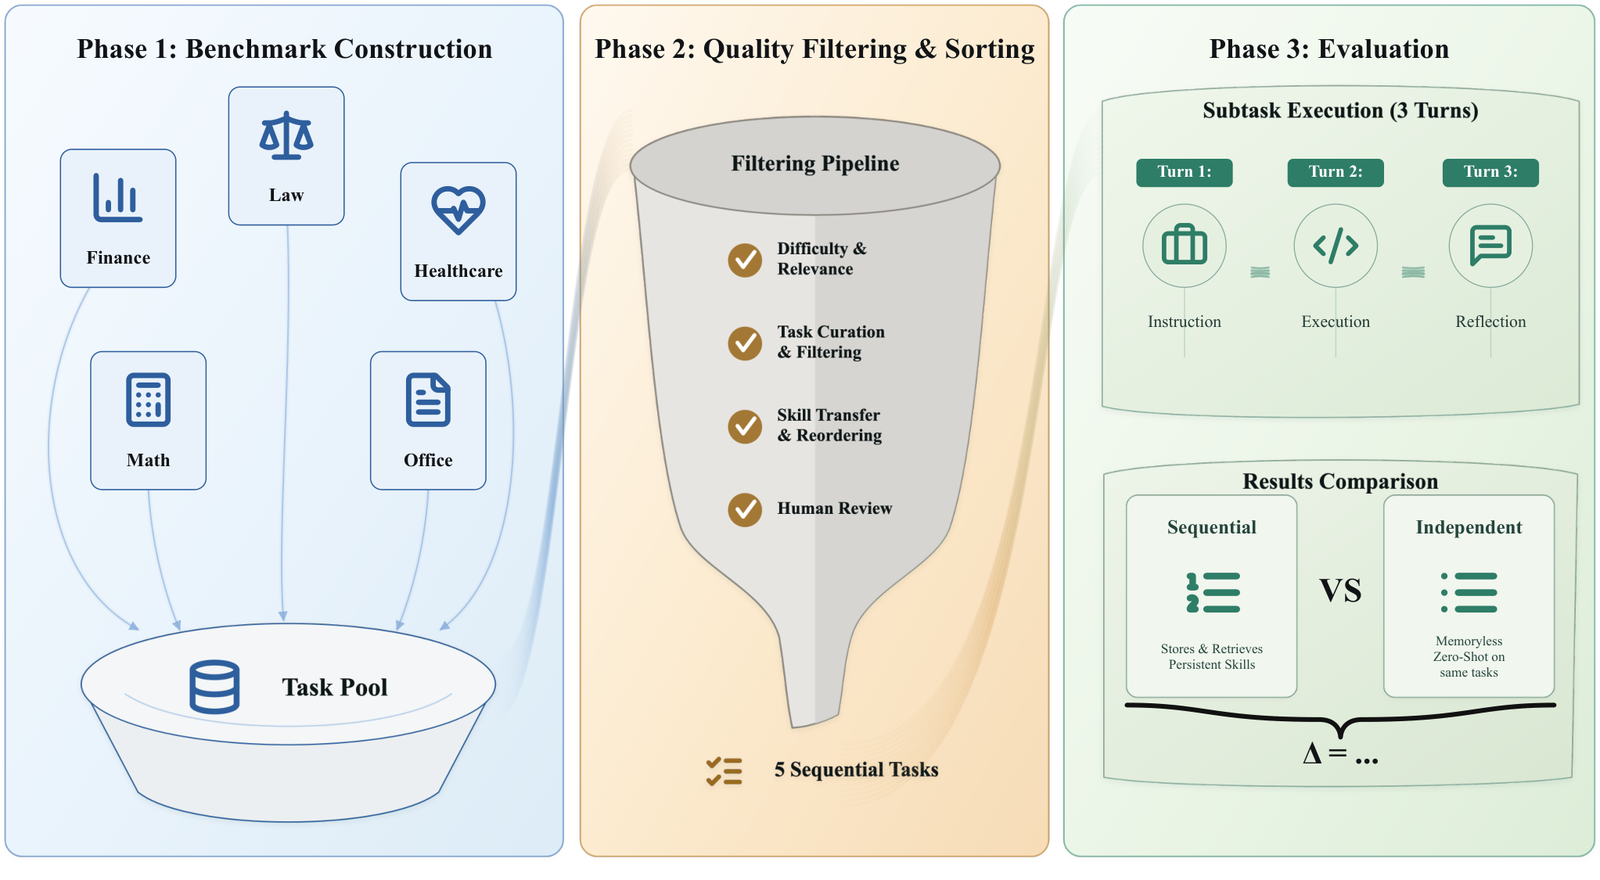
基准横跨五个极具现实价值的领域:医疗健康(Healthcare)、法律(Law)、数学(Mathematics)、金融(Finance)和通用办公(Office)。在每个领域内,团队精心挑选并编排了 100 个互相交织的子任务。这些任务并非凭空伪造,而是从 OlympiadBench、LawBench、GAIA、ClawBench 以及 OneMillionBench 等经典与高难度 Agent 数据集中抽取的混合体。
这套基准最具巧思的设计在于任务编排机制。传统的任务集合往往是打散的无序状态,而 ContinualSkillBench 假设真实技能的生长必须基于“依赖链条”。团队通过语义相似度度量(余弦相似度 $\ge 0.85$ 判定为语义对等)与有向图算法,将具有递进关系和技能复用潜力的任务排布成序列。检验表明,相较于随机排列,排布后的序列在局部历史窗口(1、5、10 步)内的核心技能重合度显著提升,真正营造出“前人栽树、后人乘凉”的认知进阶环境。
评测采用三轮交互协议(Three-Turn Protocol):Agent 接收任务和当前技能库,执行操作,获得程序或评委反馈;随后在反思阶段,Agent 可自主决定调用 Create Skill 或 Modify Skill 算子来新增或修正技能。更新后的技能库将直接下发给后续任务。
持续交互确实管用,但红利归属出人意料
评测覆盖了当前顶尖的大模型底座与 Agent 框架,包括 GPT-4o、GPT-5.3-Codex 以及 Claude 4.7 Opus。通过对比“从零独立执行每项任务(Independent)”与“保留经验的串行持续执行(Sequential)”,实验揭示出数个反常识的现象。
首先,串行执行确实能显著提效。在 15 组“模型—领域”组合中,有 14 组在归一化奖励(Normalized Reward)上实现了正增长,宏观平均绝对提升为 $+0.078$,相对于独立基线实现了 16.9% 的相对涨幅。其中,医疗领域表现最为抢眼,跨模型的平均归一化提升达到 $+0.149$;金融、法律、办公和数学的平均提升则在 $+0.052$ 到 $+0.076$ 之间。
但接下来的分歧打破了“模型能力越强、进阶获益越大”的常规假设。基线能力最强的 Claude 4.7 Opus,其平均归一化改善幅度仅有 $+0.058$,甚至在数学领域出现了负增长($-0.008$);相反,GPT-5.3-Codex 拿下了全场最高的改善增量($+0.098$);而底座能力略逊的 GPT-4o 也刷出了 $+0.077$ 的提升。这说明,利用过往经验持续进化的潜力,并不单纯由静态的解题底座能力线性决定。
更具启发性的发现来自于消融实验:持续进化的红利,究竟来自那套被赋予厚望的“显式技能库”,还是仅仅来自于上下文中保留的历史交互与错误反馈?
研究人员在法律、金融和医疗三个领域设计了纯上下文学习(Pure ICL)对照组——让模型经历完全相同的任务流和反馈机制,但不提供创建与修改技能文件的接口。结果令人吃惊:
GPT-5.3-Codex 在显式维护技能库时的归一化得分为 0.602,而在纯 ICL 模式下则是 0.605,二者平均性能基本持平。
细分任务类型的表现差异揭示了底层机理:
在有明确规则和刚性格式要求的任务中(例如法律和金融的精准匹配 Exact Match,以及医疗中需要操作工具的程序化评测 Programmatic),显式技能库优势明显,医疗程序任务的准确率直接从 0.250 跃升至 0.500。技能文件以文档形态固化了规范步骤,起到了类似“标准化作业程序(SOP)”的锚定作用。
但在开放度较高、采用自由评分准则(Rubric)的任务中,纯 ICL 却全面反超。显式沉淀出的技能文档,往往带有过拟合早期任务评估标准的痕迹;当面对下游需要发散分析的复杂场景时,这些死板的“规矩”反而变成了束缚 Agent 推理的认知包袱。
越弱的模型,越容易被“技能垃圾”淹没
如果说高阶模型还能在某些刚性任务中借技能库获益,那么观察模型在维护技能库时的动态行为,则暴露了当前智能体架构更深层次的缺陷。
实验统计了不同模型在完成五个领域共 500 个子任务后的技能演变轨迹,对比极其鲜明。
GPT-5.3-Codex 在整个任务流中总计仅生成了 205 个技能,且这些技能在后续任务中被检索、调用的频率非常高。它展现出了某种程度的“归纳合并能力”,倾向于将多次尝试总结为结构紧凑、跨任务通用的程序模块。
与之形成剧烈反差的是 GPT-4o。它在全流程中疯狂堆叠出了 384 个技能文件,几乎快达到前者的两倍。然而,这些技能在生成后极少在后续子任务中被再次唤起。
这种现象被研究团队定义为技能碎片化(Skill Fragmentation)。能力相对薄弱的 Agent 缺乏将具体问题提炼为高阶抽象的能力,它把每一次报错、每一个特定参数的修补,都当成了“一项新技能”强行写入库中。其结果就是技能库急剧膨胀,内部充斥着高度狭隘、互相孤立且语义重叠的“一次性策略”。
庞大且劣质的技能库不仅没有扩展 Agent 的能力边界,反而在后续检索时引入了巨大的上下文噪声,大幅加重了决策检索的负担。这种“贪多嚼不烂”的特征,正是阻碍 Agent 走向自主进化的核心瓶颈。
终身进化的下一站
ContinualSkillBench 的测试结果向整个 AI 智能体社区传达了一个清晰的信号:当前的 Agent 架构确实可以通过与环境交互持续适应环境,但离真正的“经验沉淀与跨任务抽象”还有很大距离。
简单地塞给模型两个 Create Skill 和 Modify Skill 提示词,并不能奇迹般地催生出类人的学习机制。很多时候,所谓的能力提升只是大模型依靠庞大上下文窗口,对近期历史反馈做出的即时自适应。而在缺乏高质量抽象、去重与重构机制的前提下,盲目追求“自主维护技能库”,甚至可能演变成一种算力与上下文空间的负资产。
未来的自演化 Agent 如果想要突破这一瓶颈,不能仅停留在“单任务结束后写总结”的初级逻辑,而必须引入更严苛的技能生命周期管理——包括跨任务的主动归纳抽象、技能冲突检测、冗余合并与定期修剪淘汰。只有当模型懂得何时拒绝把琐碎经验当成“技能”时,真正的自主进化才算拉开序幕。