IBM提出BONSAI:不是死磕单次高分,而是靠“可进化性”树搜索让Agent涨23分
BONSAI: Evolvability-Guided Tree Search over Skills
对于权重被冻结(Frozen)的大语言模型 Agent 来说,如果无法通过梯度下降来学习新经验,唯一的进化途径就是上下文中的那份“技能文档”(Skill)。这份文档不是简单的提示词模板,而更像是一本写满踩坑指南、调用规范和校验逻辑的操作手册。
ArXiv URL:https://arxiv.org/abs/2608.07056v1
既然模型权重纹丝不动,开发者能优化的对象就只剩下这份文本。以往自动优化技能的通行做法非常直观:让优化器大模型看一看执行失败的案例,重写一段文本,只要在验证集上的单次测试分数变高,就采纳这次修改。然而,IBM Research 最近发表的研究指出,这种被广泛采用的贪心搜索存在致命盲区——它只能看见分数的绝对高低,却看不出这个分数是站在一个极易崩溃的“过拟合尖峰”(Narrow Overfit Spike)上,还是坐落在一个经得起反复修改的“平坦高地”(Broad Plateau)上。
针对这一问题,IBM Research 推出了名为 BONSAI 的技能优化框架。它不再单纯依据当前分数的绝对值来分配算力,而是引入了演化生物学中的可进化性(Evolvability)概念,以蒙特卡洛树搜索(MCTS)的方式管理技能文档的突变。在完全不增加额外推理调用的前提下,BONSAI 让冻结的 30B 代理在三项基准测试中平均提升了 $23.13$ 个百分点,并在严格对齐调用预算的情况下,稳稳压过了此前的顶尖方案 GEPA 和 SkillOpt。
为什么“只要变好就保留”是条死胡同?
要理解 BONSAI 的切入点,必须先看透传统优化流程的软肋。在面对有限的验证任务时,一个获得 70 分的技能文档可能存在两种截然不同的地貌:第一种是在该文档周围的绝大部分细微改动,依然能稳定拿到接近甚至超越 70 分的表现;第二种则是该文档恰好撞上了某些特定样例的巧合,稍微改动一个词,分数就会雪崩式跌到 40 分。
后一种状态就是典型的尖锐局部极值。在以“修补”为核心的代码编写或长流程规划中,这种现象尤为致命。优化器往往为了修好当前批次的某一个边缘错误,在技能文档里强行打上一块特异性极高的补丁。在单次验证下,这块补丁看起来让总分上涨了一点,但它极度脆弱(Brittle),彻底破坏了文档在其他潜在场景下的鲁棒性。后续的优化一旦基于这个尖峰继续展开,便会陷入“拆东墙补西墙”的恶性循环,整个搜索树很快便走入死胡同。
传统的优化理论早就证明,在参数空间中,平坦极小值(Flat Minima)的泛化性能通常远胜于尖锐极小值。生物学在审视物种演化时,也会把一个谱系在面临基因突变时能否持续产生有益变异的能力——也就是“可进化性”——与个体当前的适应度(Fitness)明确区分开来。然而,在以自然语言为载体的提示工程与技能优化领域,此前始终缺乏一种既能度量可进化性、又不会成倍消耗调用预算的搜索机制。
零成本度量:如何把整棵搜索树变成传感器?
测量一个文本区域的变异稳定性,最直观的暴力解法是对该文本进行大量轻微改动并逐一打分,但这会导致大模型推理成本暴增数倍。BONSAI 巧妙之处在于:它没有为了度量可进化性而发起哪怕一次额外的 API 调用,而是直接把树搜索的结构本身变成了评估工具。
在 BONSAI 中,每个子节点都是父节点文本的一次“突变”(Mutation)。记节点 $n$ 自身的验证集得分为 $v(n)$,其子树中所有已访问并完成评估的变异子孙节点集合为 $\mathcal{L}(n)$,子孙节点总数为 $m(n)$。BONSAI 将该节点所在邻域的可进化性估值 $Q(n)$ 定义为该子树下所有后代节点的平均得分:
\[Q(n)\;=\;\frac{1}{m(n)}\sum_{s\in\mathcal{L}(n)}v(s)\]基于这个定义,父节点原本的得分与扰动后代均值之间的差值,便精确刻画了该节点的“脆弱度”(Brittleness):
\[\sigma(n)\;=\;v(n)-Q(n)\]如果 $\sigma(n)$ 很大,说明该节点虽然自身看似高分,但其后代变异后分数大幅回落,属于不稳定的尖峰;反之,若 $\sigma(n)$ 维持在低位甚至为负,则表明这片文本空间极具韧性,后继变异持续产出高分。更关键的是,公式中的每一个分值 $v(s)$ 都是搜索流程本身必须评估的常规开销。随着树搜索向纵深展开,被访问越多的节点,其 $Q(n)$ 的估算就会以无额外成本的方式自动变得更加精准。
引导与探索:改良版 UCB 树搜索机制
有了可进化性指标后,搜索预算该如何下注?BONSAI 采用了类似 AlphaGo 和 MuZero 的上置信界(UCB)策略,但在利用项(Exploitation)上做了根本性替换。从根节点向下选择路径时,每一层选择子节点 $s$ 的准则为:
\[U(s)\;=\;v(s)+\lambda\bigl(Q(s)-v(s)\bigr)+c\,\sqrt{\frac{\ln N(p)}{N(s)}}\]其中 $N(\cdot)$ 代表节点的访问次数,$p$ 是 $s$ 的父节点。参数 $\lambda$ 控制着引导信号的偏向:当 $\lambda=0$ 时,算法退化为只看当前分数的传统贪心搜索;而在默认设定的 $\lambda=1$ 下,利用项完全由 $Q(s)$ 主导,意味着算法将彻底由区域的可进化性来牵引搜索方向。
为了防止不同任务间的分数跨度打乱探索节奏,BONSAI 借鉴了 MuZero 的动态归一化技巧,将利用项动态缩放到 $[0, 1]$ 区间,从而让超参数 $c$ 在面对各类不同难度的基准测试时都能保持稳定的尺度不变性。公式右侧的标准探索项则保证了即使某个分支初期的变异表现平平,只要访问次数较少,依然有翻盘被重新选中的机会。
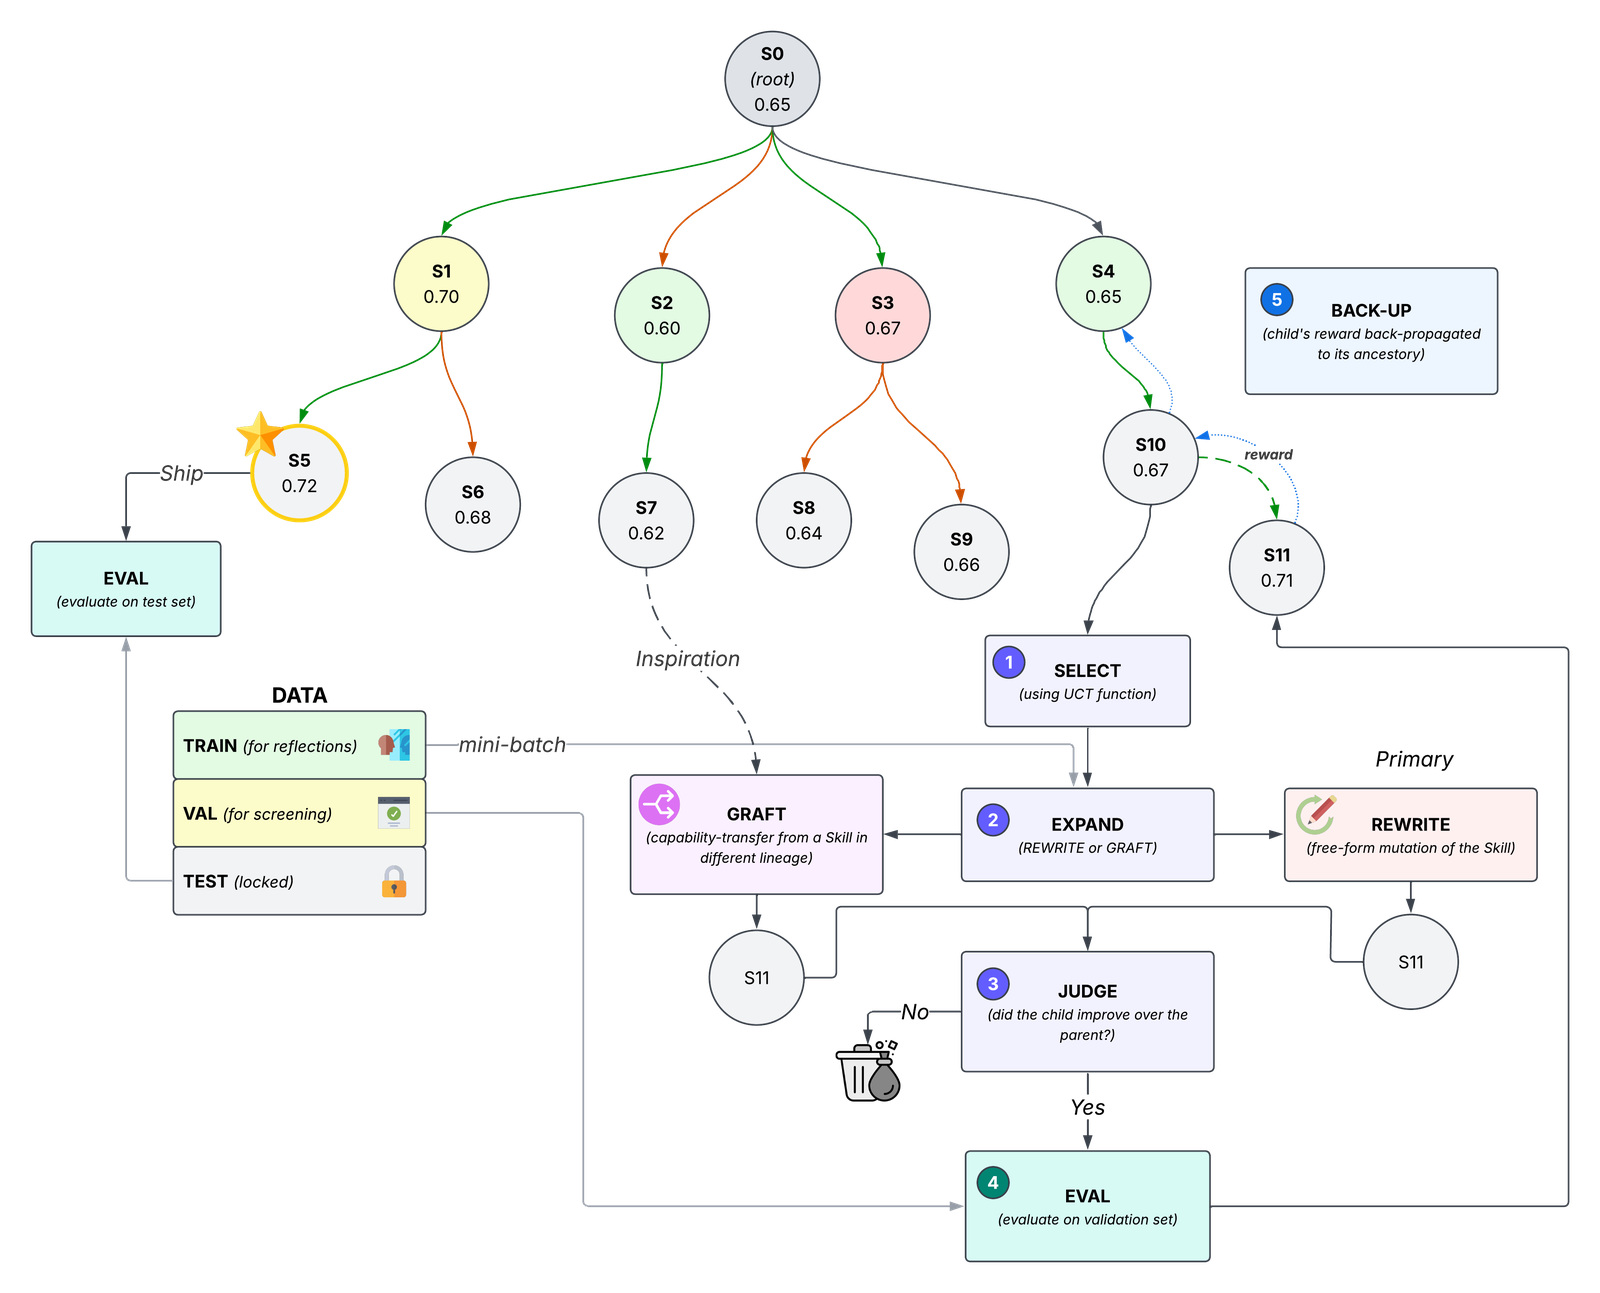
在节点展开与备份阶段,BONSAI 同样设立了严谨的保护机制。优化器针对一批训练错题提出改写提案后,必须严格在该训练批次上超过原节点得分才会被系统接纳;一旦被接纳,才会在完整验证集上计算 $v(c)$ 并向祖先节点回传分数累加 $W(a)$ 与样本计数 $m(a)$。如果提案未能通过初筛,算法只给祖先节点的总访问数 $N(a)$ 加一,并不污染 $m(a)$ 和 $W(a)$。这种将“探路失败的试错成本”与“被证实的价值样本”严格隔离的设计,防止了偶发的改写失败连带拖垮本来优秀的语义区域。
最后,当总调用预算耗尽时,BONSAI 采取了“引导归引导,部署归部署”的解耦策略:直接部署整棵树中验证集绝对得分最高的那份单篇文档 $\arg\max_n v(n)$。研究团队特别指出,决不能在最终部署时用脆弱度 $\sigma$ 去打折扣,因为被深入探索的优秀节点其 $\sigma$ 是清晰可见的,而未经探索的边缘叶子节点 $\sigma$ 看起来反而很小,若在交付时惩罚脆弱度,实质上是在倒奖励“无知”。
破除孤岛:不对称的 GRAFT 能力迁移
在树搜索的推进过程中,容易出现另一个瓶颈:不同谱系各有所长。例如,分支 A 学会了处理日期格式但搞不定嵌套公式,分支 B 搞定了嵌套公式却丢失了日期处理能力。常规的单节点重写很难解决这个问题,因为负责改写的优化器每次只能看到当前节点的错误,根本不知道整棵树的其他分支里已经蕴含了解药。
为此,BONSAI 设计了一个可选的非对称移植算子 GRAFT。当选定节点 $A$ 遇到瓶颈时,系统会从树的其他分支中寻找一个在 $A$ 失败的任务上表现出色的供体节点 $B$,让优化器将 $B$ 的能力补充进 $A$ 中。
值得注意的是,GRAFT 被严格设计为一种非对称注入:它并不是把两份文档暴力拼接或做传统遗传算法的对称交叉,而是把供体 $B$ 纯粹当作“解题证据”提供给 $A$。生成的新文档依然作为 $A$ 的直系子节点加入树中,供体 $B$ 不会继承任何访问计数与价值反向传播。这一设计巧妙地打破了谱系之间的能力孤立,同时完全保留了树搜索统计量原有的数学一致性。
实验印证:算力对齐下的真正领先
为了验证可进化性引导的真实威力,研究人员选用了三个极度考验 Agent 遵循规范与推理能力的硬核评测集:
-
SpreadsheetBench:根据自然语言指令编写 Python 脚本修改 .xlsx 表格,沙箱执行后逐单元格比对,要求绝对客观的全对;
-
SearchQA:结合检索片段完成问答,以标准完全匹配(Exact Match)为准;
-
LiveMathematicianBench:高难度数学命题的单选判断。
实验中的被操作执行者(Performer)全程采用完全冻结的 granite-4.1-30b,优化器大模型则统一使用 DeepSeek-V3.2。对比基线不仅包含无技能的裸跑模型和初始种子文档,还引入了 prompt 演化强基线 GEPA 以及将技能视为可训练状态的 SkillOpt。所有基准均在严格对齐的、真实的被操作模型调用次数(Rollout)上限下运行,彻底排除了算力堆叠带来的虚假增益。
| 测试基准 | Performer 算力预算 | 无技能 (No-Skill) | 种子技能 (Seed) | GEPA 基线 | SkillOpt 基线 | BONSAI (基准版) | BONSAI + GRAFT |
|---|---|---|---|---|---|---|---|
| SpreadsheetBench | ~2400 rollouts | 7.50% | 17.50% | 21.07% | 20.00% | 23.21% | 25.00% |
| SearchQA | ~18,000 rollouts | 72.50% | 72.43% | 78.29% | 75.57% | 79.00% | 78.93% |
| LiveMathematicianBench | ~3000 rollouts | 17.74% | 28.23% | 56.14% | 59.65% | 64.91% | 63.16% |
在三项基准上,BONSAI 产出的技能文档相较于没有任何技能引导的 Agent,平均带来了 23.13 个百分点的巨大泛化提升;相比同等预算下最强的 baseline,也分别取得了 2 到 5 个百分点以上的明确超额收益。当在分工差异显著的 SpreadsheetBench 上开启 GRAFT 移植算子时,性能更进一步冲到了 25.00%。
更具说服力的是针对可进化性信号本身的消融实验。在保持树结构、初筛阈值、部署策略完全一致的前提下,研究团队强制将公式中的 $\lambda$ 置为 0,也就是让搜索退回到只追逐当前单次高分的纯贪心模式:
-
在 SpreadsheetBench 上,贪心模式在第 20 轮验证分达到 0.200 后便彻底停滞,而 BONSAI 的可进化性搜索一路攀升,在第 95 轮推至 0.275,最终测试集差距拉开 +3.21%;
-
在 SearchQA 上,贪心模式在第 13 轮(0.760)止步,可进化性模式则在第 23 轮摸到 0.775,测试集胜出 +2.14%;
-
在 LiveMathematicianBench 上,贪心模式在第 16 轮(0.700)见顶,而 BONSAI 在第 43 轮冲上 0.750,最终测试集领先幅度高达 +7.02%。
这一组对比直接坐实了一个结论:以往技能优化之所以迅速撞墙,核心原因就是贪心搜索过早把预算耗尽在那些虚高的尖峰上,误把死胡同当成了终点;而以可进化性为准绳的搜索,能够持续穿透假象,找到真正具备衍生潜力的优质语义高地。
总结与启示
在庞大参数量的模型由于私有化部署、微调代价高昂或 API 黑盒等限制而不得不保持冻结状态的背景下,自然语言形式的“技能”与“系统提示词”事实上承担起了模型策略更新的全部职责。
BONSAI 的价值不仅在于刷新了几个基准评测的分数,更在于它指出了提示工程与 Agent 优化在方法论上的一个长期误区:文本优化的目标,绝不应是去拟合那份静态的验证集并赌一个偶发的高分,而是要让优化过程始终行进在容错率高、可塑性强的语义地貌中。 将演化生物学对可进化性的理解,零额外成本地移植进大模型的蒙特卡洛树搜索之中,为未来构建长期自演化、自适应的复杂 Agent 系统提供了一条极具说服力且成本可控的技术路径。