TART:拆解多语言Agent规划塌陷,跨11种语言准确率提升5.6%
An Actionable Diagnosis of Multilingual, Multi-Agent Planning Failures
当大语言模型被封装进复杂的多智能体(Multi-Agent)系统,承担起调用外部工具、浏览网页、处理异构文档的长链路任务时,一个长期被掩盖的问题开始显露:一旦用户的提问脱离英语,系统的执行崩溃率就会陡增。很多开发者直觉上会把这种衰减归咎于基础模型的跨语言理解底座不够扎实,或是下游工具执行时的翻译失真。
ArXiv URL:https://arxiv.org/abs/2608.03735v1
Cohere 与富士通的研究团队在这篇论文中揭示了一个更本质的问题根源:多智能体系统的跨语言溃败,主要发生在“需求转化为可执行计划”的边界上。即便后续的子智能体具备完备的工具使用与代码执行能力,如果顶层的规划器(Planner)在理解非英语输入时丢失了关键的实体、时间或操作顺序约束,整个系统就会沿着一张方向完全偏离的蓝图持续空转。
为了系统性诊断并逆转这一现象,研究团队提出了一个包含五大维度的“规划对齐失败”(Planning-Grounding Failure)分类体系,并在此基础上设计了轻量级缓解协议 TART(Taxonomy-Guided Actionable Representation)。在无需微调任何模型权重、也不重构现有智能体框架的前提下,TART 在涵盖高、中、低资源的 11 种语言 GAIA-MAPS 基准测试中,将顶尖 Agent 系统 OWL 的端到端准确率平均提升了 5.6 个百分点;在更受控的表格多步推理基准 MULTITAT 上,更是带来了高达 47.6% 的相对性能提升。
多语言多智能体的系统性“偏航”
多智能体架构的核心逻辑,通常是由一个负责全局统筹的规划器充当用户界面。它负责将自然语言需求拆解为结构化子任务,再交由协调器(Coordinator)指派给专业的网页搜索、代码执行或文档处理 Worker。这一设计在英语环境中运行良好,因为规划器能够精准捕捉提问中隐含的约束条件。
但在面对非英语、特别是训练语料相对匮乏的中低资源语言时,规划阶段的语义流失会被剧烈放大。论文将这类问题严格定义为“规划对齐失败”(Planning-Grounding Failure):用户请求与生成的计划之间存在语义错位,以至于即使后续所有子步骤都被百分之百完美执行,最终交付的结果也无法满足原始需求。
这种失真在多智能体流水线中具有不可逆的破坏力。规划器位于整个调用链的最上游,一旦它把核心实体替换成了相似概念、漏掉了特定的年份范围,或是把依赖关系颠倒,后续无论配备多么强大的执行器,都只能在错误的航道上做无用功。
五大维度:为规划失败建立可操作的病理切片
以往针对智能体错误的研究大多停留在英语环境下的表面分类,如工具调用语法错误、幻觉或是死循环。为了穿透多语言语境下的真实病灶,研究人员先在与后续评测完全隔离的开发环境(基于 Cohere Aya-Expanse-32B 和 Qwen2.5-32B-Instruct)上,对 80 个涵盖伊博语(Igbo)、约鲁巴语(Yoruba)、孟加拉语(Bengali)、斯瓦希里语(Swahili)等低资源语言的真实失败案例进行了饱和式定性分析,最终收敛出五类核心的对齐失败维度。
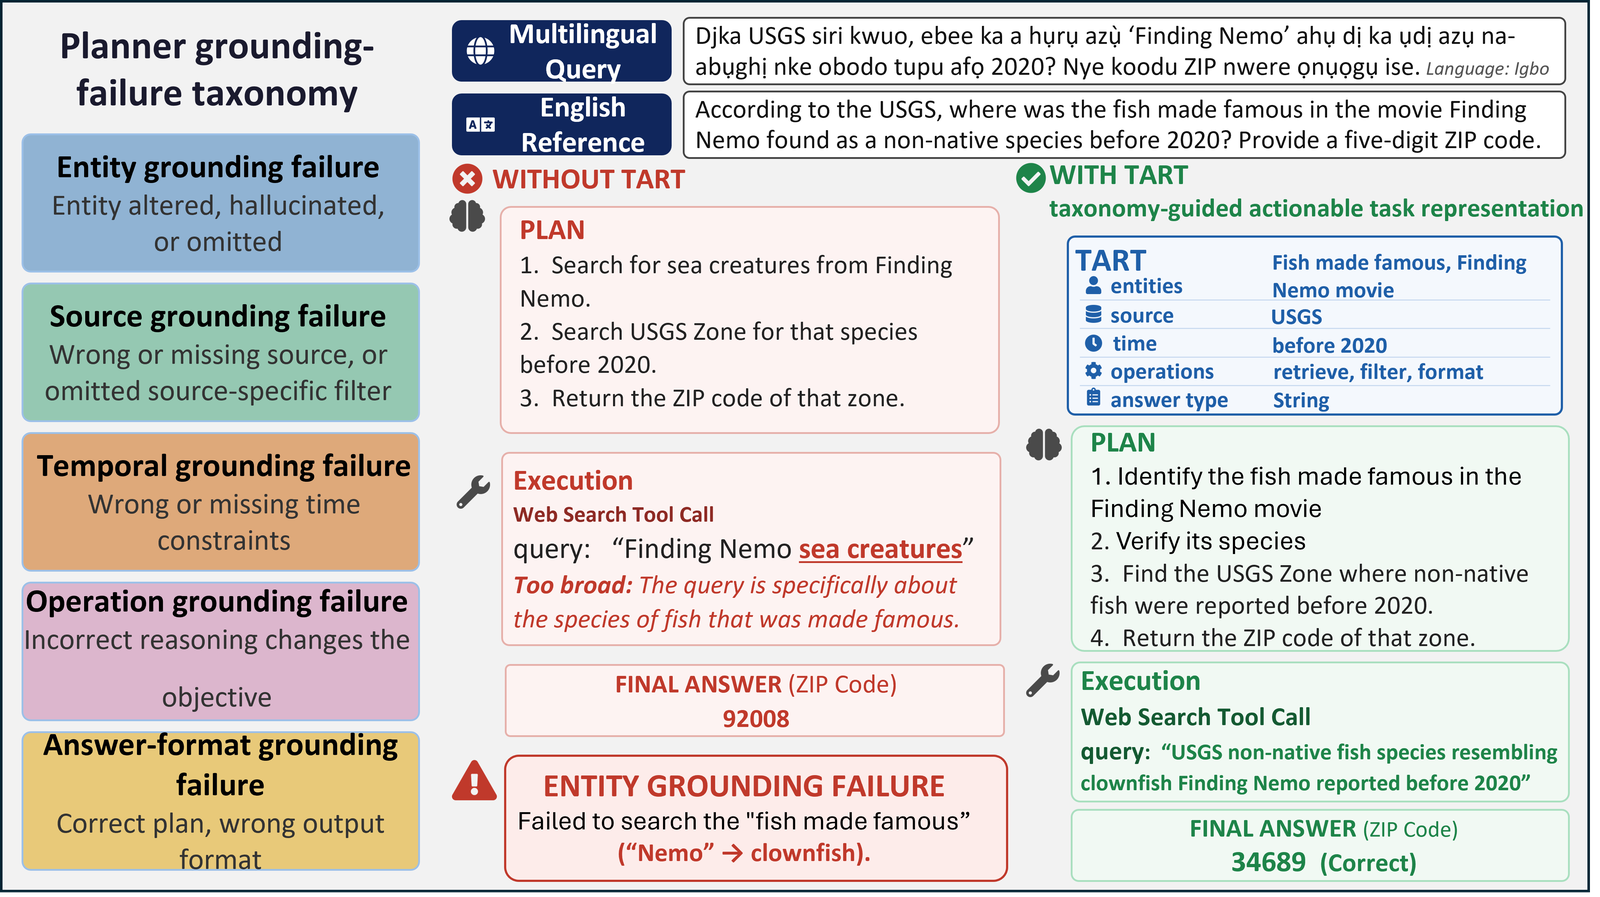
这五大维度构成了智能体从用户指令向动作蓝图转化时必须兑现的“语义契约”:
-
实体对齐(Entity Grounding):规划器未能准确保留、翻译或解析提问中的核心实体。例如在处理伊博语关于特定水文地理的查询时,规划器未能解析出隐含的目标地名,导致检索步骤直接指向了宽泛甚至错误的数据库。
-
数据源对齐(Source Grounding):遗漏了用户明确指定或任务强依赖的信息源,例如要求在特定官方站点或某份指定 PDF 中寻找答案,但计划中却将其泛化为通用网页搜索。
-
时间对齐(Temporal Grounding):丢失或篡改了时间范围、基准截止日期,导致智能体检索到时效失效的数据。
-
操作对齐(Operation Grounding):任务拆解后的逻辑步骤序列出现严重偏差。常见表现为跳过了前置的归一化步骤、颠倒了过滤与汇总的顺序,或是直接漏掉了多跳推理中不可或缺的中间算子。
-
输出格式对齐(Answer Formatting):未能遵守最终答案的单位、精度、结构化排版等格式约定。
研究团队指出,这套分类法的核心价值不仅在于“诊断出系统坏了”,更在于它是“可操作的”(Actionable)——每一个维度都直接指向了规划器应该补齐的具体信息,为后续的程序化修正提供了明确靶点。
语言资源越匮乏,结构化规划失败占比越高
为了验证这套分类体系在更大规模跨模型、跨语言场景下的通用性,研究团队构建了基于 LLM-as-a-Judge 的自动化评判管线,并通过 6 位专业标注员对 122 个样本进行双盲人工验证,取得了高达 0.906 的 Macro-F1 值,证实了自动化判别的可靠性。
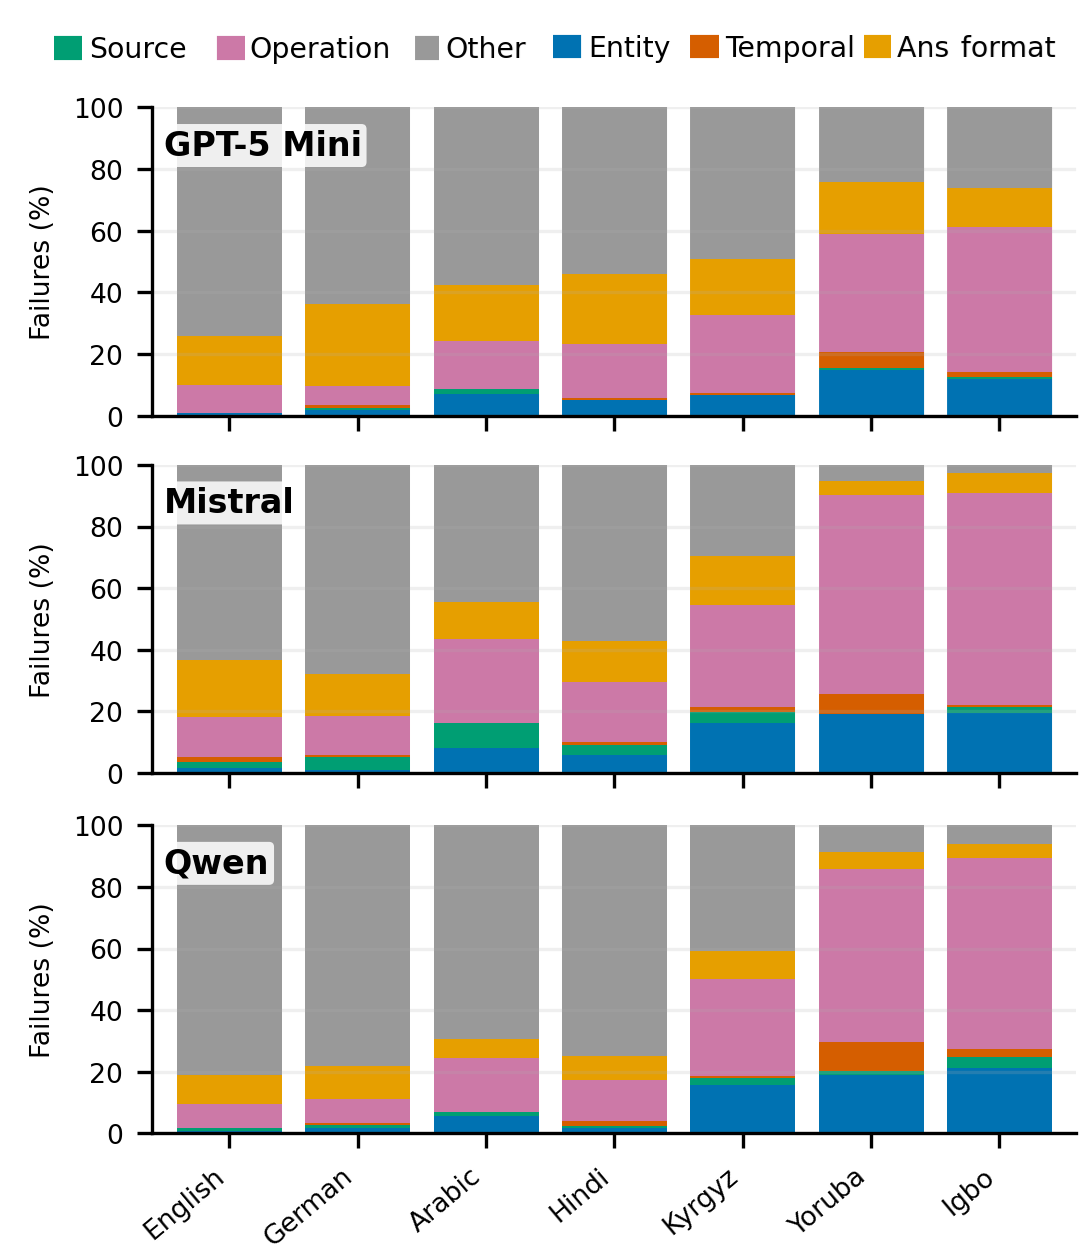
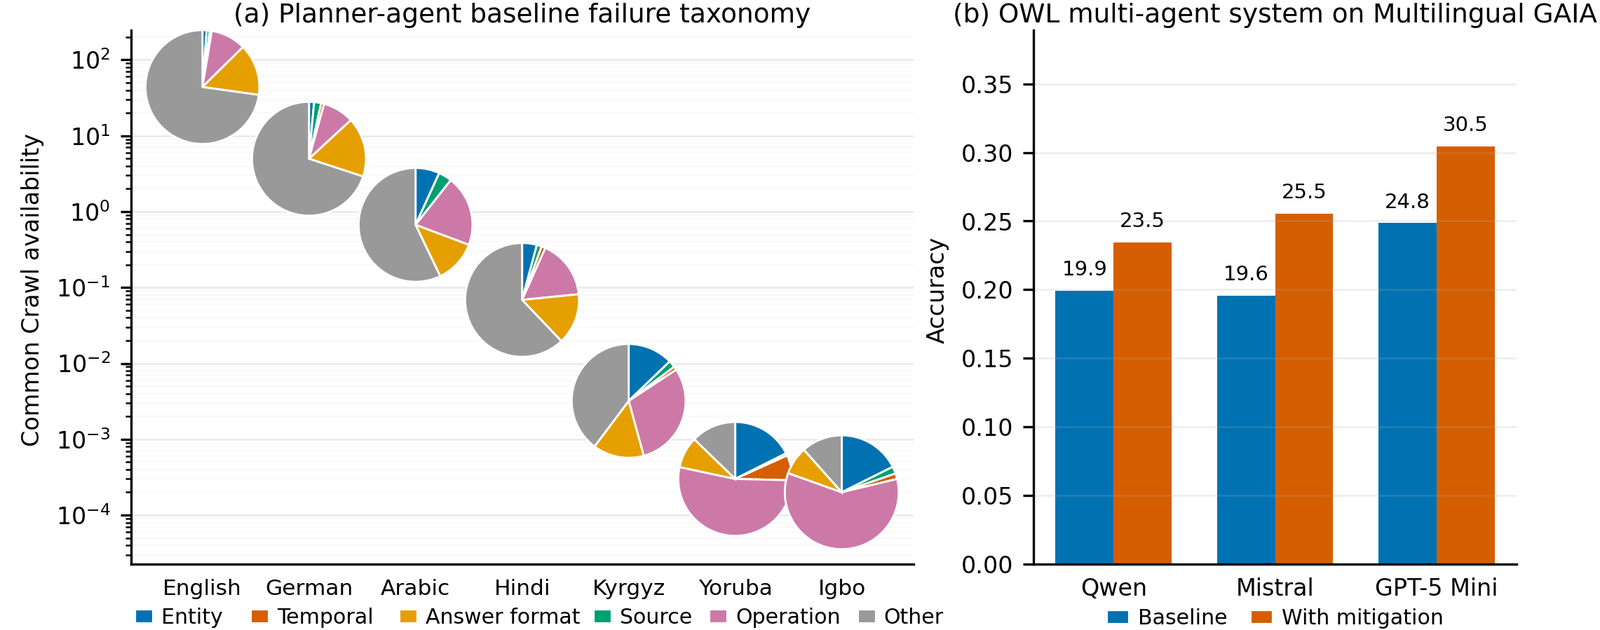
对 GPT-5-mini、Mistral-Large-3 与 Qwen3-VL-235B 在 GAIA-MAPS 上的大规模基线失败案例进行统计后,展现出一个极其鲜明的“资源梯度效应”:
随着语言在 Common Crawl 语料库中的资源丰富度从高到低递减,那些无法归类的泛化残差错误(Other failures)占比显著下降,而本文定义的五类规划对齐失败所占的份额却持续攀升。特别是在低资源语言(如吉尔吉斯语、约鲁巴语、伊博语)中,操作对齐失败(Operation Grounding)急剧膨胀,成为了最致命的单类错误,在 Mistral-Large-3 和 Qwen3-VL-235B 的低资源失败样本中甚至占据了绝对多数;实体对齐失败的占比也同步扩大。
这一规律表明,多语言智能体在面对小语种时出现的性能崩溃,绝非不可捉摸的随机幻觉,而是具有高度一致性的结构性失灵:模型丢失了对多步推理算子序列的构建能力,以及跨语言准确锚定实体概念的能力。
TART:把分类法转变为跨Agent的“语义契约”
明确了病灶所在,论文顺理成章地提出了缓解方案 TART(Taxonomy-Guided Actionable Task Representation)。其设计哲学非常克制:不重新预训练模型,不在外部挂载沉重的启发式检索规则,而是在输入进入规划阶段前,先进行一次专门针对上述失败维度的语义解析,生成一份显式的结构化任务描述。
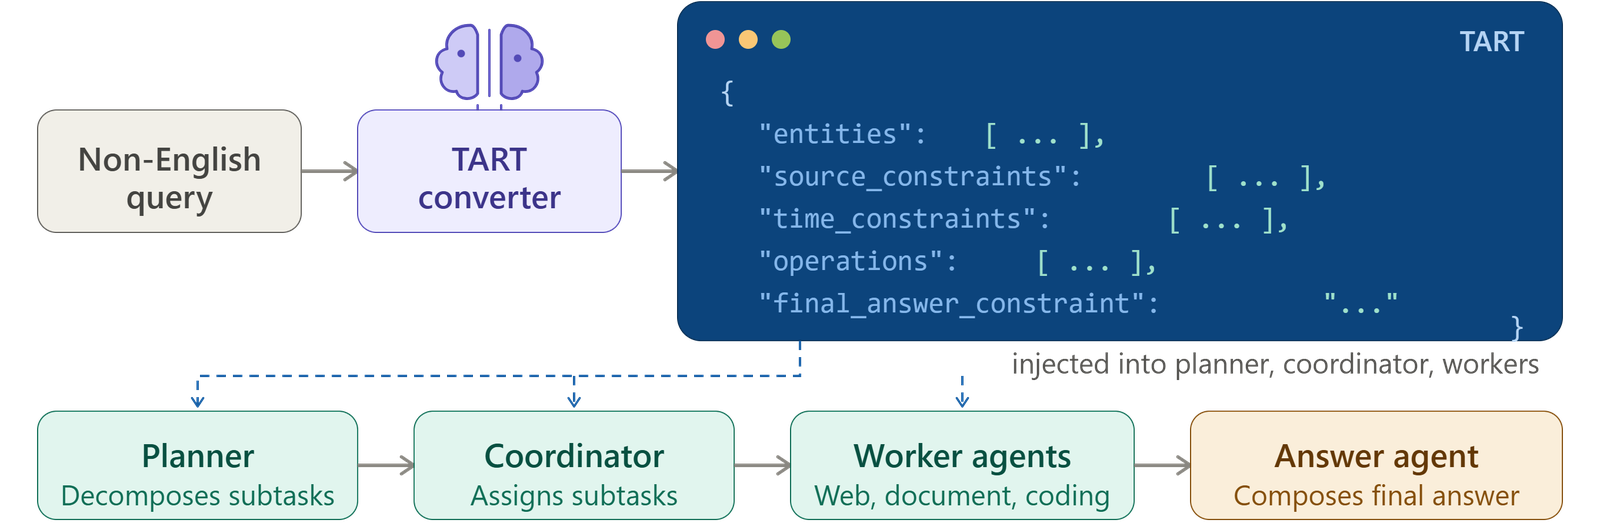
当用户提出一个非英语 Query 时,系统首先调用大模型将其解析为标准化的 TART 结构,该结构严格对应分类体系中的关键字段,显式提炼出:
-
目标实体与代词指代消歧(Entities);
-
指定的数据来源与检索路径(Sources);
-
严格的时间与时效边界(Temporal constraints);
-
达成目标必须经历的原子操作序列(Operations);
-
最终答案必须满足的约束(Format/Constraints)。
这一结构化表示的作用绝不仅限于一次性辅助规划。在多智能体流水线中,TART 会与原始 Query 并行,被持续注入到规划器(Planner)、协调器(Coordinator)以及下游各类垂直 Worker(Web Agent、Document Agent、Code Agent)的 System Prompt 中。
这种贯穿全程的注入机制建立了一种“语义契约”。规划器依据清晰的操作字段拆解子任务;协调器依据显式的实体与数据源约束进行分发;执行智能体在展开多轮推理与工具调用时,始终能看到原始诉求的硬性边界,从而有效阻断了跨语言信息在多轮调用中的逐步漂移与稀释。
实验印证:高低资源全线反弹,小语种收益尤为显著
为了评估 TART 的实际效能,论文选用了两个极具代表性的评测基准:包含高度开放、多模态复杂任务的 GAIA-MAPS(覆盖 11 种语言),以及专注长程表格推理的 MULTITAT(覆盖 10 种语言)。
在 GAIA-MAPS 上,以当前针对 GAIA 任务表现优异的多智能体框架 OWL 为基座,搭载 GPT-5-mini 作为核心模型,TART 在 11 种语言中的 10 种均取得了显著提升,全语言平均绝对准确率提升了 5.6 个百分点(从基线的 24.9% 提升至 30.5%)。
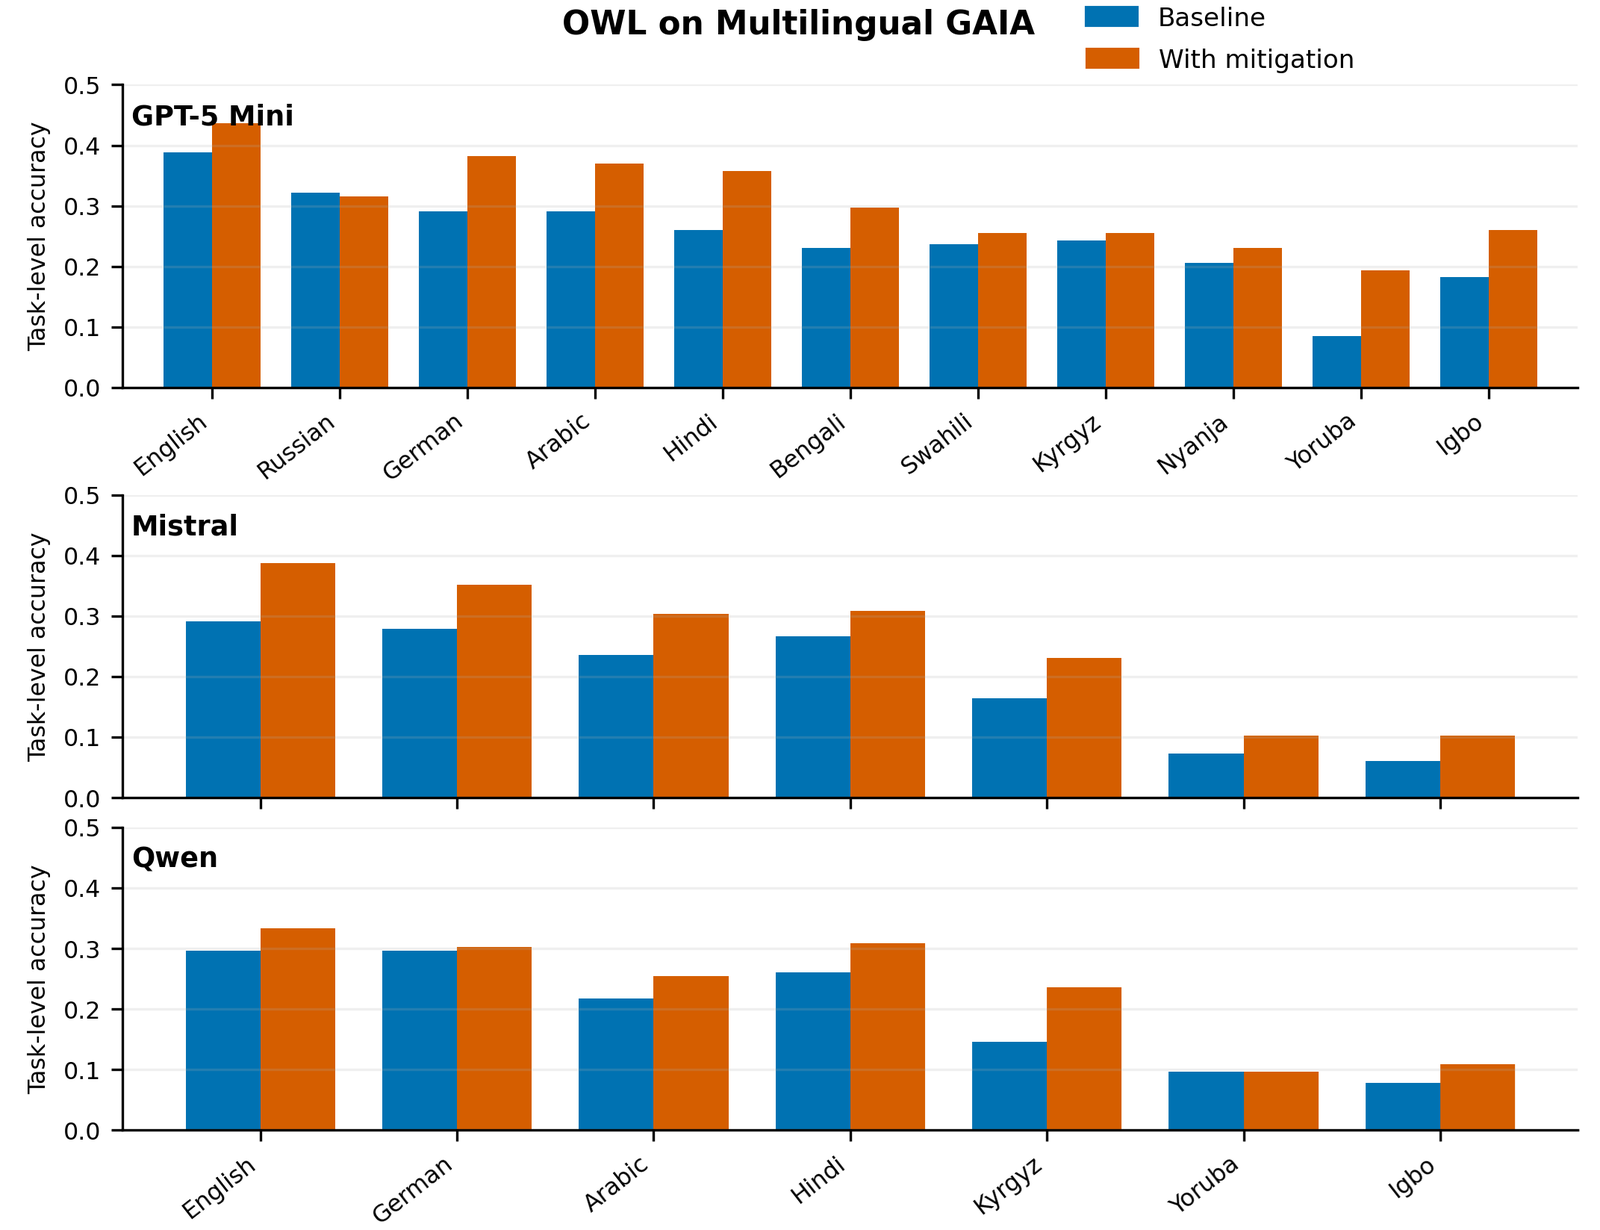
细看语言分布,这种提升不仅出现在德语(+9.1)、印地语(+9.7)和阿拉伯语(+7.9)等中高资源语言中,在最考验跨语言迁移能力的极端低资源语种上表现得尤为突出:约鲁巴语实现了 10.9 个百分点的巨大增益,伊博语也提升了 7.9 个百分点。在独立的第二次重复运行测试中,GPT-5-mini 在 22 次语言运行对比中胜出 20 次,证明了性能提升的高度稳健性。
这种增益在 Mistral-Large-3 和开源百亿多模态模型 Qwen3-VL-235B 上同样得到了复现。在 MULTITAT 表格推理任务中,TART 的加入让 Mistral-Large-3 的平均准确率直接从 21.0% 跃升到 31.0%,带来了 10 个百分点的绝对增益,相对提升幅度达到 47.6%;十种参评语言无一出现性能退化,法语提升 17.6 个百分点,孟加拉语和斯瓦希里语也分别提升了 9.2 和 6.8 个百分点。
消融研究与复杂度的边界
TART 到底哪一部分在起关键作用?研究人员在跨越不同资源层级的五种语言上进行了累加式消融实验(Ablation Study)。
实验设置了三个梯次:仅包含表面输入约束(实体、时间、来源)的 Input 组;在前者基础上追加推理步骤规划的 Input + Operation 组;以及包含完整答案格式约束的 Full 组。
数据清晰地揭示了各模块的价值流向:系统平均准确率从基线一路攀升,每加入一个维度的约束,效果便产生一次显著跃升。更为关键的是,操作字段(Operations)对低资源语言展现出了定海神针般的作用。在伊博语中,最终 9.1 个百分点的总增益中,有高达 7.3 个百分点是由操作字段贡献的;而在阿拉伯语和印地语中,输入约束与操作约束的贡献则更加均衡。这与前文发现的“低资源语言主要死于操作对齐失败”形成了极其严密的互证逻辑闭环。
然而,论文也坦诚指出了当前的瓶颈。在 GAIA 任务的难度分级中,TART 的增益绝大部分集中在 Level 1(平均提升 9.0 个百分点)和 Level 2(提升 5.0 个百分点),而在难度最高的 Level 3 任务上,平均性能增益趋近于零。深入分析表明,Level 3 任务不仅考验规划的准确性,更依赖智能体进行超长步骤的工具调试与复杂的非线性动态纠错。当底层环境交互和超长上下文处理能力达到上限时,单纯依赖上游规划器的语义对齐便难以独自突破瓶颈。
重新审视跨语言智能体的前端接口
Cohere 与富士通的这项工作给多智能体系统的构建者带来了极具价值的工程启示。
长久以来,多语言 Agent 的研发往往陷入两种极端:要么盲目迷信底层大模型的“通用涌现能力”,期望单次 Prompt 就能让规划器理解复杂的非英语小语种意图;要么耗费巨资对特定小语种进行端到端微调。
TART 则证明了第三条道路的可行性:在规划器真正展开动作分解之前,引入一层轻量级、契约式的语义规范协议。通过在最上游将隐含的实体、时间、数据源以及推理算子显式解构,并将这些约束作为“语义契约”贯穿多智能体协作的全流程,系统能够在不改动任何模型参数的情况下,显著筑牢跨语言执行的稳定性防线。对于正在尝试将自主智能体推向全球化、多语种实际业务场景的团队而言,这一思路无疑具有高度的启发性和可借鉴性。