AgentOPSD:清华美团提出递归自蒸馏,ALFWorld成功率达89.1%
AgentOPSD: Recursive Self-Distillation for Agentic Reinforcement Learning
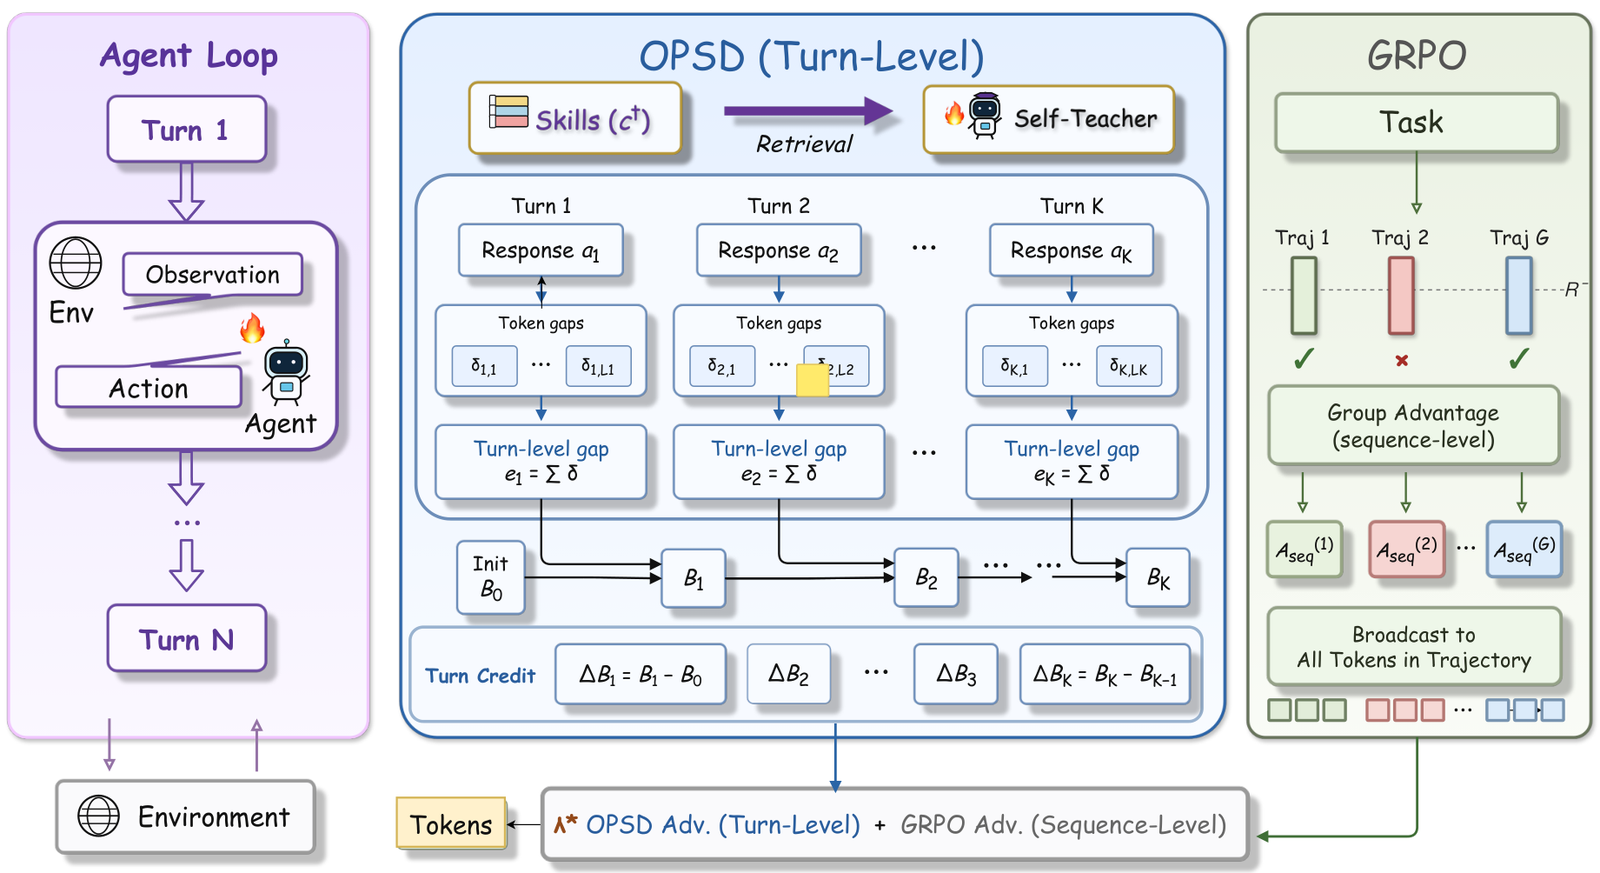
在大模型逐步走向多轮自主交互(Agentic Tasks)的背景下,强化学习(RL)成为了激发模型工具调用、环境感知与复杂规划能力的关键手段。然而,这类多轮交互环境往往只在整条轨迹结束时给出一个稀疏的最终胜负结果(Verifiable Reward)。当前以 GRPO(Group-Relative Policy Optimization)为代表的主流无价值网络(Critic-free)算法,倾向于直接将整个轨迹的最终优势值(Advantage)均摊广播给轨迹中的每一个 Token。这种“一刀切”的信用分配方式在单轮推理中尚可应付,但在几十轮的复杂具身或搜索任务中,往往会导致模型把成功归功于无关紧要的操作,或把失败惩罚施加在原本极具价值的推理步骤上。
ArXiv URL:https://arxiv.org/abs/2608.05987v1
为了解决稀疏反馈问题,近期研究尝试引入特权自蒸馏(OPSD),利用训练期可见的额外信息引导策略。但现有方法要么局限在 Token 级别,破坏了 Agent 交互以“轮次(Turn)”为决策单位的物理边界;要么孤立地评估单步得分,忽略了交互历史对当前决策价值的动态塑造。
针对这一困境,美团、清华大学与浙江大学的研究团队提出了 AgentOPSD。该方法不增加任何独立的 Critic 价值网络,也不引入额外的环境采样交互(Rollouts),而是通过在对数几率(Log-odds)空间内递推更新贝叶斯信念状态,将稀疏的轨迹级奖励重塑为细粒度的轮次级信用。在 ALFWorld 具身环境评测中,基于 Qwen2.5-7B 的 AgentOPSD 取得了 89.1% 的成功率;更关键的是,面对随着交互步数变长而急剧下降的策略稳定性,AgentOPSD 将长程任务的性能衰减斜率从 GRPO 的 -2.91 压制到了 -0.54。
为什么孤立的蒸馏信号算不上时序信用?
在多轮交互环境中,智能体的每一个动作通常由一长串 Token 组成,而环境只有在动作完整结束、触发轮次边界时才会返回新的观察。传统基于特权信息的在线自蒸馏(On-Policy Self-Distillation)通常在训练时向模型输入辅助技能或额外线索作为“教师”,然后对比带特权输入与原始输入下的 Token 条件概率差。
如果直接把这种局部的概率差距当成强化学习的奖励,会遇到两个根本性的结构错位。其一是颗粒度错配,环境状态的迁移是轮次级的,而在动作内部的单个 Token 级别计算散度,很容易切碎一个原本连贯的动作语义。其二是时序上下文的缺失,在真实的序列决策中,一个动作是否有价值,完全取决于它在当前上下文中的边际贡献。当局面胜负未定时,一个关键动作能彻底扭转战局;但当模型前面已经连续做对了九步、最终成功已成定局时,第十步哪怕再完美,对最终结果的边际推进也几乎为零。
以往的局部自蒸馏方法对每一步单独打分,无法区分“力挽狂澜的关键一步”与“大局已定下的常规操作”。真正的时序信用分配,衡量的不应是某个动作局部的静态质量,而是该动作在多大程度上改变了整条轨迹最终走向成功的预期。
轮次级贝叶斯证据聚合
AgentOPSD 建立在一种后验视角之上。令 $C$ 表示整条交互轨迹最终成功的事件。如果在第 $k$ 轮智能体做出的动作 $a_k = (y_{k,1}, \dots, y_{k,L_k})$ 确实推动了任务完成,那么这个动作应该在成功经验中展现出比失败经验更高的出现概率。根据贝叶斯法则,动作对最终成功概率所带来的对数几率变化,本质上对应着似然比:
\[\operatorname{logit}p(C\mid s_k, a_k) - \operatorname{logit}p(C\mid s_k) = \log\frac{p(a_k\mid s_k, C)}{p(a_k\mid s_k, \neg C)}\]直接在长程任务中对所有可能的后续路径边缘化计算是不可行的。AgentOPSD 利用训练期检索到的特权经验技能 $c^+$,构造了动作级别的对数概率差。对于动作内部的每一个 Token,计算其在带有特权信息与普通历史下的对数概率差 $\delta_{k,t}$,并将其沿动作长度进行轮次内求和,从而得到与环境交互边界天然对齐的轮次级证据 $e_k$:
\[e_k = \sum_{t=1}^{L_k} \delta_{k,t} = \log\frac{\pi_\theta(a_k\mid s_k, c^+)}{\pi_\theta(a_k\mid s_k)}\]这一聚合消除了动作内部 Token 碎片化的噪声,将局部的特权监督转化为一个标量证据。当 $e_k > 0$ 时,表明该动作在特权视角下受到积极评价,增强了通往成功的证据支持;反之则表明该动作偏离了正确路径。
在 Log-Odds 空间内的递归信念修正
拿到单轮证据 $e_k$ 之后,算法的核心在于如何结合历史来判定这一轮是否关键。AgentOPSD 维护了一个带衰减因子的证据累加器,并在对数几率空间中递推更新对轨迹成功的后验信念。
系统将初始信念 $B_0$ 锚定在 GRPO 同批次采样的平均成功率 $\bar{R}$ 上,从而为整个更新过程注入环境难度的先验基准。在随后的每一轮交互中,历史证据按折扣因子 $\gamma$ 进行衰减,并叠加当前轮次的新证据,形成当前轮次的对数几率 $\ell_k$:
\[c_k = \gamma c_{k-1} + e_k,\qquad \ell_k = \operatorname{logit}(B_0) + c_k = \operatorname{logit}(B_0) + \sum_{j=1}^k \gamma^{k-j} e_j\]通过 Sigmoid 函数将对数几率映射回概率空间,即可得到第 $k$ 轮结束时智能体对最终成功的信念状态 $B_k = \sigma(\ell_k)$。进而,第 $k$ 轮动作所带来的边际信念修正量被定义为前后两轮信念的差值:
\[\Delta B_k = B_k - B_{k-1} = \sigma(\ell_k) - \sigma(\ell_{k-1}) \approx B_{k-1}(1 - B_{k-1}) \big(e_k - (1-\gamma)c_{k-1}\big)\]这一公式展现了优雅的自适应门控特性。当智能体处于极度不确定的探索阶段(即前序累积信念处于中庸状态,此时 $B_{k-1}(1 - B_{k-1})$ 接近最大值 0.25)时,新证据能够引起大幅度的信念修正;而一旦累积证据已经高度确信任务必然成功或失败时,$B_{k-1}(1 - B_{k-1})$ 趋近于 0,即使后续动作获得很高的单步打分,其边际修正量也会被主动抑制。这在数学上直接解决了冗余动作被过度奖赏的问题。
为了确保局部的修正不违背最终的真实结果,AgentOPSD 结合整条轨迹的序列优势符号 $\operatorname{sign}(A_{\mathrm{seq}})$,定义了带符号的方向信用:
\[q_k = \operatorname{sign}(A_{\mathrm{seq}}) \Delta B_k\]其幅值反映了该轮动作引发状态转移的剧烈程度,而符号则严格校验这种修正是否与最终结果一致。在成功轨迹中推动成功率上升的动作,或在失败轨迹中力挽狂澜试图纠偏的动作,都会获得高幅值的正面肯定。
无 Critic 的有界优势重塑
在得到每轮的信用标量 $q_k$ 之后,如何将其安全地回馈到策略梯度更新中,同时避免破坏 GRPO 原有的收敛稳定性,是工程实现的核心。很多强化学习算法在直接缩放优势时极易导致梯度爆炸或策略崩溃。
AgentOPSD 采取了一种轨迹内标准化的有界调制策略。首先计算整条轨迹内部所有轮次信用的均值 $\mu_q$ 与方差 $\sigma_q$,将每轮的信用转化为标准化分数 $z_k$。随后,通过截断函数将其映射到一个严格受限的乘数区间 $[1-b, 1+b]$,其中 $b \in (0, 1)$:
\[w_k = \operatorname{clip}\left(1 + b z_k,\, 1-b,\, 1+b\right),\qquad \widetilde{A}_k = A_{\mathrm{seq}} \big[(1-\lambda) + \lambda w_k\big]\]参数 $\lambda \in [0, 1]$ 构成了在纯 GRPO 均匀优势与精细化轮次优势之间的平滑插值旋钮。这种设计的关键特性在于:重塑后的轮次优势 $\widetilde{A}k$ 永远保持与原始序列优势 $A{\mathrm{seq}}$ 相同的符号方向。算法绝不会因为局部的蒸馏波动而推翻最终验证器对整条轨迹“胜或负”的定性判决,它仅仅是在这一全局判决之下,对各轮次的权重进行重新洗牌——把有限的学习信号从无功平庸的轮次转移到决定胜负的关键轮次上。在实际的策略优化中,第 $k$ 轮中的每一个 Token 都会直接继承其所属轮次的重塑优势 $\widetilde{A}_k$,无缝适配主流的大语言模型 PPO/GRPO 训练管线。
实验结果与长程鲁棒性验证
为了全面验证方法的有效性,研究团队在具身模拟基准 ALFWorld、交互式电商购物环境 WebShop 以及多跳检索问答 Search-QA 上进行了系统评测,基座模型选用开源主流的 Qwen2.5-3B-Instruct 和 Qwen2.5-7B-Instruct。
对比基线涵盖了无训练 Prompt 方案、经典组相对策略优化(GRPO、Skill-GRPO)以及多种先进的自蒸馏结合强化学习方案(如 RLSD、SDAR、StepOPSD 等)。所有需要特权信息的基线均在相同的数据与技能检索预算下运行,以确保性能提升并非源自额外的先验数据泄露,而是来自信用构建方式的改进。
在需要极其严苛的多步物体查找、清洗、加热并放置的 ALFWorld 任务中,Qwen2.5-7B 搭配 AgentOPSD 斩获了 89.1% 的成功率,远超标准 GRPO 的表现,并在所有自蒸馏基线中位列第一。在长程推理密集的环境中,随着轨迹长度的拉长,AgentOPSD 的优势更加明显。
通过对 ALFWorld 各子任务的平均成功步数与性能衰减率进行线性回归分析,结果显示:
-
标准 GRPO 随着平均步数增加,每多走一轮成功率下降 2.91 个百分点;
-
同样引入特权蒸馏但采用无区分缩放的 RLSD 下降更快,斜率达到 -3.59;
-
AgentOPSD 的衰减曲线极其平缓,斜率仅为 -0.54。
这一对比清晰地表明,均匀广播优势在长轨迹交互中会带来巨大的累积方差与错误归因,而递归信念更新能够有效抵抗长时序带来的信号稀释。
机制消融与超参数敏感度
为了确认 AgentOPSD 的每一层设计是否都发挥了不可替代的作用,论文在 ALFWorld 上针对各核心组件开展了严格的拆解消融实验:
-
轮次级聚合 vs Token 级更新:若将信念递推降维到 Token 级别,成功率从 89.1% 跌落至 85.9%。Token 级别的累积割裂了完整动作的语义,弱化了动作与环境反馈的因果对齐。
-
递归信念更新 vs 原始局部差距:若去除历史信念状态的递归机制,直接使用当轮未经递推的原始差距 $e_k$ 进行归一化,成功率下降至 82.8%。这证实了单独的自蒸馏差距确实不等于时序信用,必须借助历史状态的边际修正来剔除已饱和的无用信息。
- 带符号校验 vs 仅保留幅值:如果舍弃乘积中的结果符号项,仅用边际修正幅值 $\lvert \Delta B_k \rvert$ 进行优势调制,模型表现骤降至 80.5%。幅值只能表达“状态发生了剧烈扰动”,但无法甄别这种扰动究竟是在挽救死局还是在走向毁灭,缺少终局符号的引导会导致梯度方向在局部产生误判。
- 经验先验锚定 $B_0$:若去除以组平均胜率 $\bar{R}$ 作为对数几率起点的设定,成功率降至 78.9%。这说明批次平均胜率构成了至关重要的任务难度标尺,直接决定了早期更新是否处于高灵敏度响应区间。
在超参数敏感度测试中,衰减系数 $\gamma$ 在 0.8 到 1.0 之间波动时模型性能均保持在稳健的高位区间,说明该算法并不苛求极其精确的折扣调谐;而对于交互仅需 4 步左右的短程任务 Search-QA,各参数调节带来的波动非常微小,进一步印证了该机制的作用主力集中在长程信用分配的痛点场景。
重构 Critic-Free 架构下的时序差分精神
长期以来,强化学习在处理复杂时序信用分配时面临两难选择:要么采用 PPO 搭配一个训练成本高昂且容易估计不准的价值网络(Critic),借助广义优势估计(GAE)实现时序差分(TD)更新;要么走向 GRPO 这种完全砍掉 Critic、依赖整条轨迹蒙特卡洛结果的组相对方法,换取系统扩展性与极高训练效率的同时,默默承受长步数下的信用分配失效。
AgentOPSD 提供了一条巧妙的折中路径。它保留了 GRPO 无需独立 Critic 网络、无额外 Rollout 开销的轻量级框架,仅凭训练期间前向传播所附带的特权自蒸馏概率差,在数学层面上通过贝叶斯递推构建出了一个轻量的“隐式价值基线”。连续轮次间的边际信念修正 $\Delta B_k$,在功能上完美扮演了类似 GAE 中 TD 误差(Temporal-Difference Error)的角色。
这项研究表明,长程语言 Agent 的后训练不需要陷入“庞大 Critic”与“粗暴全局奖励”的非此即彼中。通过在动作边界上规范化概率信号,并将其置于动态的时序信念框架内演变,算法能够在几乎不增加计算负担的前提下,精准识别决定交互胜负的关键转折点。这为未来复杂工具调用、通用软件操作以及具身具智系统的后训练,提供了极具启发性的信用分配新范式。