微软提出OEO:自进化Agent无需预设流程,GPT-5.5在线编排省下65%交互Token
Rethinking Self-Evolving Agents: Do We Still Need Prescribed Optimization Pipelines?
在过去两年的大模型自进化研究中,让智能体(Agent)“通过与环境交互来自主改进”一直是极具吸引力的方向。为了实现这一目标,绝大多数现有系统都在外围搭建了一套严丝合缝的优化流水线。从分阶段收集失败用例、按模板进行反思诊断,到通过语法受限的补丁算子(Patch Operators)修改技能提示词,再到依靠验证集严格门控以及帕累托搜索来决定是否接受更新,人类工程师实际上替大模型规划好了自进化的每一个动作和节奏。
ArXiv URL:https://arxiv.org/abs/2608.09629v1
然而,随着前沿基础模型(Frontier Models)在多步骤长程推理、交互错误归因以及跨轮反思能力的全面跃升,一个底层系统的核心问题浮出水面:当优化器本身已经是一个顶尖大模型时,我们真的还需要在外围写死一套任务专用的自进化流水线吗?
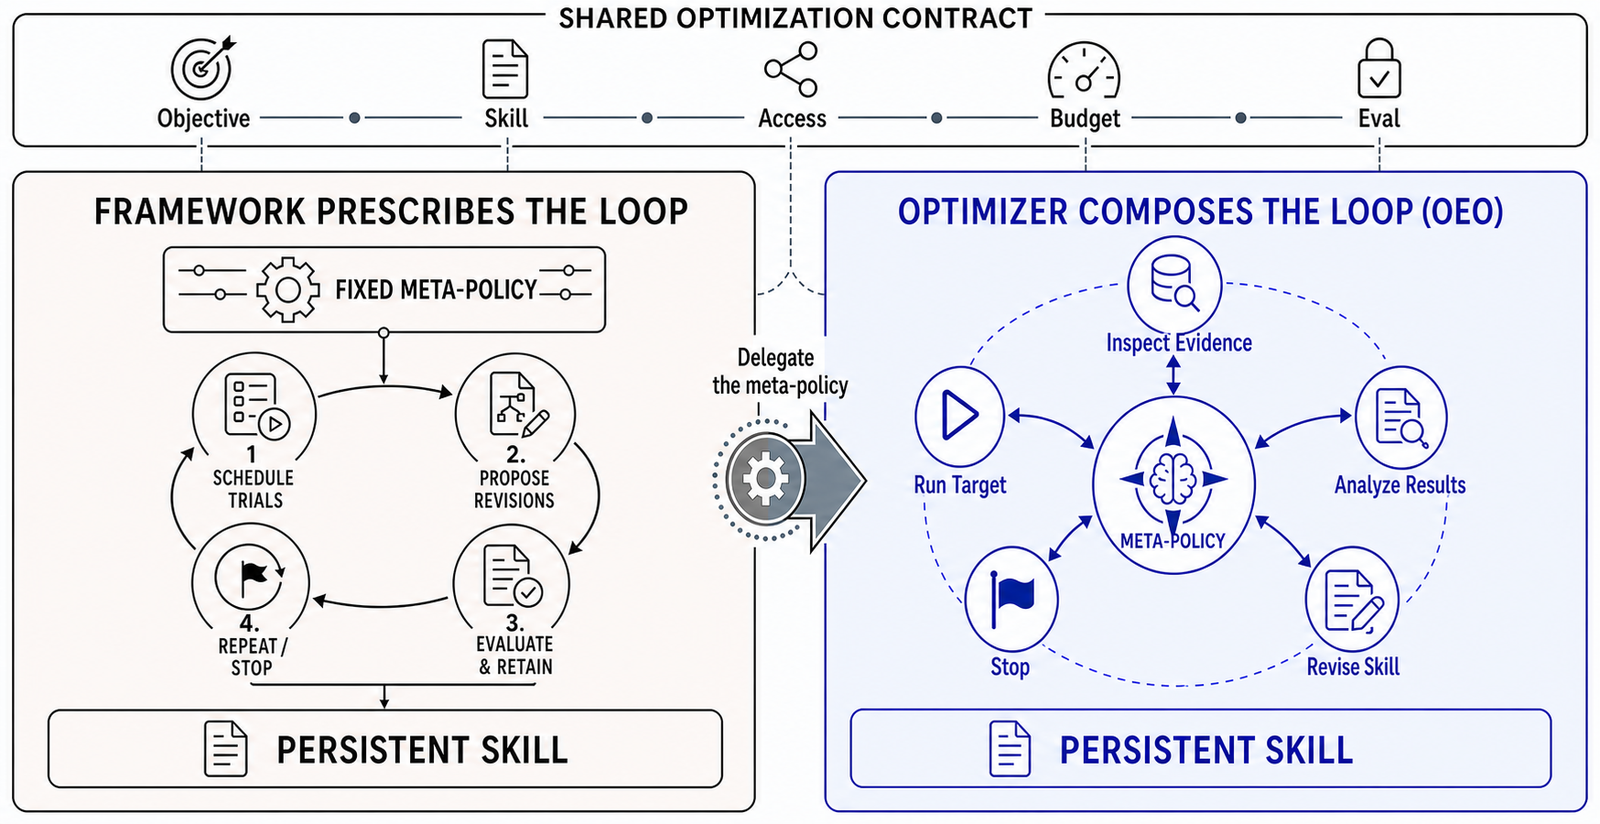
来自微软研究院(Microsoft Research)的最新研究对这一经典范式提出了挑战。作者团队明确提出,以往系统实际上把“治理优化问题的外部契约”与“组织优化过程的内部元策略”混为一谈。为此,他们提出了一种名为 OEO(Open-Ended Optimization,开放式优化)的极简范式:框架仅负责严格锁定目标、预算、权限和评测红线,而把“何时收集证据、如何诊断失败、提出何种粒度的修改以及何时停止”的全部过程控制权,彻底交给前沿优化器在线自主编排。
实验结果展现了极具冲击力的分工重构:以 GPT-5.5 作为优化器,在覆盖 8 组基准与目标模型组合的 14 场直接对决中,OEO 斩获了 12 场胜利、1 场平局,仅在 1 场设置中以 0.21 个百分点的微弱劣势落后于进化算法 GEPA。更重要的是,OEO 在取得这一战绩的同时,仅消耗了基线系统中位数 34.3% 的目标交互 Token。这表明,在具备足够推理能力的前沿模型面前,人为预设的优化流水线不仅不再是必需品,反而可能成为限制模型发挥潜力的束缚。
从“包办一切”到“确立契约”:优化职责的重新划分
要理解这项研究的立足点,首先需要厘清现有自进化智能体系统的结构设计。一个典型的技能自进化系统包含两个模型角色:一个是执行具体基准任务的目标模型(Target Model),另一个则是观察执行轨迹、诊断问题并改进持久化技能文本的优化器模型(Optimizer Model)。
在过去的架构中,框架(Framework)扮演了绝对的主导者。例如,代表性的流水线式系统 SkillOpt 强制规定了阶段化的运行步骤:先执行固定批次的测试,分离成功与失败轨迹,然后通过特定模板进行反思,接着只允许优化器使用预设的微小补丁算子进行局部增删改,最后经过严格的验证集门禁才决定是否将新版本持久化。另一种代表性方案 GEPA 则偏向搜索,它虽然允许自由格式的文本突变,但将每一次突变嵌套在固定的帕累托多目标进化循环中,由框架决定父代选择、淘汰频率与终止时机。
这两套系统虽然在算法拓扑上截然不同,但本质上都是由人类在系统代码中“硬编码”了优化的完整路线图。优化器大模型在其中只是一个流水线工人,负责在框架指定的某个具体工位上填充文本内容。
微软研究团队在此做出了关键的概念解耦:将自进化系统拆解为优化契约(Optimization Contract)与优化元策略(Optimization Meta-Policy)。
-
优化契约($\mathcal{C}$)属于外部治理范畴,它必须由外部框架不可妥协地锁定。这包括优化目标、初始技能文本 $s_{0}$、目标模型、允许使用的交互操作集 $\mathcal{O}$、计算与 Token 资源预算 $B$、不可跨越的数据边界以及冻结的最终测试集 $D_{\mathrm{final}}$。
-
优化元策略则属于过程控制范畴,即智能体究竟该以什么样的时序和逻辑把零散的反馈转化为持久的技能更新。在时间步 $t$,优化动作的选择形式化为:
其中 $\mathcal{I}_{q}$ 代表具体程序的外围支持。
OEO 的核心机制就是将优化元策略的掌控权从外部代码彻底让渡给大模型本身。在 OEO 协议中,框架退居为一个严格的执行沙箱与记账裁判:它暴露给优化器一个通用的交互接口,允许模型在预算范围内自主决定是发起一组测试、分析特定错误案例、对技能文本进行任意段落的大幅度重组、回退到之前的某个检查点,还是主动宣布收敛并停止优化。外部框架仅负责校验操作合法性、记录资源消耗并严密隔离测试集,绝不插手干预具体的优化工序。
12胜1平:开放式编排在主流基准上的全面压制
为了公平验证这种“放权”是否可行,评测必须在严格相同的外部契约下进行。研究团队在 SearchQA、OfficeQA、SpreadsheetBench 以及极具挑战性的前沿数学推理基准 LiveMathematicianBench(简称 LiveMath)上展开了系统性评测。任务执行端分别采用了开源的 Qwen3.5-4B 和前沿的 GPT-5.5 作为目标模型,而优化器端则统一使用 GPT-5.5,以排除优化器底座能力差异带来的干扰。
在与基于流水线分阶段更新的 SkillOpt 的 8 组直接对决中,GPT-5.5 驱动的 OEO 在所有初始技能上均实现了正向提升,取得了 7 胜 1 平的战绩。平局出现在以 GPT-5.5 为执行端的 SpreadsheetBench 上,两者的通过率精确打平在 0.7607;而在 GPT-5.5 为执行端的 LiveMath 上,OEO 则取得了高达 18.55 个百分点的绝对领先优势。
在与引入帕累托进化搜索的 GEPA 进行的 6 组确认性对比中,OEO 同样赢下了 5 场。GEPA 唯一领先的一场是在 SearchQA 上,但也仅仅领先了微不足道的 0.21 个百分点;而在 LiveMath 这类更需要深度逻辑诊断的场景下,OEO 对 GEPA 的优势进一步扩大到了 28.23 个百分点。需要强调的是,GEPA 本身在其中 3 个场景下都优于 SkillOpt,这证明 GEPA 是一个足够强劲的基线,OEO 的胜利绝非由于选用了羸弱的对照组。
更令人印象深刻的是资源利用效率的极度反差。在与执行环境的交互上,OEO 在所有设置下的 Token 消耗均显著低于 SkillOpt,其中位数仅为 SkillOpt 预设预算的 34.3%。在 GPT-5.5 驱动的 SpreadsheetBench 任务中,OEO 甚至仅用了预设预算 6.1% 的目标交互 Token 就追平了基线。
深入分析可以发现,这种效率并非来自于无差别的“抠门”。在优化器模型自身的推理 Token 消耗上,OEO 在数个任务中几乎消耗了与基线相近乃至略高的预算。换言之,前沿模型在拥有自主控制权后,展现出了类似高级工程师的行为模式:它把更多的算力花在内部深思熟虑的归纳与自我批判上,而不是像传统框架那样盲目、机械地去刷海量的真实环境交互样本。 这种“重反思、精准交互”的策略,直接打破了传统自进化系统依赖密集数据采样的低效循环。
并非单纯依赖先验:单次重写与能力边界控制
面对 OEO 的出色表现,学术界往往会提出两个尖锐的质疑:
第一,GPT-5.5 是不是单凭自身的强预训练知识(Prior),在看到初始技能的第一眼就能一次性写出最佳版本,从而让所有的“交互式自进化”沦为空谈?
第二,如果 OEO 这么好,它是一个放之四海皆准的“万能外壳”,还是专属于前沿顶尖模型的特权?
为了回答第一个问题,研究团队设置了严格匹配输入、零交互的单次重写(One-shot Rewrite)对照组。在该设置下,GPT-5.5 拥有所有静态的先验知识,但不被允许进行任何环境交互和执行反馈收集。结果表明,在 SearchQA 上,静态先验确实带来了一定幅度的提升,但其最终得分仍然分别落后 OEO 达 6.14 和 3.57 个百分点;而在结构更为严密、更依赖反馈调试的 LiveMath 上,静态重写甚至引发了严重的性能负迁移,直接降低了初始技能的基线得分,相比之下,经过 OEO 多轮交互演进的技能则实现了接近 30 到 35 个百分点的爆发式提升。这确凿地证明,OEO 的收益并非来自底座模型的先验复读,而是来自于其在交互闭环中精准组织假设检验与反馈吸收的能力。
然而,第二个质疑则揭示了这项研究最重要的理论边界:元策略的放权存在极其严格的“能力门槛”。
当研究人员保持测试协议完全冻结,而将优化器模型降级为中等能力模型或较弱模型时,局势发生了戏剧性的反转。在中等能力优化器下,预设流水线的 SkillOpt 在 LiveMath 和 SearchQA 上全面反超 OEO,领先优势分别达到 9.68 和 3.50 个百分点。而在弱优化器下,OEO 的通用交互接口直接失效——由于缺乏基本的格式遵从与上下文规划能力,弱优化器甚至无法输出可被执行的有效动作,整个自进化过程直接停摆;相反,SkillOpt 依靠其坚固的外部代码控制流,依然能强行驱动弱模型完成整个流程(尽管最终由于修改质量太差,其生成的技能得分甚至跌破了初始技能)。
从数据敏感度来看,优化器从能力中等跨越到前沿级别时,OEO 的性能在 LiveMath 和 SearchQA 上分别跃升了 16.13 和 7.07 个百分点;而同等跨度下,受制于固定框架约束的 SkillOpt 仅分别提升了 2.42 和 0.64 个百分点。这组对比清晰地划定了边界:预设的优化流水线本质上是一种“能力依赖型的外部脚手架”(Capability-dependent Scaffolding)。 当模型本身不具备规划复杂优化步骤的能力时,人类编写的代码框架能够提供关键的代偿和下限兜底;但一旦跨越了某个智力拐点,这层脚手架就会反过来变成天花板,阻碍模型根据动态反馈走出更高维、更灵活的解题路径。
轨迹显微镜:过程极度发散,功能高度收敛
为了看清“预设流水线”究竟从根本上改变了什么,研究团队对所有可完整追踪的 OEO 与 SkillOpt 运行轨迹进行了微观层面的状态重构。他们追踪了优化历史上每一次持久化技能文本的字节级变化,并计算了编辑幅度、涉及的 Markdown 段落广度以及反复推翻前期修改的“修订动荡度”(Revision Churn)。
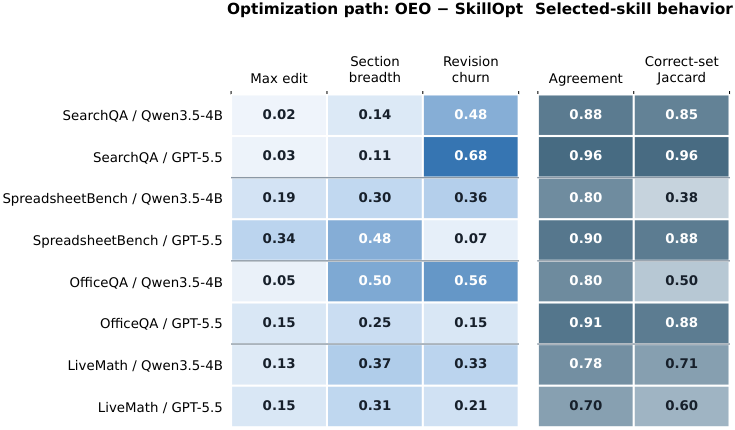
轨迹诊断展现出一种高度一致但反直觉的图景:
在优化路径的空间中,OEO 展现出了极高的探索自由度。在所有 8 组配对实验中,OEO 的最大归一化 Token 编辑量、触及的最大 Markdown 段落广度以及修订动荡度均显著高于 SkillOpt。SkillOpt 由于受到预设补丁算子的物理限制,始终在初始文本的局部做小心翼翼的“微创修补”;而 OEO 则经常大刀阔斧地重写核心段落,甚至在后续轮次中完全推翻上一轮的假说,进行彻底的重构。
令人惊讶的是,这种在文本空间和轨迹演进上的巨大差异,并没有导致最终模型行为的分道扬镳。当研究人员在测试集上逐题比对由 OEO 和 SkillOpt 分别演进出的最终技能时,发现两者的行为表现出极高的重合度:在 8 组设置中,有 7 组的 Pass/Fail 判决一致性在 0.78 以上,正确题目集合的 Jaccard 相似度在 5 组设置中突破了 0.70。在 GPT-5.5 驱动的 SearchQA 上,尽管两者的修改历史完全不同,但最终的判决一致性高达 0.9629,正确集 Jaccard 高达 0.9581;在 SpreadsheetBench 战平的设置中,两者的正确集重合度也达到了 0.8767。
统计分析进一步证实,最终技能文本的编辑距离与它们在基准上的功能行为差异之间,其斯皮尔曼等级相关系数仅为弱相关的 $\rho = 0.3095$。
这意味着,人类此前煞费苦心设计的优化流水线,实际上更多地只是改变了大模型在文本空间中“跋涉的路径风格”(让路径看起来更保守、更规整),但在具备客观评测反馈的前提下,前沿大模型无论是自由大步跨越还是戴着镣铐跳舞,最终都会自发收敛到几乎同一批能够解决问题的核心操作模式上。
自进化系统的新范式:能力自适应分工
这项工作对于正在构建 Compound AI System、LLM Agent 自我迭代系统以及企业级工作流的开发者而言,具有深刻的工程架构启示。
长期以来,AI 社区在设计自进化系统时陷入了一种“自动化控制迷思”:工程师们倾向于把最复杂的业务逻辑、反思状态机、回滚机制和进化规则全部用 Python 代码写死。这不仅导致系统异常臃肿、极易在异构任务间失效,而且将整个系统的能力上限牢牢锁死在工程师自己对“如何优化技能”的认知水平上。
微软这项研究揭示了一条更为优雅的系统演进哲学:框架管约束,模型管路径。
系统架构师的核心职责应当是定义一个严密无缝的“优化契约”:搭建确定性的沙箱环境,保护测试集不被数据泄漏,严格监控 Token 和 API 调用开销,并提供准确且可执行的反馈信号。只要这个外部安全防线足够稳固,具体的迭代战术、用例筛选和技能演进步骤就应该随着优化器底座能力的提升,逐步卸载给大模型本身。
未来的自进化智能体架构不应是一成不变的刚性管道,而应演进为一种“能力自适应的动态脚手架”系统。在弱模型时代,我们需要像 SkillOpt 那样为其配备全套支架;而随着前沿模型不断向通用推理高地推进,主动拆除多余的脚手架,让模型在清晰的规则边界内自由展开探索,或许才是释放自进化智能体真正潜力的标准解法。