51万文档规模测试:图RAG撞墙、Agent失灵,传统BM25凭何胜出?
Which RAG Paradigm Wins at Scale? A Scaling Study of Retrieval-Augmented Generation Paradigms
在大模型落地企业级知识库的过程中,检索增强生成(RAG)几乎是所有团队的标配架构。过去两年,业界对 RAG 的演化方向抱有极高的技术热情:一方面,微软推出的 MS-GraphRAG 以及 LightRAG、HippoRAG 等图谱方案,试图通过大模型预先抽取实体与关系三元组,重构深层知识网络;另一方面,以 Claude Code、SWE-bench 配套环境为代表的智能体方案(File-System Agent),让大模型通过多轮命令行、文件树遍历与关键词搜索动态探索语料库,被许多人视为替代静态检索的终局形态。
ArXiv URL:https://arxiv.org/abs/2607.26497v1
然而,这些华丽的前沿范式究竟能不能撑住真实企业场景的数据膨胀?一个极其尴尬的现状是:绝大多数学术基准和开源项目在评测时,往往把语料库固定在几百到几千篇文档的微型规模,或者只在特定数据集上跑单点评测。一旦语料库扩展到数十万、上百万篇文档,不同范式的准确率衰减速度如何?离线建库与在线查询的 Token 账单会膨胀到什么程度?
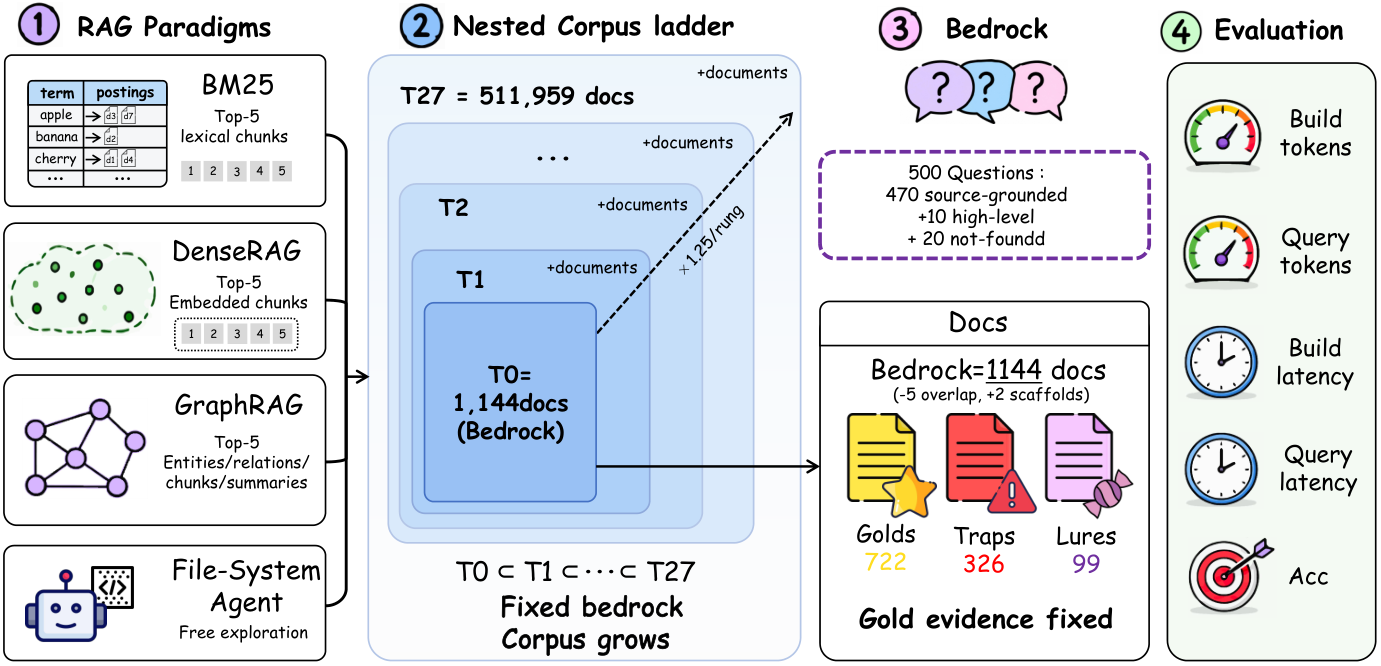
来自北京农林科学院、元石科技(Metastone Technology)与中国科学技术大学的研究团队,在最新论文《Which RAG Paradigm Wins at Scale? A Scaling Study of Retrieval-Augmented Generation Paradigms》中给出了极其硬核的回答。他们构建了一个包含 28 个严格嵌套层级、语料规模从 1,144 篇以 1.25 倍步长一路跃升至 511,959 篇文档(对应 Token 规模从 170 万增至 6.01 亿)的控制实验阶梯。在完全相同的 Reader 模型、统一打分裁判和固定问答测试集下,横向对比了词法检索(BM25)、稠密检索(DenseRAG)、四种图检索(MS-GraphRAG、LightRAG、HippoRAG 2、LinearRAG)以及文件系统智能体(File-System Agent)。
这项研究得出了三个颠覆直觉的核心结论:
-
最古老的 BM25 展现出极其惊人的抗压扩展性,在中大型规模以上的所有层级全面领跑官方综合得分,且在整个扩展阶梯中始终稳坐帕累托(Pareto)成本效益前沿的最低成本端。
-
依靠多轮工具调用的文件系统 Agent 在千篇文档的小规模下虽能微弱胜出,但单题消耗的 Query Token 是 BM25 的 39 到 60 倍;当语料膨胀到 51 万篇全量时,其得分从最初的 77.4 骤降至 30.7,落后 BM25 接近 20 分。
-
依赖大模型预抽取的重型图 RAG 遭遇了严峻的“建库成本墙”(Construction Wall),甚至无法完成前 2% 语料的索引构建;而兼顾了建库可行性的轻量图方案,在准确率上又始终未能超越零建库成本的 BM25。
严格嵌套的 28 级扩展阶梯:如何排除评测干扰?
评估不同 RAG 系统随着规模扩大的表现,存在极高的实验难度。如果在放大语料库的同时更换了提问集、变动了 Reader 模型、或者引入了不受控的随机噪声,测试结果就会被混杂因素严重污染。
为了建立严苛的控制变量,研究人员依托包含 511,959 篇多源企业文档的 EnterpriseRAG-Bench 语料库,设计了一套“前缀严格嵌套”(Strictly Nested Tiers)的阶梯构建方法。基底层级(Bedrock)包含 1,144 篇核心文档,其中锁定了全部 500 道测试题所依赖的真实参考证据,以及针对每道题目专门设计的对抗性干扰文档(Adversarial Distractors)。随后的 27 个扩展层级,按照固定的随机种子和来源分层采样,每阶递增约 25% 的背景噪声文档,确保上一级的所有文档被下一级严格包含($T_1 \subset T_2 \subset \cdots \subset T_{28}$)。
这种设计带来了一个绝对的控制标准:无论语料库如何膨胀,黄金证据始终存在于知识库中,测试问题和评估标准分毫不变。系统准确率的下滑,纯粹由语料库规模放大引入的海量干扰文档所导致。
在此基础上,研究团队统一了度量口径。所有一阶段生成模型(Reader)固定采用相同的 LLM,打分系统不仅记录官方综合得分(结合事实完整性与正确性的门控分数),还独立统计文档级召回率、离线建库 Token 消耗(区分生成式 Token 与 Embedding Token)、在线单题查询 Token 消耗以及端到端延迟。为了杜绝大模型裁判的主观偏差,团队还引入了独立的第三方裁判模型与二元评估协议进行交叉验证,跨裁判一致率高达 96.2%,确保了实验结论的可靠性。
准确率崩塌:复杂 Agent 与密集检索的规模困局
在基底规模(1,144 篇文档)下,各家表现基本符合当下的主流宣传。文件系统 Agent 取得了 77.4 的高分,略高于 BM25 的 74.7,二者的 95% 置信区间高度重叠。此时,Agent 依靠多轮工具调用,在目录结构中游刃有余地翻阅、比对文件,展现出很强的多跳推理与线索追踪能力。
然而,随着语料阶梯逐级上升,系统间的表现迅速分化。当语料规模达到几万篇文档时,BM25 展现出极其坚挺的抗噪性;而文件系统 Agent 的准确率曲线却出现明显跳水。到 511,959 篇全量规模时,BM25 依然保住了 50.5 的综合分,但文件系统 Agent 的得分却腰斩至 30.7,稠密检索(DenseRAG)也仅录得 29.9。
稠密向量检索的疲软在预料之中。在数十万篇文档的混合企业语料库中,企业问答往往包含大量专有名词、料号、错误代码或人名,而对抗干扰文档在语义上往往与问题极度相近,但在关键事实细节上存在偏差。高维稠密向量在这种细粒度区分上极易被相似度淹没,导致检索召回率随噪声急剧退化。
令人吃惊的是被寄予厚望的 File-System Agent。分析显示,Agent 在全量语料上的失败,并不是因为 80 次工具调用的上限被耗尽。事实上,即使在调用未超限的测试子集上,Agent 的得分同样发生了雪崩。深层症结在于它的“全局候选发现”(Global Candidate Discovery)机制失灵。在海量文件构成的庞大树状文件系统中,大模型通过 ls、grep 等初级工具进行局部试探,犹如在黑夜中打着手电筒找针。只要前两步关键词搜索受挫或进入了错误的目录分支,后续的序列化探索就会在错误上下文的引导下彻底偏航,甚至在海量干扰项中耗尽精力,最终产生幻觉或直接放弃。
撞上建库墙:Graph RAG 难以承受之重
图 RAG 面临的困境则更为致命:它在许多中大规模测试点上甚至连准确率曲线都无法画完整,直接撞上了不可逾越的离线建库成本墙。
MS-GraphRAG 和 LightRAG 这类方案的核心思想,是在建库阶段调用强大的生成式大模型,逐段解析文本块(Chunk),提取出细粒度的实体、属性与关系描述,并组织分层社区报告。这种重型建库模式的 Token 消耗量极为骇人。数据测算显示,MS-GraphRAG 每索引一个语料 Token,就需要消耗高达 24.6 个生成式 LLM Token。在本次实验中,MS-GraphRAG 仅仅爬升到 8,750 篇文档的层级,其累计构建成本就已达到数亿 Token,耗费数十个计算实例天,最终不得不停止向上扩展。据论文推算,如果强行在 51 万篇全量语料(约 6 亿 Token)上构建完整的 MS-GraphRAG,将需要消耗接近 80 亿个生成式 Token 和数十个实例月的计算资源。
HippoRAG 2 尝试通过开放词表三元组与个性化 PageRank(Personalized PageRank)算法来降低复杂度,其建库开销与语料呈现近乎线性的比例增长($b \approx 1.01$)。但即使在 131,876 篇文档的中等规模下,它也已经吞噬了 7.24 亿个建库 Token。更具讽刺意味的是,付出了如此高昂的离线代价后,HippoRAG 2 在该规模下的准确率仅为 41.0,整整落后零建库成本的 BM25 达 15 分之多。
为了解决大模型建库昂贵的问题,LinearRAG 采用轻量级命名实体识别(NER)配合小向量模型构建实体共现图,完全不消耗生成式 LLM Token。然而在准确率表现上,LinearRAG 同样未能在任何一个共享层级上压制 BM25。实验数据表明:如果在建库阶段放弃了昂贵大模型的深度语义蒸馏,图谱质量就会大幅缩水;而如果坚持使用大模型精细提取,工程预算与构建时间便无法支撑起大规模真实业务。
成本与延迟账本:在线开销差距超 60 倍
除了离线建库的算力黑洞,在线查询阶段的算力消耗同样决定了 RAG 系统能否在工业界上线。
一阶段直接检索系统(BM25、DenseRAG、HippoRAG 2)的单题查询成本具有天然的“尺度不变性”。无论语料库是 1,000 篇还是 51 万篇,它们都仅负责召回 Top-5 代码片段,随后拼接为一次 Prompt 提交给固定的 Reader 模型。因此,BM25、DenseRAG 和 HippoRAG 2 的单次问答 Token 消耗始终稳定在 5,000 至 6,500 Token 之间,端到端延迟控制在数秒内。
相比之下,File-System Agent 的在线查询成本随着语料规模扩大呈现爆炸式增长。在 1,144 篇基底规模下,Agent 平均每题就需要消耗 226,000 个查询 Token;随着文件系统层级加深、分支变多,大模型在上下文中保留的历史交互记录迅速膨胀,到两万多篇文档规模时,单题查询 Token 已经飙升至 343,000,达到了 BM25 的 60 倍之巨。不仅如此,多轮往返的串行 LLM 调用使得单题平均响应时间拉长到数十秒甚至数分钟,无论在 API 账单还是实时体验上都彻底失去了商用可行性。
机制破局:把检索置于智能体之前(Agent + BM25)
既然文件系统 Agent 在小规模下表现出惊人的推理上限,却在大规模下因缺乏全局候选发现而溃败,那么问题的根源究竟是“Agent 的多轮推理范式不行”,还是“裸文件系统这种底层介质不行”?
为了彻底解耦“推理策略”(Agency)与“检索基底”(Substrate),研究团队进行了一组极具启发性的对照实验:他们保留了 File-System Agent 完全一致的大模型、提示词工程、思考循环以及 80 次工具调用预算,但做了一个关键手术——剥夺其直接遍历底层裸文件系统的权限,换成一个由 BM25 驱动的打分检索工具与段落阅读接口,即“Agent + BM25”。在这个架构中,Agent 的第一次动作被强制使用原始问题调用 BM25 全局检索,随后的思考轮次中,Agent 可以根据中间阅读到的线索发起新的关键词搜索。
实验结果令人振奋:在 51 万篇全量语料抽样的 150 道严苛测试题上,基于裸文件系统的原生 Agent 得分仅为 36.9,纯 Native BM25 的基线得分为 54.8,而切换为“Agent + BM25”之后,综合得分一举飙升至 69.4!不仅大幅反超了纯 BM25,更彻底粉碎了原生 Agent 在规模扩张下的退化诅咒。同时,由于首轮 BM25 能够精确锁定高质量的前候选段落,Agent 不再需要像无头苍蝇一样在文件树中疯狂盲搜,其实际消耗的查询 Token 缩减到原生 Agent 的约九分之一。
这一关键实验确立了一个底层设计原则:全局候选检索必须先行,智能体推理应当后置。面对数十万级甚至更大的知识库,指望语言模型直接利用文件系统工具去摸索全局线索是徒劳的;但只要让经典倒排索引承担起高效粗筛的职责,智能体便能在高度聚焦的局部候选集上,充分释放交叉验证、多跳关联和长文总结的强大推理能力。
对企业级 RAG 架构的启示
这项研究以详实的数据打破了“越复杂、越昂贵、越前沿的架构就越有效”的技术迷信,为工程实践带来了清晰的技术选型指南:
对于以企业文档、技术工单、规章制度为核心的严肃工业知识库,BM25 不仅不是应该被淘汰的“老古董”,反而应当成为所有团队开箱即用的第一基准(Default Baseline)。它零离线建库成本、低在线查询延迟、完全可解释,并且在精确定位实体标识符、代码和专业术语时对语义干扰噪声具备天然的抗性。
盲目投入巨大算力去全量抽取实体图谱、构建所谓“全知图 RAG”的路线在超大规模下性价比极低。除非业务场景中存在极其明确、高度密集的拓扑关系跳跃需求,且语料库规模有限,否则重型 Graph RAG 的投资回报率将十分惨淡。
如果团队致力于引入具有自省、规划与动态纠错能力的 Agent 架构,切忌让智能体直接面对裸文件系统或扁平存储。将倒排检索(如 BM25)或高效混合检索封装为类型化工具,作为 Agent 探索外部世界的第一道感知屏障,才是兼顾高精度与扩展性的唯一可行解。