WaiT:让高频先等等!Meta频域流匹配算力减半创下像素SOTA
WaiT for the Signal: Simple Frequency-Aware Flow-Matching
高分辨率图像生成正在经历一场范式演进。基于流匹配(Flow Matching)与扩散架构的模型,正在把分辨率一路推向 512、1024 乃至更高尺寸。然而,绝大多数主流方案在处理生成过程时,都默认把图像中的所有空间频率一视同仁。无论在去噪初期画布还是一团混沌,还是在后期雕琢毫芒,网络都在全分辨率空间中同时对低频和高频信息施加相同的计算量。
ArXiv URL:https://arxiv.org/abs/2607.28760
来自 Meta FAIR、巴黎高师与索邦大学的研究团队在最新论文中指出了这种做法的本质缺陷:在真实的图像物理世界中,高频信号被噪声破坏的速度远快于低频结构。在去噪过程的前半段,图像的高频分量在统计上根本就是不可分辨的纯高斯噪声。现有的全尺寸流匹配模型耗费了高达一半的计算量,在毫无意义的高频纯噪点上反复纠缠,反而削弱了模型建立全局语义与宏观结构的注意力。
为了打破这一僵局,研究团队提出了 WaiT(Wavelet-aware image Transformer)。其核心思想异常直观而精妙:名副其实地“等待信号”(Wait for the Signal)。通过可逆且无损的离散小波变换(Haar DWT),WaiT 将生成过程在频域上解耦为低频粗结构与高频细节。在去噪前期,高频分支彻底“按兵不动”,保持为纯噪声;只有当低频粗结构逐渐成型并穿过临界时间点后,高频噪声才接入流动,与低频信息协同收敛。
这一改动不依赖复杂的层次化多尺度网络设计,完全基于对噪声调度的重新编排。实验结果极具说服力:在 ImageNet 512$\times$512 无条件与类别条件生成任务中,WaiT 在推理算力降低高达 50% 的前提下,实现了 1.43 的像素空间 FID;其 2B 参数量的大模型更是以 1.30 的 FID 创下了像素级生成模型的最新 SOTA。这一机制不仅在纹理保真度上击败了主流潜空间模型,还零门槛泛化至 1024 分辨率文生图与视频生成任务,在 Kinetics-600 上取得了 0.84 的 SOTA FVD。
频率不对称:流匹配中被忽视的物理规律
自然图像在频域上遵循幂律衰减规律,低频蕴含着物体轮廓、空间布局和语义类别等宏观结构,而高频则承载着边缘、毛发和织物纹理等局部高阶细节。当高斯噪声注入图像时,由于高频分量本身的能量极低,其信噪比(SNR)崩塌的速度比低频分量快得多。
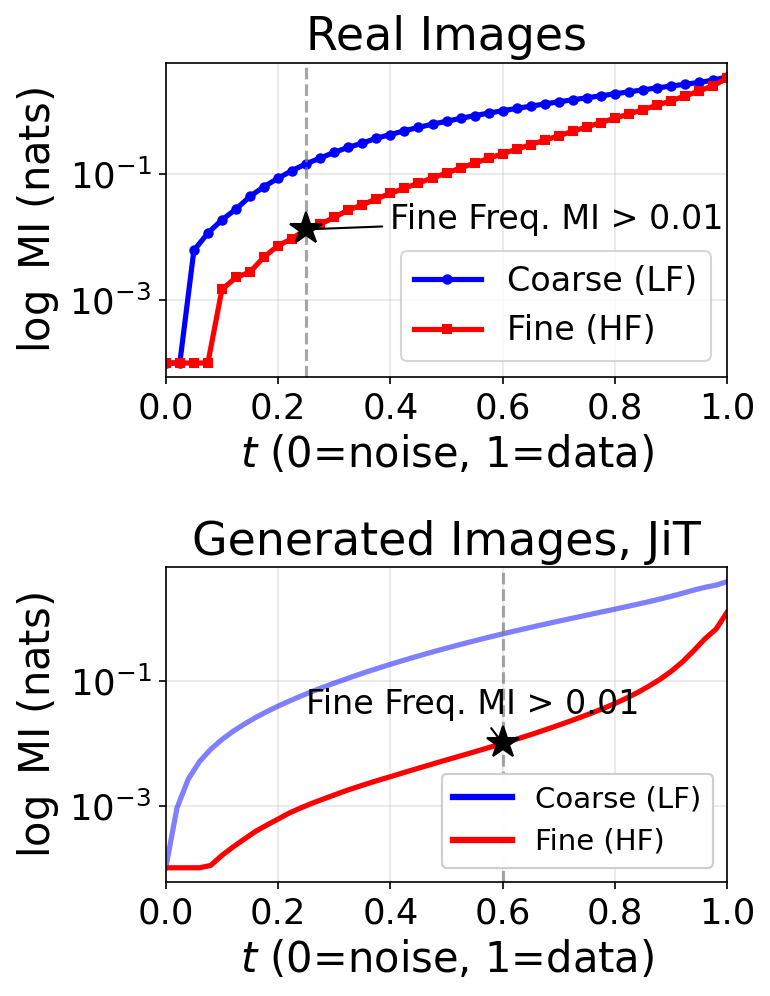
研究团队通过互信息(Mutual Information, MI)测量明确展示了这种时间维度的不对称性。如上图所示,在正向加噪过程中,高频频段与原始图像之间的互信息在时间参数 $t \approx 0.25$ 附近就已经归零(低于 0.01 nats),退化为与真实数据脱节的白噪声;而此时的低频频段依然保留着丰沛的语义信息。在标准 JiT 等模型的反向生成轨迹中,同样存在这种严重滞后:高频细节并非随着时间均匀生成,而是在去噪轨迹行进过半后才突然从噪声中析出。
这意味着现有的标准流匹配在去噪轨迹的前四分之一甚至前半段,都在强行让庞大的神经网络去拟合高频频段的纯白噪声。这种训练不仅徒劳耗费了海量算力,更分散了网络建立全局一致性的表征容量。如果在高频成分根本不具备学习信号时让它“等待”,待全局轮廓初定后再开启高频演进,就能从根本上重塑生成的质量与效率边界。
解耦与延迟:WaiT 的频域流动机制
针对这一直觉,WaiT 采用单层离散小波变换(Haar DWT)作为图像与频域之间的桥梁。单层二维 Haar 小波在数学上极为简洁纯粹:它以步长为 2 进行局部块运算,其低频分支(LF)相当于 $2\times2$ 的平均池化,直接压缩了空间尺度,维度降为原图的 $1/4$;而水平、垂直和对角线三个高频分支(HF)则精确记录了这四个像素之间的差异,占据其余 $3/4$ 的数据量。因为小波变换具有正交性与完全可逆性(IDWT),它完全不同于有损且需要预训练的 VAE 潜在空间,是一种完全无损且零额外参数的映射。
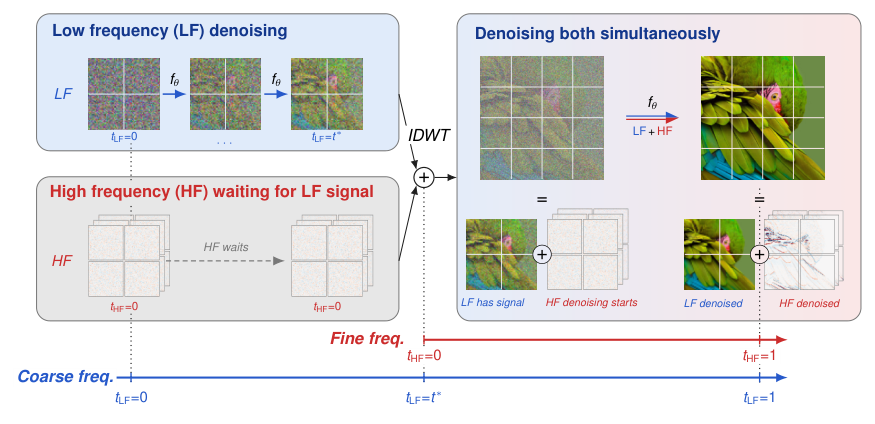
WaiT 的去噪过程分为两个紧密相连的阶段。在第一阶段(粗粒度阶段,时间步 $0 \to t^*$),模型仅针对低频分量 $z_{LF}$ 进行去噪。此时高频分量 $z_{HF}$ 保持为纯高斯噪声,完全不参与计算。这一阶段由于只处理低频 Token,网络输入的 Token 数量骤降至原本的 $1/4$,推理 FLOPs 呈现指数级收缩。
当时间步推移到临界交越点 $t^*$ 时,模型进入第二阶段(精细化联合阶段)。此时已部分去噪的低频信号与依然是纯噪声的高频信号相遇,系统通过小波逆变换(IDWT)将频域分量组合回原生空间,或者在全频段空间中共同演化直至 $t=1$。
为了让两阶段平滑过渡,WaiT 没有采用两套割裂的模型分别建模,而是设计了差异化的线性噪声调度体系。低频分量在全时间区间 $[0, 1]$ 保持标准线性演进:
\[z_{LF,t} = t_{LF} \cdot \tilde{x}_{LF} + (1 - t_{LF}) \cdot \epsilon_{LF}\]而高频分量的时间参数 $t_{HF}$ 则被映射到一个压缩的局部区间 $[t^*, 1]$:
\[t_{HF} = \max\left(0, \frac{t_{LF} - t^*}{1 - t^*}\right)\] \[z_{HF,t} = t_{HF} \cdot x_{HF} + (1 - t_{HF}) \cdot \epsilon_{HF}\]这种“延迟线性调度”保证了高频分量在 $t_{LF} \le t^$ 时 $t_{HF}$ 恒等于 0,即完全维持纯噪声状态;而在越过 $t^$ 后,高频噪声迅速加速流动,并最终在 $t=1$ 处与低频分量以连续、平滑的状态同时收敛到终点。
在数值稳定度方面,本文提出了精细的频带归一化方案。低频小波系数由于聚合了能量,其均方值通常大于 1。WaiT 使用训练集上低频绝对系数的第 95 百分位数 $S_{LF}$ 进行缩放:$\tilde{x}{LF} = x{LF} / S_{LF}$,避免了极端离群值或重尾分布破坏去噪轨迹。与此同时,高频小波系数保留其原生的物理稀疏性(大量近零系数与极少量强边缘系数),不加任何归一化,促使模型天然聚焦于结构边缘的高动态范围建模。
为什么硬切断不如平滑调度?核心消融解析
将生成拆分为多阶段的思路在 PixelFlow 或 Pyramidal Flow 等已有探索中也有体现,但以往方案多依赖于“分段式级联模型”:用一个模型在 $[0, t^]$ 上生成低分辨率,再通过另一个模型在 $[t^, 1]$ 上接力去噪。这种硬性切断(Hard Handoff)直接带来了严重的训练-推理分布偏移。
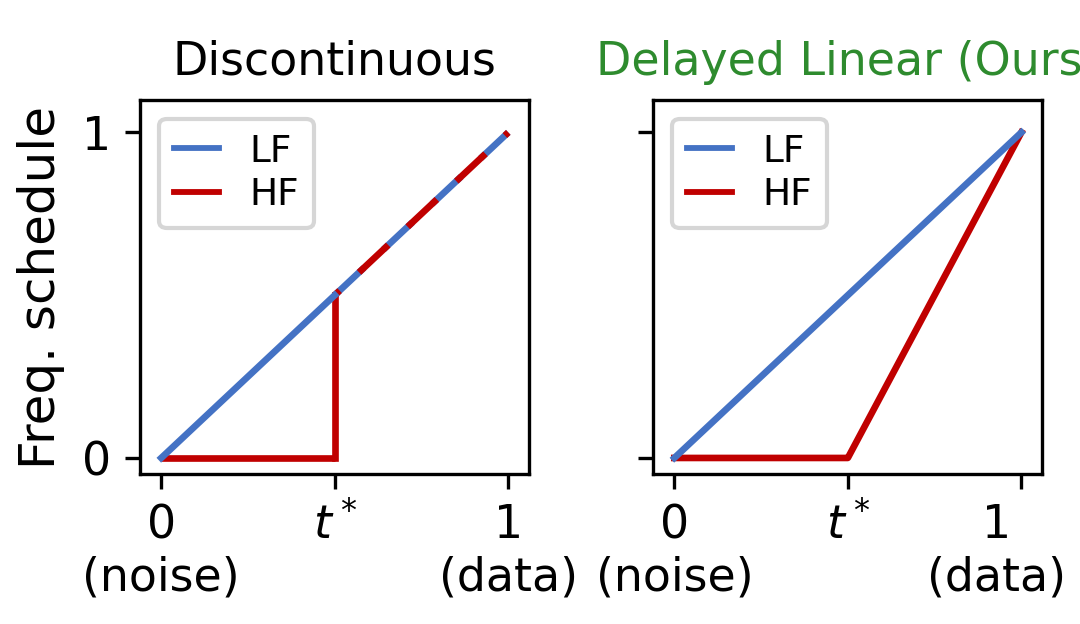
WaiT 团队对比了分段级联方案与单模型平滑方案的差异。在 ImageNet 256 上的消融实验显示:
-
如果使用传统的两阶段硬接力(在 $t^*=0.5$ 处直接注入噪声拼接),模型的 FID 仅有 7.51;
-
改用延迟线性调度后,低频与高频在一个统一模型内通过单次端到端联合训练完成演进,FID 瞬间缩减 2.08 降至 5.43;
-
进一步对交越点 $t^$ 进行网格搜索可以发现,当 $t^=0$ 时模型退化为标准均匀流匹配(即 JiT 基线);随着 $t^$ 右移,生成性能逐渐提升,在 $t^=0.25$ 处达到性能巅峰。这一数据与前文通过互信息理论测得的“高频信号在 $t \approx 0.25$ 彻底消失”形成了严密的互证。
训练目标上,WaiT 延用了 $x$-prediction 与 $v$-loss 的对应形式,但在频域对各频段进行了噪声权重的精确分配。针对第一阶段,粗粒度损失函数重点优化低频重构:
\[\mathcal{L}_{\text{coarse}} = \mathbb{E}_{t \sim U[0,1],\, x, \epsilon} \left[ (1 - t_{LF})^{-2} \| x_\theta(z_{LF,t}, t) - \tilde{x}_{LF} \|^2 \right]\]进入第二阶段后,精细化损失函数则根据各自频段的实际演化时间 $t_{LF}$ 与 $t_{HF}$ 独立加权:
\[\mathcal{L}_{\text{fine}} = \mathbb{E}_{t > t^*, x, \epsilon} \left[ (1 - t_{LF})^{-2} \|\hat{\tilde{x}}_{LF} - \tilde{x}_{LF}\|^2 + (1 - t_{HF})^{-2} \|\hat{x}_{HF} - x_{HF}\|^2 \right]\]这种频段感知损失赋予了流匹配更强的物理针对性,模型在不同时间步能专注在信噪比合理的尺度上发力。
戳破传统指标盲区:三轴评测体系
当图像分辨率提升到 512$\times$512 和 1024$\times$1024 时,学术界长期依赖的标准 FID 指标暴露出致命缺陷。标准 FID 的计算必须将输入图像强制双三次下采样至 299$\times$299 才能送入 Inception-v3 提取特征。这种粗暴的下采样直接过滤掉了图像最精华的高频微观纹理与局部细节。很多生成图像尽管在全局大轮廓上符合标准(获得极低的标准 FID),但在原生 1:1 分辨率下细看却充斥着涂抹感或高频噪波。
为了客观评测超高分辨率生成的真实成色,WaiT 团队引入了严格的三轴评估标准:
-
全局连贯性(Global Coherence):沿用标准 FID,度量全图语义和宏观结构分布;
-
局部结构细节(Local Detail):采用 5-crop FID(5cFID),从原生分辨率图像的四个角落及中心分别截取无缩放的 $299\times299$ 局部图像块进行统计,严禁下采样破坏局部结构;
-
高频纹理保真度(Texture Fidelity):引入高频 Fréchet 小波距离(hFWD),通过小波分析提取高频子带系数,直接衡量高频分布与真实图像的物理契合度。
人类偏好测试表明,相比于常规 FID,5cFID 和 hFWD 与人工感官评估的高保真、清晰度呈现出高得多的正相关性。
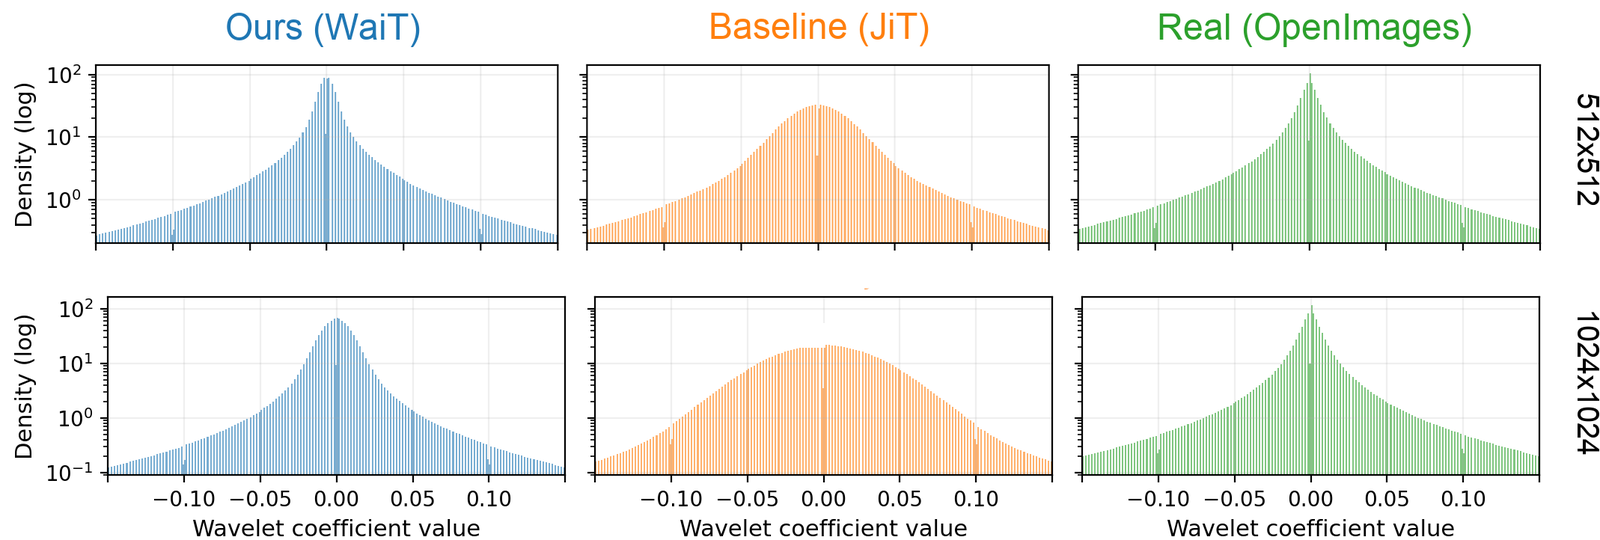
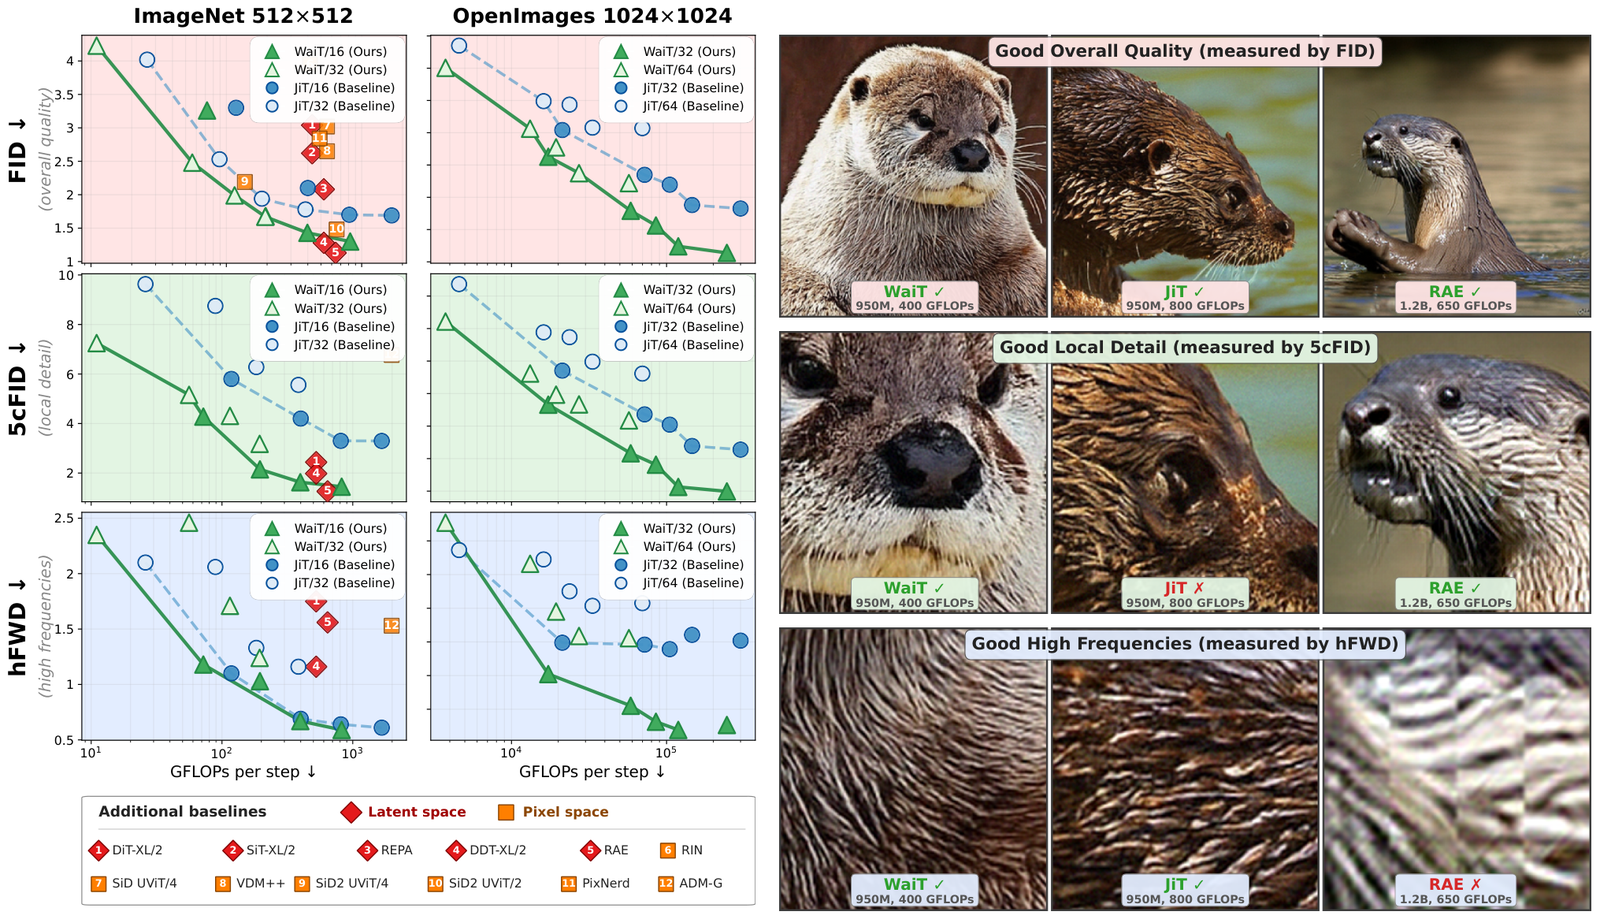
在上图展示的高频小波系数统计中可以清晰看到:随着分辨率提升至 1024,原生基线模型 JiT 生成的高频系数分布急剧展宽、变扁,说明其充斥着不符合真实物理分布的杂乱伪影;而 WaiT 生成的高频小波分布始终极其严密地紧贴真实数据分布曲线(GT)。WaiT 不仅消除了伪影,更把画笔精准落在了真实的毛发、纹理和边缘上。
实验突破:全线刷新的帕累托曲线与跨模态扩展
在 ImageNet 512$\times$512 经典基准上,WaiT 展现出了压倒性的帕累托最优性能。无论在何种算力预算下,WaiT 的三项指标均全面优于已有的像素空间代表模型(如 JiT)和主流潜在扩散模型(如 LlamaGen、DiT 等)。
具体而言,以 WaiT-H/16 为代表的模型,仅耗费低于 400 GFLOPs 的采样计算量,就达成了 1.43 的 FID、1.63 的 5cFID 以及 0.67 的 hFWD。相比对标的 JiT 基准,WaiT 在推理算力节约近一半的同时大幅胜出;而扩大至 20 亿参数的 WaiT-G/16 模型,更是直接将像素空间模型的最佳纪录推到了 1.30 FID。在纯粹度量纹理真实度的 hFWD 维度上,WaiT 甚至跨空间击败了配备复杂预训练编码器的主流潜在空间模型。
这种优势在更大尺度原生数据集(OpenImages 512 与 1024 分辨率)上被进一步放大。论文指出,ImageNet 中只有极少部分图片的原始短边大于等于 512,强行测试 1024 只会引入插值伪影。在天然高分辨率的 OpenImages 1024 验证中,WaiT 的生成细节显著纯净于对比模型,彻底摆脱了像素扩散模型在高分辨率下容易产生的毛躁与浑浊。
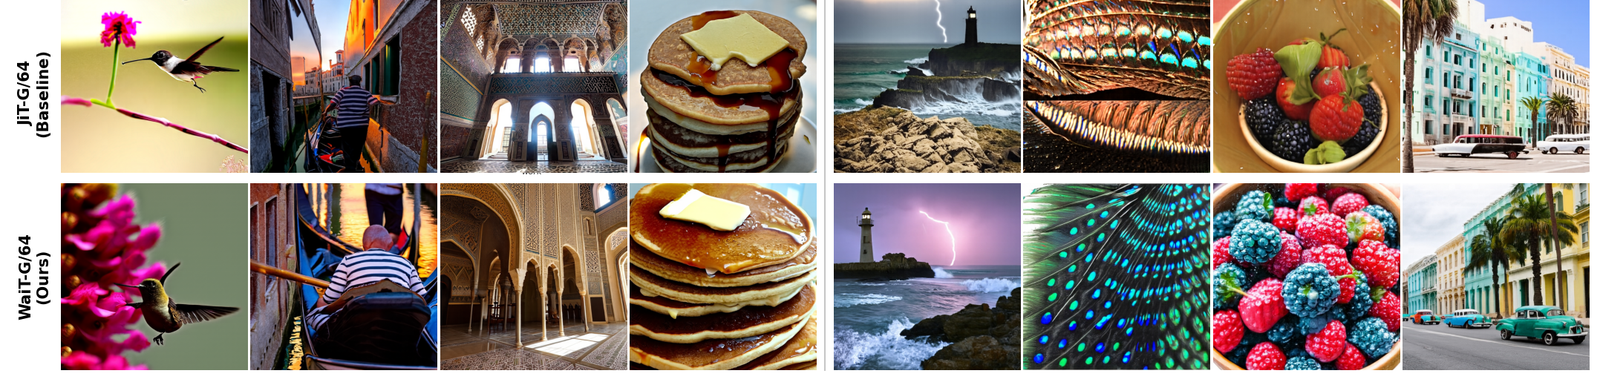
除了条件图像生成,研究人员还将这套机制直接平移至更大规模的 1024 分辨率像素空间文生图任务中。训练数据涵盖 SA-1B 与 DataComp-Multimodal 等。如上图所示,在完全相同的网络参数下,WaiT 产出的画面在毛发细节、反射光影与复杂排版文字的锐度上远超基准,同时带来了最高 3 倍的推理吞吐量提升。
更引人注目的是在时序视频领域的无缝泛化。视频生成面临着更夸张的时空 Token 膨胀压力,对计算量极为敏感。研究团队将单层空间小波直接扩展为三维时空小波(Spatiotemporal Wavelets),对时间轴与空间轴联合分频,算法代码与核心调度逻辑不做任何特异性修改。
在 Taichi-HD 和 Kinetics-600 视频基准的实测中,WaiT 在减少约 30% 计算量的前提下,生成流畅度和画面稳定性全面反超原生扩散方案,在 Kinetics-600 上斩获了 0.84 的 SOTA FVD 成绩。这一结果证明,频域信号延迟出现的物理规律在自然界动态时空中具有普适性。
极简设计的力量与像素生成的前景
长期以来,基于预训练自编码器(如 VAE)的潜空间生成模型在效率上占据绝对优势,但其代价是不可挽回的高频细节压缩损失,以及预训练编解码器带来的误差累积与伪影问题。像素空间模型虽然保真度上限高,却受制于全分辨率的高昂计算代价难以扩展。
WaiT 的出现为像素空间生成模型注入了一剂强心针。它没有走堆叠特征金字塔、引入复杂跨注意力分支或设计专有网络的老路,而是用经典的无损 Haar 小波,精准对应了扩散生成中不同频段信息浮现的时间窗口。让高频“等待信号”,表面上只是简单地推迟了高频的介入时机,实质上是对生成模型算力资源的一次深度纠偏与重分配。
这项研究表明,流匹配模型性能的提升,并不必然依赖更庞大的参数堆叠或繁琐的网络技巧。深刻理解物理世界在信息学层面的本质规律,并将其转化为优美简洁的归纳偏置(Inductive Bias),往往能以极低的改造成本,爆发出跨越架构与模态的生命力。