Bunraku:不是放大模型,而是联合预测!单张插画直出可交互Live2D资产
Bunraku: Turning a Single Illustration into an Editable Live2D Character
在虚拟主播、二次元二次元手游和各类交互式虚拟陪伴产品中,Live2D 长期占据着统治地位。与传统的 3D 骨骼蒙皮动画相比,它完整保留了插画师笔下的笔触质感与赛璐璐风格;与扩散模型直接生成的视频序列相比,它又是一个具有明确参数接口、能以极低算力在终端实时驱动的结构化资产。
ArXiv URL:https://arxiv.org/abs/2607.27348
但在工业管线中,产出一个全精度 Live2D 模型极其耗时费力。一位熟练的制作人员通常需要耗费四到八周时间,逐层拆解几十上百个图层、手动画出被遮挡的内层结构、为每个部件布设三角网格,并为数十个控制参数逐一手动捏出关键帧位移。这一漫长的结构化绑定流程,往往导致单体资产外包成本高达上千美元。学界与工业界过去探索过分层生成或图生视频技术,但前者只停留在像素切分,无法运动;后者输出的只是固定像素流,一旦参数超出预设范围便无法实时交互。
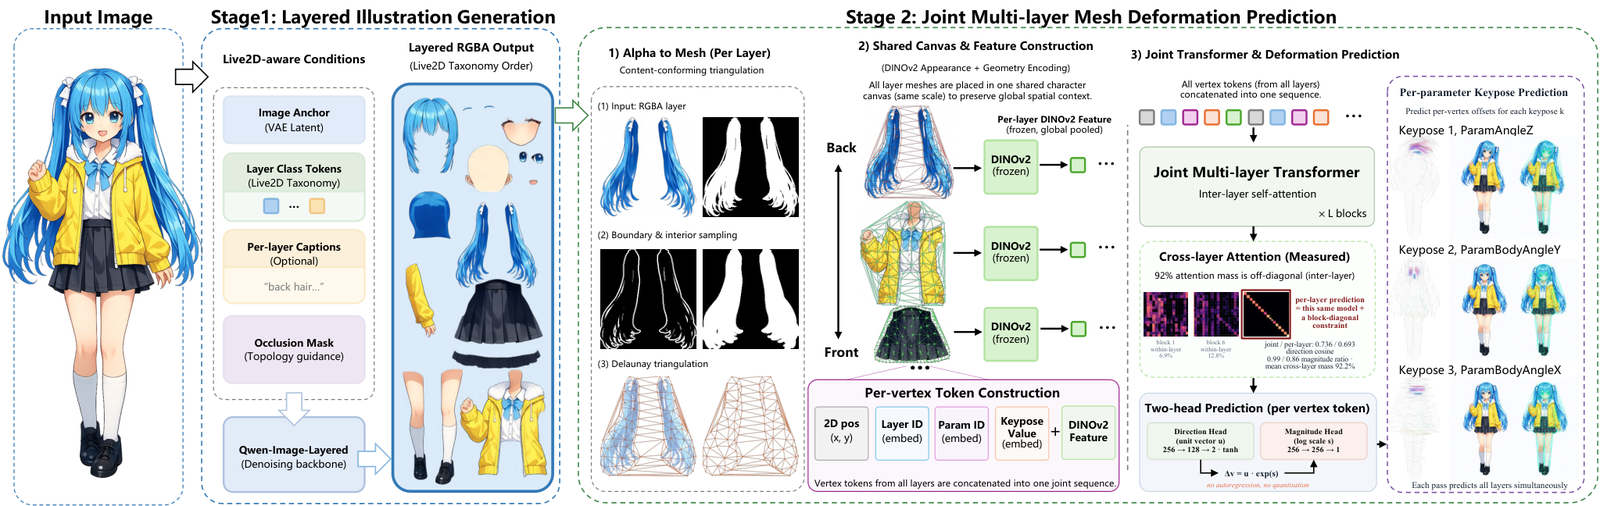
针对这一断层,新研究提出了首个从单张静态插画直接端到端生成完整可驱动 Live2D 资产的系统 Bunraku。该系统的命名源于日本传统木偶净瑠璃(Bunraku),寓意多个操作者在统一的节奏下协同牵引同一个木偶。Bunraku 不仅能够实现高质量的遮挡补全分层,更在第二阶段颠覆了传统“逐部件独立预测位移”的假设,将全角色所有图层的全部网格顶点放置于统一坐标系内,使用单一 Transformer 联合预测形变场。在 50 个完全未见过的测试角色上,联合预测机制将网格运动方向的平均余弦相似度推升至 0.768(中位数达 0.828),彻底解决了五官与躯干各自形变导致的破面撕裂问题。
为什么现有视频生成替代不了 Live2D 资产?
在评估生成模型对 2D 角色动画的价值时,许多人倾向于将目光投向以可控视频扩散(Video Diffusion)为代表的像素生成模型。这些模型确实可以通过姿态骨架(Pose)、线稿引导甚至稀疏 3D 点轨迹让一张立绘动起来。但视频生成模型输出的是已经烘焙好的栅格视频帧,其底层并没有几何支撑,更没有状态机。
工业引擎所需要的交互资产,必须具备两个硬性特质:其一是参数连续可驱动,例如面部朝向、眨眼幅度或嘴型开合必须绑定在标准浮点数滑轨上,运行时能够随外部输入实时插值;其二是完全解耦与可再编辑性,美术团队应当能够随时替换一套服装纹理,而不破坏已经调好的动作绑定。
现有的结构化生成工作同样存在局限。3D 网格生成虽然可以自回归地生成点面序列,但 3D 拓扑和权重难以直接套用在扁平手绘插画上;矢量动画生成(如 LottieGPT)只能在 SVG 路径和贝塞尔曲线之间插值,根本无法承载带有复杂纹理细节的栅格位移;多层图像扩散模型虽然学会了拆解 RGBA 图层,却在网格布设和动作绑定前止步。这意味着,从扁平原画跨越到可运行资产的整条链路,关键瓶颈落在了“如何让数十个互相遮挡的图层网格,在参数驱动下作为一个统一整体协调变形”。
阶段一:遵循解剖学分类体系的遮挡补全分层
Bunraku 的第一阶段(Stage 1)专注于图层拆解与盲区补全。如果一个角色的袖子没有在图层拆解中被完整剥离,或者后发图层缺失了被前胸遮挡的发丝,后续的网格生成无论多精细都无法弥补这种几何缺失。消融实验也证实,图层缺失是造成端到端失败的最主要错误通道。
研究团队基于 Qwen-Image-Layered 进行深入改造,摒弃了通用视觉任务中粗糙的“前景/背景/装饰”标记,构建了专门适配 Live2D 规范的“8 大类、32 子类”层级分类体系(包含头发、面部皮肤、眼睛、嘴部、头部饰品、躯干、手臂和下半身)。在训练中,模型同时接收静态原画的 VAE 潜在编码、Live2D 规范类别 Token、可选的图层文本描述,以及用于监督遮挡区域绘制的掩膜。
通过在专门收集整理的近万个工业级 Live2D 模型上微调,Stage 1 输出的不再是简单的透明通道抠图,而是按严密 Z 轴深度顺序排列、被前序图层遮盖区域已自动绘制完整的 RGBA 图层序列。在实测角色中,部分内部图层有超过 40% 的面积完全由扩散模型在无直接视觉线索的情况下凭先验补齐,为后续的形变支撑提供了完整的纹理底板。
阶段二:从 Alpha 通道生成自适应三角网格
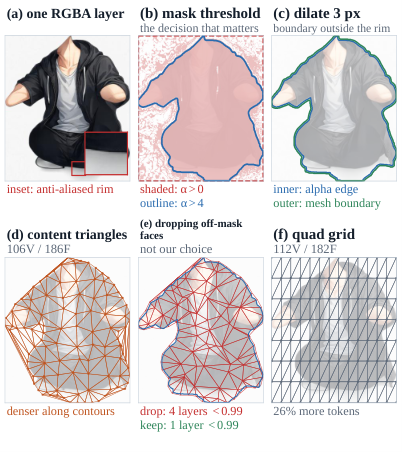
拥有了补齐的图层之后,系统需要为每个图层赋予物理变形载体。在传统 Live2D 制作中,网格必须紧密包络透明边缘,同时内部需要有足够均匀的采样点以保证弯曲时的平滑度。Bunraku 在 Stage 2 采用了一种完全确定性、无须学习且不产生随机采样的算法:仅依靠每个图层的 Alpha 通道即可派生出贴合轮廓的高性能三角网格。
网格生成的各个细节均由严格的几何约束决定:
首先,系统将阈值设定为 $\alpha > 4$(以 255 为满值),这一极小的容差能过滤掉抗锯齿阶段产生的半透明杂点,同时保留微弱的羽化轮廓;随后将边缘轮廓向外膨胀 3 个像素,确保在极端扭转变形时,纹理采样不会发生边缘截断。
其次,系统提取该图层的所有外轮廓并按弧长成比例分配边界顶点。这一设计尤为重要,因为动漫发型常常存在分离的发丝、发尾或悬浮饰品,如果仅抓取最大连通轮廓,分离部件将被直接丢弃。
最后,在由轮廓约束的有效区域内部注入带有轻微扰动的晶格点,并运行 Delaunay 三角剖分。
最终,大约 55% 的顶点预算集中在精准贴合的不规则边缘上,其余顶点均匀散布于内部。相比于粗暴的均匀四边形网格,这种自适应三角网格不仅显著减少了无效透明区域的计算浪费,还将整个人物的顶点总数压缩到了极具计算经济性的区间。
核心机制:全顶点跨图层联合预测
在拿到全图层的网格之后,真正的难题浮出水面:如何让每个图层上的成百上千个顶点在不同控制参数下协同运动?
如果将各个图层独立输入网络,分别预测各个部件的关键姿态位移,虽然形式上最简单,但也是最容易产生严重破绽的做法。一旦瞳孔的位移幅度比眼白快了几个像素,或者刘海在侧脸转动时的偏转角度与面部轮廓脱节,整个画面的角色一体感就会瞬间瓦解,出现严重的视觉撕裂。
为了彻底根除这种撕裂,Bunraku 确立了其最关键的核心思想:全图层必须作为一个单一序列联合预测。
具体而言,网络放弃了在每个图层的局部外接矩形中计算坐标的做法,而是将一个角色全部 $N$ 个图层的所有顶点坐标 $v_{i,j}$ 全部映射到 $[-1,1]^2$ 的统一全角色画布坐标系中。这样一来,发卡与头发、眼球与眼眶之间的绝对相对距离,在输入特征中就得到了客观保留。
每个图层的每个顶点都被视作自注意力序列中的一个独立 Token。其初始输入向量由四部分构成:顶点的空间位置傅里叶编码、当前驱动参数的嵌入向量(例如头部偏转、嘴部开合)、当前控制滑轨数值的傅里叶编码,以及图层在层叠关系中的位置编码。
紧接着,系统为每个图层提取一个全局视觉引导。这里研究团队做出了一个违背直觉但极其关键的工程抉择:只使用图层全局池化特征,拒绝局部密集纹理特征。在早期实验中,团队曾尝试在每个顶点的精确二维坐标处双线性采样 DINOv2 的 Patch 特征,希望让网络感知局部的明暗。但评测显示,精细的局部特征反而让网络陷入对特定角色微观纹理的过拟合,在跨角色泛化时方向余弦相似度直线下跌,位移幅度比例校准显著恶化。
改用全局平均池化后的 384 维向量后,网络仅被告知“当前顶点属于一撮长双马尾,而非坚硬的护肩”,促使其完全聚焦于大尺度拓扑与相对几何位置。
当所有图层的顶点拼接为长度为 $T = \sum_{i} n_i$ 的超长序列后,数据被直接送入单一非自回归 Transformer。自注意力机制完全打破图层边界:92% 的注意力权重分布在对角块之外,这意味着某个图层顶点的位移计算,完全建立在全角色其他所有图层顶点上下文的基础之上。
关键发现:缩放模型无用,协调机制才是质变点
在模型规模与训练目标的探索中,Bunraku 揭示了一系列值得整个结构化生成领域警醒的实验事实。
首先是对自回归离散化方案的否定。在探索初期,研究团队曾尝试遵循类似 3D 网格生成的流行做法,将位移量量化为离散 Token 并通过自回归模型生成。但结果表明,在底模网格已经确定的情况下,强行离散化位移不仅损失了几何连续性,其纸面上的高精度也完全是被自回归训练中的“教师强制(Teacher Forcing)”虚高掩盖。在真正推断时,误差会迅速累积漂移。最终,团队全面转向非自回归的直接回归网络,并将二维位移显式分解为“有界方向向量 + 对数幅度(Log-magnitude)”,以应对 Live2D 动作中重尾分布的微小位移与大幅度形变共存的问题。
更令人震惊的结论来自于参数量缩放实验。直觉上,处理这种高维复杂协调任务往往需要参数量极大的大模型支撑。但当研究人员将 Stage 2 的 Transformer 参数量从 5.1M 依次扩展至 571.6M 时,泛化评估指标几乎没有出现任何提升;当进一步扩大到 1.0B 参数时,训练甚至直接走向了发散崩溃。
这一强有力的反常识现象说明:阻碍 2D 插画骨骼/网格绑定的技术死结,根本不是模型的表征容量,而是缺乏足够多样性的工业级高质量绑定语料,以及缺乏强制各部件跨图层对齐的几何协调机制。将各个图层独立预测的模型与联合预测模型对比,独立模型的方向余弦得分仅为 0.693,而仅需 5.1M 参数的联合模型直接跃升至 0.768。联合建模带来的协调一致性,正是填平撕裂鸿沟的决定性因素。
真正的资产级自由度:自然语言驱动的重绘与换装
将整套流程固化为标准化 Live2D 格式的巨大优势在于,下游的使用体验与传统工业管线完全无缝兼容,同时解锁了生成式模型此前无法企及的稳健可控性。
在推理完成后,系统输出的是标准 Cubism 参数网格。在运行时,无论是实时动捕驱动的面部朝向参数(ParamAngleX/Y),还是呼吸、眨眼或下颌张合,都仅仅是在所预测的两个极限姿态之间执行轻量级的线性插值。这意味着该资产可以在移动端、网页或游戏引擎中以数百帧的帧率实时无延迟回放,完全不需要每次动作更新都重新调用庞大的神经网络推断。
更为精妙的特性体现在资产的解耦复用上。由于第二阶段每个图层的自适应网格完全由且仅由其 Alpha 掩膜生成,网格拓扑并不绑定特定的颜色像素。如果在资产生成后,用户希望通过自然语言将角色的校服换为礼服,或者调整衣物的图案材质,管线可以直接在第一阶段的图层级别使用局部文本重绘工具(如基于文本的局部 Inpainting)修改该图层的 RGB 内容,只要该操作没有改动图层的透明轮廓,此前预测出的所有网格结构与几十组参数关键帧位移都可以实现逐字节(Byte-for-byte)的无损复用。
这种“在资产内部闭环解耦”的能力,正是像素级视频生成模型至今无法逾越的工业门槛。
迈向全自动 2D 互动资产的里程碑
为了建立可复现的评测基准,研究团队开源了涵盖 8,884 个高精度工业级角色的多层动画数据集,并提出了首个覆盖图层解构、网格健康度与位移保真度的标准化测试集 Live2D-Bench。在测试中,即使面对风格各异、从网络上直接抓取的野生静态同人画作,系统依然展现出极其稳定的分层与绑定能力。
Bunraku 证明了一件事:让扁平艺术品动起来的最高效路径,未必是用数以百亿计参数的视频生成器去暴力模拟每一帧的光影重绘,而是用轻量而精准的几何先验,去自动化人类动画师创造结构化资产的过程。
当单张插画不再需要耗费数周的纯体力手工拆解与调点,虚拟角色的创作门槛将被彻底击穿。从概念设计草图直达可实时互动的虚拟偶像,2D 内容生产管线正正式跨入资产端到端生成的全自动时代。