AttriMem:Token级归因切入过程反馈,破解Agent记忆学习瓶颈
AttriMem: Attribution-Guided Process Feedback for Agent Memory Learning
在多轮交互与跨会话的长程任务中,大语言模型(LLM)驱动的智能体面临着严峻的上下文管理挑战。海量历史信息不仅冗长,而且关键线索往往高度稀杂碎地散落各处。为了防止长上下文带来的计算爆炸与“大海捞针”式的注意力衰减,构建外部记忆模块已成为学界与工业界的共识方案。然而,外部记忆库究竟该如何构建与维护——在什么时候写入、合并、压缩还是丢弃哪些信息——始终是决定智能体推理上限的核心瓶颈。
ArXiv URL:https://arxiv.org/abs/2607.21106
现有的记忆构建策略主要分为两大阵营:一类是依赖人工规则的启发式机制,这类方法高度主观,极易出现记忆目标与下游推理需求的错配;另一类则是基于强化学习(RL)的目标驱动方法,虽然能根据下游任务表现进行动态演进,但由于长期受困于粗粒度的“信用分配(Credit Assignment)瓶颈”,策略往往难以精准优化。来自浙江大学等机构的研究团队提出了 AttriMem,这是一种通过归因技术提取过程反馈的 Agent 记忆学习框架。其核心思想在于:不再将记忆动作当成黑盒,而是利用最终答案的变化反向推导中间记忆中具体到 Token 级别的贡献,将全局结果奖励与局部过程奖励深度融合。这一设计不仅在 LongMemEval、LoCoMo、PerLTQA 等多个长程记忆评测基准上超越了现有最强基线,更让小模型在脱离强监督微调(SFT)冷启动的前提下,仅凭强化学习即可实现显著的记忆策略进化。
记忆构建的两难困境:规则主观与奖励稀疏
要让智能体在数万 Token 的交互长河中保持清醒,记忆策略必须在每个时间戳对当前交互做出增量式决策。过去以 Mem0、A-Mem、LightMem 等为代表的启发式方案,本质上是在预设一套关于“什么是重要信息”的人工假设。人类专家认为重要的实体、关系或总结,在面对特定下游问答决策时可能毫无价值;而真正决定推理生死的微小细节,往往被固化的压缩规则过早抹杀。这种设计逻辑上的客观错配,直接限制了记忆系统在复杂、跨领域任务中的泛化能力。
转向强化学习看似是一条自然的解决路径。然而,强化学习面临着记忆构建任务固有的延迟与模糊反馈困境。在经典的 Task-Performance RL 框架下,环境只能给出最终答案“对”或“错”的标量反馈。智能体在一个长达数十轮的会话中执行了数百次记忆写入与更新,仅仅依靠最终一个回答的胜负,根本无法分辨是第 3 轮写入的时间戳立了大功,还是第 10 轮保留的冗余事实拖了后腿。
为了缓解稀疏反馈,后续研究开始尝试过程奖励的探索。例如 Mem-T 尝试在采样树上将最终奖励向祖先节点回溯重分配,但这种方式并没有引入新的信息量,本质上依然是最终结果的机械平摊;更进一步的 MemBuilder 则引入了辅助问答对,通过评估中间记忆是否被检索且辅助生成了正确答案来为动作打分。尽管 MemBuilder 将反馈推向了动作级(Action-level),但它依然把“记忆条目”视作一个不可分割的整体。一个包含数十个词的记忆片段里,可能只有三五个 Token(例如关键数字、名字或时间节点)真正支撑了下游决策,其余内容皆为噪音。将同等大小的正向奖励广播给整段记忆,不仅难以教会模型过滤无关细节,反而极易在策略更新中强化无意义甚至有害的冗余文本。
构建细粒度过程监督的根本难点在于:中间记忆决策几乎不存在客观且唯一的标准答案(Ground Truth)。同一个最终推理路径,完全可以通过多种不同组织形式的记忆来支撑;究竟哪条记忆内容应该被赋予信用,与智能体在生成阶段选择的具体推理轨迹紧密耦合。静态的人工标注在多变的长程推理环境中注定失效,如何动态、准确地衡量中间生成内容的真实价值,正是必须跨越的理论死结。
归因驱动的过程反馈机制
AttriMem 破局的关键,在于将下游已生成的最终答案作为溯源标靶,通过敏感度分析(Attribution)直接量化中间记忆文本对最终输出的因果贡献。它不再试图预先制定一个抽象的“优秀记忆”标准,而是务实地回答一个物理问题:如果扣掉记忆里的某几个 Token,最终答案的置信度会不会发生雪崩?
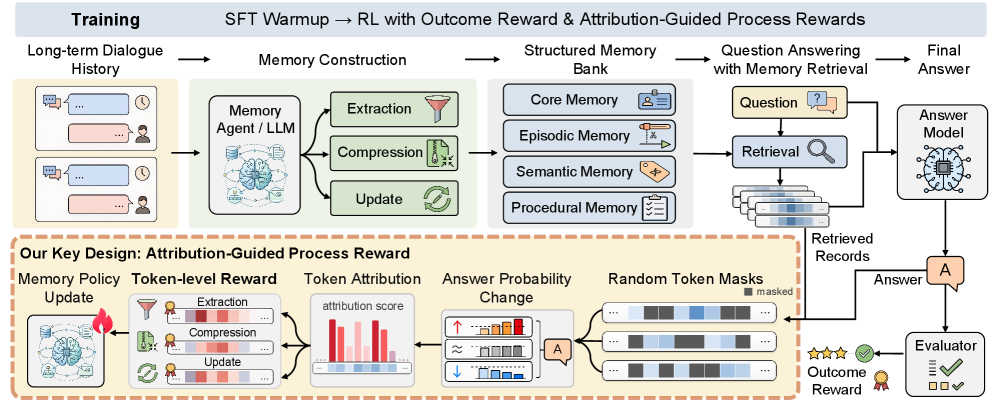
如上图所示,在 AttriMem 的整个强化学习闭环中,记忆策略网络在与环境交互的过程中,逐步执行提取、更新、合并等记忆动作,构建出外部记忆库。随后,在面对下游长文本问答请求时,系统利用一个冻结(Fixed)的检索器与问答生成器完成推理,输出预测答案。
在训练阶段,AttriMem 突破性地引入了双层奖励机制。首先,模型依然计算一个评估全局回答质量的最终结果奖励 $R^{\mathrm{out}}$,并转化为全局优势值 $\hat{A}^{\mathrm{out}}$。在此基础之上,AttriMem 启动反向归因计算。具体而言,它对中间记忆库中的文本内容进行随机掩码采样,通过对比完整记忆上下文与掩码部分上下文时问答模型输出 logits 的差异,推导每个 Token 的边际贡献:
\[\phi(z_i, y; c) \approx F(y \mid c) - F(y \mid c \setminus z_i)\]这里,$F(y \mid c)$ 代表在上下文 $c$ 下模型生成答案 $y$ 的对数概率测量,而 $z_i$ 即为被扰动的特定 Token。通过这种计算,AttriMem 能够精确获取每个动作所产出的第 $k$ 个 Token 的局部过程奖励 $r_{i,t,k}^{\mathrm{proc}}$。在策略梯度的反向传播中,最终的综合优势函数被表达为:
\[\hat{A}_{i,t,k} \coloneqq \hat{A}^{\mathrm{out}}_i + \lambda \hat{A}^{\mathrm{proc}}_{i,t,k}\]这一公式彻底重塑了记忆策略的更新方向:即使整个任务最终失败了(全局结果奖励为负),那些在中间阶段精准提取出核心实体的 Token 依然可以通过正向的过程优势获得鼓励;反之,哪怕整个任务侥幸成功,记忆片段中混入的大量无意义修辞与干扰性 Token 也会受到过程层面的惩罚。这种将标量反馈拆解为“全篇广播 + 单字校正”的混合反馈形式,从根本上打破了长期制约长程 Agent 记忆学习的信用分配瓶颈。
Token级归因的威力:从黑盒粗放到靶向提纯
为了直观展现 Token 级信用分配与传统动作级奖励的本质差异,本文提供了一组极具代表性的案例对比。在模型完成 SFT 初始化的同一记忆状态下,传统方法与 AttriMem 对同一段记忆文本的奖励分配截然不同。
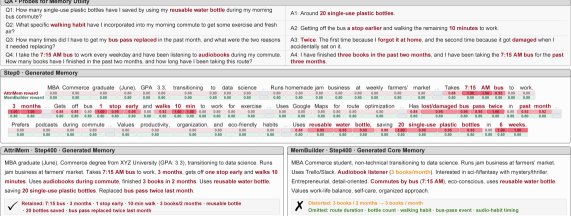
如上图案例所示,在未引入强化学习时,基座模型生成的原始记忆往往掺杂了大量非关键的背景描述(例如无关的天气、主观的闲聊情绪)与少量的关键事实(精确的日期、数量或行动指令)。MemBuilder 这类动作级方案在判定该记忆有助于回答时,会将均一的正奖励打在整段文本上;而 AttriMem 的归因图谱则清晰地显示,奖励呈现出高度离散的尖峰特性——只有那些直接支撑问答决策的核心名词、时间戳与谓词获得了显著的正向信用,多余的修辞不仅没有奖励,甚至因为引入了干扰而被赋予微弱的负值。
这种精细度在强化学习的收敛阶段产生了决定性分歧。经过强化学习优化后,传统动作级反馈训练出的策略表现出明显的“记忆膨胀”与“关键细节缺失”,因为它在训练中频繁收到关于整段文本的粗糙正反馈,学会了通过生成更长、更宽泛的模糊语句来“蹭”奖励,反而导致核心信息的准确率下降;而由 AttriMem 驱动的策略,在进化后能够主动丢弃冗余表达,记忆结构高度提纯,输出的内容紧凑且信息密度极高,甚至能自动纠正先前的幻觉细节。
实验评测:超越基准与跨域泛化
评估 Agent 记忆能力不仅要看在熟悉环境下的问答准确率,更要考察其面对未知分布、甚至脱离优质初始化时的真实强化学习能力。AttriMem 在以 LongMemEval 为主训练集的基础上,对 LoCoMo 和 PerLTQA 进行了严格的零样本跨域迁移(Zero-shot Transfer)评测。
在整体准确率层面,实验数据展现出了 Token 级归因的压倒性优势。在经过相同的 SFT 预热后,AttriMem 在 LoCoMo、LongMemEval 和 PerLTQA 三个基准上分别取得了 82.48%、83.25% 和 84.49% 的优异表现。相比于之前最强的强化学习记忆框架 MemBuilder,AttriMem 分别取得了 2.47、1.50 和 0.75 个百分点的显著提升;相比于非 RL 的启发式记忆基线,领先幅度更是扩大到数个百分点以上。即使是在完全未参与训练的 LoCoMo 与 PerLTQA 两个迁移基准上,AttriMem 依然刷新了当前 SOTA,证明这种基于下游敏感度的 Token 级策略优化具有极强的领域普适性。
更具说服力的一项发现在于消融实验中对 SFT 依赖性的测试。以往的研究(包括 MemBuilder)普遍得出一个结论:直接在基座模型上跑强化学习几乎无效,甚至会导致模型策略崩溃,必须先经历高质量专家轨迹的 SFT 冷启动。然而,AttriMem 的测试颠覆了这一固有认知:
-
在完全不进行 SFT 初始化的纯粹强化学习设置下,基于结果奖励的粗粒度 RL(RLOut)提升极其微弱,MemBuilder 仅能为基座模型带来 0.10 到 2.00 分的微弱提升;
-
采用 Token 级归因过程奖励的 AttriMem(RLTok),在无 SFT 的情况下,直接让基座模型在三个评测集上暴涨了 2.26 至 5.50 个百分点,甚至超越了动作级归因(RLAct)将近 1.5 分。
这一结果有力地证明:过去强化学习在 Agent 记忆策略上过度依赖 SFT,并非强化学习范式本身的缺陷,而是粗粒度信号在极度宽广的动作空间中无法有效引导梯度。细粒度的 Token 归因直接填补了动作空间中价值梯度的空白,即使没有专家轨迹的引路,策略网络依然能够自行摸索出提炼高价值记忆的正确路径。
记忆质量与推理效率的帕累托最优
评估记忆系统不能仅看问答的最终分数,中间产出的记忆库本身是否干净、紧凑,直接关系到整个系统的推理成本与长期运行的鲁棒性。
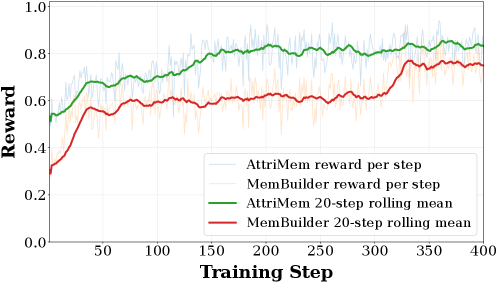
首先在训练稳定性方面,从上图展示的训练曲线可以观察到,引入 Token 级归因反馈的 AttriMem(RLTok),其收敛速度与稳定性显著优于纯结果奖励(RLOut)和动作级奖励(RLAct)。粗粒度的反馈导致策略梯度在长序列中剧烈震荡,而精细的过程奖励充当了强有力的正则化锚点,大幅削减了 RL 训练中的方差,使得优化过程平滑且持续向上。
除了量化指标,研究人员还引入了基于 GPT-4 的盲测裁判机制,对不同方法生成的中间记忆文本进行多维度的定性评估。在针对信息完整性、去噪水平与逻辑条理性的对比中,AttriMem 生成的中间记忆对 MemBuilder 取得了 72.94% 至 77.78% 的极高胜率。这表明经过细粒度归因洗礼后的策略,其自主构建的外部记忆库不仅更契合下游检索器的偏好,在人类可读性与信息凝练度上也达到了工业级的高标准。
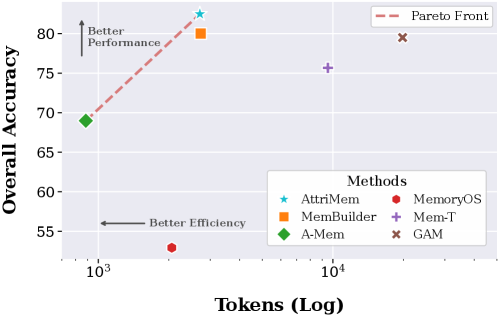
对于面向真实落地场景的 Agent 系统而言,Token 的消耗量就是真金白银的硬件与调用成本。上图绘制了各个记忆范式在“端到端单题 Token 消耗”与“问答准确率”之间的权衡散点图。可以看到:
-
传统的启发式方法如 A-Mem 虽然计算极快、Token 消耗极低,但由于关键信息大量损耗,其准确率表现垫底;
-
依赖重度检索与保留大段对话的基线(如 Mem-T、GAM)则深陷上下文膨胀泥潭,吞噬了数倍的 Token,准确率却未能成比例提升;
-
AttriMem 则稳稳地占据了帕累托最优前沿(Pareto Frontier)的最顶端。它在保持最高准确率的同时,端到端平均 Token 消耗与 MemBuilder 持平,并且远低于 Mem-T。这充分印证了 AttriMem 的设计哲学:它并不是通过“死记硬背”更多上下文来提升推理命中率,而是教会了 Agent 如何用最精练的词句承载最高密度的信息。
计算开销与未来演进
从工程实现的角度审视,AttriMem 依赖于对记忆文本不同子集的遮蔽采样来估计归因值,这必然会在训练阶段带来额外的模型前向推断开销。作者在文中坦陈了这一点,但也给出了实用的工程对策:由于所有的掩码变体本质上都是针对问答模型的只读推理,不涉及中间状态的重构,因此在底层实现中完全可以通过高度并行的单批次(Batched Forward Pass)一次性完成,使得训练延迟的增加被压制在可控区间内。同时必须指出,这种归因开销仅存在于策略离线训练阶段,在模型部署后的线上推理期,智能体运行完全依赖已训练好的记忆网络,不会引入任何额外的延迟。
另一个值得深思的议题是归因粒度的边界。AttriMem 目前将基本单元设定为单个 Token,但在人类自然语言的深层语义中,关键证据往往是以由多个连续或不连续 Token 组成的“语义跨度(Span)”乃至跨条目的关系网络呈现的。单个 Token 的独立打分在面对复杂逻辑关联时可能忽略了 Token 之间的协同交互效应。未来如何在保持计算可接受度的前提下,探索从 Token 级向动态语义块(Semantic Chunk)层级的非线性归因迈进,将是基于过程反馈记忆系统的另一个重要演进方向。
总结
AttriMem 的价值并不仅限于在几个长程对话数据集上取得了刷榜成绩,更重要的是它为 LLM Agent 的长期演化提供了一种极具启发性的思路:在缺乏天然中间监督信号的长链条决策任务中,不必机械地依赖昂贵的人工标注去构建“完美过程”,也不必退守在粗糙的结果级反馈中被动摸索。通过敏感度分析将下游的最终表现科学、因果地逆向“投影”到历史过程中的每一个文字上,正是连接全局目标与微观行动的坚实桥梁。随着各类 Agent 架构走向愈发复杂的长期交互,这种归因引导的过程反馈范式,有望在记忆构建之外的规划、反思、工具调用等更多深水区释放出更大的变革潜力。