AngelSpec:不再押注单一草稿机制,大模型推理加速达 2.4 倍
AngelSpec: Towards Real-World High Performance Inference with Speculative Decoding
在大模型在线服务系统的工程实践中,投机解码(Speculative Decoding)早已不是冷门的前沿概念,而是各大厂商降低服务延迟、节省算力成本的关键手段。然而,工业界长期面临一个尴尬的现实:学界不断提出各种新颖的草稿模型(Drafter)架构——从轻量级的多 Token 预测(MTP, Multi-Token Prediction)到单步生成整块序列的块并行扩散模型(Block-parallel Diffusion)——但没有哪一种架构能在所有真实业务场景下稳赢。
ArXiv URL:https://arxiv.org/abs/2607.25852v2
真实线上流量具有极高的异质性。开放域闲聊(Chat)具有极高的条件熵,一个句子往往有无数种合理的展开方式,目标模型在深层候选上的接受率会迅速跌落,强行生成长序列只会浪费验证算力;而在代码生成和数学推理中,严格的语法、反复出现的变量名以及严密的推导逻辑形成了极强的局部约束,长距离可预测性极高。针对这种结构与业务分布的割裂,腾讯提出了 AngelSpec 这一统一的投机推理训练与系统框架。
该方案的核心思想非常务实:不再试图训练一个放之四海而皆准的“通用草稿模型”,而是在训练数据、模型架构和推理调度三个层面做结构与任务的协同特化。针对高熵对话,系统采用在多样化目标模型生成数据上进行训练时测试(TTT)展开的轻量级 MTP;针对代码与数学等结构化推理,系统提出了结合混合目标条件特征与前驱自回归校正头的块并行模型 DFly。在腾讯 Hy3-A21B 模型上的实测表明,DFly 将平均接受长度提升约 30%,在 4 到 64 并发全区间实现 1.98–2.40 倍的解码加速,吞吐量比同类代表性工作 DFlash 提升 10.5%–11.8%。
MTP 的现实瓶颈:暴露偏差与目标漂移
多 Token 预测作为大模型原生自带的投机组件,凭借极低的参数与显存开销,已经成为包括 DeepSeek、Meta 等团队在内的生产级标配。MTP 直接复用目标模型主干网络的隐层特征、词表嵌入矩阵(Embedding)和输出线性头(LM Head),避免了维护一套独立小模型的运维复杂性。但在实际落地中,朴素的 MTP 往往在第二、第三个预测位置出现断崖式接受率下滑。
这一现象的根源在于训练与推理的分布不匹配,即经典的暴露偏差(Exposure Bias)。在标准的多任务或辅助损失训练中,模型通常采用 Teacher Forcing 模式。在预测第 $k$ 个未来 Token 时,输入给 MTP 模块的始终是真实文本(Ground Truth)的正确 Token。然而在实际在线服务中,预测深度 $k \geq 1$ 的输入只能是深度 $k-1$ 刚刚推断出的预测 Token $\widehat{x}$。一旦上游出现微小偏差,推断出的隐藏状态和 KV Cache 就会迅速脱离干净的训练轨迹。
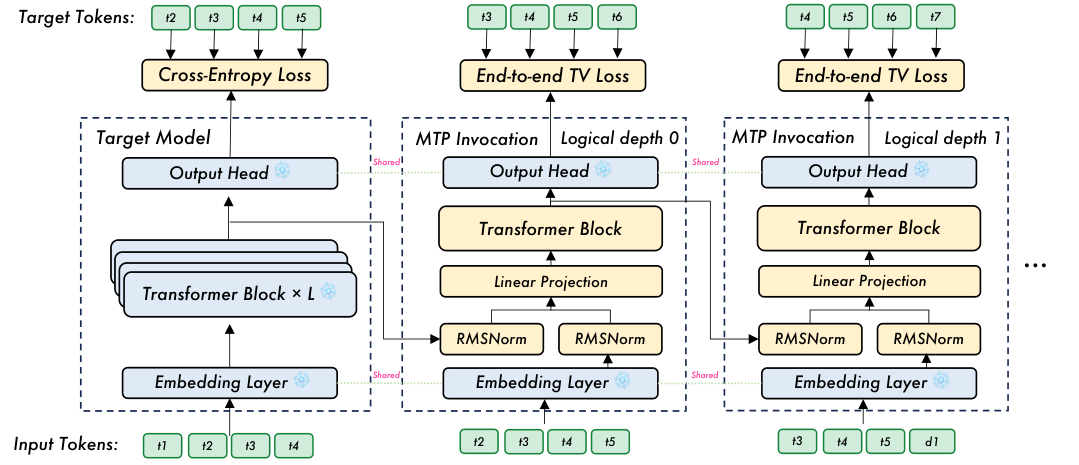
为了解决这一问题,AngelSpec 借鉴了 EAGLE-3 的思想,在训练阶段引入了 训练时测试(Training-Time Test, TTT) 机制。该设计采用逻辑多深度、物理单模块的共享参数结构。如图 1 所示,在单个训练步骤内,同一个物理 MTP 模块会被自回归展开 $D$ 步。在预测深度 $k+1$ 时,模块强制接收上一轮预测得到的贪心预测值 $\arg\max$,并维护自回归生长的局部草稿 KV Cache。这意味着,深层的 MTP 参数在训练期就直面带有自身误差的前缀分布,学会从上游的非完美生成中纠偏,从而彻底弥合了离线训练与在线投机服务之间的状态鸿沟。
面对多步展开带来的梯度与显存压力,AngelSpec 在序列维度上进行分布式切分,确保展开状态、自注意力计算以及大词表 Logits 匹配全程保持分布式。更重要的是,训练序列打包(Sequence Packing)时严格遵守文档边界隔离,避免交叉掩码导致深层监督信号在无关样本之间泄漏。
让对齐直接面向接受率:从 KL 到端到端 TV 损失
草稿模型训练的本质,不是让小模型成为一个独立的语言生成者,而是尽可能完美地拟合冻结目标模型在未来的输出行为。学术界通常直接采用前向 KL 散度(Forward-KL)作为蒸馏目标,但在投机解码的拒绝采样机制下,KL 散度并不能线性对应到最终的接受率。
如果用 $p$ 表示目标模型的真实概率分布,$q$ 表示草稿模型的预测分布,则拒绝采样的理论单步接受概率 $\alpha(p, q)$ 等于两个分布的重叠部分,即 $\alpha(p, q) = \sum_{v \in \mathcal{V}} \min(p(v), q(v)) = 1 - \operatorname{TV}(p, q)$,其中 $\operatorname{TV}$ 为全变差距离(Total Variation Distance)。当预测深度达到 $D$ 时,投机采样的串行接受逻辑具有乘法效应:一旦前一步被目标模型拒绝,后续所有预测无论多么准确都会被当场作废。
因此,AngelSpec 构建了端到端全变差损失函数($\mathcal{L}_{\mathrm{e2e}}$):
\[\mathcal{L}_{\mathrm{e2e}} = 1 - \frac{1}{\vert{}\mathcal{I}\vert{}D} \sum_{i \in \mathcal{I}} \sum_{m=0}^{D-1} \prod_{k=0}^{m} \alpha_{i,k}\]该乘积形式赋予了浅层预测深度显著更高的损失权重,直接在数学目标上贴合了拒绝采样的级联特性。
然而,直接在冷启动阶段优化上述端到端 TV 损失极度不稳定,因为初始化阶段学生分布与目标分布差距巨大,TV 梯度极其微弱甚至弥散。为此,团队设计了两阶段优化流程:先利用带有自适应权重 $\lambda$ 的混合损失(LK Loss)完成初始冷启动收敛,待分布接近目标流形后,再切换为端到端 TV 损失精调。消融实验证实,这种两阶段策略相较于单纯使用 KL 散度或硬标签交叉熵,能够将多步平均接受长度稳定提升 0.15–0.2 个 Token。
除了损失设计,训练语料的生成方式同样起到了决定性作用。如果直接使用人工标注或外部数据作为目标文本,MTP 学到的仍然是外部语料风格,无法反映部署的目标模型在线推理时的局部不确定性特征。AngelSpec 采用完全由冻结目标模型在线 Rollout 生成的样本轨迹作为训练监督信号,确保输入给草稿模块的隐藏状态与 Token 分布与真实部署环境严丝合缝。
在 Hy3 模型上的测试显示,在贪心解码($T=0$)下,经过 TTT 和 Rollout 数据强化的 MTP 将全基准平均接受率从 52.8% 提升至 66.4%,平均接受长度(MAL)从 2.58 提升至 2.99。在随机采样($T=0.9$)下,平均接受率同样从 51.3% 提升至 63.3%。尤为显著的是,提升几乎全部集中在深层位置:在 GSM8K 和 HumanEval 上,第三个候选位置的单步接受率从约 30%–38% 大幅跃升至 70%–75% 以上,原本价值微弱的深层推测被真正激活成了有效产出。
DFly:打破块并行扩散的“上下文割裂”
MTP 机制虽然轻量稳定,但受限于自回归的单步串行依赖,通常只适合预测 2 到 3 个 Token;一旦试图预测更长,草稿生成的延迟就会随深度线性叠加,抹平投机带来的收益。在代码与数学等长距离高确定性场景下,业界更青睐单次前向直接生成一整个 Token 块(Block)的并行生成范式,例如基于扩散或掩码机制的 DFlash。
然而,现有的块并行方案存在两个难以忽视的技术短板:
-
目标特征复用过于粗糙:以 DFlash 为代表的模型通常将目标模型多层的隐藏状态拼接后通过一个全连接层,压缩为一个单一的全局上下文特征 $c_t$,随后在所有草稿层中共享。这种方式忽略了草稿网络不同深度对目标特征粒度的差异化需求。
-
块内 Token 相互独立导致语义崩塌:并行骨干网络对一个 Block 内所有被掩码的位置进行双向注意力计算,输出的各个位置分布本质上是边缘分布 $q(x_{t+i} \mid x_{\leq t})$。当遇到多分支逻辑时,模型可能在第 1 个位置选择了分支 A 的 Token,而在第 2 个位置预测出分支 B 的高概率 Token,导致拼装出的草稿块逻辑前后矛盾,极易被目标模型中途拦截。
针对这两个核心痛点,AngelSpec 提出了名为 DFly 的全新块并行架构。
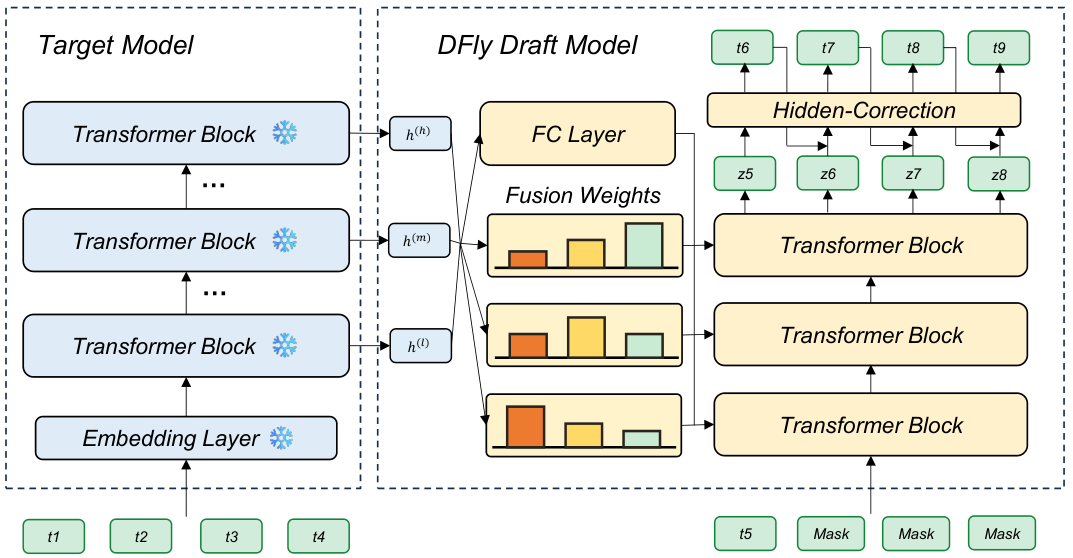
首先,在特征条件注入方面,DFly 采用了混合目标条件骨干(Hybrid Target-Conditioning Backbone)。它将 DFlash 的全局变换特征 $c_t$ 与 DFlare 的层特异性融合特征 $f_t^{(i)}$ 相结合:
\[g_{t}^{(i)} = \operatorname{RMSNorm}\left(c_t + f_t^{(i)}\right)\]其中全局特征 $c_t$ 负责传递跨层级拼接的宏观上下文,而层特异性特征 $f_t^{(i)}$ 则通过一组可学习的注意力权重对目标模型不同层的隐藏状态进行动态加权求和。通过这种混合设计,草稿模型浅层能够聚焦于底层的语法和表层特征,深层则可以利用高级语义表征,显著提高了对目标大模型隐层信息的表征利用率。
其次,为了让并行生成具备序列因果感知,DFly 在完全并行的骨干网络后方,串联了一个极具轻量化特色的前驱隐藏状态校正头(Hidden-Correction Head)。传统的马尔可夫头(如 DSpark)仅能基于上一个采样 Token 的 Embedding 进行低秩转移偏差计算,表达能力有限。而 DFly 的隐藏校正头将经过归一化的草稿骨干隐状态 $\widetilde{z}^{\mathrm{D}}{t+i}$ 与前一步已确定前驱 Token 的嵌入向量 $e{t+i-1}$ 进行拼接,送入轻量的 SwiGLU 模块:
\[\widehat{z}^{\mathrm{D}}_{t+i} = z^{\mathrm{D}}_{t+i} + \operatorname{SwiGLU}\left(\left[\widetilde{z}^{\mathrm{D}}_{t+i}; e_{t+i-1}\right]\right)\]校正后的隐状态再通过输出头计算当前位置的最终概率分布。这一改动的精妙之处在于计算开销的极端不平衡:计算量最庞大、耗时最长的主干 Transformer 依然保持高度并行的单次前向传播,而只有尺寸极小的校正头按从左到右的顺序逐位置刷新。它将原本并行的孤立边缘预测,成功转化为带有前缀因果条件的联合概率分布 $\prod_{i=1}^B q_i(x_{t+i} \mid x_{\leq t}, x_{t+1:t+i-1})$,彻底消除了由于块内独立性假设引发的草稿连贯性崩塌。
在训练优化策略上,DFly 同样延续了分段思想:第一阶段结合 D-PACE 动态接受概率衰减权重与混合 LK 损失进行冷启动;第二阶段再引入端到端 TV 目标进行接受长度的直接最大化,确保块内每个位置的置信度都能最大程度转化为真实的接受 Token。
运行时动态自适应:将验证视为共享算力池
绝大多数投机解码系统都预设了一个固定的验证步长(例如固定验证 4 或 5 个 Token)。然而在线上服务中,这种静态设计常常导致计算资源的错配。
一方面,不同请求在不同解码阶段的接受率天差地别;另一方面,随着线上并发量的变化,硬件的算力瓶颈状态会发生动态迁移。在低并发时,系统受限于内存带宽(Memory-Bound),目标模型多验证几个 Token 的延迟开销几乎可以忽略不计;但在高并发下,计算单元逐渐饱和(Compute-Bound),验证过长的低置信度候选 Token 会剧烈挤占批处理(Batching)容量,导致整体吞吐不升反降。
为此,AngelSpec 整合了 D-cut 动态截断机制。该机制不再孤立地审视单个请求的草稿序列,而是将目标模型的验证算力视为跨并发请求的全局共享资源池。系统首先基于草稿模型输出的概率分布,评估出每个候选前缀的期望收益(Expected Utility);同时,系统内置了一套轻量的运行时成本模型(Runtime Cost Model),根据当前请求的批大小(Batch Size)、序列上下文长度、并行策略以及硬件负载,实时换算验证不同长度后缀的额外开销。
在这套协同机制下,当系统负载较轻时,D-cut 会允许保留更长的草稿块以尽可能压榨潜在的加速比;而当请求负载激增、算力吃紧时,调度器会果断跨请求剔除深层低置信度的草稿后缀,将有限的验证算力重新倾斜给高确信度的前缀。
异质协同带来的架构启示
在开源的腾讯 Hy3 模型族上进行的大规模基准评估,印证了这套异质协同范式的有效性。实验不仅验证了算法层面的接受率提升,更还原了真实 Serving 负载下的吞吐收益:在 4 到 64 的全并发压力测试中,DFly 在 Hy3-A21B 上均取得了全场最高的平均吞吐,端到端加速比达到 1.98–2.40 倍,并在相同硬件配置下实现了比 DFlash 稳定高出 10.5%–11.8% 的吞吐增益。
AngelSpec 给大模型推理优化带来的更深层次启示在于:投机解码的研究重点,正在从单纯的“发明一种更巧妙的草稿网络”,转向“如何处理现实推理工作负载的极度不均衡”。
对话与推理两类任务在熵空间上的鸿沟,决定了轻量级自回归 MTP 与高带宽块并行扩散必须各司其职,而通过底层系统级的离散生成与统一流式训练框架(Disaggregated Target Generation),两套原本割裂的技术栈得以在同一个技术底座下协同演进。随着大模型在长上下文 Agent、工具调用等复杂链路中的渗透加深,根据输出分布特异化草稿策略、按在线负载动态博弈验证深度的思路,将成为投机推理迈向大规模工业生产落地的必然路径。