CoEvoKG:让知识图谱与搜索Agent双向进化,宏平均最高提升11.6分
CoEvoKG: Co-Evolving Knowledge Graphs with Self-Evolving Search Agents
在利用强化学习(RL)提升大语言模型复杂推理能力的探索中,带有可验证奖励的强化学习(RLVR)已经展现出可观的潜力。然而,当这一范式被延伸到智能体(Agent)场景——尤其是需要模型自主调用搜索引擎、在多轮交互中搜集证据来回答知识密集型问题的多跳推理任务时,现有技术路线正迅速撞上两堵高墙。
ArXiv URL:https://arxiv.org/abs/2608.01904
第一堵墙来自训练数据的匮乏与昂贵。主流的搜索智能体训练往往依赖静态的人工问答数据集。这类数据规模有限,想要覆盖复杂、深度的多跳检索链条成本极高;如果放手让模型无约束地自由生成任务,又极易产生歧义、无解或者毫无信息量的垃圾问题。第二堵墙则源自自对弈(Self-Play)机制内部的巨大浪费与不稳定性。以往自博弈方案中的“提问者”(Proposer)和“解题者”(Solver)在对抗中往往容易走向失衡:提问者可能出一些过于刁钻甚至存在答案泄露的题目,导致训练崩溃;更令人扼腕的是,每当解题者经过艰苦的多轮检索终于走通了一条证据链并获得奖励后,这些耗费计算资源检索出来的宝贵证据就会随着这一轮步进结束而被彻底丢弃。
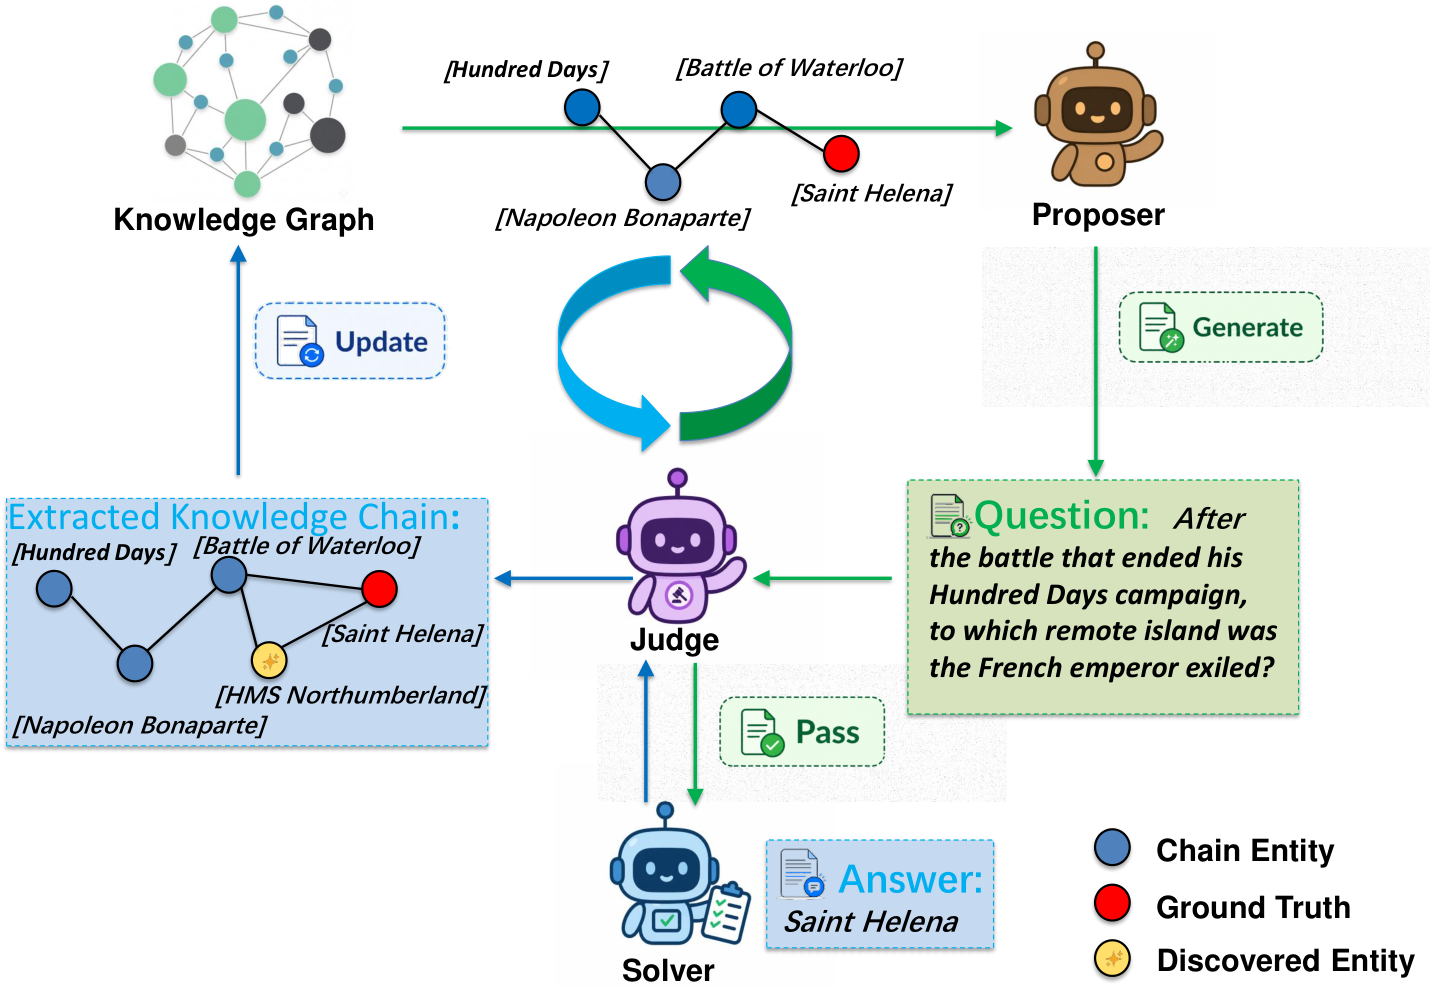
针对这一核心痛点,最新研究提出的 CoEvoKG 框架给出了一个极具启发性的闭环解法:将知识图谱(Knowledge Graph, KG)同时作为可验证训练任务的“发生器”与智能体进化的“永久证据记忆库”。在这套框架下,提问模型与搜索模型协同演进,成功的搜索证据会被持续回写、反哺至图谱中,使图谱结构不断变密、变丰富,进而为后续训练提供更具深度的问题。实验表明,CoEvoKG 在涵盖单跳与复杂多跳的六大公开问答基准上,使 Qwen2.5-3B-Instruct、Qwen2.5-7B-Instruct 以及 Llama-3.1-8B-Instruct 的宏平均准确率分别大幅提升了 11.2、10.1 和 11.6 个百分点;在同等训练预算下,显著超越了固定数据的 Search-R1 以及常规自博弈方案 Search Self Play(SSP)。
困局:为什么搜索智能体的自进化容易走入死胡同?
要理解 CoEvoKG 的设计精妙之处,必须先看清搜索智能体在传统自进化路径上的内在缺陷。
在典型的自对弈训练中,系统通常由两个角色构成:提问模型负责编造问题,解答模型负责通过调用检索工具寻找答案。这种机制理论上可以摆脱对人工标注数据的依赖,但在实际运行中极易退化。由于缺乏结构化的世界知识作为锚点,提问模型很难自发掌控多跳问题的逻辑链条,经常制造出事实自相矛盾的问题,或是无意间在题干中把关键线索直接泄露出去。而如果为了防止作弊而强行增加提问难度,提问模型又倾向于合成一些由于互联网信源缺失而根本无法解答的“死题”,导致解答模型的强化学习信号由于长期拿不到正反馈而迅速耗尽。
比训练失衡更深层的弊病在于“知识的即用即弃”。现有的强化学习算法(无论是 PPO 还是近期广受关注的 GRPO)本质上都在优化模型的参数权重。解题者经过多轮与搜索引擎的交互,找到了一组能够严丝合缝支撑推理的网页段落,这组段落实质上构成了一条高质量的外部事实通路。但在现有的框架里,梯度更新一旦完成,这批经过验证的搜索轨迹就完成了使命,随之被系统内存释放。下一次遇到类似的推理拓扑时,模型仍然必须从零开始在浩瀚的开放网页中盲目摸索。
这种设计使得智能体在推理能力的演进和外部知识的积累之间出现了割裂。大模型本身的参数容量是有限的,企图仅靠参数记忆所有长尾事实与复杂关联极不现实;而开放环境中的检索又充满噪声。如何建立一个能够随着智能体试错而不断沉淀高质量事实、并反过来驱动智能体解决更高维度难题的自生长系统,正是破局的关键。
双向奔赴:CoEvoKG 如何打通知识与策略的闭环?
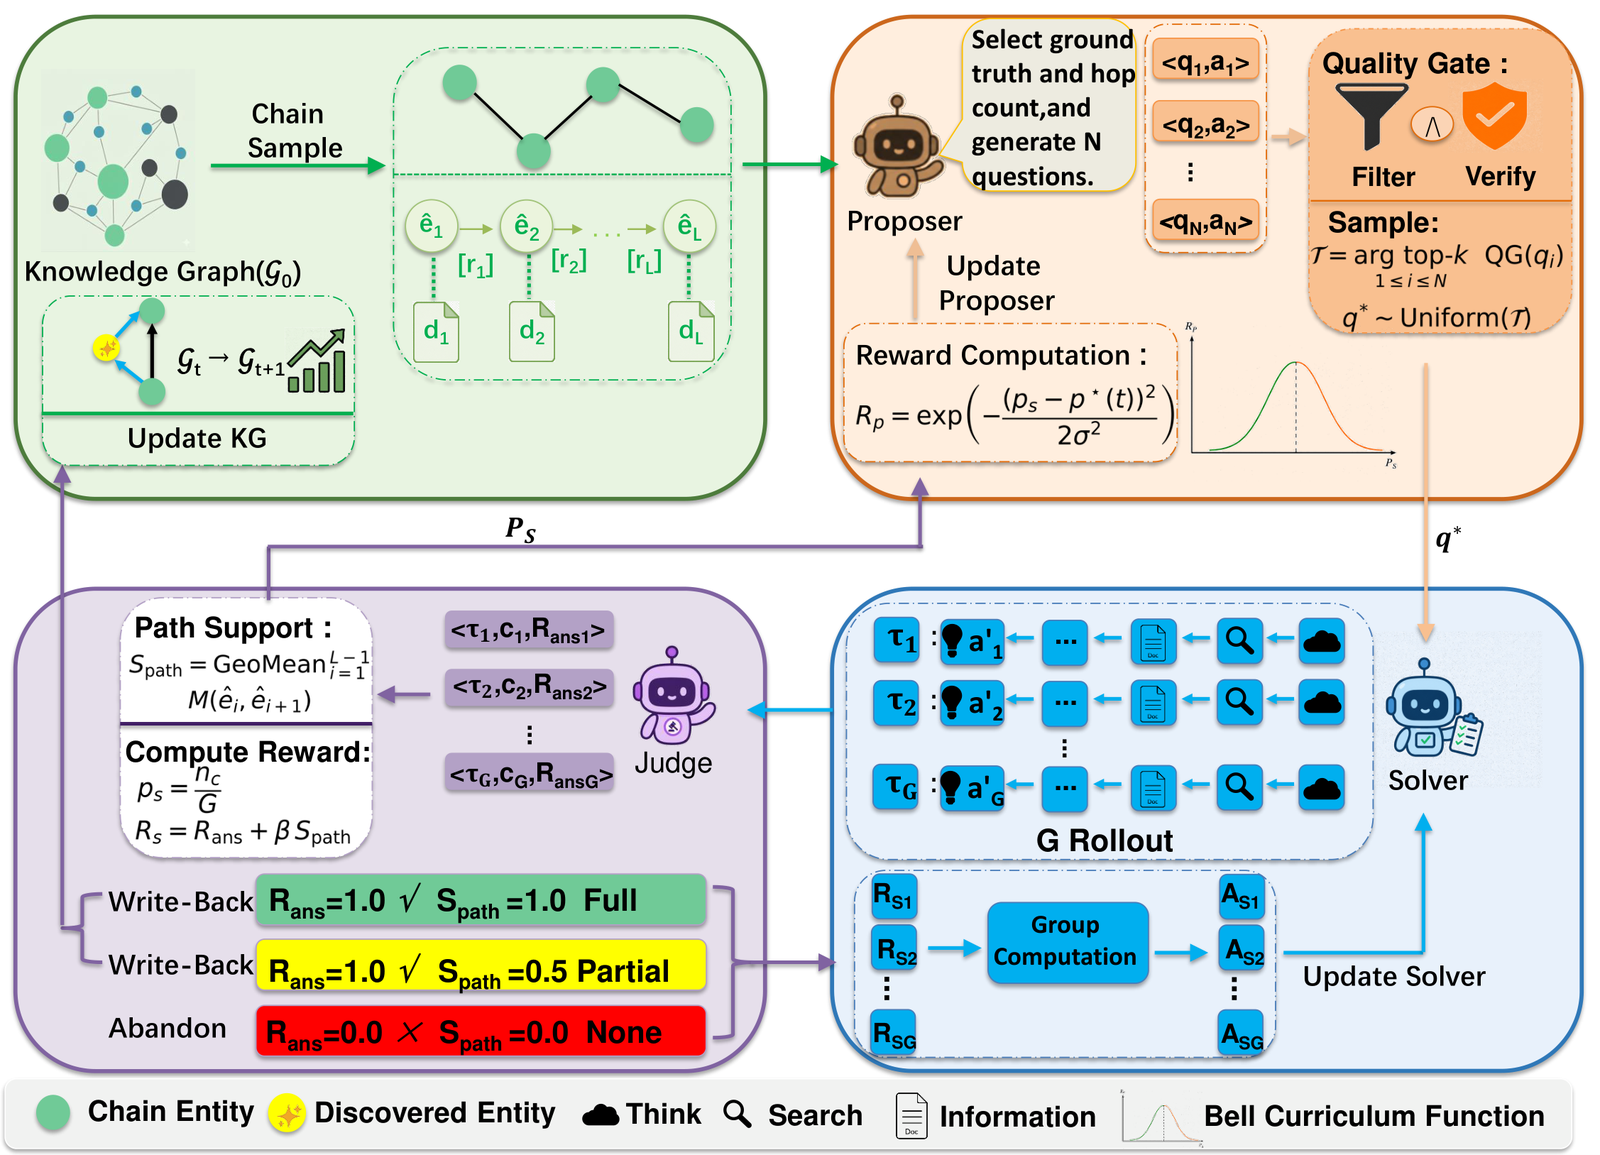
CoEvoKG 的核心思想,是把静态的外部知识图谱激活为智能体训练过程中的“活水”。系统由三个紧密咬合的模块构成:基于图谱实体链的任务生成、兼顾路径支持度与动态难度的双重奖励机制,以及经验证的图谱记忆回写系统。
整个训练流转以图谱中的“证据链”(Evidence Chain)为起点。研究人员首先基于维基百科条目构建起初始的图谱候选池 $\mathcal{G}_0$,每条链由 2 到 3 个具有明确关系标签的实体构成,例如 $(e_1, r_1, e_2, r_2, e_3)$。提问模型并不是天马行空地拟题,而是以这条实体链及其所关联的百科文本段落作为硬约束背景,挑选链条中的某一个实体作为目标答案 $a$,生成一个需要跨越至少两个跳步才能回答的疑问句 $q$。为了防止提问模型在题目中直接点出实体名造成“穿帮”,系统引入了一个严格的质量门控(Quality Gate),利用独立的轻量验证器对问题进行无泄露检查、真实多跳必要性判定和表述清晰度打分。只有跨过门槛的问题才会被放行给解答模型;倘若某个实体链生成的候选均未达标,系统则启用预设的种子题(Seed Fallback)补位,确保训练批次的稳定供给。
当合规的多跳问题送达解答模型后,解答模型将在环境中展开最多 8 轮的思考与搜索交替循环。为了彻底杜绝大模型在强化学习中常见的“瞎蒙撞对答案”现象,CoEvoKG 为解答模型设计了一个复合过程奖励函数:
\[R_{s}=R_{\mathrm{ans}}\big(1+\beta\,S_{\mathrm{path}}\big)\]在这个公式中,$R_{\mathrm{ans}} \in {0, 1}$ 表示最终答案字符串匹配的绝对正确性。只有在最终答案完全正确的先决条件下,路径支撑得分 $S_{\mathrm{path}}$ 才会介入并乘以权重 $\beta$(实验中设为 0.2)作为额外奖励。这意味着,如果模型仅仅是蒙对了答案,但调用的搜索轨迹毫无章法,它只能拿到基础奖励;只有当模型搜索过程中实际遍历的实体路径与底层知识图谱的事实逻辑严密吻合时,才能拿满丰厚的过程奖励。路径得分采用几何平均计算,只要推理链条中出现任何一步断裂或无证据支撑,得分就会急剧跌落。
与此同时,提问模型并不会被鼓励去一味刁难解答模型。传统自对弈往往采用零和博弈机制,容易让提问者走向极端恶意的出题死角;CoEvoKG 则将提问模型的奖励 $R_{\mathrm{diff}}$ 绑定在解答模型的“最近发展区”上。系统通过解答模型在同一个问题下多个采样轨迹(GRPO Group)的最终命中率 $p_s$ 来度量难度,并设定一个呈钟形高斯分布的奖励曲线,其最佳难度目标值 $p^{\star}(t)$ 会随着训练进程从容易逐渐向困难退火。提问模型只有把题目难度精准维持在解答模型“跳一跳能够得着”的临界区,才能获取最高收益。
这个循环最关键的收口在于记忆回写(Verified Graph Memory)。当解答模型成功解出一道题且其搜索路径通过了图谱验证阈值后,这条轨迹中所抓取的高质量网页证据并不会消失。系统会对检索到的实体文本进行哈希去重与清洗,然后将这些全新佐证段落持久化回写到图谱对应的节点和边上。这意味着,图谱 $\mathcal{G}$ 不再是一个冰冷静态的数据库,而是伴随解答模型的成功探索不断进化出更丰富的上下文 $\mathcal{G}_{t+1}$。在接下来的迭代轮次中,提问模型再从这些被强化的节点采样时,就能立足于更具信息量的背景,拟造出更为精细、深度的多跳逻辑问题,真正让知识的积累与模型能力的攀升形成了自我促进的飞轮。
在具体优化实现上,团队依托 veRL 与 SGLang 框架搭建了异步多轮采样管线。解答模型借助 GRPO 算法,直接在同一组问题生成的多个轨迹间计算相对优势,彻底省去了维护大型价值评估网络(Critic)的显存开销;提问模型则通过 REINFORCE++ 算法在全局批次内进行收益白化归一化,两者均采用带有低方差 KL 散度约束的截断策略梯度目标,确保在长周期演进过程中不发生策略崩溃。
战绩盘点:六大基准上的全面突破
为了检验 CoEvoKG 的真实硬实力,实验在单跳问答(NQ、TriviaQA、PopQA)和更考验复杂链条推理的多跳问答(HotpotQA、2WikiMultiHopQA、Bamboogle)共计六大公开基准上进行了全方位评测,涵盖开源领域最具代表性的三个基座:Qwen2.5-3B-Instruct、Qwen2.5-7B-Instruct 以及 Llama-3.1-8B-Instruct。
评测的一个关键前提是保持训练预算与底层工具链的绝对公平。所有方法——包括微调基座、基于静态数据训练的搜索代表方案 Search-R1、纯自博弈的 Search Self Play(SSP)以及 CoEvoKG——均在完全一致的 Wikipedia 语料库上调用相同的 E5 密集检索器,最多允许展开 8 轮检索,且统一受限于完全一致的 314 个优化步数。
宏观结果显示,CoEvoKG 展现出了极为强劲的泛化推理能力。在 Qwen2.5-3B-Instruct 上,未经强化的基模在六大基准上的宏平均准确率仅有 30.9%,而引入 CoEvoKG 训练后跃升至 42.1%,净增 11.2 个百分点;在参数规模更大的 Qwen2.5-7B-Instruct 上,宏平均由 44.0% 提升至 54.1%(+10.1 分);在 Llama-3.1-8B-Instruct 上更是实现了从 39.8% 到 51.3% 的跨越,涨幅达到惊人的 11.6 个百分点。
更重要的是,在严格对齐的算力预算下,CoEvoKG 相比现有的顶尖方法拉开了明确差距。相较于静态数据驱动的 Search-R1,CoEvoKG 在三个模型尺度上的宏平均表现分别高出 2.6 至 3.7 个百分点,这充分说明从静态人工数据池汲取养分具有天然上限,动态生成的高难度任务拓宽了智能体的能力边界。而相较于同样具备生成机制但缺乏图谱支撑与证据回写的 SSP,CoEvoKG 依然保持着绝对的领先优势。尤其是在 HotpotQA、2WikiMultiHopQA 这类极其强调严格实体推理链条的任务上,CoEvoKG 的增益尤为显著。
动力学追踪:为什么训练过程没有陷入退化?
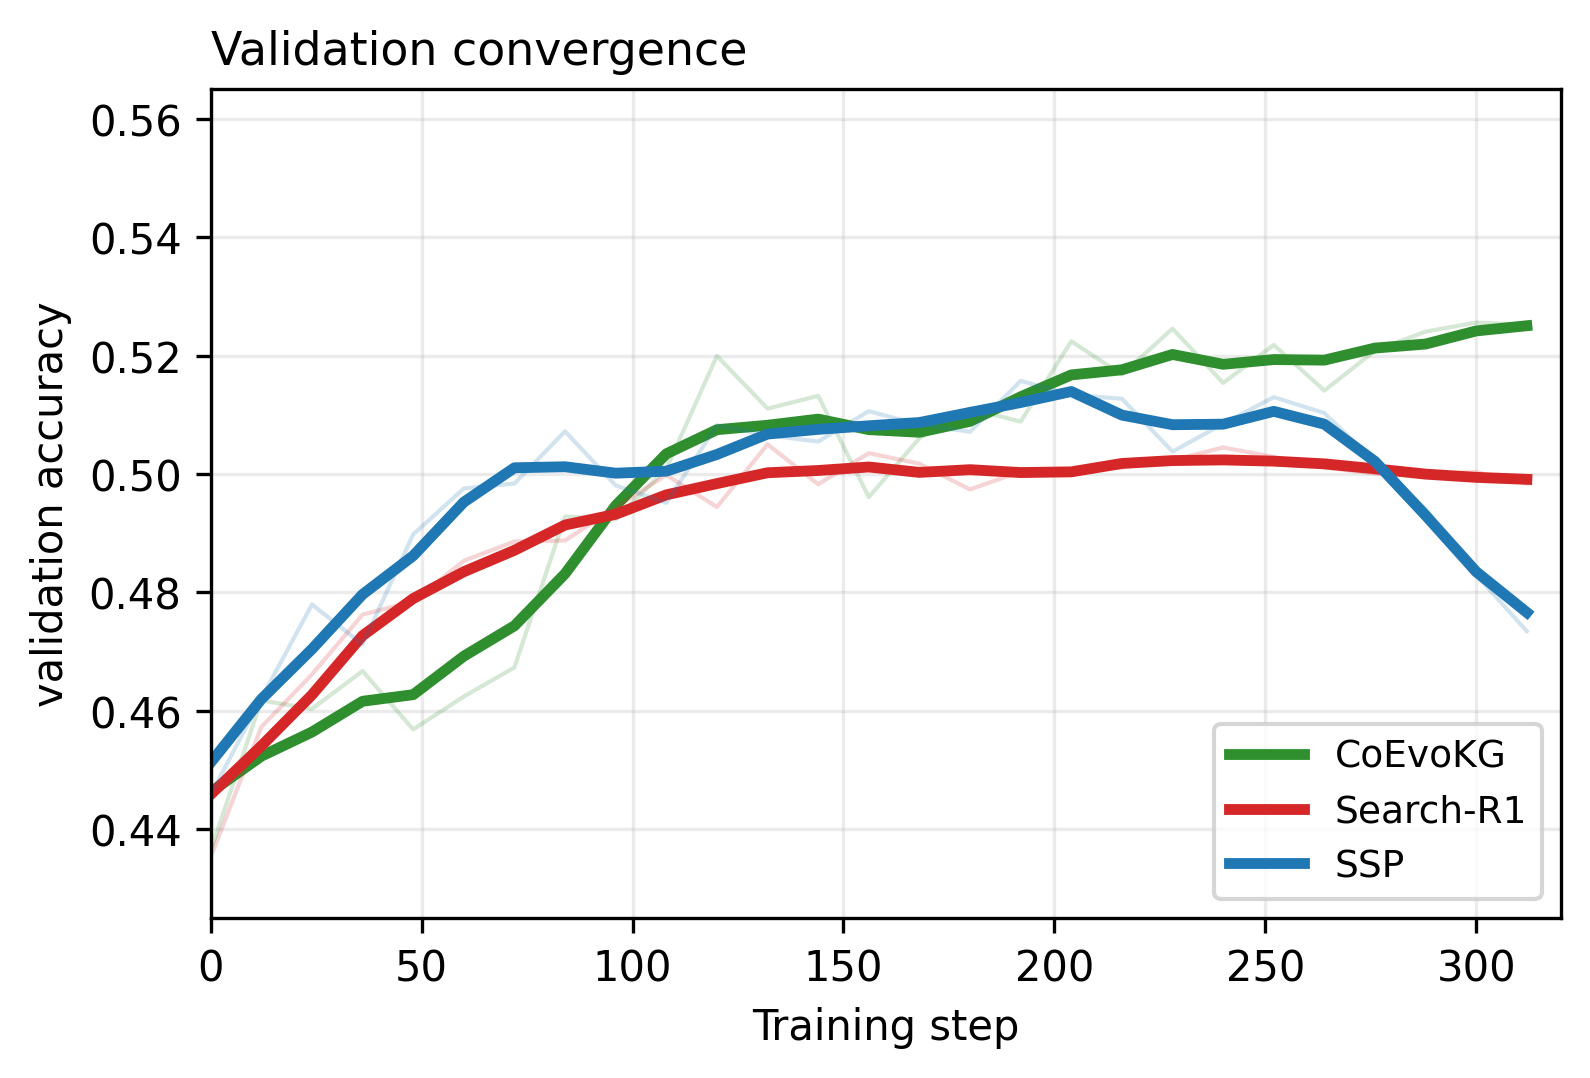
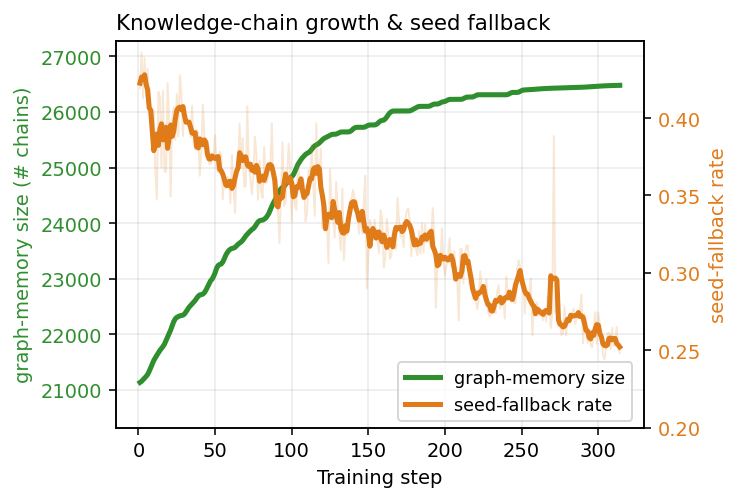
自对弈强化学习最令工程师头疼的往往是训练过程的不稳定与突发性退化。为了透视 CoEvoKG 内部的演进肌理,作者团队对 Qwen2.5-7B-Instruct 的整个生命周期指标进行了连续追踪,给出了多维度的监控视图。
从验证集准确率的收敛曲线(Figure 3a)中可以看出几组方案的本质差异。基于固定数据的 Search-R1 在大约 150 步左右就迅速达到瓶颈,后续曲线完全走平,显露出数据分布耗尽的典型特征;不带图谱约束的自博弈基线 SSP 虽然在前 100 步升温较快,但进入训练中后期后,策略性能开始出现明显的掉头向下,这正是提问与解答双方在缺乏客观事实锚点时发生奖励作弊或陷入分布崩塌的典型表现。反观 CoEvoKG,尽管由于前期需要同时适应图谱链路和门控约束而使得爬升稍显温和,但在 100 步之后展现出了极强的后劲,验证集精度始终呈现单调稳步上升的态势,最终收敛在全场最高点。
这种持久后劲的源泉在图谱容量与回退率监控中得到了印证。如图 3(b) 所示,随着解题者不断攻克难题并将高置信度实体路径回写,验证图谱池中的有效链条数量在训练前半段快速扩张,随后由于去重机制的主动介入,增长斜率自然平缓并进入平台期。与此同时,系统对预设保底种子题(Seed Fallback)的依赖程度从早期的约 40% 稳健下降并收敛在 25% 左右。这意味着在整个训练周期的绝大部分时间里,提问模型都在稳定利用演化中的图谱生成原创、合规的高质量考题,并未发生由于出题失败而导致系统完全退化回种子数据的窘境。
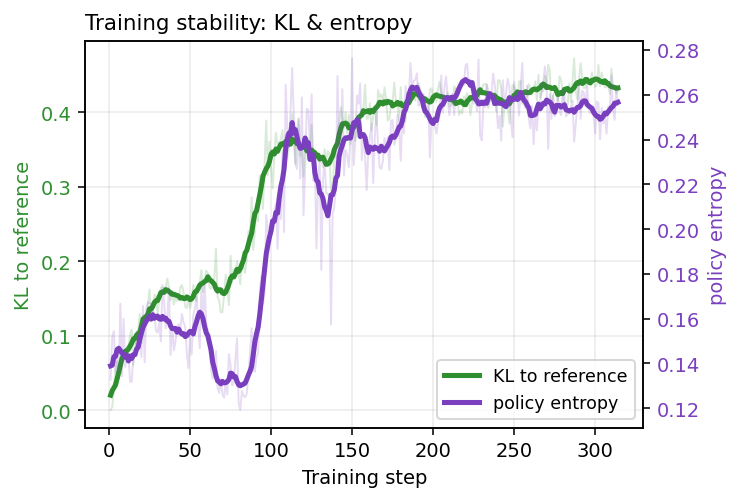
同时,图 3(c) 展示的 KL 散度与策略熵数据从统计层面给出了安全证明。在 300 多步的高强度自我演进中,提问与解答两个策略的 KL 散度在前期微增后迅速收敛至水平稳定状态,策略熵同样保持在合理健康的区间,既没有发生策略发散跑偏,也没有出现灾难性的输出模式坍塌。
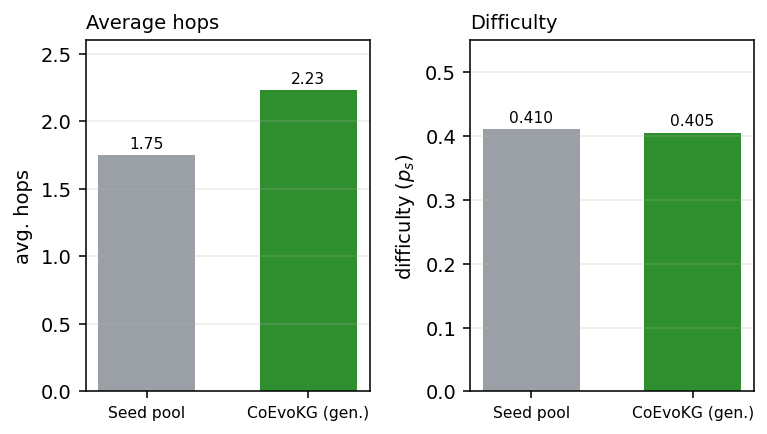
深入到生成题目质量的微观层面,Figure 4 给出了更直观的剖析。研究人员比对了提问模型在 CoEvoKG 框架下生成的考题与人类编写的种子数据集的内在属性。数据显示,两者的解答难度(解答模型的成功率 $p_s$)几乎高度持平(0.405 对比 0.410),这印证了动态难度奖励机制确实将生成任务精准锁死在了当前模型的最近发展区;但在实体逻辑跳步(Hop Count)的维度上,CoEvoKG 生成的问题平均跳步高达 2.23,显著高于种子题库中约 1.75 的水平。这种强烈的“多跳偏置”直接解释了为什么 CoEvoKG 能够大幅刷新模型在复杂多跳下游基准中的成绩。
为了精细界定每一处创新的边际贡献,本文设计了一套依赖递进式消融实验(Build-up Ablation)。由于路径支撑验证和记忆回写必须建立在图谱实体链的基础之上,研究人员从传统的 SSP 出发依次叠加组件:
-
首先引入基于图谱链条的任务生成与无泄露硬门控(C1),宏平均准确率立刻实现了跨越式跃升,且在配对符号检验中表现出极高的统计显著性,彻底堵死了传统自博弈中提问者靠恶意出题骗取梯度的漏洞;
-
继而引入路径支撑过程奖励与动态难度对齐(C2),模型性能再次获得稳健进阶,这一步有效清除了依靠猜测或碎片信息偶然答对的虚假正例;
-
最后叠加证据记忆持久化回写机制(C3),图谱在训练流转中真正被盘活,最终将系统推向了性能顶峰。
启示:知识外脑与智能体自进化的未来范式
CoEvoKG 的成功不仅在于刷新了若干多跳问答基准的跑分,更重要的是为智能体系统的演进哲学提供了一个极具参考价值的范式转型。
在此之前,业界关于大模型记忆的讨论往往陷入两极:一派主张把所有认知和常识通过海量预训练与后训练全盘硬塞进参数内部;另一派则寄希望于外部 RAG 检索,但这些检索系统在推理时往往只是被动接受查询,模型自身在交互过程中获取的经验无法形成持久的事实沉淀。诸如 Reflexion 等智能体尝试通过短期的反思记忆来优化单次会话,但这种“情境记忆”生命周期极短,且难以结构化转化为全系统的共同资产。
CoEvoKG 表明,结构化的图谱拓扑可以成为连接大模型生成能力与外部开放世界的最佳桥梁。当知识图谱在训练循环内部被真正“用起来”时,它既扮演了约束模型天马行空幻觉的“语法树”,又充当了消化、提炼并长期留存高价值检索证据的“外部海马体”。
这种将“强化学习策略演进”与“外挂结构化记忆扩充”紧密耦合的双向机制,为解决复杂知识密集型任务的自监督学习指出了一条极具生命力的路径。随着未来图谱构建技术向更多专业垂直领域的渗透,让搜索智能体在专业图谱的牵引与滋养下自我出题、自我求解、并持续扩充行业知识图谱本身的演进闭环,或许将成为大模型迈向真正自主专家系统的关键技术基座。