CofactVLA:清华提出反事实干预框架,真实机器人OOD成功率提升52.3%
CofactVLA: Deconfounding Vision-Language-Action Models via Counterfactual Intervention
在具身智能领域,基于视觉-语言-动作(Vision-Language-Action, VLA)的多模态大模型正迅速成为机械臂自主操作的主流范式。然而,只要把这些在仿真环境里表现完美的策略部署到真实物理世界,就会频繁观察到一个令研究人员头疼的致命缺陷:机器人表面上听从指令,背地里却在“各干各的”。当用户给出“拿起蓝色盘子里的积木”这一指令时,机械臂往往会径直伸向桌面上体积更大、颜色更鲜艳的黄色网球。
ArXiv URL:https://arxiv.org/abs/2608.04396v1
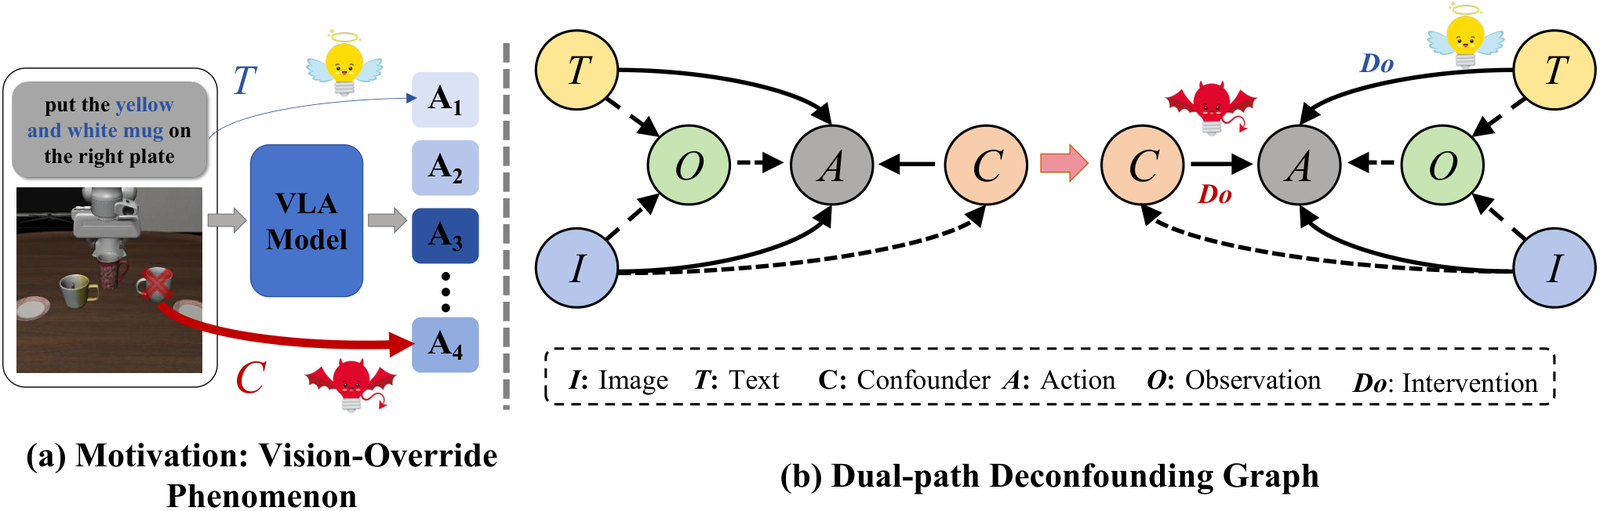
这种被称为视觉覆盖(Vision-Override)的现象,本质上源自机器人多模态数据集中严重的模态失衡。在连续控制中,高维密集的图像数据流在信息量上远超离散、稀疏的自然语言 Token。策略网络在端到端拟合模仿学习数据时,极其容易走捷径,将注意力过度绑定在环境中最显著的物体或最熟悉的桌面布局上,从而完全跳过语言指令的语义驱动。这种因果混淆使得模型在分布内(In-Distribution)环境中看似聪明,一旦面对视觉干扰或分布外(Out-of-Distribution, OOD)场景,执行成功率就会断崖式下跌。
针对这一瓶颈,清华大学研究团队提出了一种名为 CofactVLA 的因果反事实去混淆框架。该方法抛弃了以往依赖数据增强或后处理粗暴相减的做法,将动作生成过程形式化为一个双路径去混淆图(Dual-path Deconfounding Graph, DDG)。通过在单次前向推理中动态构建一个剥离语言指令的“反事实分支”,CofactVLA 实现了特征层面的反事实协方差缩减(CCR)与动作层面的正交投影引导(OPG)。实验表明,该方法在仿真基准 LIBERO-Plus 上刷新了纪录;在真实物理机械臂的复杂扰动评测中,面对让基线模型彻底瘫痪的极端分布偏移,CofactVLA 实现了 75.8% 的操作成功率,相比基线模型的 23.5% 取得了高达 52.3 个百分点的绝对增益。
模态失衡下的因果混淆:为什么 VLA 总对语言指令“听而不闻”?
要理解视觉覆盖的发生机制,必须借助结构因果模型(Structural Causal Model)来审视当前 VLA 模型的决策路径。在理想的决策逻辑中,机械臂生成的动作 $A$ 应当由自然语言指令 $T$(任务意图)作为核心驱动因子,并在视觉观测 $O$ 中完成空间定位与物理对齐。然而在实际训练中,海量的视觉像素提供了极高的数据密度,而文本指令在长序列轨迹中往往保持静态且信息维度极低。
这种非对称的模态结构迫使模型建立了一条虚假的后门路径:$I \dashrightarrow C \rightarrow A$。这里的 $C$ 指代隐式的视觉混杂因子(Visual Confounder),例如视野中反光强烈的金属夹爪、占据大面积画面的托盘,或是模型在预训练阶段高频见过的典型物体。当模型发现仅凭这些显眼的视觉几何特征就能在大部分训练轨迹中压低预测损失时,语言指令 $T$ 对动作 $A$ 的因果驱动效应就被旁路阻断了。
学界此前曾尝试通过两类途径缓解这一问题,但均存在明显局限。第一类是数据驱动方案,如对文本进行同义改写或对图像做局部遮挡扩增。这类方法在开放世界的复杂场景中不仅成本高昂,且难以穷尽所有组合,无法从根本上解耦网络内部已经纠缠的表征。第二类是动作级引导方案,例如直接套用文生图领域的无分类器引导(Classifier-Free Guidance, CFG),通过双分支预测结果的标量线性相减来抑制视觉偏置。然而,机器人连续动作空间具备严格的物理流形约束,这种简单的线性外推往往会放大非正交噪声,导致输出的速度场直接脱离真实物理约束,造成机械臂关节抖动、碰撞甚至急停。
CofactVLA 的切入点极其深刻而直观:既然无法预先穷举环境中有哪些视觉混淆物,不如主动向模型抛出一个反事实提问——“如果在完全相同的视觉场景下,彻底拿掉这句语言指令,模型凭本能究竟会执行什么动作?”
捕捉纯粹视觉偏置:双路径去混淆图的构建
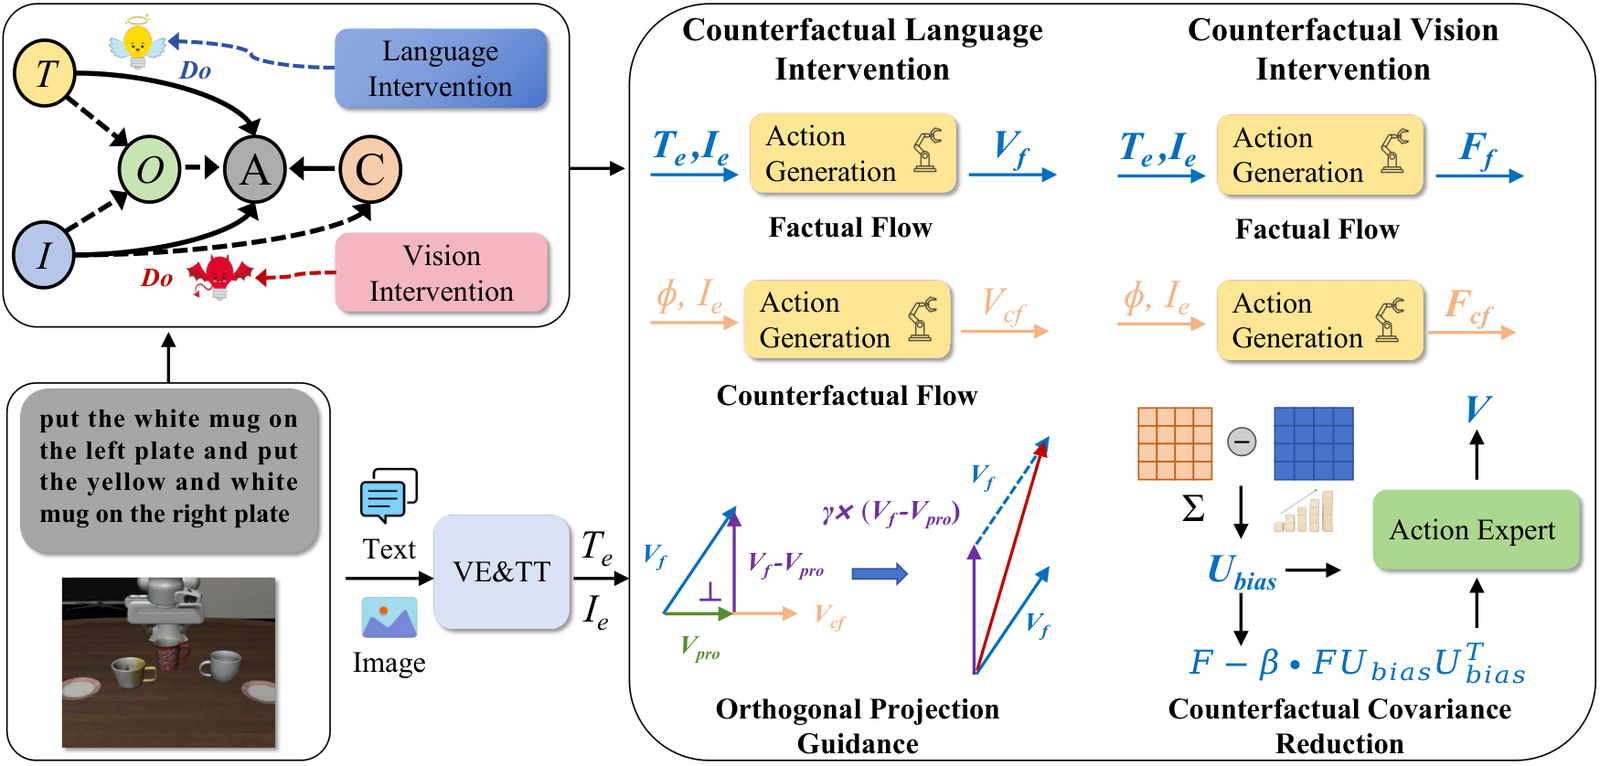
为了在不增加额外推理延迟的前提下回答上述反事实问题,CofactVLA 在模型单次前向计算中构建了平行的双流通道:事实分支(Factual Branch)与反事实分支(Counterfactual Branch)。事实分支正常接收多模态视觉图像与文本指令,而反事实分支则通过对文本 Token 实施全掩码,迫使模型仅依赖当前视觉场景生成动作趋势。
在这一设定下,反事实分支所预测出的输出,便成为了环境视觉混杂因子的“显影液”。它精确捕捉了由于物体显著性、桌面历史布局或预训练视觉先验所诱发的动作偏置。有了这个参照锚点,研究团队设计了自内而外的双重因果干预机制,分别在模型的潜特征空间施加视觉干预,并在动作流匹配生成阶段施加语言意图增强。
特征级去混淆:反事实协方差缩减(CCR)
视觉覆盖的根源并非发生在最后的动作输出头,而是深植于骨干网络(VLM)的多头注意力计算中。密集的视觉 Token 会在键值(KV)缓存中形成强大的特征共振,使动作解码器在尚未开始规划轨迹前就已被偏置的视觉表征所绑架。
为了在特征层切断虚假后门,CofactVLA 提出了反事实协方差缩减(Counterfactual Covariance Reduction, CCR)。研究人员将潜特征空间分解为两个相互正交的子空间:包含任务目标的因果观测子空间 $\mathcal{S}{O}$,以及由虚假视觉捷径主导的混杂子空间 $\mathcal{S}{C}$。
通过对比反事实特征协方差矩阵 $\Sigma_{cf}$ 与事实特征协方差矩阵 $\Sigma_{f}$,团队定义了差分协方差矩阵:
\[\Delta\Sigma = \Sigma_{cf} - \Sigma_{f}\]数学证明表明,当模型受到视觉显著性干扰时,差分矩阵 $\Delta\Sigma$ 的正特征空间恰恰对应着那些在无语言条件下被过度激活的视觉混杂模式。通过对 $\Delta\Sigma$ 进行特征值分解,提取对应正特征值($\lambda > \epsilon > 0$)的前 $k$ 个特征向量,便能精确构建出描述视觉偏差的基底空间矩阵 $U_{bias}$。
随后,CCR 在视觉语言模型的最后若干层注意力机制中,通过正交投影直接从原始特征 $F$ 中扣除与 $U_{bias}$ 共线的干扰分量:
\[F_{causal} = F - \beta (F U_{bias}) U_{bias}^{\top}\]这一操作如同一场精准的特征外科手术。由于正交性质的保证,投影操作仅剥离了使模型产生冲动行为的视觉噪声,而深藏在负特征空间及正交补空间中的语言语义表征(如目标物体的颜色、方位及特定动作指令)得到了完整保留。
动作级流匹配重塑:正交投影引导(OPG)
在完成特征清洗后,信息流进入基于连续流匹配(Flow Matching)的动作专家网络。针对动作生成阶段,传统的 CFG 标量差分之所以会导致机器人动作失效,是因为它盲目地沿着非条件向量的反方向做全局减法,极易破坏动力学连续性。
机器人动作具有典型的多模态与等价性特征:同一个抓取指令,机械臂无论是从左侧微调逼近还是从右侧绕过,都属于有效的物理流形。若直接使用标量减法,两个有效速度场的差值很可能直接指向不可达区域。为此,CofactVLA 提出了正交投影引导(Orthogonal Projection Guidance, OPG)。
在连续时间步 $\tau \in [0, 1]$ 下,事实流速度场记为 $v_{cond}$,反事实流速度场记为 $v_{uncond}$。OPG 不再直接做向量相减,而是先将事实速度场向反事实速度场所在的方向做正交分解,计算出共线的偏置分量:
\[v_{proj} = \frac{\langle v_{cond}, v_{uncond} \rangle}{\|v_{uncond}\|_{2}^{2} + \epsilon} v_{uncond}\]进而提取出完全垂直于视觉偏置分量的纯语义速度向量:
\[v_{\perp} = v_{cond} - v_{proj}\]最终的因果合成动作速度场由原始事实流与这一正交语义分量共同决定:
\[v_{causal} = v_{cond} + \gamma \cdot v_{\perp}\]这一几何操作的精妙之处在于,它通过得分等价性(Score Equivalence)保证了干预仅在语义判别方向上重新分配轨迹概率,在彻底剔除反事实视觉牵引力的同时,严格约束合成轨迹落在合法的动作流形之内,确保了轨迹的平滑与物理可行性。
从基准测试到物理现实:分布外泛化的大幅跃升
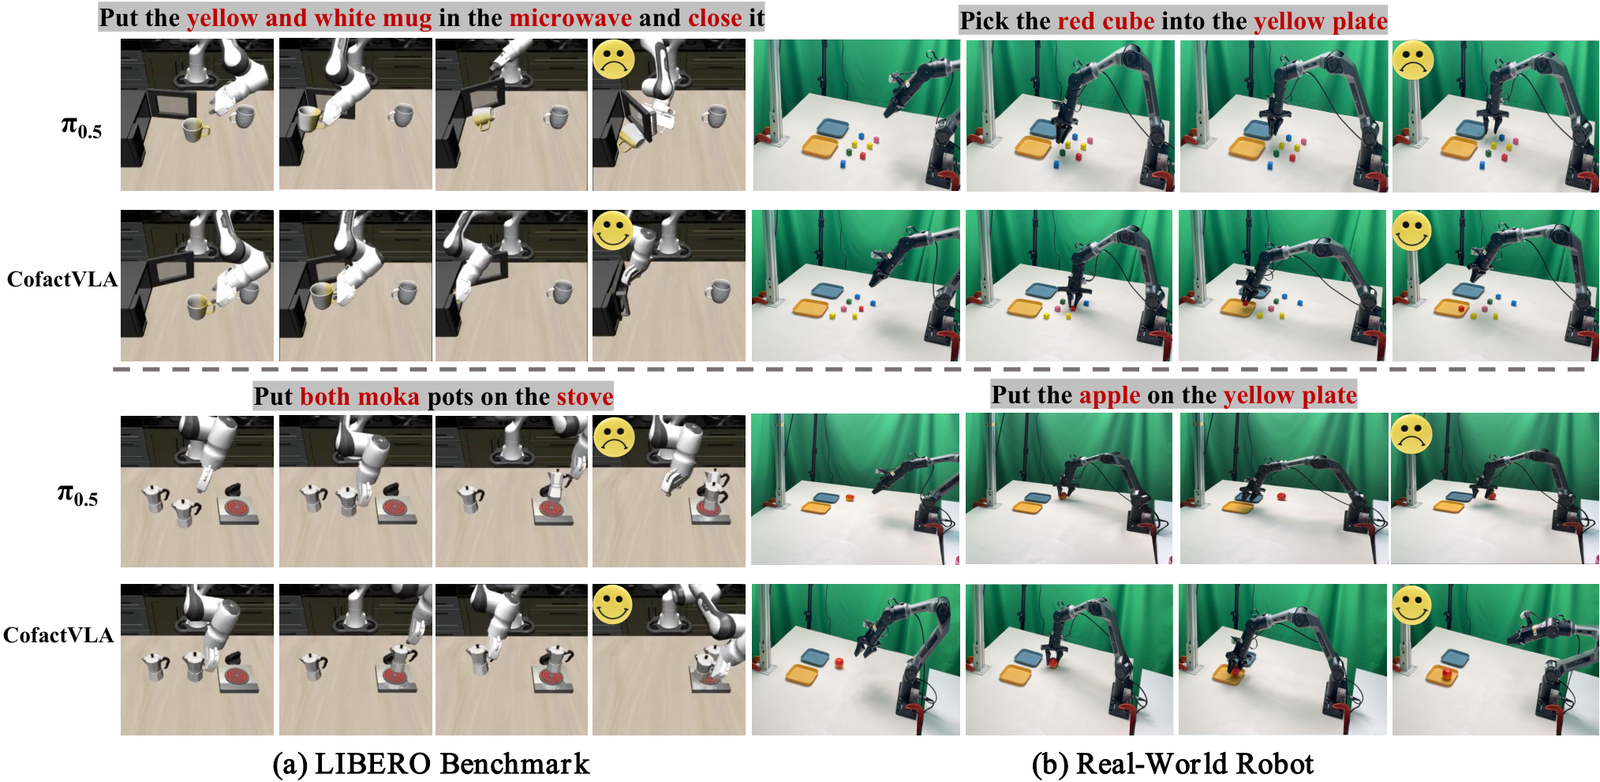
为了验证因果去混淆机制的通用性,研究团队首先在标准的仿真套件 LIBERO 以及更具挑战性的泛化基准 LIBERO-Plus 上进行了大样本评估。在 LIBERO-Plus 中,系统引入了包括机器人底盘视角变换、桌面空间布局剧变、未知干扰物体、光照突变和相机噪声等 7 类复杂的分布外扰动。
测试结果显示,以强大的 $\pi_{0.5}$ 架构为骨干,CofactVLA 在 LIBERO-Plus 上的总成功率达到了 69.1%,大幅超越基线模型 $\pi_{0}$ 的 53.6%。尤其是在机械臂本体外观发生变化(Robot 维度)和空间布局重排(Layout 维度)这两类最容易引发视觉混杂的场景下,CofactVLA 分别交出了 49.7% 和 70.2% 的成功率成绩单。传统模型在这些场景下由于无法识别熟悉的参照物而全面失灵,CofactVLA 则展现出了极强的零样本适应能力。
在消融实验中,研究团队深入对比了 OPG 与传统干预算子的效能。直接做向量相加的策略得分仅为 94.0%,直接做标量相减为 96.0%,即便采用更激进的无分类器动作引导(CAG)也仅达到 97.5%。而采用 OPG 的完整模型将成功率推高到了 98.5%。这直接证明了几何正交投影在保持动作流形平滑性上的数学优越性。
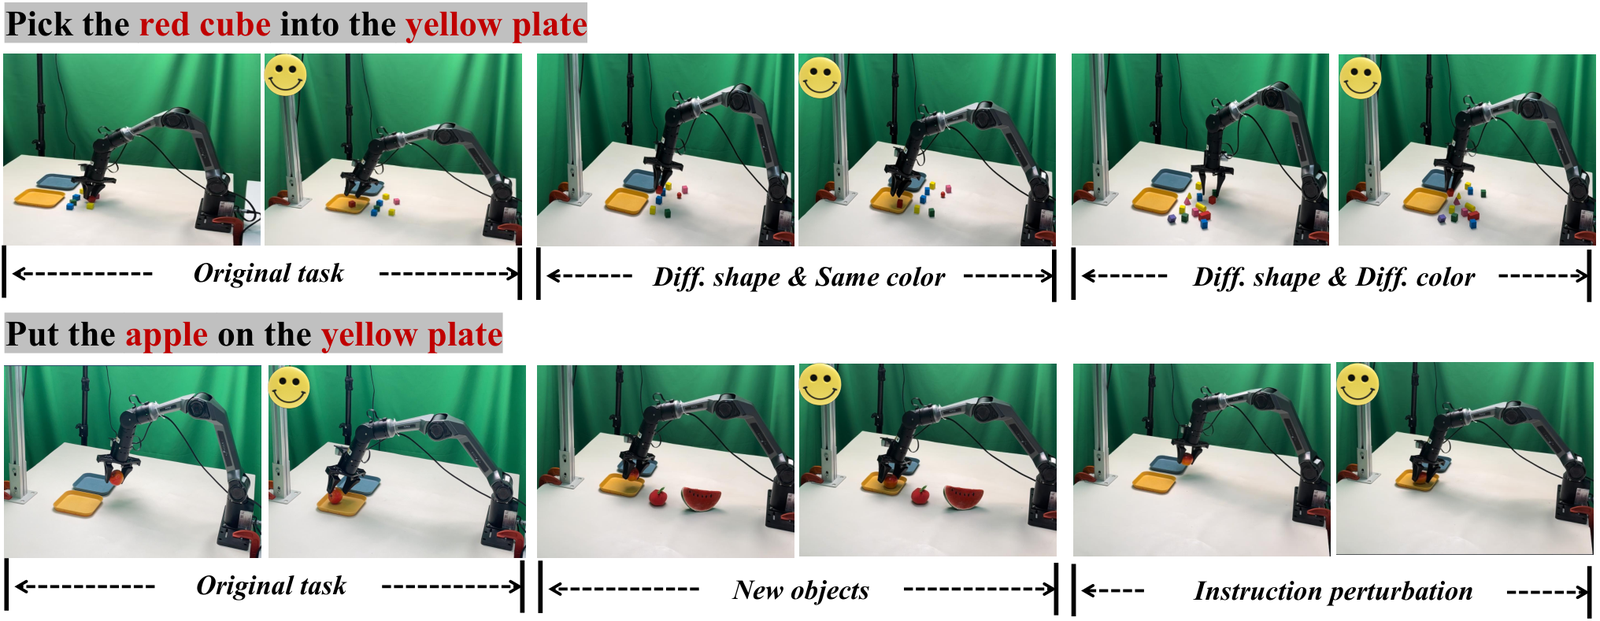
相较于仿真测试,真实物理世界的评测更能暴露具身策略的鲁棒性短板。团队使用 6 自由度的 AgileX PiPer 机械臂搭配双目 RealSense 相机,在 10 Hz 频率下执行 4 项高难度长程任务:
-
从蓝色盘子中移出长方体;
-
将黄色盘子里的网球移至蓝色盘子;
-
将苹果放置在黄色盘子上;
-
将红色立方体抓取并放入黄色盘子。
在基础的分布内测试中,CofactVLA 取得了 90.8% 的平均成功率,显著高于基线模型 $\pi_{0.5}$ 的 71.0%。而在包含杂乱背景、相似干扰物以及强烈环境光斑的分布外(OOD)测试中,两者的差距彻底拉开。
基线模型在面对复杂视觉干扰时暴露了极大的脆弱性。例如在第二项任务中,当场景加入无关但显眼的干扰物体后,$\pi_{0.5}$ 的执行成功率直接从标准环境下的 100% 暴跌至 0%,模型完全被干扰物吸引,甚至无法完成第一次夹爪对准。基线模型在 OOD 场景下的整体平均成功率仅剩 23.5%。相比之下,集成了 CCR 与 OPG 的 CofactVLA 成功抵御了视觉快捷路径的诱导,牢牢锚定文本指令,在 OOD 场景下依然维持了 75.8% 的高成功率,取得了 52.3 个百分点的绝对增益。
总结与未来边界
CofactVLA 为解决具身智能中的“视觉覆盖”提供了一种全新的理论与工程范式。它不再寄希望于无限扩充训练数据的被动防御,而是通过因果图的形式化定义,主动在模型推理管道中引入反事实干预。这一设计不仅在数学上具备清晰的子空间投影解释性,在计算上还能复用前向传播的 KV 结构,保证了极高的实时控制效率。
当然,该方法依然存在其物理与感知边界。论文指出,CofactVLA 的去混淆能力上限在一定程度上仍受制于底层视觉语言模型(VLM)自身的零样本定位基底;如果骨干网络本身完全无法识别某一特定名词的概念,因果干预也无法凭空合成未曾学习的语义。此外,当机械臂在运动过程中发生剧烈的自体视觉遮挡(例如臂身完全挡住目标托盘)时,单/双目固定视角的反事实分支也会出现特征退化。未来将因果反事实机制扩展至动态多视角融合与三维点云流表征中,或将是具身控制模型走向高通用性与高可靠性的下一站。