V-Mem:别再暴力跨模态搜索!模态路由将长程多模态记忆准确率拉升至0.82
V-Mem: Modality-Routed Retrieval for Long-Term Multimodal Agentic Memory
当大模型从纯文本交互迈入支持图文交错的多模态时代,智能体(Agent)所面对的记忆挑战发生了质的转变。长程对话动辄持续数周甚至数月,用户可能随手发来一张报错截图、一张白板草图或一张旅行照片,并在很久之后轻描淡写地问一句:“我们之前聊到那张照片里的问题时,最后怎么解决的?”
ArXiv URL:https://arxiv.org/abs/2608.01543
目前的记忆增强生成(MAG, Memory-Augmented Generation)系统大多建立在纯文本假设之上,即便少数标榜支持多模态的记忆框架,在面对真实视觉相关提问时表现也往往差强人意。来自清华大学等机构的研究者在论文《V-Mem: Modality-Routed Retrieval for Long-Term Multimodal Agentic Memory》中指出,现有系统失效的根本症结在于一个看似合理的底层假设:在向量索引空间中,用户的提问(Query)在几何距离上必然靠近能回答该问题的证据(Evidence)。
这一经典假设在多模态环境下被两条难以逾越的鸿沟彻底击碎。为此,研究团队提出了 V-Mem。该框架放弃了在统一表征空间硬碰硬的暴力跨模态检索,转而通过轻量化的“模态路由”解耦多模态记忆管理。在极具挑战性的多模态长记忆基准 Mem-Gallery 上,V-Mem 斩获了 0.825 的 LLM 评测分,远超此前最佳基准的 0.561;在带有输入图像的复杂提问中,更是以 0.872 的高分将最高仅 0.472 的基线模型甩在身后,同时实现了记忆构建过程的零 LLM Token 开销。
击碎经典检索的两道隐形鸿沟
要理解长程多模态记忆为何频频失效,首先需要审视向量相似度检索在图文交织场景下遭遇的系统性偏差。论文将这一失败归结为两项根本机制:
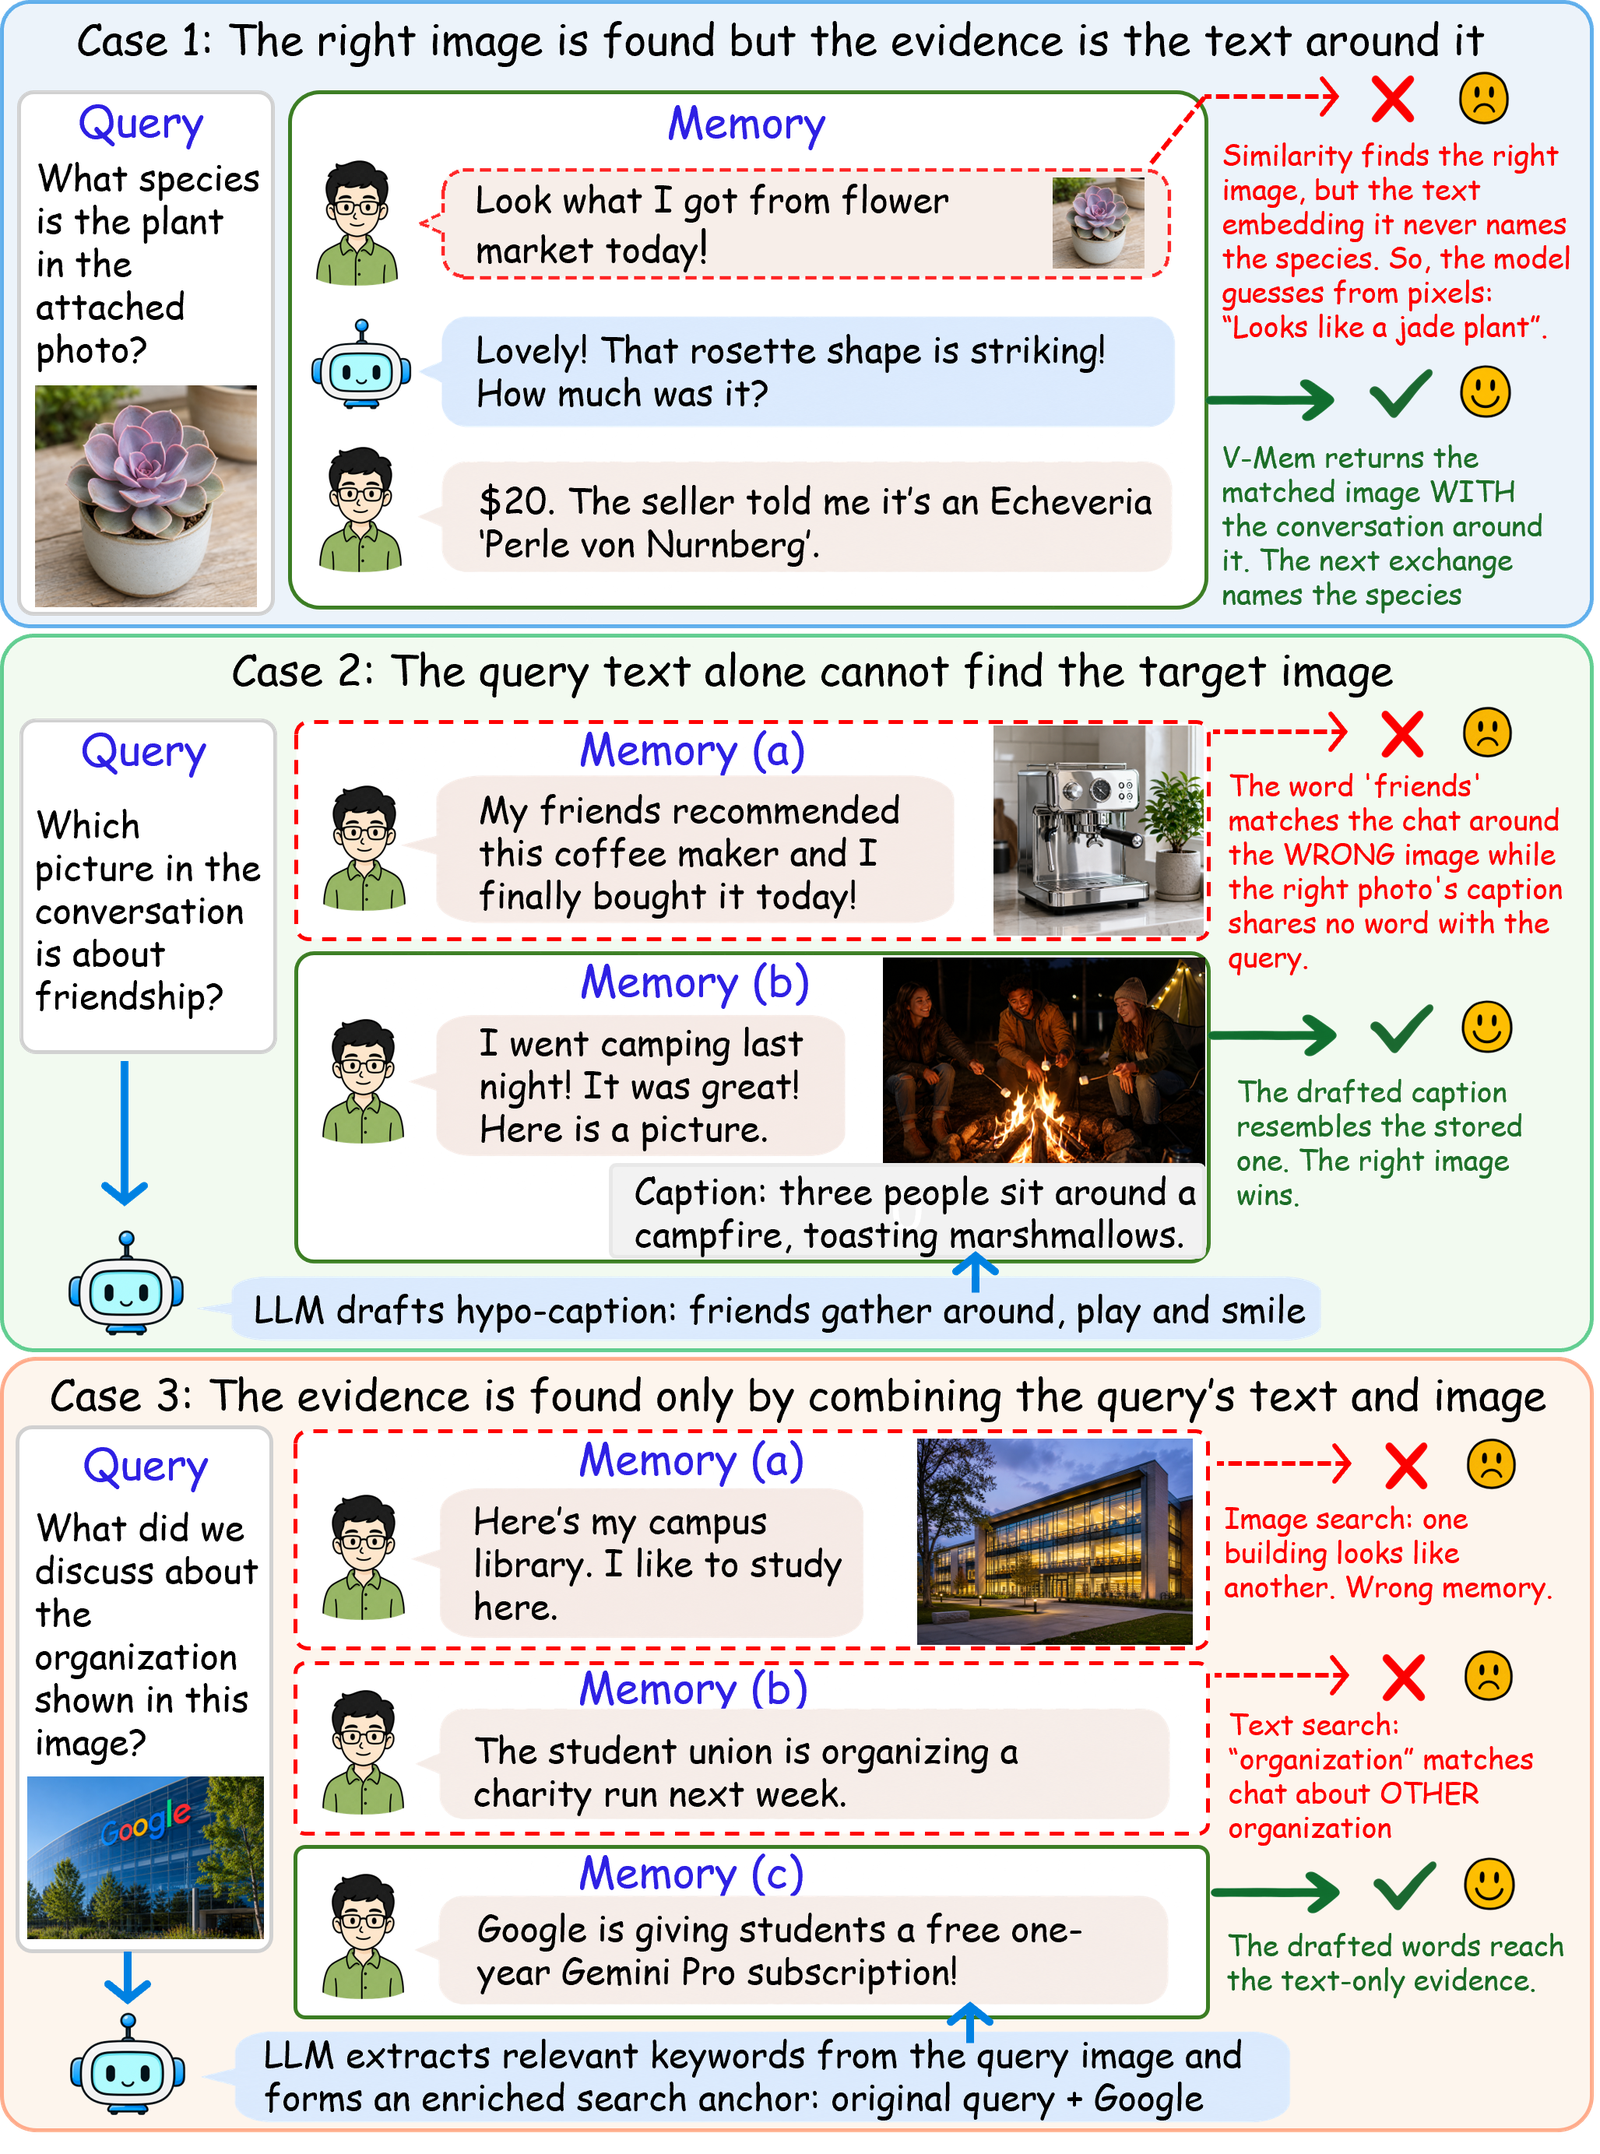
第一是模态鸿沟(Modality Gap)。即便使用 CLIP、SigLIP 这类经过海量对比学习训练的多模态联合嵌入模型,文本与图像在潜空间中依然会聚集成各自独立的簇,无法做到真正意义上的几何重合。当用户的查询是文本,而决定答案的核心证据是一张历史图片时,向量检索会本能地优先召回与问题相似的“其他文本”,而将真正的目标图片排在候选列表末端。直接跨模态计算相似度在统计分布上天然处于下风。
第二是相似性-相关性鸿沟(Similarity-Relevance Gap)。在真实交互中,最能回答问题的证据,往往与问题本身的字面或图像特征毫无相似度可言。图 1 中的第三个案例极具代表性:用户附带了一张 Google 总部大楼的照片,提问是:“关于这张照片里的机构,我们之前讨论过什么?”
系统真正需要调取的历史记忆是:“Google 正在向学生免费提供为期一年的 Gemini Pro 订阅服务。”
如果拆开来看:
-
单独拿大楼照片去检索历史库,大楼图像的 Embedding 距离“Gemini Pro 订阅讨论”的文本相差十万八千里,系统只会召回相册里其他建筑物的照片;
-
单独拿提问文本去检索,提问中只有“机构”和“讨论”,压根没有出现“Google”和“订阅”,文本检索器只会找出一堆包含“机构”字样的无关闲聊。
问题与证据在语义表面没有任何交集,纯粹依靠各自特征的相似度匹配必然全面落空。多模态证据的命中,必须依赖图文两部分信息的深层化学反应。
轮次、泳道与单元:解耦记忆结构
为了彻底绕开跨模态嵌入的不稳定性,V-Mem 颠覆了传统记忆系统将一切内容摘要化、图谱化或暴力压入统一嵌入空间的做法。它选择尊重对话天然的时间与物理结构,将长期交互历史组织为三层架构:轮次(Rounds)、单元(Units)与泳道(Lanes)。
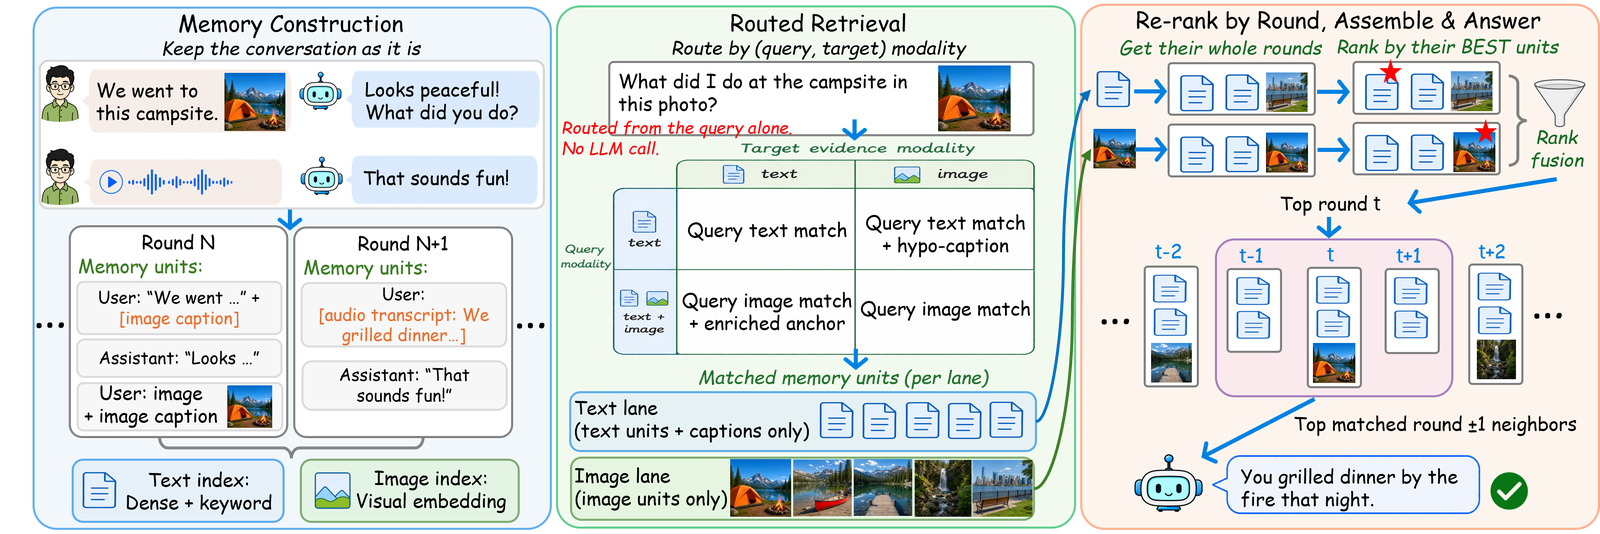
在数据组织层,系统将一次完整的“用户-智能体”交互定义为一个轮次(Round)。一个轮次内部可能包含多个由文本段或原始图片构成的记忆单元(Unit)。这里的关键先验在于:在同一轮次中共同出现的图文,在现实语境中极大概率是强相关的。如果用户发了一张盆栽照片并配文“这叶子发黄怎么治”,照片和这句话并不需要在跨模态向量空间中做到数值完全对齐,轮次本身就是它们最强、最自然的纽带。
同时,V-Mem 在底层划分出两组物理隔离的检索泳道:
-
文本泳道(Text Lane):承载所有文本单元以及图片对应的文本描述,构建稠密向量(all-MiniLM-L6-v2)与稀疏关键词(BM25)两套混合索引,兼顾语义泛化与精确匹配;语音信息则经转录后同样作为文本单元收拢在此;
-
图像泳道(Image Lane):保存原始图片的高维视觉嵌入(基于本地运行的 SigLIP),允许输入图像直接对标库内图像,杜绝信息在图生文压缩过程中的折损。
两套泳道平时互不干扰,完全避免了无关模态的噪声引入。只有在遇到特定问题时,系统才会按需激活对应的检索通路。
模态路由:让对的信号走对的路
在检索阶段,V-Mem 提出了核心的模态路由机制(Routed Retrieval)。它不是用单一公式应对所有提问,而是根据输入查询本身的形态和目标证据的类型,将检索动态路由到四种不同的执行路径。
令人惊讶的是,这种路由完全不需要额外耗费昂贵的大模型推理。系统通过极轻量的启发式规则即可在瞬间完成决策:查询自身是否附带图片一目了然;而用户是在寻找图片(如“发我当时那张图”)还是在寻找事实信息,通过关键词规则分类即可稳定切分。由此,系统梳理出四类交互象限:
-
纯文本 $\to$ 文本事实(Text $\to$ Text):直接激活文本泳道进行混合检索;
-
图文输入 $\to$ 历史图片(Image+Text $\to$ Image):直接在图像泳道对比原始图像特征;
-
纯文本 $\to$ 历史图片(Text $\to$ Image):面临跨模态鸿沟与相关性鸿沟;
-
图文输入 $\to$ 文本事实(Image+Text $\to$ Text):最严苛的多模态推理场景。
面对前两种同模态检索,V-Mem 保持单泳道高速直达。而面对后两种复杂的跨模态场景,V-Mem 祭出了两套组合拳:
1. 依靠共享轮次跨越模态鸿沟(Cross-Modal via Shared Rounds)
既然跨模态特征对比不可靠,V-Mem 索性在检索时完全不做跨模态距离计算。当输入为纯图片并试图寻找相关文本时(或反之),系统先在与输入模态相同的独立泳道中完成匹配,锁定得分最高的候选单元,随后直接顺藤摸瓜,调取该单元所在轮次(Round)中伴随的目标模态单元。这一策略极其精妙地用交互的时间共现性化解了潜空间的模态偏移——不需要对齐图像向量与文字向量,历史上下文的天然捆绑就是最好的桥梁。
2. 生成式搜索锚点弥合相似性-相关性鸿沟(Generated Anchors)
面对前文所述“Google 大楼”式的盲区提问,原始 Query 与目标证据在词面和视觉上均无交集。V-Mem 在此处有节制地引入了端侧多模态大模型,以极小代价动态生成搜索锚点(Search Anchor):
-
当用户发图提问文本事实时(Image+Text $\to$ Text),系统让视觉模型解析图像中的核心线索与潜在关联实体(提取出“Google Headquarters, Mountain View”等关键词),将其拼接回原始提问,构成富化搜索锚点(Enriched Search Anchor)。拿着带有实体关键词的富化文本再去检索文本泳道,原本隐蔽的目标文档瞬间被精准激活;
-
当用户用抽象文本寻找图像时(Text $\to$ Image),系统则反向利用大模型构建假想图像描述(Hypothetical Caption),将抽象需求还原为视觉场景描述,从而与图像库中的文本索引或视觉特征实现平滑对接。
在多路信号打分完成后,系统使用倒数排名融合(RRF, Reciprocal Rank Fusion)抹平不同模态打分的尺度差异,并动态决定上下文装配策略:针对常规推理,自动打包命中轮次的相邻 $\pm 1$ 轮对话作为上下文链条;而针对“我们一共讨论过几座博物馆”这类全域聚合型提问,则自动丢弃邻近冗余轮次,为跨时间跨度的候选轮次腾出上下文预算。
为什么说“零构建成本”至关重要?
在过去很长一段时间里,长程记忆系统(例如基于知识图谱或分层笔记抽象的方案)普遍患有“大模型依赖症”。每当对话推进一轮,系统往往要调用大模型进行实体抽取、三元组更新、冲突消歧或长文本摘要。
这种架构不仅在 API 费用或本地算力上极为奢侈,更埋下了两重隐患:一是写入延迟严重阻碍实时交互;二是信息不可逆压缩。大模型在对话沉淀阶段的每一次提炼和取舍,都可能将数天后用户突然关心的某个视觉细节或语气词永久抛弃。
V-Mem 在记忆构建阶段采取了完全相反的哲学:只存储,不压缩;全保留,延后计算。
在对话发生时,V-Mem 仅调用本地运行的轻量级 Embedding 模型(MiniLM 与 SigLIP)和 BM25 算法对轮次单元建立索引,整个过程不消耗哪怕一个 LLM Token,写入耗时仅在秒级。系统保留了对话发生时的原始形态与完整细节,将真正需要深度理解与信息融合的步骤延后至检索发生的一刹那。这种增量式、零 LLM 开销的构建模式,才真正具备支撑长期、高频、7×24 小时实时 Agent 伴随的工程落地性。
实验评测:大比分超越主流多模态记忆基线
为了检验该架构的真实有效性,研究团队在两大长程多模态基准上进行了全面评测:涵盖多模态深度推理的 Mem-Gallery(包含视觉中心搜索、视觉推理、测试期图像学习等 9 个子类别)以及经典的对话长记忆基准 LoCoMo。
对比基线包括目前多模态与长文本记忆领域的代表性工作:采用图结构与大模型摘要来索引图像描述的 Omni、采用迭代式 LLM-in-the-loop 检索策略的多模态记忆框架 M2A,以及依赖大模型生成动态笔记抽象的纯文本记忆系统 A-Mem。
评测由独立的先进模型作为打分裁判(LLM-as-judge),所得结果呈现出显著的代际差距:
在聚焦多模态检索能力的 Mem-Gallery 基准上,各系统的综合表现如下:
-
V-Mem:综合得分 0.825
-
Omni:综合得分 0.561
-
A-Mem:综合得分 0.460
-
M2A:综合得分 0.314
特别是在最考验图文结合能力的测试期学习(TTL,提问中包含全新图像输入)任务中,V-Mem 达到了惊人的 0.872 分,而参与测试的所有基线模型无一能够突破 0.472;在视觉推理(VR)类别中,V-Mem 取得 0.575,而基线最高仅为 0.273。这一悬殊落差直接印证了前文的理论判断:那些将图像压成一句粗糙 Caption 或试图依赖跨模态 Embedding 硬碰硬的旧系统,面对图文强相关的隐式证据时,召回率几乎呈现雪崩式坍塌。
即便在退化至以纯文本检验为主的 LoCoMo 基准上,V-Mem 依然以 0.690 的总分领先第二名 Omni 的 0.583。特别是在证据分布明确的单跳问题(Single-hop)与时间推理(Temporal)任务中均大幅领跑,且在完全不构建复杂图拓扑的前提下,多跳推理(Multi-hop)能力打平了依赖知识图谱的 Omni。
通过逐层拆解核心机制的消融实验(Ablation Study),研究者还原了系统演进的增益路径:从不加限制的朴素多模态检索(Vanilla)起步,仅加入模态路由机制即可有效排挤无关模态的噪声干扰;而一旦引入“共享轮次对齐”与“大模型生成搜索锚点”,多模态视觉推理维度的得分立刻迎来跨越式拉升。每一项设计都精确打击了对应的检索失效场景。
总结与启示
V-Mem 的成功给正在探索多模态智能体架构的研究者和工程师带来了极为明确的技术启示:
首先,统一的多模态向量空间并非通用记忆的灵丹妙药。尽管多模态表征模型日益强大,但模态鸿沟在细粒度检索场景下依然客观存在,试图用单一的 Cosine 相似度统管所有交互形态,往往会捡了芝麻丢了西瓜。
其次,交互的天然结构本身就是最高效的索引。对话中的“轮次”、时间序列上的“相邻上下文”,这些不消耗任何模型计算量的物理先验,其对齐跨模态信息的可靠性甚至超越了数亿参数训练出的联合嵌入。
最后,记忆系统需要重塑推理算力的分配比例。放弃在写入端昂贵且容易造成信息丢失的过度摘要,将算力留到查询端用于生成精准的“搜索锚点”,用轻量规则做路由,不仅大幅摊薄了 Agent 长期运行的推理账单,更从系统架构层面彻底解决了长程多模态问答中“问在此模态、答在彼模态”的核心痛点。