nGPT:用超球面表示与对数退火,让14B模型训练Token直接减半
Training nGPT
在大语言模型预训练的工程实践中,模型权重的模长和激活值的尺度往往随着层数加深和步数增加而漂移,这也迫使现代网络高度依赖各类归一化层与复杂的优化器超参数调节。此前提出的归一化 Transformer(normalized Transformer,简称 nGPT)试图从几何根源解决该问题:将模型的所有参数矩阵与激活向量全部约束在单位超球面上,把前向传播直接重构成在超球面流形上的逐步优化过程。
ArXiv URL:https://arxiv.org/abs/2608.01284
然而,从理论上的超球面表示走向真正高效的大规模工业级预训练,往往横亘着巨大的工程与优化鸿沟。最新研究《Training nGPT》给出了一套可落地的完整训练配方,并将其实验验证推向了包含 Transformer 与 Mamba-2 混合架构、采用专家混合(MoE)的现代前沿模型中。实验结果表明,在高达 14B 参数量的混合 MoE 架构上,nGPT 展现出了惊人的数据利用效率:达到与 AdamW 训练的未归一化基线模型相同的验证损失,所消耗的训练 Token 数量直接缩减了约一半。
这不仅意味着超球面表示在复杂、非纯 Transformer 架构中依然高度有效,也向业界展示了一种可能打破现有训练范式的全新路径。
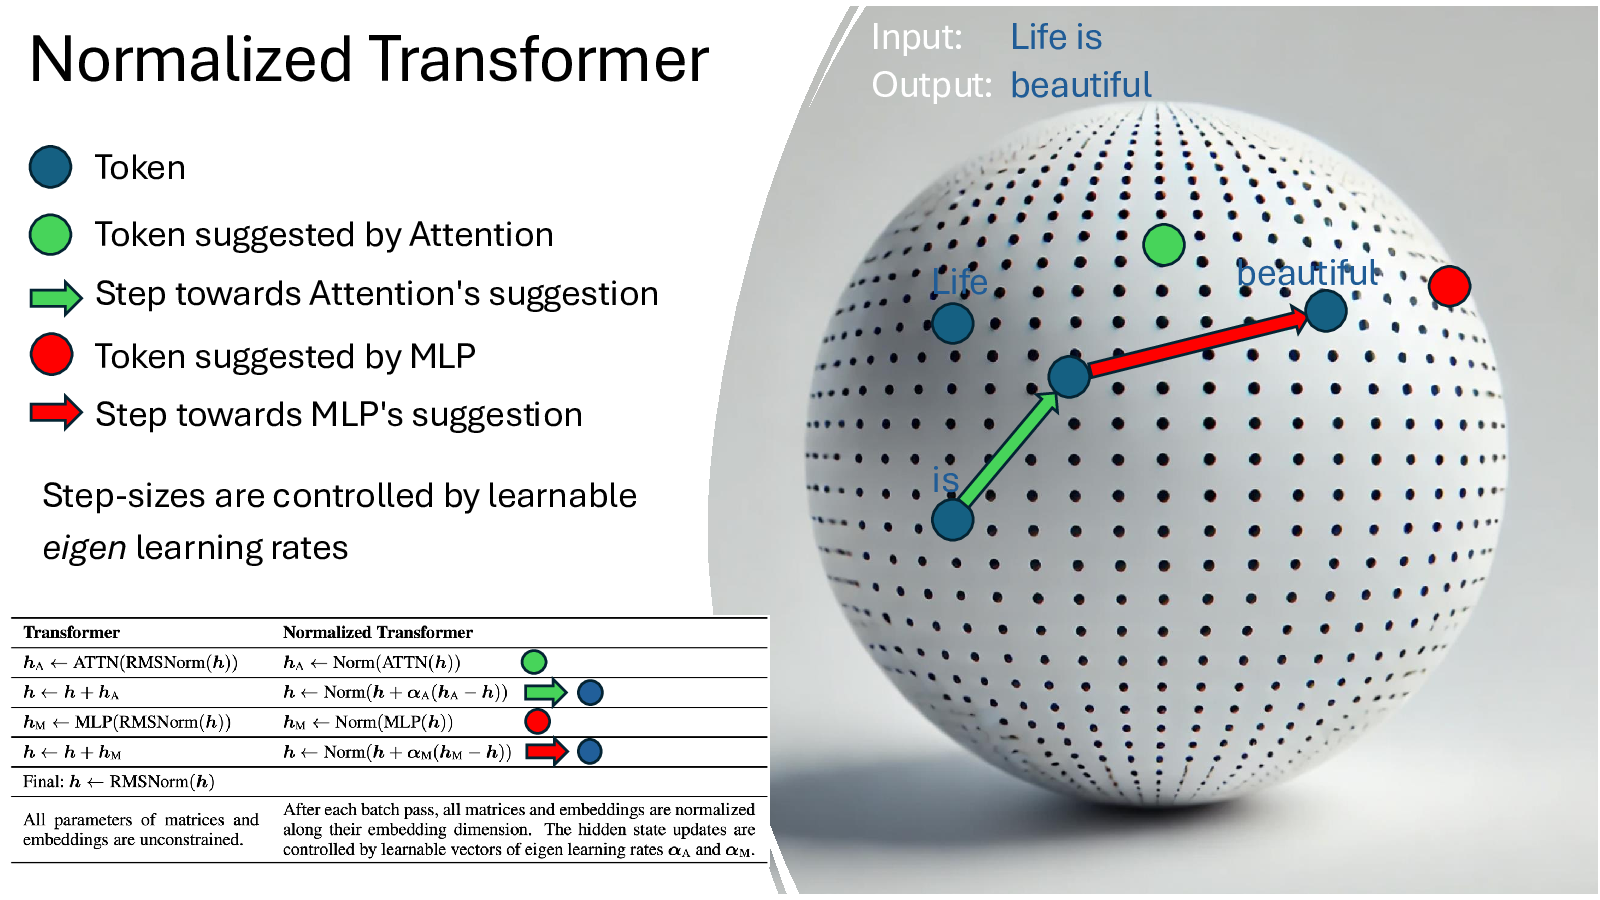
从欧氏空间到超球面:nGPT 究竟改变了什么
传统的 Transformer 或混合架构在欧几里得空间中进行矩阵乘法与残差累加。由于特征向量的模长可以自由变化,表征的相似度度量与更新方向往往受到向量尺度的强烈干扰。
nGPT 的核心理念是将网络中的每一处向量表示——包括隐藏状态、注意力机制中的键值对、MLP 的投影矩阵向量,全部强制归一化为单位模长。如上图所示,以输入序列预测下一个 Token 为例,初始 Token 在超球面上被表示为坐标点;自注意力模块计算上下文关系后,在球面上提议一个更新方向;中间状态沿着超球面大圆弧向该提议迈出一段步长;随后的 MLP 模块再次提出新的目标点,隐藏状态再进行一次球面上学习到的插值更新。
在多层堆叠下,Token 预测任务彻底转变为在超球面上的多步优化轨迹。这里的模型权重向量不再是随意延展的超平面法向量,而是超球面上的一组“锚点(Anchors)”,内积则严格对应着超球面上的夹角相似度。这种几何上的纯粹性从数学上杜绝了隐层激活发散或权重梯度崩溃的风险,但同时也对优化过程提出了严苛的新挑战:在流形约束下,梯度的几何含义变了,传统的学习率衰减策略和自适应优化器也将失去原本的假设基础。
针对这些问题,该论文围绕梯度预调理、学习率退火以及优化器门控机制,构建了一套完整的底层配方。
关键组件一:Logit 梯度预调理(LGP)
在超球面设定下,由于隐藏状态和词表输出嵌入向量都具有单位模长,原始输出未缩放的 Logit 实际上是被严格限制在 $[-1, 1]$ 内的点积。为了控制预测概率分布的尖锐程度(Sharpness),网络需要一个可学习的词表级缩放向量 ${\mathbf{s}}_{z} \in \mathbb{R}^{V}$,未归一化的 Logit 表达为:
\[{\mathbf{z}} = {\mathbf{s}}_{z} \odot {\mathbf{u}}\]其中 ${\mathbf{u}}$ 为规范化隐藏状态与输出词向量的点积。然而反向传播时,损失函数 $\mathcal{L}$ 对中间量 ${\mathbf{u}}$ 的梯度会被直接乘上 ${\mathbf{s}}_{z}$:
\[\frac{\partial\mathcal{L}}{\partial{\mathbf{u}}} = {\mathbf{s}}_{z} \odot \frac{\partial\mathcal{L}}{\partial{\mathbf{z}}}\]随着训练推进,高频词和特定语法标记对应的缩放系数往往会迅速放大,导致其反向梯度被过度拉伸,破坏梯度的平稳性。为此,研究团队设计了 Logit 梯度预调理(Logit Gradient Preconditioning, LGP),引入幂次参数 $q$ 与均值归一化项,将梯度更新修正为:
\[\frac{\partial\mathcal{L}}{\partial{\mathbf{u}}} \leftarrow \left(\frac{{\mathbf{s}}_{z}}{\mathrm{mean}({\mathbf{s}}_{z})}\right)^{q} \odot \frac{\partial\mathcal{L}}{\partial{\mathbf{z}}}\]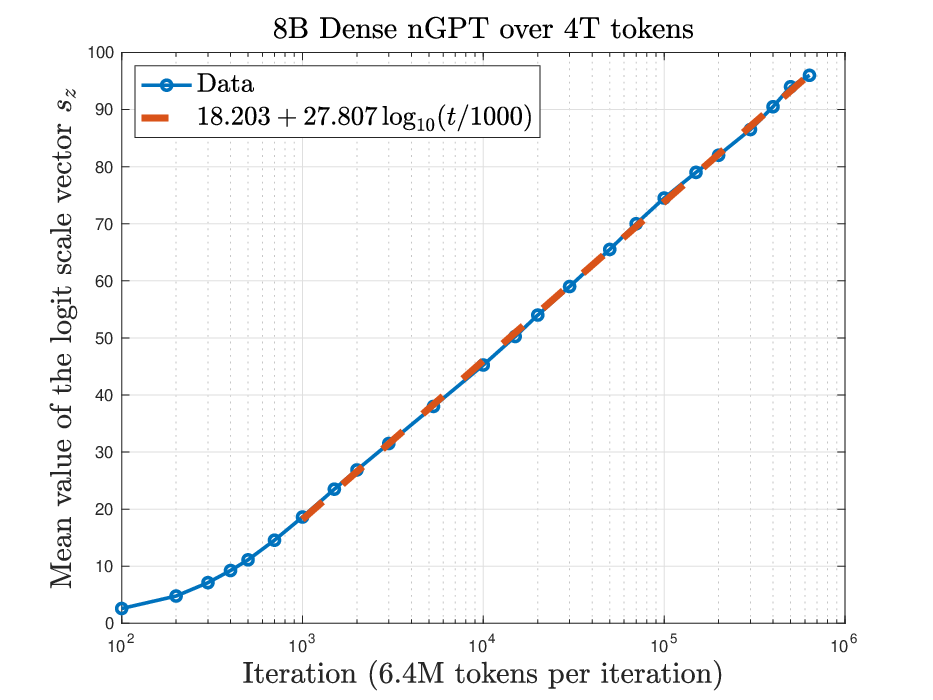
当选取 $q=1$ 时,系统消除了随时间急剧变化且不可控的全局尺度放缩效应,在完全不改变前向传播数学性质的前提下,大幅稳定了输出层的反向动力学。
关键组件二:重构时间分配的对数学习率衰减
大模型训练通常使用余弦退火(Cosine Annealing)或预热-平稳-衰减(WSD)策略。但在参数归一化的网络中,由于权重模长被锁死在单位球上,模型无法通过改变权重模长来被动调节“有效学习率(Effective Step Size)”。换言之,优化器施加的学习率乘子,将百分之百、不打折扣地映射为参数在超球面上的角速度位移。
研究者提出了一种对数学习率衰减(Logarithmic Learning Rate Decay)方案。在完成前 10% 步数的线性预热后,退火乘子按如下对数曲线逐步回落:
\[\eta(t) = \eta_{\min} + \left(\eta_{\max} - \eta_{\min}\right) \left[ 1 - \frac{\log\left(1 + \frac{r}{\rho}\right)}{\log\left(1 + \frac{1}{\rho}\right)} \right]\]其中 $r \in [0, 1]$ 为退火阶段的相对进度参数,$\rho$ 则控制曲率。
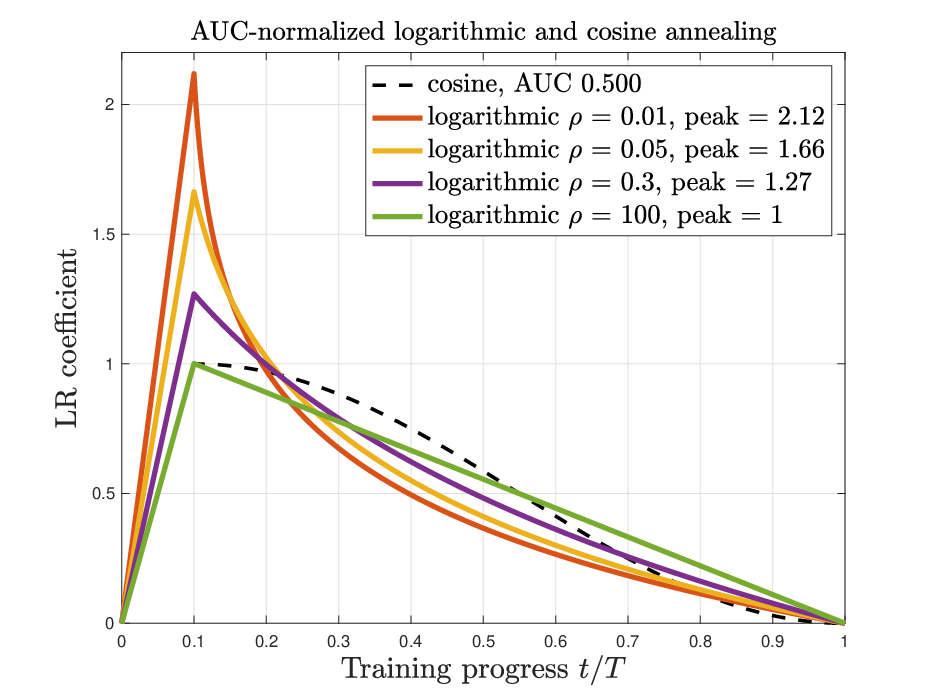
上图展示了在保持学习率曲线下面积(AUC,即累积学习率预算)完全相等的前提下,不同 $\rho$ 值的对数衰减与余弦衰减的走势对比。余弦衰减在中期变化相对温和,而小 $\rho$ 值的对数衰减则在预热结束后迅速释放大量的角位移预算,使参数在训练早期快速大步探索,而在后半程则留出极其漫长而平缓的微调长尾。这种早激进、后深耕的节奏,完美契合了超球面上早期粗排拓扑、后期精细微调的物理图景。
关键组件三:GatedAdamW 与角位移安全截断
标准的 AdamW 优化器利用一阶矩 ${\mathbf{m}}{t}$ 与二阶矩 ${\mathbf{v}}{t}$ 计算更新步长。分母项中的数值稳定常数 $\epsilon$ 虽然最初只是为了防止除零,但数学推导表明,它实际上充当了一个隐式的平滑门控:当梯度二阶矩远小于 $\epsilon$ 时,步长受限;当二阶矩远大于 $\epsilon$ 时,步长趋近于符号梯度。
本文提出将其显式解耦,构造出 GatedAdamW。定义自适应步长分母 ${\mathbf{d}}{t} = \sqrt{\hat}{t}} + \epsilon_{\mathrm{num}}$,并通过显式的 Sigmoid 门控因子 $\mathbf{\gamma}_{t}$ 来调制更新强度:
\[\mathbf{\gamma}_{t} = \sigma\left(a \log\frac{{\mathbf{d}}_{t}}{\epsilon_{\mathrm{gate}}}\right)\]参数更新规则相应变为:
\[\mathbf{\theta}_{t} = \mathbf{\theta}_{t-1} - \eta_{t}\left(\alpha\,\mathbf{\gamma}_{t} \odot \frac{\hat{{\mathbf{m}}}_{t}}{{\mathbf{d}}_{t}} + \lambda\mathbf{\theta}_{t-1}\right)\]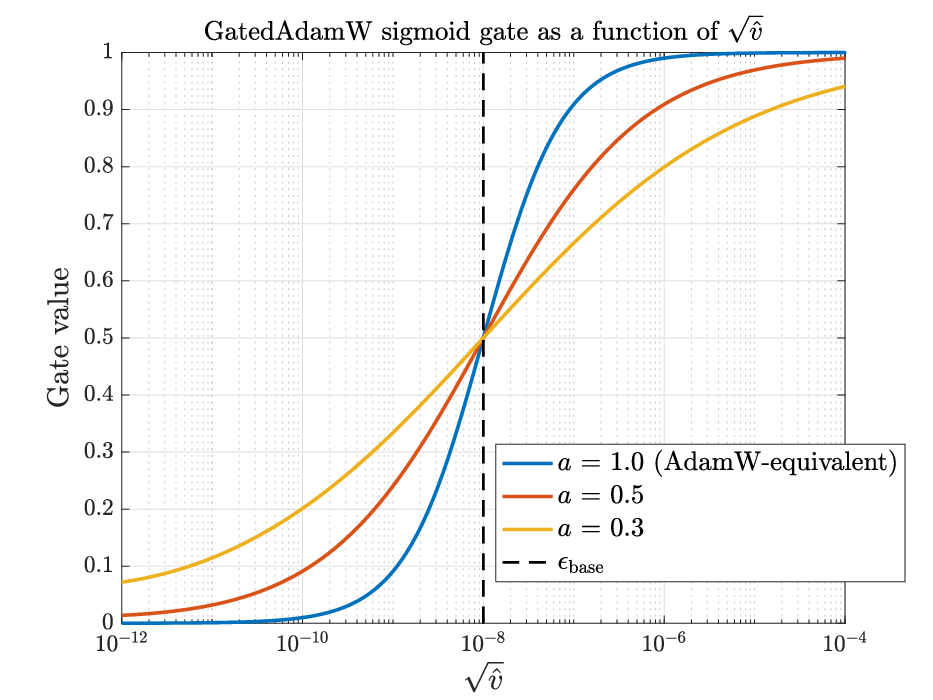
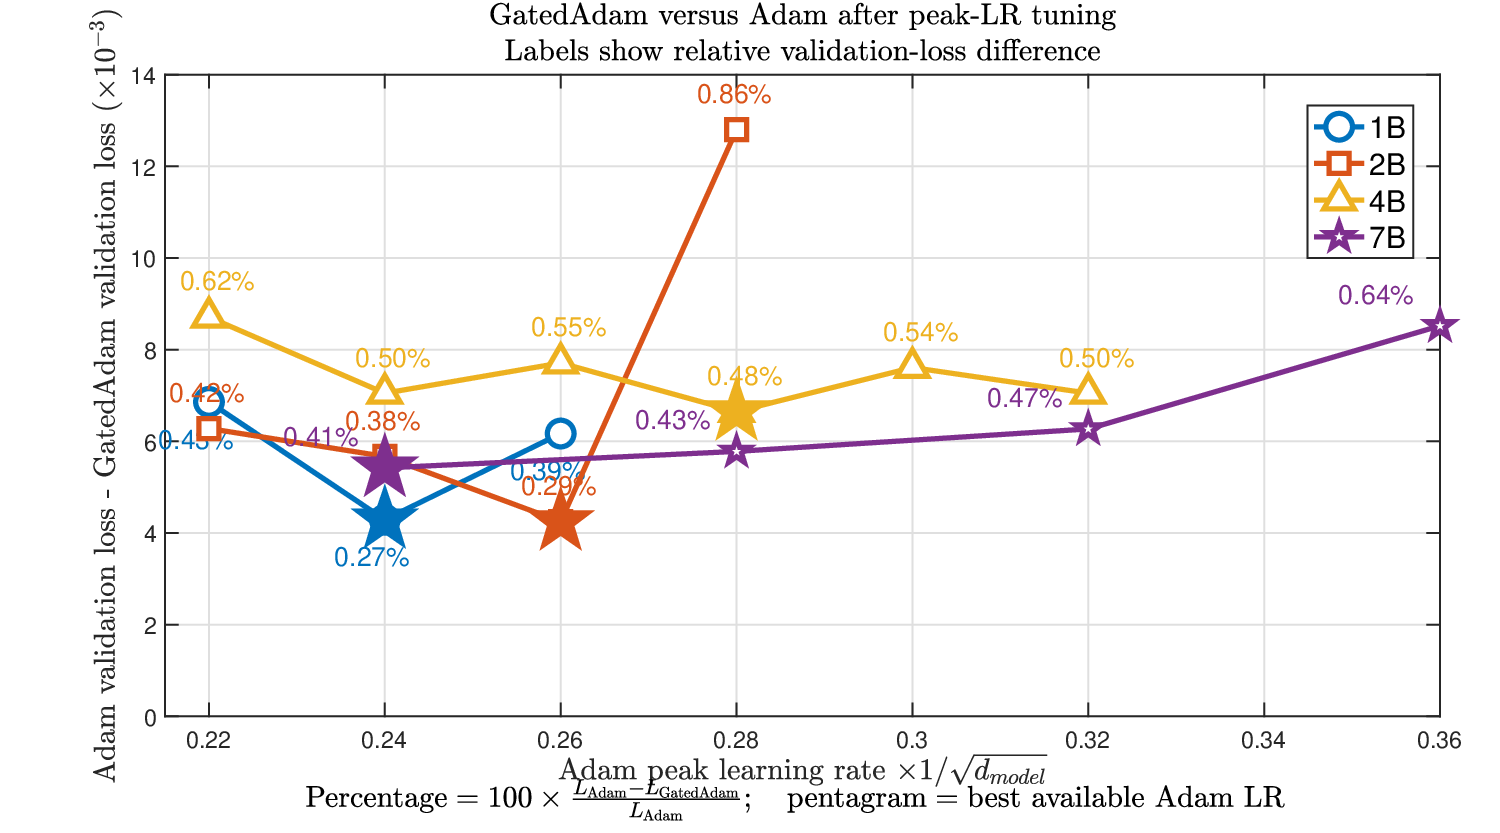
参数 $a$ 负责调节转换区间的陡峭程度。当 $a=1$ 时,其行为在数学上等价于经典的 AdamW 门控;而当调小至 $a=0.5$ 时,曲线过渡变得更加柔和,使得处于低信噪比状态的坐标维度不会被一刀切地抑制,也不会突兀地承受满额自适应更新,从而在超球面各向异性流形上维持了更优的平滑度。
除了门控机制外,作者还引入了角位移截断(Angular Step Cap, ASC)。在每次参数更新候选向量 $\widetilde}{t}$ 形成后、执行最终单位归一化之前,计算其相对于上一时刻权重 ${\mathbf{w}}{t-1}$ 的正切分量 ${\mathbf{u}}{t}$ 与转动角 $\phi{t}$:
\[\phi_{t} = \operatorname{atan2}\left(\|{\mathbf{u}}_{t}\|_{2},\, \left\langle\frac{{\mathbf{w}}_{t-1}}{\|{\mathbf{w}}_{t-1}\|_{2}}, \widetilde{{\mathbf{w}}}_{t}\right\rangle\right)\]如果单步偏转角超过了预设的上限 $\theta_{\max}(t)$,系统将通过正弦和余弦函数直接将候选向量投影回最大允许偏转角的球面上。这给非嵌入层的参数演化加上了一道不可逾越的几何安全底线。
适配现代架构:把 Mamba-2 与 MoE 搬上超球面
此前的归一化网络多局限于纯 Dense Transformer 玩具模型,如何让超球面学习在涵盖状态空间模型(SSM)和稀疏路由的工业级混合架构中成立,是这篇论文极具含金量的地方。
研究团队选用了英伟达 Nemotron-3 体系所采用的先进架构:混合 Mamba-2 与带有专家混合(MoE)的前馈层。改造要点聚焦于去除破坏几何尺度的组件并建立合理的尺度代理:
-
投影矩阵全面归一化:无论是自注意力、Mamba-2 还是 MoE 专家前馈块,凡是构成线性投影的权重矩阵,均在嵌入维度(如 $d_{\text{model}}$)方向执行强制单位模长归一化。在分布式训练中,这一约束被严格绑定在优化器所操作的底层参数上。
-
剔除 RMSNorm 与标量尺度重注入:在 Mamba-2 块中直接剥离了原有的 RMSNorm 结构,引入可训练标量 $s_{\mathrm{mamba}}$ 对输入激活进行重缩放,从而使进入 SiLU 激活函数的输入落入合理的非线性敏感区间。在 MoE 路由部分,同样移除常规归一化,引入可训练标量 $s_{\mathrm{moe}}$ 规范化 Sigmoid 路由器的输入分布。这种采用标量而非向量的处理,在数学上严格维持了超球面各向同性放缩的几何解释。
14B 参数实测:数据效率为何能提升一倍?
为了客观评估这套配方的扩展性,作者采用了 Nemotron-3 Nano 的标准 Scaling 梯队进行对比。评估涵盖了 1B(0.21B 激活参数)、2B(0.37B 激活参数)、4B(0.61B 激活参数)、7B(0.91B 激活参数)直到 14B(1.74B 激活参数)的五种规格,训练数据量严格按照激活参数的 320 到 420 倍进行配置,14B 模型训练 Token 规模达到 560B。
评估基线(GPT)采用由原作者团队高度调优的 AdamW 方案配合 WSD 学习率调度,而 nGPT 则采用全套归一化配方。
整体数据显示,在 1B 至 14B 的全尺寸区间内,nGPT 的最终验证损失(Validation Loss)普遍比基线模型低约 2.5%。不要小看这 2.5% 的绝对降幅——在参数 Scaling 规律极其陡峭的深水区,验证集困惑度或损失下降几个百分点,往往需要数倍的算力或数十倍的数据规模才能换取。
更加引人注目的是收敛动态学特征。在 14B 参数(1.74B 激活)的完整训练轨迹中,基线 GPT 受 WSD 调度的强行拖尾影响,在退火前一直处于较高的损失位点;而 nGPT 则表现出早期稍缓、中后期急剧加速收敛的特性。
最终收敛对比表明:14B 规格的 nGPT 达到基线模型消耗 560B Token 时的验证损失终点,仅仅使用了大约一半的训练 Token。 这一数据效率的倍增,强有力地印证了超球面表征学习在消除尺度冗余自由度后所释放的表征潜力。
为了厘清性能收益究竟来自何处,作者进一步对 GatedAdamW 的门控锐度进行了剥离实验。在 1B 到 7B 模型上,保持峰值学习率最优配置,对比了平滑门控($a=0.5$)与传统 Adam 等价门控($a=1$)的差异。实验显示,平滑门控相比传统门控能带来约 15% 到 20% 的 Token 节约,但相较于整个 nGPT 带来的 50% 效率飞跃,优化器门控调整只是拼图中的一块。真正决定性的质变,仍然源于超球面参数化本身与整套几何训练配方的协同效应。
冷思考与局限性
尽管这项研究在效率数字上极其抢眼,但从审慎的技术视角来看,仍有几个现实层面的局限需要正视:
首先,受限于整体算力预算,论文作者明确表示并未进行穷尽式的单组件超参数消融实验,学习率随模型参数量变化的精确 Scaling Law 尚未形成严格的经验公式闭环。
其次,评测指标主要集中在训练集与验证集的预训练 Loss 上。尽管损失函数的收敛通常与下游表现高度正相关,但在少样本上下文学习(In-context Learning)、逻辑推理基准(如 GSM8K、MATH)以及指令遵循微调(SFT)中,被约束在超球面上的表征是否具有与经典模型完全一致或更优的泛化行为,依然缺乏更大规模的下游评测背书。
最后,参数归一化虽然消除了尺度爆炸,但在分布式训练中频繁进行流形投影与角位移截断,对通信底座与底层算子(Kernel)融合提出了全新的实现要求。现存针对标量乘法和标准矩阵乘深度优化的硬件加速库,尚需要时间去完全兼容这套几何计算范式。
总结
《Training nGPT》的价值在于,它撕开了长期以来大模型训练“参数与激活在无界欧氏空间内无序震荡”的理所当然,把几何约束从纯理论探讨落地为一套兼顾 Mamba-2、MoE 架构与百亿参数规模的实用工程配方。
在算力成本与高质量数据日益枯竭的当下,通过重新定义模型特征空间的几何形态,换取近一倍的数据效率提升,无疑为后 Transformer 时代的架构演进与优化器设计提供了一条极具启发性的思路。