中科院解析长程规划机制:从预训练世界模型到多教师在线蒸馏
The Physics of Multi-Turn Long-Horizon Planning: From Pre-training to Post-training via Single- and Multi-Teacher On-Policy Agentic Distillation
在从单一问答走向通用智能体(Agent)的演进过程中,多轮长程规划(Multi-Turn Long-Horizon Planning)被普遍视为最核心也最脆弱的能力。当前的很多大模型在单轮对话、代码补全或短流程工具调用中表现优异,但在面对需要数十步交互、环境状态动态演变、依赖先决条件的复杂环境时,往往迅速陷入决策漂移或逻辑崩溃。
ArXiv URL:https://arxiv.org/abs/2607.24720v1
这种能力的瓶颈究竟出在哪里?现有的研究往往受制于一个根本性难题:大模型所依赖的海量互联网预训练数据是不透明且不可控的。研究人员无法确切知晓,模型展现出的长程规划能力究竟是在预训练阶段就已成型、只是在后训练中被激发,还是完全依靠强化学习等后训练算法凭空学到的;更无法定量剥离数据质量、技能组合方式与优化算法对长程规划的影响。
针对这一黑箱困境,中国科学院与中国科学院大学的研究团队提出了系统剖析多轮长程规划“底层物理学”(Physics of Multi-Turn Long-Horizon Planning)的分析框架。研究通过构建一个高度可控的合成规划世界,系统解构了智能体规划能力从预训练获取、单教师强化学习与在线蒸馏塑造,到多教师在线蒸馏整合的全生命周期机制。这项工作为大模型长程规划能力的构建指明了清晰的技术路径。
构建受控实验场:拆解长程规划的生成逻辑
要科学研究长程规划能力的来源,首先需要一个完全消除数据污染、可精确调控任务复杂度的闭环环境。研究团队设计了一套可控规划环境(Controllable Planning Gym),将规划问题抽象为在分层技能图谱上的序贯决策任务。
每个任务领域被形式化为一棵深度为 $H$ 层、每层包含 $W$ 个类别、每个类别具有 $N$ 个具体实体的树状结构。状态转移规则基于析取范式与合取范式构建:
\[v \iff (u_{1,1} \land \dots \land u_{1,k_1}) \lor \dots \lor (u_{m,1} \land \dots \land u_{m,k_m})\]这意味着某个高阶目标的达成,依赖于前序若干层级材料的逻辑合成。通过动态调整目标物品所处的层级与初始库存,研究团队可以精准控制任务规划的绝对步长(分为短程 Short、中程 Middle、长程 Long),并在初始背包中按比例掺入干扰项以模拟真实决策噪声。
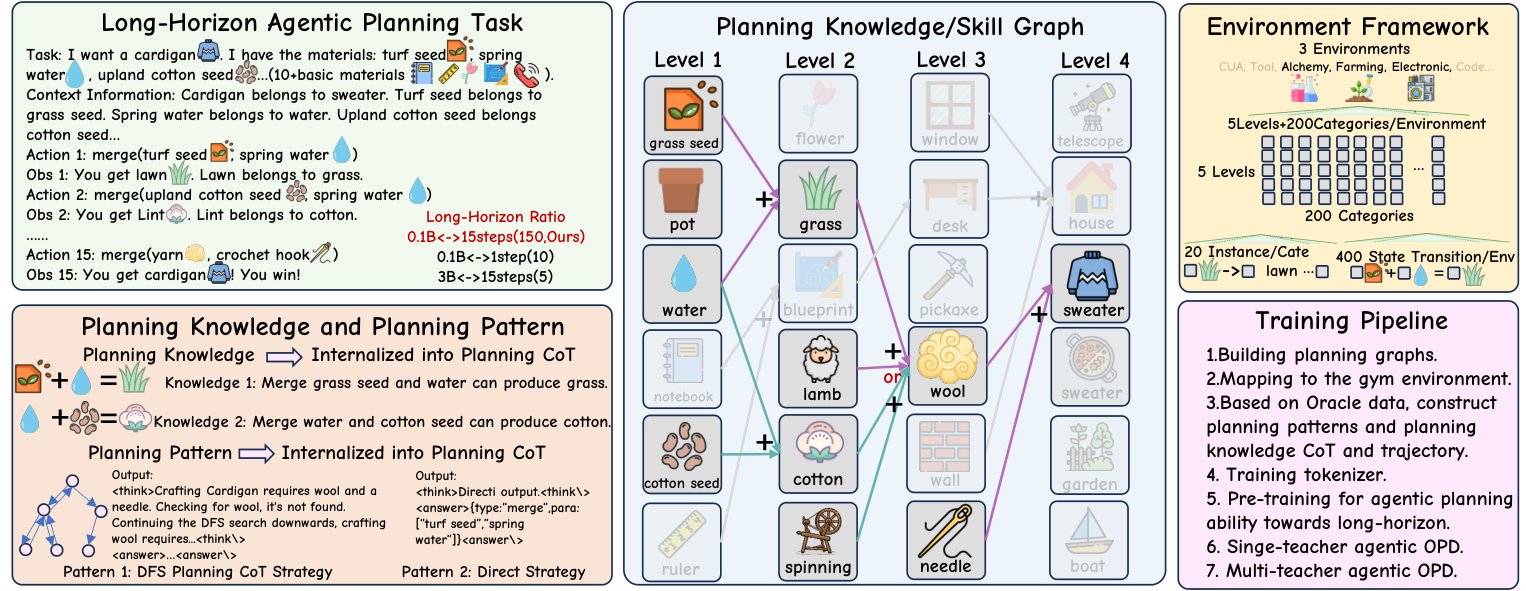
在此基础之上,研究团队基于 Qwen2.5 架构,从零初始化模型并从零训练专用分词器(Tokenizer),彻底隔绝了外部预训练语料的先验泄漏。这一设定使得研究者能够如同在物理实验室中控制变量一样,独立考察预训练与后训练不同阶段对规划能力的影响。
阶段一:规划能力的预训练获取,世界模型与数据质量的决定性作用
在预训练阶段,主流观点往往存在两种假说:一种认为模型只需学会海量原子技能的模仿,就能自然通过组合泛化解决长程任务;另一种认为只需让模型直接拟合动作序列即可。研究团队从数据格式、数据分布与数据质量三个维度进行了系统实证,得出了颠覆直觉的结论。
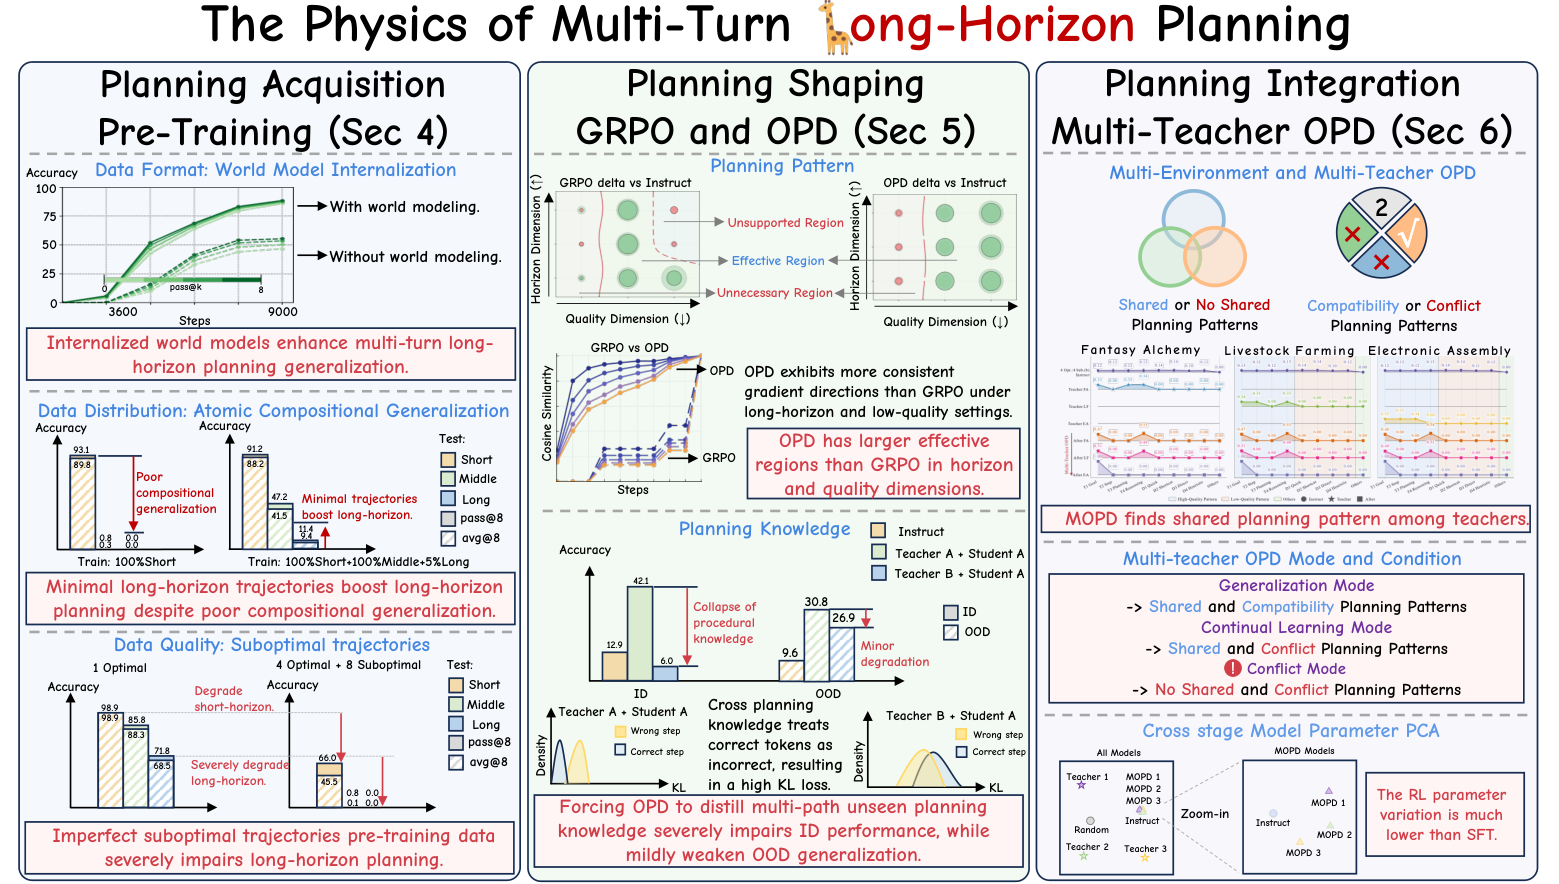
首先是数据格式维度的内化世界模型(World Model Internalization)。传统的行为克隆往往采用直接动作预测(Direct Action Prediction),即根据当前状态直接输出下一步动作。而研究团队对比了显式状态转移建模的思维链模式(CoT State Transition Modeling)。在这一模式下,模型被强制要求先输出对环境物理规则的模拟:
\[\mathcal{T}: \mathcal{S} \times \mathcal{A} \rightarrow \mathcal{S}\]即在真正采取行动前,先在隐式认知空间中模拟动作 $a_t$ 作用于状态 $s_t$ 后生成的新状态 $s_{t+1}$,以此将规划过程转化为在内化状态空间上的深度优先搜索(DFS)。实验表明,显式构建世界模型的模型在长程任务上的泛化能力显著优于直接动作预测。这是因为多轮长程交互的容错率极低,仅仅模仿动作策略会导致预测误差在步长增加时迅速累积,而显式预测环境状态转移则为模型提供了推演与自我纠错的“内部模拟器”。
其次是数据分布维度的原子技能组合神话。如果预训练语料中只包含完美的原子级技能(单步或极短步长的转移规则),模型能否展现出组合泛化(Compositional Generalization)能力以解决数十步的长程任务?实验给出了否定答案:仅依靠原子技能训练的模型在面对长程组合任务时几乎完全失效。然而,机制的关键转折点在于,预训练语料中只需掺入极小比例的长程轨迹数据,模型的长程规划能力就会出现突变式的提升。这表明,虽然组合泛化无法凭空自发涌现,但少量长程轨迹能够充当结构脚手架,迅速激活模型将离散原子技能串联成深层搜索树的能力。
最后是数据质量维度的误差放大效应。现实中的网络数据充斥着次优轨迹(Suboptimal Trajectories)、冗余步骤甚至逻辑死胡同。研究发现,长程规划对次优数据的敏感度呈指数级上升。在短程任务中,混杂部分次优轨迹对最终成功率影响轻微;但在多轮长程场景下,早期的微小次优决策会导致后续交互偏离最优吸引子,决策噪声在长程时域上被不断级联放大,造成长程规划性能的断崖式下跌。这也直接解释了为何基于未经清洗的公开语料很难直接预训练出强大的规划智能体。
阶段二:后训练的能力塑造,GRPO与在线蒸馏的边界判定
当模型经过预训练获得初始能力后,后训练(Post-training)如何进一步重塑规划表现?研究团队从互信息(Mutual Information)的视角将规划能力解构为两个层面:具有跨任务通用性的“规划范式”(Planning Patterns,如回溯、剪枝、状态校验等通用决策结构,与具体实体互信息较低),以及高度依赖特定任务规则的“规划知识”(Planning Knowledge,如特定物料配方与业务脚本,与任务实体互信息极高)。
针对通用规划范式的塑造,研究团队界定了强化学习在规划任务中的三类适用边界区间:
不必要区间(Unnecessary Region):当预训练数据质量极高且任务步长较短时,预训练模型本身已具备极强的规划概率分布,后训练带来的额外收益微乎其微。
有效区间(Effective Region):当处于中长规划步长且初始预训练存在一定缺陷时,后训练算法能够显著拉升策略表现。
不受支持区间(Unsupported Region):当任务复杂度极高、状态空间过于庞大且初始策略缺乏有效先验时,算法无法在有限采样中获得有效正反馈,导致后训练完全失效。
在有效区间内,研究重点对比了当下主流的群体相对策略优化(GRPO)与基于在线采样的智能体在线蒸馏(On-Policy Agentic Distillation, Agent-OPD)。传统的 GRPO 依赖标量奖励对生成的整个轨迹进行优势度估计,但在长程决策中,稀疏的标量反馈难以准确进行信用分配(Credit Assignment)。往往一个包含二十步的轨迹最终失败,并非每一步都错,但稀疏回报会导致所有步骤的梯度更新方向发生混淆。
相比之下,Agent-OPD 直接在学生模型自主探索生成的轨迹 $\tau \sim \pi_{\theta}$ 上,计算学生策略分布 $p_{k,t}$ 与理想教师策略分布 $q_{k,t}$ 之间的逆向 KL 散度(Reverse KL Divergence):
\[\mathcal{L}_{\text{Agent-OPD}}(\theta) = \mathbb{E}_{\tau \sim \pi_{\theta}} \left[ \sum_{k=1}^{K} \sum_{t=1}^{T_k} D_{\text{KL}}(p_{k,t} \parallel q_{k,t}) \right]\]这种基于 Token 级别的密集监督,为长程规划中的每一步推理与动作提供了即时且一致的梯度引导方向。实验表明,在低质量预训练数据和极长步长的恶劣条件下,OPD 的有效适用区间明显宽于 GRPO,成功挽救了许多 GRPO 无法收敛的长程任务。
然而,对于具体“规划知识”的塑造,研究团队揭示了一个极具警示意义的失效陷阱。当教师模型掌握的底层业务知识与学生模型原有的知识结构存在冲突时(例如面对完全未见过的多路径复杂业务流),即便教师模型的答题准确率极高,直接采用 OPD 进行强制在线蒸馏也往往无法让学生顺利学会新知识。更严重的是,这种后训练会迅速破坏学生模型原先建立得极好的域内世界模型(In-domain World Modeling),导致原有领域性能崩塌,而新领域能力又未能完全确立。
这一现象的本质原因在于,具体规划知识具有极高的互信息,需要对网络参数进行精确的样例级重写。而基于策略梯度的在线微调机制更倾向于提供平滑的、小幅度的参数偏移,不足以在保留旧知识的同时稳固嵌入全新的高维状态转移逻辑,最终导致模型在认知重构过程中陷入“进退失据”的中间态。
阶段三:多教师能力整合,MOPD的协同与冲突法则
在工业界落地智能体时,往往需要融合来自不同专家模型的能力。研究团队进一步探讨了多教师在线智能体蒸馏(Multi-Teacher On-Policy Distillation, MOPD)在整合不同规划能力时的深层机制。实验揭示,MOPD 在多轮规划中的本质并非简单的知识叠加,而是推动学生模型的策略分布向多个教师所共享的“通用规划范式”交集进行收敛。
根据不同教师所在环境之间的规划范式关系,MOPD 表现出三种截然不同的运行模式:
-
泛化模式(Generalization Mode):当不同环境之间共享兼容且通用的规划范式时,MOPD 能够展现出优异的跨环境迁移泛化能力。智能体在一个环境中被激活的高阶回溯与搜索逻辑,能够无缝迁移到结构相似的未见测试环境中,打破了传统单一环境过拟合的界限。
-
持续学习模式(Continual Learning Mode):当不同环境的局部动作规则存在差异,但在宏观层面仍保留部分共享的规划范式结构时,学生模型能够通过 MOPD 逐步适应新教师的特征,同时有效抑制对旧环境的灾难性遗忘,展现出稳健的增量适应能力。
-
冲突模式(Conflict Mode):当不同教师所代表的环境呈现出完全对立的规划决策范式时,MOPD 则会遭遇灾难性的跨环境干扰。学生模型在强行拟合新教师分布的过程中,旧有决策逻辑被迅速擦除,产生剧烈的策略震荡和性能衰退。
这一发现明确划定了大模型模型整合(Model Consolidation)的工程边界:通过多教师蒸馏融合智能体能力的前提,是环境间存在相容的宏观认知结构,而非强行将行为模式互斥的系统捏合在一起。
长程规划智能体的构建启示
中科院这项对多轮长程规划物理学机制的探索,厘清了当前智能体架构中若干长期模糊的认知,并为下一代通用智能体模型的训练管线提供了极具指导价值的实践原则。
在预训练阶段,单纯堆叠原子数据期待组合泛化涌现的做法已被证伪,必须在语料中显式引入以思维链构建的隐式世界模型状态转移预测,并保证极小比例但高质量的长程轨迹存在,同时严格清洗次优轨迹以防止长程误差扩散。在后训练阶段,基于密集分布对齐的 OPD 架构在长程信用分配上具备超越经典强化学习 GRPO 的稳健性,但必须区分通用规划范式与特定规划知识;对于未见的复杂特定任务知识,盲目使用在线蒸馏反而会瓦解原有的世界模型,应依赖更深度的前序数据注入。而在多模型融合阶段,能力的集成依赖于跨领域决策范式的结构一致性。
跳出单纯的刷榜思维,从底层的计算机制与信息流动规律去审视大模型决策智能的生成路径,这项研究所展现的不仅是长程规划失效的底层归因,更为大模型智能体迈向高可靠现实落地铺平了清晰的科学基石。