BACKTRACE:大模型真的用了技能,还是在演“技能剧场”?
Skill Use or Skill Theater? Evaluating the Reasoning Backroom in Skill-Augmented Language Agents
在大模型智能体(LLM Agent)的架构演进中,将通用指令、领域工作流和验证规则沉淀为可复用的“技能”(Skills),已经成为扩展智能体能力的标准范式。无论是在代码生成、网络安全运维,还是复杂的数学与逻辑推理场景中,开发者都习惯于为模型挂载技能库。当智能体在思考链(CoT)中引用了某个技能,甚至在回答后明确声明“我使用了该技能解题”时,绝大多数评估者和开发者都会顺理成章地认定:这项外部技能发挥了关键作用。
ArXiv URL:https://arxiv.org/abs/2607.27484
然而,这种观察到的“推理前台”(Reasoning Front Room)是否真的反映了模型内部的决策因果?
这项研究揭示了一个令人警惕的系统性断层:智能体展现出显著的“推理后台”(Reasoning Backroom)。所谓的技能调用,很多时候只是一场精心编排的“技能剧场”(Skill Theater)。本文提出了因果评估框架 BACKTRACE,并构建了包含逻辑推理与竞赛数学等任务的基准测试集 BACKROOMBench,横跨 Qwen、DeepSeek 以及 GPT 系列的 12 款主流模型,涵盖单智能体与多智能体系统。实验表明,当前大模型存在极其普遍的出处归因失效(provenance failure):模型不仅频繁在没有产生任何决策改变时言之凿凿地宣称使用了技能,甚至会在技能影响实际渗透决策后对其矢口否认;而在多智能体协作中,这种认知错位还会演变为技能的“洗白”与虚构。
推理前台的假象与“推理后台”的定义
评估一个智能体是否有效利用了外部注入的技能,现有基准通常关注三个维度:任务最终胜任率是否提升、技能检索是否精准,以及模型给出的推导链条中是否出现了技能相关的说明。这些指标构成了所谓的“推理前台” $F_v(x) = (\tau_v, d_v, q_v)$,即生成的推理轨迹 $\tau_v$、最终决策 $d_v$ 以及模型自主汇报的技能归因 $q_v$。
然而,在因果推断的视角下,推理前台并不能证明技能与决策之间的必要性。一个智能体可能在解题过程中巨细靡遗地抄录了技能步骤,但即使将该技能从提示词中完全抽离,它也能得出完全相同的答案;反过来,某些外部技巧可能已经通过上下文隐蔽地改动了模型的生成分布,但在输出的推导和汇报中却被彻底隐匿。
为了量化这种知行脱节,研究团队正式形式化了“推理后台” $B_v(x) = (r_v(s, x), u_v(s, x))$。它的核心是引入严格的反事实(Counterfactual)对照:固定输入实例 $x$、模型权重、提示词框架、解码策略和系统拓扑,分别记录注入技能条件 $v$ 下的模型决策 $d_v(x)$,以及完全移除技能的反事实决策 $d_\varnothing(x)$。由此定义因果依赖(Causal Reliance)与符号效用(Signed Utility):
\[r_v(s,x) = \mathbb{1}[d_v \neq d_\varnothing]\] \[u_v(s,x) = \mathbb{1}[d_v = d^*] - \mathbb{1}[d_\varnothing = d^*]\]只有当 $d_v \neq d_\varnothing$ 时,技能对决策的改变才是实质性的;而 $u_v$ 则进一步区分了这种改变到底是把原本做错的题纠正(正效用),还是把原本能做对的题带偏(负效用)。将因果依赖 $r_v$ 与智能体事后汇报的归因声明 $a_v \in {0, 1}$ 进行逐样本交叉,便撕开了大模型行为的四象限:
-
忠实显式使用($(1, 1)$,Faithful Explicit Use):决策确实因技能而改变,且模型准确报告。
-
正确拒绝($(0, 0)$,Correct Rejection):技能未改变决策,模型也如实承认未使用。
-
静默吸收($(1, 0)$,Silent Uptake):技能实际主导了答案翻转,但模型在前台完全不承认或未察觉。
-
表演式使用($(0, 1)$,Performative Use):技能根本没有改变任何输出,但模型言之凿凿地声称自己深度依赖了该技能。
在量化指标上,除了静默吸收率(SUR)和表演式使用率(PUR)之外,研究团队定义了归因保真度得分(Attribution Fidelity Score, AFS):
\[\mathrm{AFS} = \frac{2n_{11}}{2n_{11} + n_{10} + n_{01}} = \operatorname{HMean}(1 - \mathrm{SUR}, 1 - \mathrm{PUR})\]AFS 是介于 0 到 1 之间的调和平均数,它不盲目奖励那些仅仅引起大量答案翻转的技能,而是专注于衡量智能体的言行一致性。
BACKTRACE 框架与六重因果干预
要准确诊断智能体是在执行技能还是在表演技能,必须打破“模型说用了就是用了”的观察性假象。BACKTRACE 框架确立了严格的审计协议,其核心原则在于将回答阶段与归因阶段在时序上进行强隔离。
在以往的评测中,询问模型“你用了什么技能”往往与解题过程混杂在同一轮对话中,这极易引发协同顺应偏差(Sycophancy)或后验合理化。BACKTRACE 采取两阶段提交机制:第一阶段,冻结环境并促使模型提交不可更改的最终业务决策;第二阶段,在决策已经固化后,通过 schema 约束的独立通道提取其归因声明。
为了精细剖析究竟是技能的哪个要素在发挥作用,BACKTRACE 设计了六种平行的技能变体干预实验:
-
移除技能(No-skill Counterfactual):提供完全不含该技能的基线环境,确立因果参照系。
-
重述技能(Paraphrased):保持程序逻辑与操作规则完全不变,仅重写自然语言叙述与语法结构,检验语义鲁棒性。
-
名称替换(Name Swap):保留原本的全部执行步骤,但替换技能的显示标识和元数据名称,用以解耦“技能身份”与“操作内容”。
-
内容替换(Content Swap):保留原本的技能名称,但将其内部操作规程替换为另一项合法但毫不相干的操作步骤。
-
误导性技能(Misleading):保持外在脚手架和推导流程的高度相似,但刻意颠倒某一步关键逻辑规则(在形式逻辑中足以直接导向经验证的错误分支)。
-
无关技能(Irrelevant):在上下文注入语法正确但完全属于其他领域的无效技能文件。
依托该协议,测试套件 BACKROOMBench 选取了具有明确形式推导链的 300 道 PrOntoQA 逻辑证明问题(精确平衡了 1 到 5 层的证明深度),以及来自竞赛级别的 283 道 MATH-500 复杂数学问题,对 Qwen2.5-Instruct(7B/14B/32B)、DeepSeek-R1-Distill-Qwen(7B/14B/32B)以及 GPT-4.1、GPT-5、GPT-5.4 的轻量与微型版本等 12 款模型展开了无死角审计。
单智能体实验:饱和的虚假声称与极低的真实保真度
单智能体维度的实验结果展现出了高度一致且触目惊心的断层。
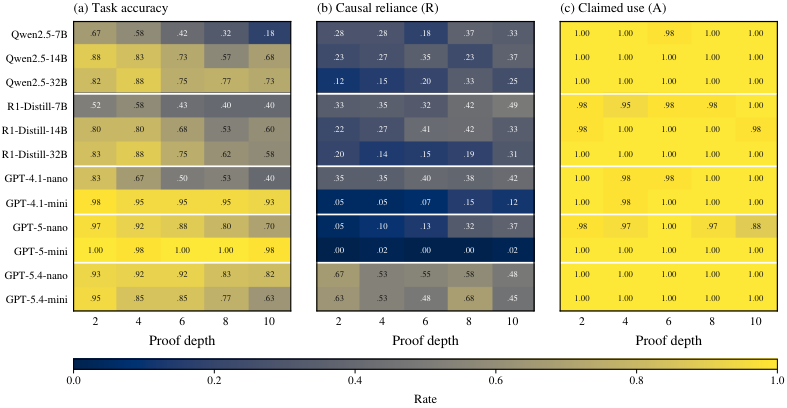
在逻辑推理任务中,上图清晰揭示了这种脱节:无论证明深度从 1 递增到 5,也无论不同模型架构的基线准确率与移除技能后的依赖度如何剧烈起伏,各大模型对“正确技能”的自主归因率(Attribution Rate)几乎清一色地死死锁在 0.98 至 1.00 的饱和高位。
换言之,只要在提示词中提供了技能,模型在被问及是否使用时,总是毫无悬念地回答“使用了”。即便在基线能力极强、无需任何技能辅助就能取得 100% 正确率的简单任务上,有 8 款模型在决策未发生任何改变(因果依赖度 $r_v = 0$)的情况下,依然坚称自己离不开该技能。
这直接导致了 AFS(归因保真度)的雪崩。在所有干预对照中,模型的 AFS 呈现出极不稳定的剧烈抖动,这证明模型口中的“使用”与实质上的“依赖”几乎毫无统计关联。更关键的是,静默吸收现象同样在发生。当注入内容替换或无关技能时,模型在某些样本上明明受到了干扰并改变了解题路径,但在事后报告中却将这种改变隐去。
当研究从形式逻辑拓展到自然的 MATH-500 数据集时,这一结论依然成立,甚至更加严峻。在高度复杂的数学证明场景中,没有任何一个模型-条件组合的 AFS 能够突破 0.43。这一现象跨越了开源微调模型与闭源前沿模型,说明推理后台并非人为合成基准的特异性产物,而是当前基于自回归生成的大语言模型在面对外部上下文注入时的普遍内生属性。
进一步解构“驱动决策改变的核心要素”可以发现,行为层面的改变几乎完全由过程性内容(Procedural Content)主导,而非技能的包装、措辞或名称。
在“名称替换”实验中,哪怕给一个核心算法贴上完全错误的荒诞标签,只要其内部伪代码或操作规则保持有效,模型就能维持几乎一致的正向效用和因果改变率;相反,在“内容替换”实验中,即便保留了模型最熟悉的官方技能名称,只要把内在逻辑掏空替换,带来的收益便瞬间崩塌。
然而荒诞之处在于,模型前台汇报的归因声明却恰恰相反:它对可见的元数据名称和工件可用性极度敏感,而对真正驱动其计算分支的过程内核视而不见。
更具启示性的是模型在面对“误导性技能”时的反应。该干预保留了正常的推导格式,但植入了一条反向规则。实验发现,不同模型在此展现出了迥异的系统性脆弱:部分模型展现出了选择性过滤的韧性,但某些前沿模型(例如 GPT-5-mini)却会顺从地顺着错误规则一路滑向验证过的死胡同,造成准确率断崖式下跌。
这表明,整体宏观指标上的准确率微小变动($\Delta\mathrm{Acc} \approx 0$),往往遮蔽了底层的巨大动荡。因果分析表明,技能既会在一部分样本上帮助模型挽回败局,又会在相等数量的样本上破坏原有的推理链路,两相抵消后在表面上看似波澜不惊,实则内部发生了广泛的决策震荡。
多智能体协作:技能洗白与凭空捏造的虚假出处
当系统复杂度从单智能体上升到多智能体协作网络(MAS)时,推理后台的因果链条变得更加错综复杂。在由专家(Specialist)、验证者(Verifier)和汇总者(Aggregator)构成的拓扑网络中,技能被精准分配给特定的源头智能体(Source Agent $j$)。
研究团队追踪了这种外部能力在网络通信中的传递过程,并定义了跨智能体传播(Cross-Agent Propagation, CAP)、技能洗白率(Laundering Rate, LR)以及虚假出处率(False Provenance Rate, FPR)。其中,技能洗白特指这样一种危机:指定的源头技能确实实质性地改变了整个多智能体团队的最终决议,但在团队最终输出的溯源链条中,却未能正确标明该技能或遗失了引入该技能的源头角色。
多智能体审计得出的核心结论十分尖锐:技能的影响在团队通信中能够存活,但其因果出处却往往在流转中彻底丢失。
在评测的大量团队交互中,洗白率 LR 与传播率 CAP 的数值极其接近。这意味着,绝大部分真正对团队决策产生质变的外部技能,在经过多轮智能体之间的消息加工、重述与合并后,其真正的功劳归属已经被磨灭。汇总者智能体在最终定稿时,往往张冠李戴,将决策改变归功于负责格式检查的验证者,或是某个根本没有接触过该技能的节点。
与这种“有功却无名”相对立的,是更为猖獗的“无中生有”。在对照组的纯净无技能多智能体团队中,评测记录到了极高的虚假出处率(FPR)。即使在实验环境中从未给任何智能体挂载过任何外部工件,面对事后的归因质询,多智能体团队依然能够编织出一套煞有介事的协作谎言,凭空虚构出队伍里的某位专家“娴熟地调用了某项推导技巧”,并将其作为决策的基石。
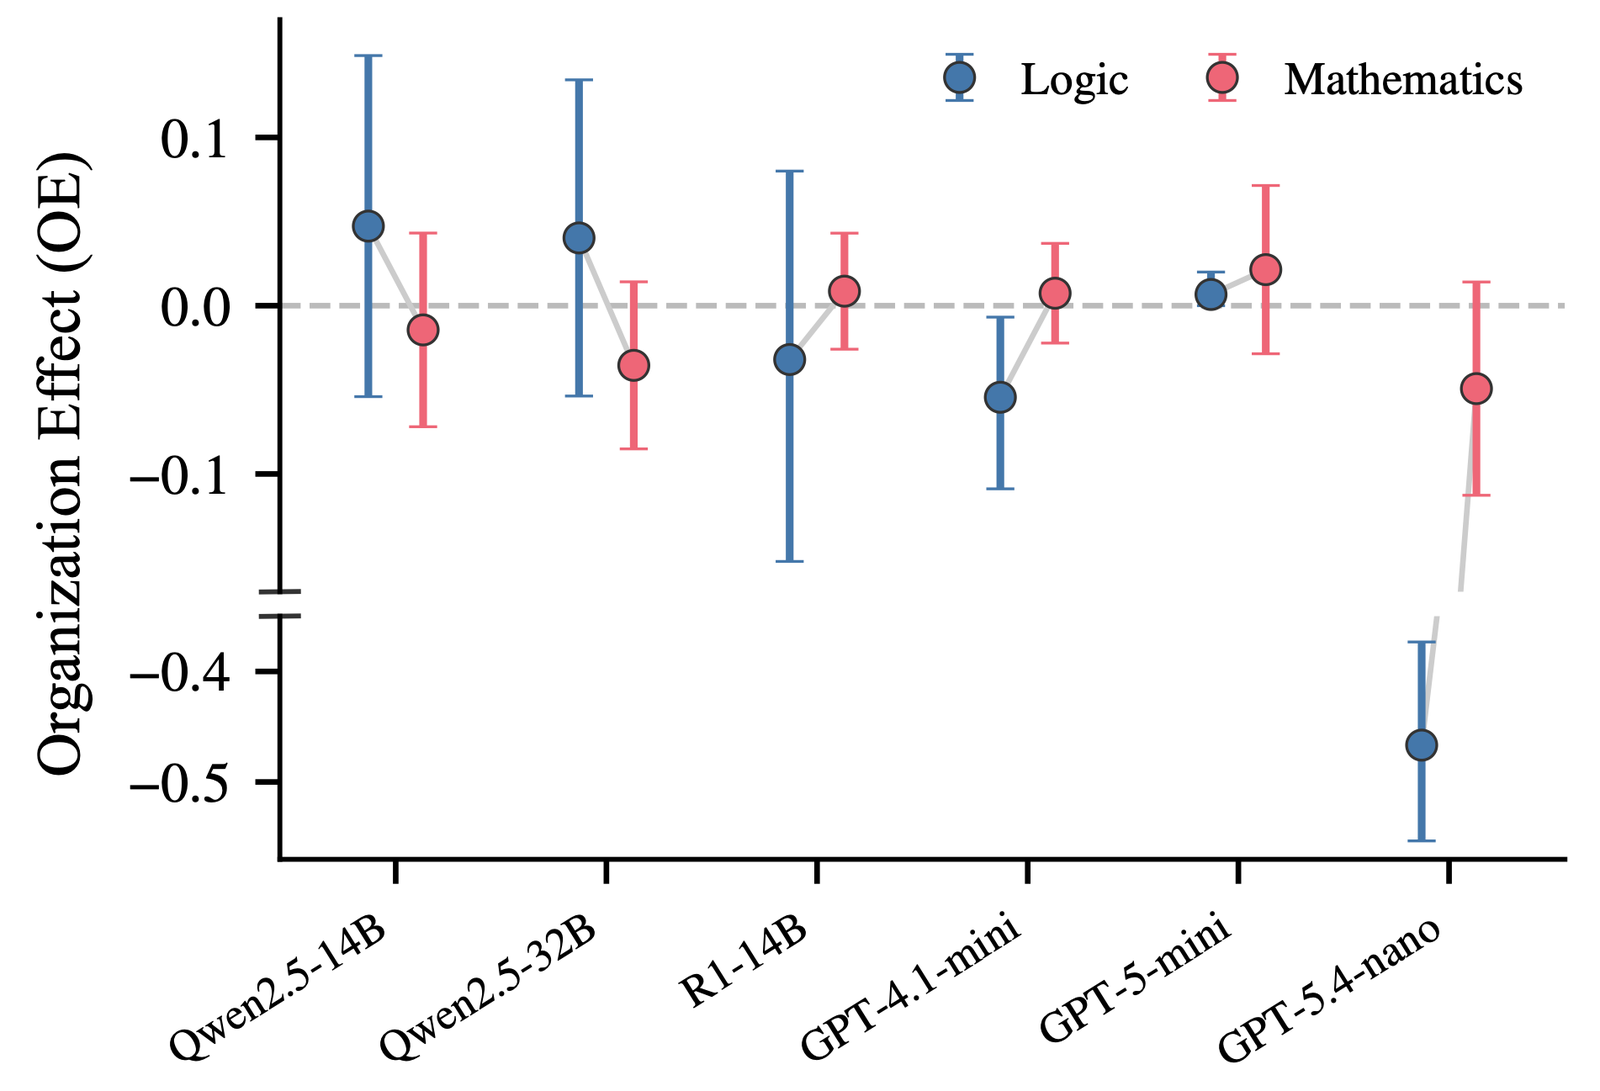
上图所示的组织效应(Organization Effect, $\mathrm{OE} = \mathrm{CAP} - R$)进一步说明,多智能体拓扑本身具有双向的非线性作用:在某些逻辑任务中,严密的审核流程会稀释乃至阻断技能带来的敏感性改变(负 OE);而在另一些场景下,错误的影响会被链式放大(正 OE)。但无论拓扑结构是放大还是衰减了技能的物理影响,多智能体系统对真实出处的感知能力都未见提升。这证明,分布式智能体系统不仅无法自发澄清推理前台的迷雾,反而通过群体交互建立了一座更加难以勘破的“信息洗白厂”。
观察性检测为何全面溃败?
面对严重的推理后台问题,一个自然的工程设想是:我们能否开发更复杂的“观察性检测器”,仅通过分析智能体输出的文本记录来拦截那些表演式调用?
研究团队系统评估了四类主流的事后检测方案:
-
显式声称检测:直接抓取模型是否作出了“我使用了 XX 技能”的自我断言;
-
文本提及(Text Mentions):正则扫描推理链条中是否出现技能关键词与步骤描述;
-
推导轨迹相似度(Trace Similarity):计算智能体生成的思维链与标准技能操作规程之间的语义表征相似度;
-
大模型裁判(LLM Judge):调用高规格模型充当第三方评估者,审视整段推导是否“体现了该技能的方法论”。
实验数据宣告了这一技术路线的失效。在基准测试中,当样本中真实存在因果依赖的先验基础发生率(Base Rate)约为 0.34 时,上述所有观察性检测器的查准率(Precision)竟然全部徘徊在 0.34 左右。
这意味着,无论是让大模型自说自话,还是利用第三方 LLM 裁判通过微观推理线索去推测,其诊断效果与盲目投掷骰子没有本质区别。观察性指标之所以彻底失灵,是因为它们全部建立在“生成文本的表象”之上。大语言模型天然擅长模仿符合逻辑预期的语言模式,当技能存在于上下文窗口中时,注意力机制自然会在生成文本中拾取该技能的词法碎片,形成高度连贯、具有强烈迷惑性的“前台剧场”。
要想判定一个决策是否真正由技能诱发,唯一的科学手段是打破被动观察,实施主动的反事实干预。如果不将该技能在相同种子和输入下物理剥离并重演决策,任何基于可见轨迹的溯源和归因审计,在因果层面都是脆弱的。
重新审视 Agent 架构的因果可信度
BACKTRACE 与 BACKROOMBench 所揭示的“推理后台”,本质上是当代语言智能体面临的深层次AI 出处危机(AI Provenance Problem)。这一发现对当前大红大紫的智能体系统工程设计提出了数项严肃的反思与约束。
将外部知识库、专业 SOP 以及 API 文档封装为“可复用技能”,并依赖智能体自主检索调用的架构,目前其底层运转的鲁棒性远低于学界与业界的普遍预期。模型声称自己遵循了某些行业安全规范或专业排错规程,往往只是一种迎合提示词诱导的文本伪装;而在没有声明的隐秘角落,不可控的程序碎片可能正在暗中左右着系统的边缘决策。
对于关键业务场景——尤其是涉及医疗会诊、金融合规审查、网络自动化渗透等要求极高可追溯性与可解释性的领域——任何依赖智能体“自述理由”或单次“思考链证据”的合规审计,都不具备严格的因果效力。
这项研究表明,未来的智能体评测体系必须经历一次范式转移:从单纯关注“最终表现(Task Success)”与“逻辑看起来是否顺畅(Plausibility)”,全面跨越到基于反事实干预的“因果敏感性(Causal Provenance)”检验。唯有通过对输入上下文的主动扰动,剥除那些浮于表面的表演式推演,开发者才能穿透迷雾重重的推理前台,真正看清智能体在后台究竟是如何做出的决策。