AlayaWorld:30步采样压缩至4步!有界记忆破解长程世界模型漂移魔咒
AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report
构建一个能够实时响应玩家指令、并在无垠空间中自洽演化的虚拟世界,曾是现代计算机图形学与游戏工业最耗费人力与资本的梦想。传统 3D 游戏开发依赖一条精密且笨重的流水线:从美术原画、高精建模、骨骼动画,到物理引擎模拟与逻辑脚本编写,任何微小的交互改动都意味着巨大的工程成本。近年来,生成式视频模型的崛起为打破这一范式带来了全新曙光。然而,如果仅仅把视频生成模型当成世界模型来用,很快就会撞上物理规则与长程记忆的双重死墙。
ArXiv URL:https://arxiv.org/abs/2607.18367v1
要让神经网络真正具备“模拟世界”的特质,必须在一个闭环内同时攻关四大相互拉扯的属性:交互性(精准响应镜头轨迹与意图变动)、时空一致性(在绕圈重访时环境纹理与几何不发生塌缩)、长程稳定性(自回归展开数十秒甚至更久而不陷入模糊与漂移),以及效率(具备足够低的推理时延以支撑交互)。以往的探索往往按倒葫芦浮起瓢:为了长程一致性不断增加历史帧,推理开销随时间爆炸;激进地压缩采样步数,又常常导致空间几何彻底失真。
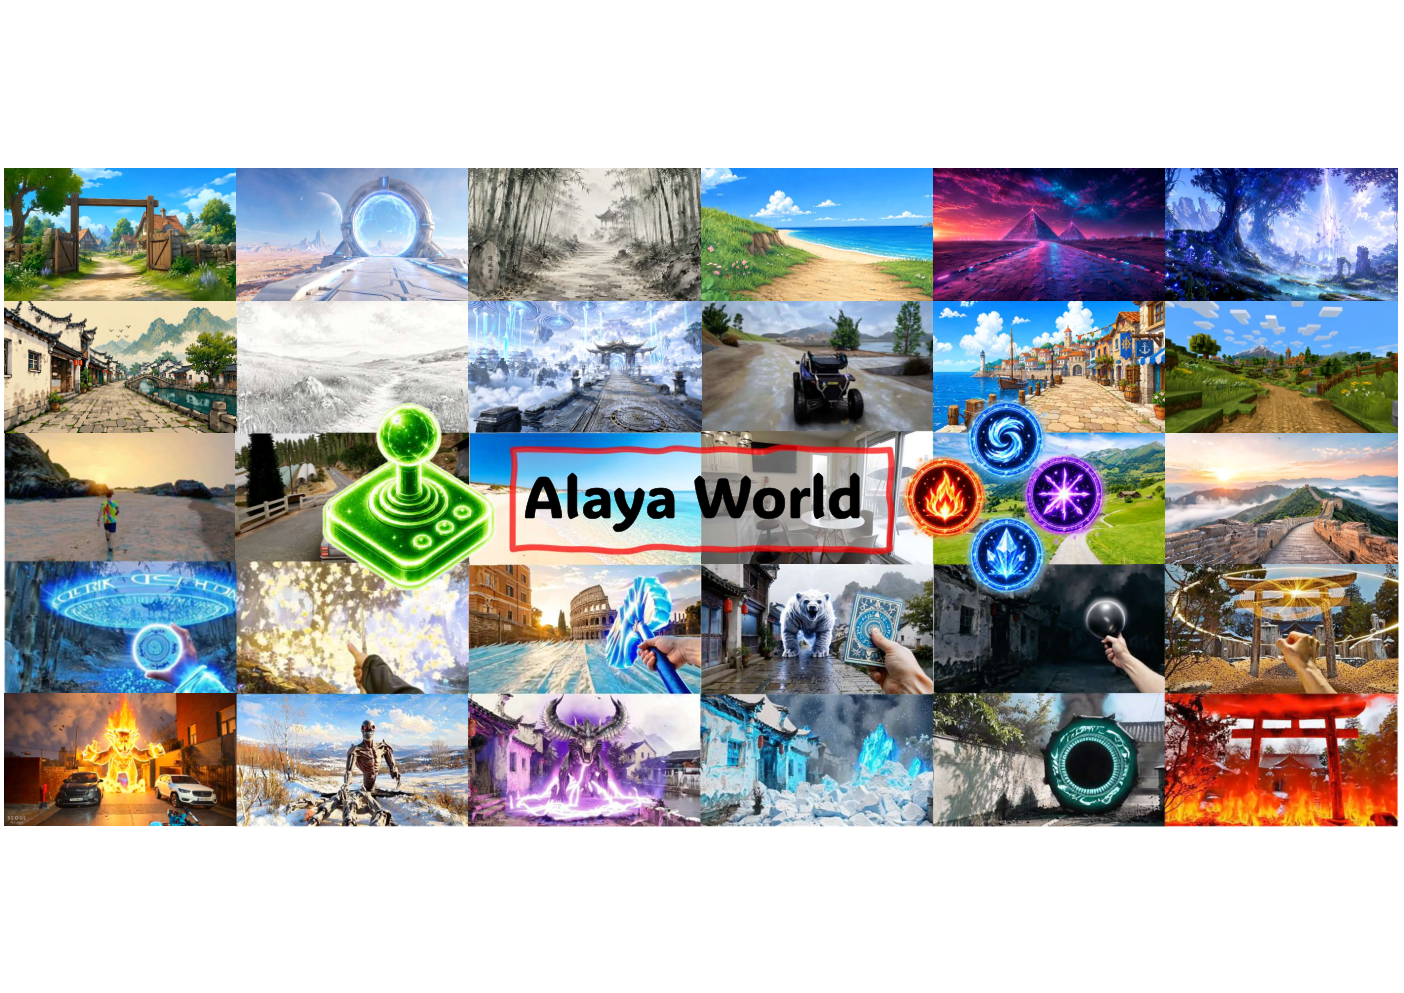
针对这一核心矛盾,Alaya Lab 提出了全栈开源的交互式长程视频世界模型 AlayaWorld。该模型基于约 15B 参数的视频扩散 Transformer(DiT)骨干,能够在 540p 和 720p 分辨率下持续输出 24 fps 的稳定视频。它的关键突破在于重构了长程生成的动力学结构:通过巧妙的有界视觉上下文机制,把几何重投影融入空间记忆,使单块生成的算力消耗在无限长的时间轴上保持恒定;同时,模型借助从自身展开中捕获的预测残差进行“抗漂移”抗毒训练,并引入无需雅可比向量积(JVP)计算的离散自回归蒸馏技术,成功将每块生成所需的扩散采样步数从 30 步骤降至 4 步。在标准基准 iWorld-Bench 上,AlayaWorld 在生成质量、轨迹跟踪与记忆能力三个维度均取得了领先表现。
有界视觉上下文:用恒定算力锁定无限世界
视频自回归生成的常见做法,是直接将前若干帧作为上下文条件喂给扩散模型。但这一策略在开放交互场景中存在天然硬伤:如果保留的历史窗口过短,视角一旦移开再转回,原本的物体就会发生“幻觉性重绘”;如果无限扩大历史窗口,自注意力的二次方复杂度会让推理显存和延迟迅速失控。
AlayaWorld 破解这一困局的核心是有界视觉上下文(Bounded Visual Context)。在潜在空间中,模型以 $K=4$ 个潜帧作为一个生成块(chunk),逐块向未来自回归演进。对于第 $i$ 个块,模型所依赖的前缀上下文被严格约束在一个紧凑的复合结构内:
\[S_{i}=\big[\;s\;;\;h_{i}\;;\;g_{i}\;;\;n_{i}\;;\;z_{i}^{\tau}\;\big]\]这个上下文向量由五个各司其职的模块拼装而成:
-
全局汇聚帧(Sink Frame, $s$):作为全局场景的语义与光照锚点,在整个交互探索周期中被恒定固定,防止长程展开后整体色调和场景基底发生漂移。
-
压缩时序记忆(Temporal Memory, $h_i$):基于最近的 6 个潜帧计算得到,专职维护局部动态和逐帧的运动平滑度。
-
几何对齐空间记忆(Spatial Memory, $g_i$):这是解决“回头看(Loop Closure)”一致性的关键。系统维护一个由历史观察帧构建的全局空间缓存 $\mathcal{B}$。当用户操纵相机重返已访问区域时,系统利用单目深度估计与几何位姿,将历史像素通过坐标变换矩阵 $u’ = \pi_i(\pi_j^{-1}(u, D_j(u)))$ 重投影到当前目标视角下,渲染出至多 10 帧对齐参考帧,作为 $g_i$ 注入注意力机制。
-
邻近参考帧(Nearby Frame, $n_i$):提供类似图生视频的高频细节过渡,确保块与块拼接处的零接缝。
-
带噪目标潜帧($z_i^\tau$):当前等待去噪生成的潜在块。
这种设计的精妙之处在于“解耦与定容”。时序记忆负责高频连贯性,几何空间记忆负责低频持久性,而历史缓存的增删与重投影在主干网络之外以轻量级的几何管线运行。无论用户在一个场景中漫游探索了 10 秒还是 10 分钟,网络骨干每次前向传播所处理的 Token 总量是恒定锁死的。这使得 AlayaWorld 在计算复杂度上摆脱了时间维度的束缚,真正具备了理论上无限长程运行的工程可行性。
从混乱中提炼秩序:多源数据与双层动作解耦
世界模型绝不可能仅凭自然风光视频就学会响应控制信号。真实世界拍摄的视频虽然质感逼真、光影复杂,但极度缺乏精准的动作与位姿真值;而合成渲染数据(如游戏录屏)虽自带完备的几何轨迹,却往往缺乏现实画面的颗粒度与随机性。
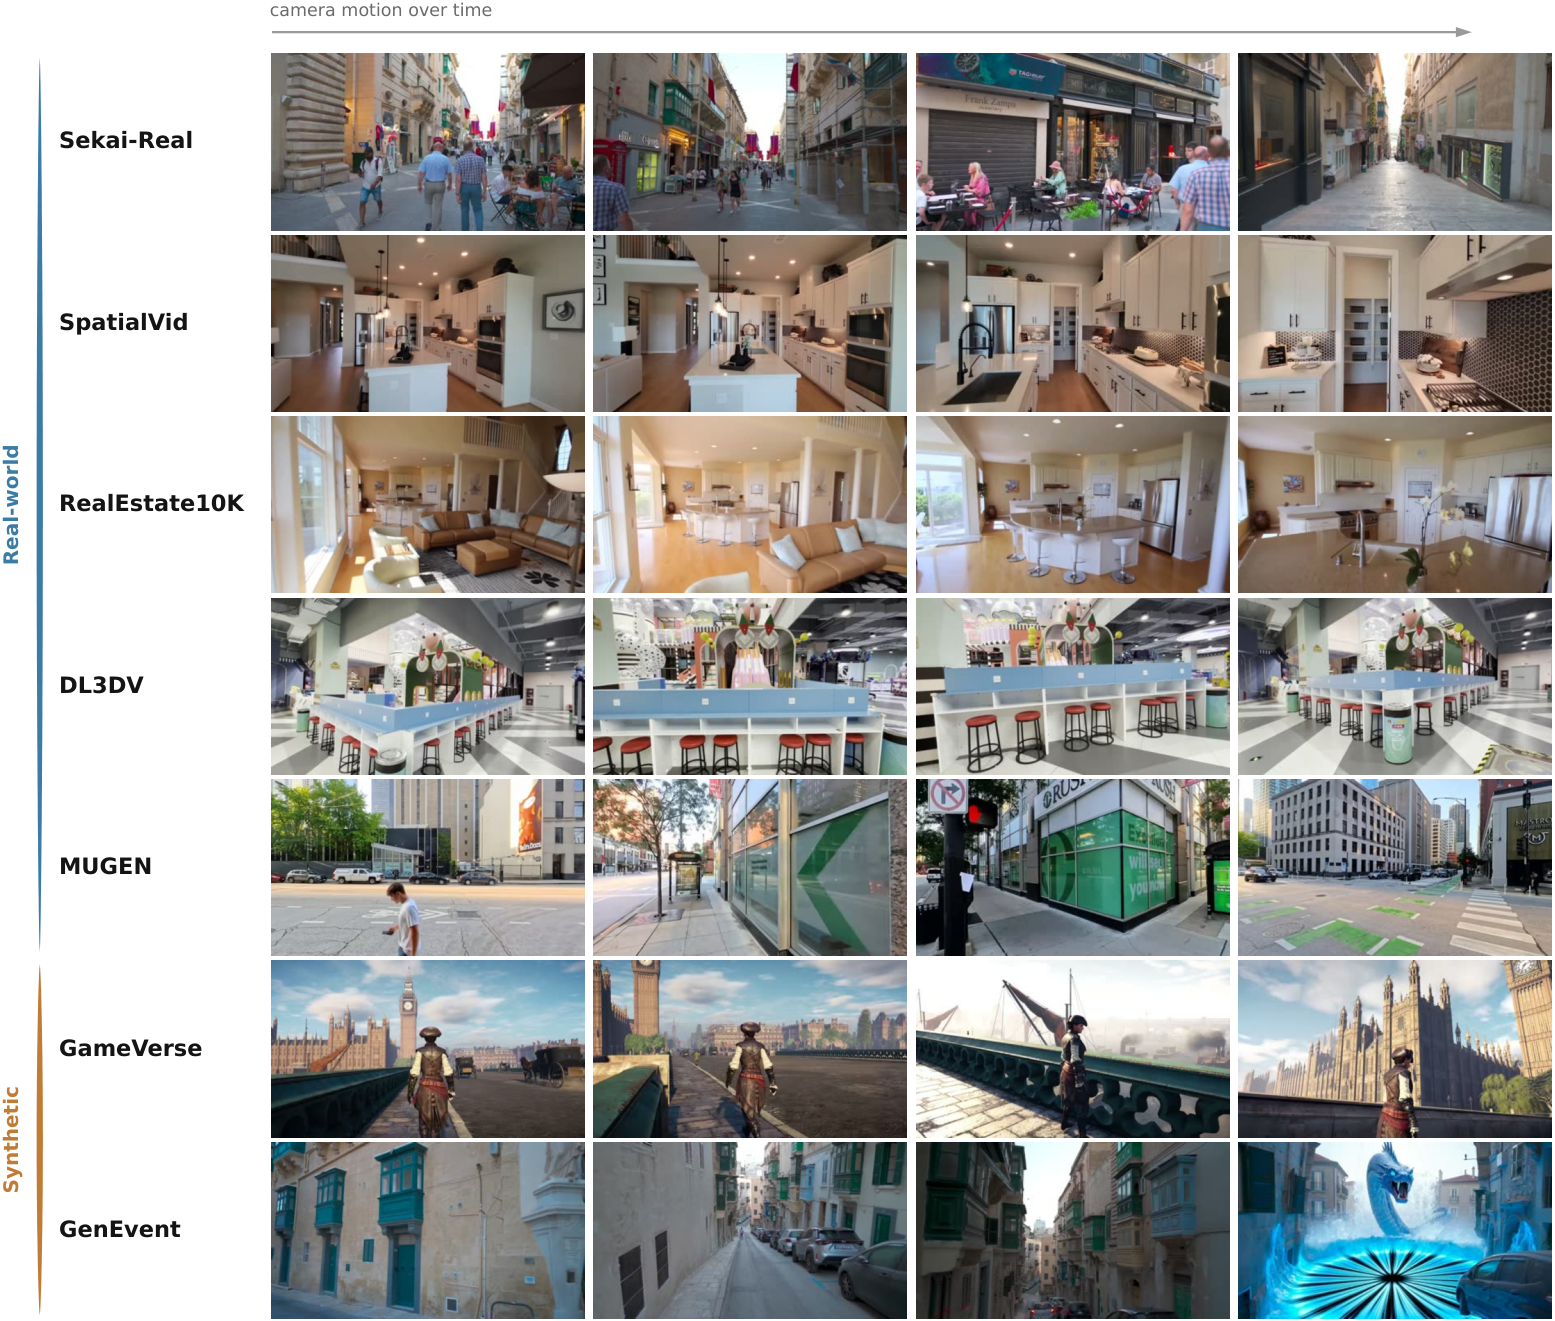
为了让模型同时习得逼真的自然演化与敏捷的轨迹操控,研发团队构建了一套横跨现实采集与合成渲染的混合语料库。数据集融合了 Sekai-Real、RealEstate10K、DL3DV 等真实室内外漫游轨迹,辅以团队内部构建的 MUGEN 视频库;在合成侧,则引入了高达 12.4 万段、平均长度 66 秒的 3A 游戏实机录屏 GameVerse,以及 6490 段由生成模型专门合成的开放事件片段 GenEvent(涵盖战斗、法术施放等长尾动作)。
在清洗这批庞杂数据时,流水线采用了一种高效的单次解码设计(Single-Decode Design):每一段视频仅经过一次硬件解码与光流估计,计算出的亮度分布、边缘黑边比、时间方差与运动方向方差等统计特征被统一缓存在共享清单中。后续的光学过滤、基于 OmniShotCut 的单镜头切割、EasyOCR 驱动的文字与游戏 HUD 消除,以及利用 YOLO11 约束前景人物遮挡率的各级门控,全部直接读取缓存分值进行毫秒级判定。
更关键的革新在于标注体系。传统的整段自然语言描述对交互式模型而言几乎不可用,因为一段视频中往往交织着摄像机的移动与前景物体的自主运动,文本若混为一谈,模型就无法学会“视角推近”与“主角向前走”的物理差异。为此,AlayaWorld 引入了细粒度的双层标注架构:
-
全局视频上下文:提炼天气、时段、场景类型、视角与画风等 26 种离散键值,作为全局状态平衡与调节的 Token。
-
时间段切片多轨标注:在每个带时间戳的子片段内,强制将语义拆分为主体运动、环境动态、静态场景特征和摄像机视角轨迹四条独立音轨。在训练阶段,模型将轨迹控制器与文本中的摄像机描述进行随机解耦抛弃,迫使网络学会仅依赖专用的连续位姿参数来执行视点平移,而将文本输入专门留给突发性动作(如打怪、施法)等高阶语义触发。
三阶段演进与“抗毒”自修复训练
从通用视频生成基座蜕变为能够抵抗长程误差累积的交互模型,AlayaWorld 经历了一套严密的三阶段训练范式。
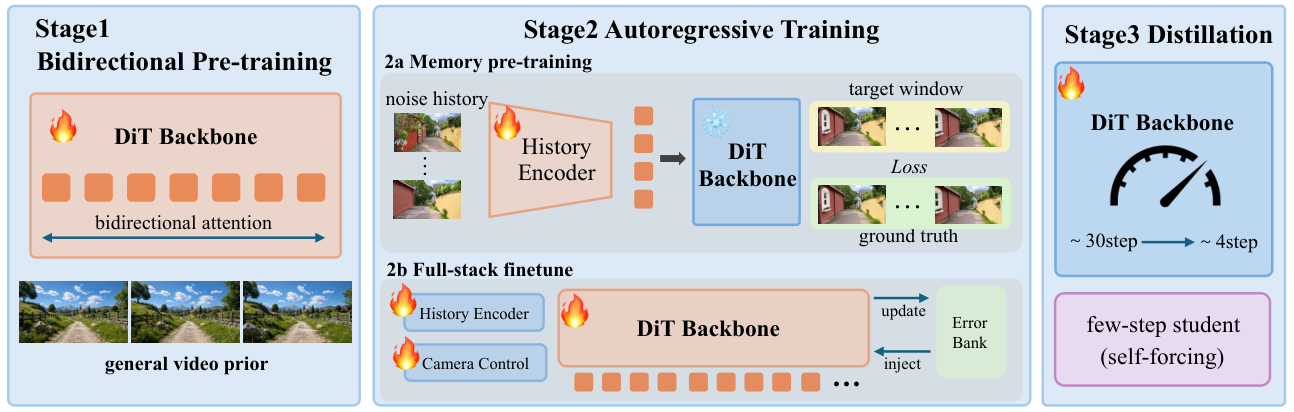
第一阶段:双向预训练(Bidirectional Prior Adaptation)。模型选用剪裁后的 13B–15B 规模 LTX-2.3 DiT 作为基础底座。在此阶段,模型依然保持全双向自注意力机制,不引入因果掩码和复杂记忆模块。核心目标是通过全参数微调,让骨干网络吞吐混合域数据的物理与光影先验,同时采用随视频时长自适应伸缩的流匹配调度策略(Adaptive Sigma-Shift),确保去噪预算合理分配在长短不一的片段上。
第二阶段:自回归时空记忆整合(Autoregressive Control & Memory Integration)。这一阶段将模型由双向生成转换为因果推进结构。为了彻底解决长程自回归中必然出现的“复合误差漂移”——即前一步微小的边缘畸变或模糊在后续几步中被不断放大、最终演变成整幅画面的崩塌,团队设计了别具一格的残差注入回放机制(Helios Drift 与 Error Bank)。
训练不再单纯给网络提供绝对纯净的真实历史切片,而是故意在上下文历史中混入网络先前自主展开时捕获的预测残差和加噪扰动。这种“投毒式”自修复训练迫使模型跳出对完美前缀的依赖,学会从包含伪影和几何失真的历史上下文中主动矫正误差。在训练初期,模型先以固定概率注入模拟扰动;待误差银行(Error Bank)被模型实际推演的失真切片填满后,残差重放机制接管主导,模型在逼真的自生成失败边缘反复学习自我修正。
第三阶段:离散自回归蒸馏(Inference Acceleration)。完成记忆与控制训练的模型虽然生成能力过硬,但每个块需要运行约 30 步扩散采样,难以支持实时的交互响应。对此,团队提出了一套面向离散时间步的自回归蒸馏策略。
以往像 Causal-rCM 这类联合蒸馏方法大多建立在连续时间流匹配的基础上,在反向传播时需要计算计算量极其恐怖的雅可比向量积(JVP),在 15B 级别的庞大 DiT 上极易引发显存枯竭与数值震荡。AlayaWorld 转向离散时间步架构,巧妙地将分布匹配蒸馏(DMD)、自强制微调(Self-Forcing++)与一致性蒸馏(Consistency Distillation)熔铸在同一优化目标中:
\[\nabla_{\theta} D_{\mathrm{KL}}\!\left(p_{\theta,\tau}\,\|\,p_{\mathrm{data},\tau}\right) = -\,\mathbb{E}\Big[\big(s_{\mathrm{real}}(\hat{z}_{i}^{\tau},\tau\mid c_{i})-s_{\mathrm{fake}}(\hat{z}_{i}^{\tau},\tau\mid c_{i})\big)\,\tfrac{\partial\hat{z}_{i}}{\partial\theta}\Big]\]结合一致性映射损失 $\mathcal{L}_{\mathrm{cm}}$,学生模型在自回归展开的历史中同步拟合教师模型的真实轨迹分布与一致性跳转。经过该阶段提炼,模型最终在保留完整几何记忆、轨迹响应度与 24 fps 流畅画质的前提下,将每个块的采样运算彻底压缩到了 4 步。
交互漫游、视角闭环与长程稳定性验证
在学术界标准世界模型基准 iWorld-Bench 的严格评测中,AlayaWorld 展现出了出色的综合素质。评测涵盖生成质量(Generation Quality)、轨迹遵循度(Trajectory Following)与记忆能力(Memory Ability)三大主轴。
在衡量交互精度的轨迹遵循度评测中,AlayaWorld 在运动平滑度与轨迹绝对精度上双双斩获最高分;而在检验场景持久性的记忆能力评测(尤其是闭环重访一致性)中,几何对齐空间记忆展现出决定性优势,其结构相似度与特征保持率显著拉开与其他开源世界模型(如 Cosmos、HunyuanVideo-1.5、Matrix-Game 2.0 等)的差距。
定性生成的实际表现进一步印证了数据背后的技术优势。在多项典型交互探索测试中,AlayaWorld 展现出四项坚实的能力:
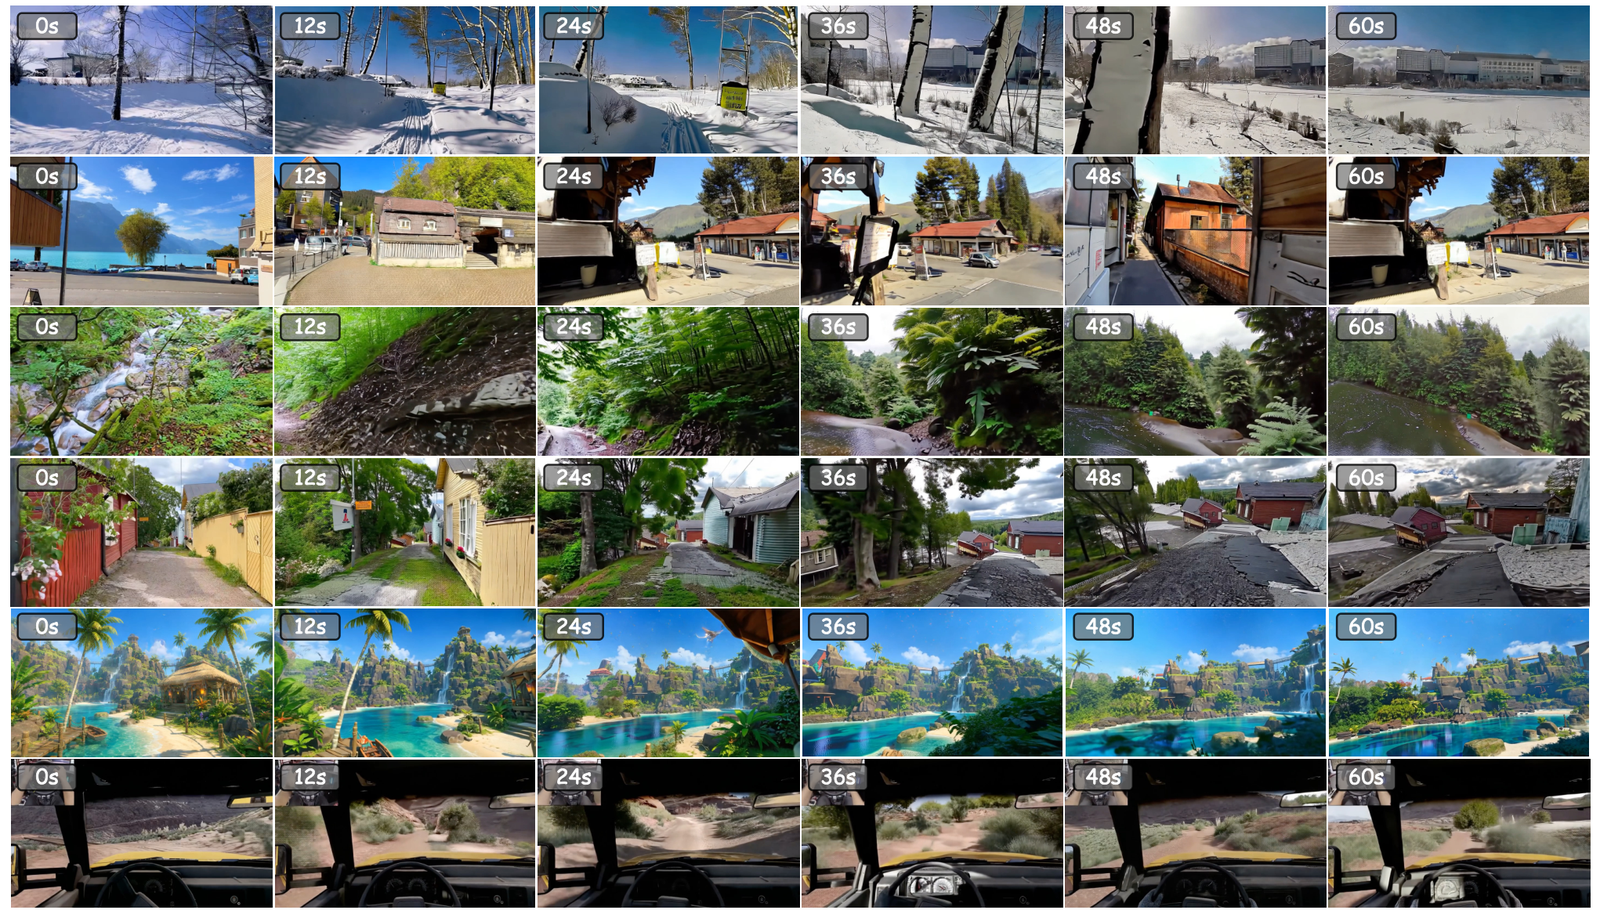
首先是长程自回归展开的惊人稳定性。如图 8 所示,在极长时间跨度的连续交互生成中,画面没有出现常见的对比度暴走、色彩单调化或背景渐进性模糊。汇聚帧(Sink Frame)与抗漂移残差机制共同拉住了场景的基底分布,使漫游数分钟后的场景依然如同初始片段一样清澈锐利。
而在空间一致性与闭环重访测试中,当操作虚拟相机在室内复杂障碍或城市街区完成 360 度环绕或折返漫游时,先前离开视场的沙发雕花、货架排列和路标文字,在视角重新切回的瞬间均能精确重现,没有发生任何生成式模型常见的“空间失忆”。
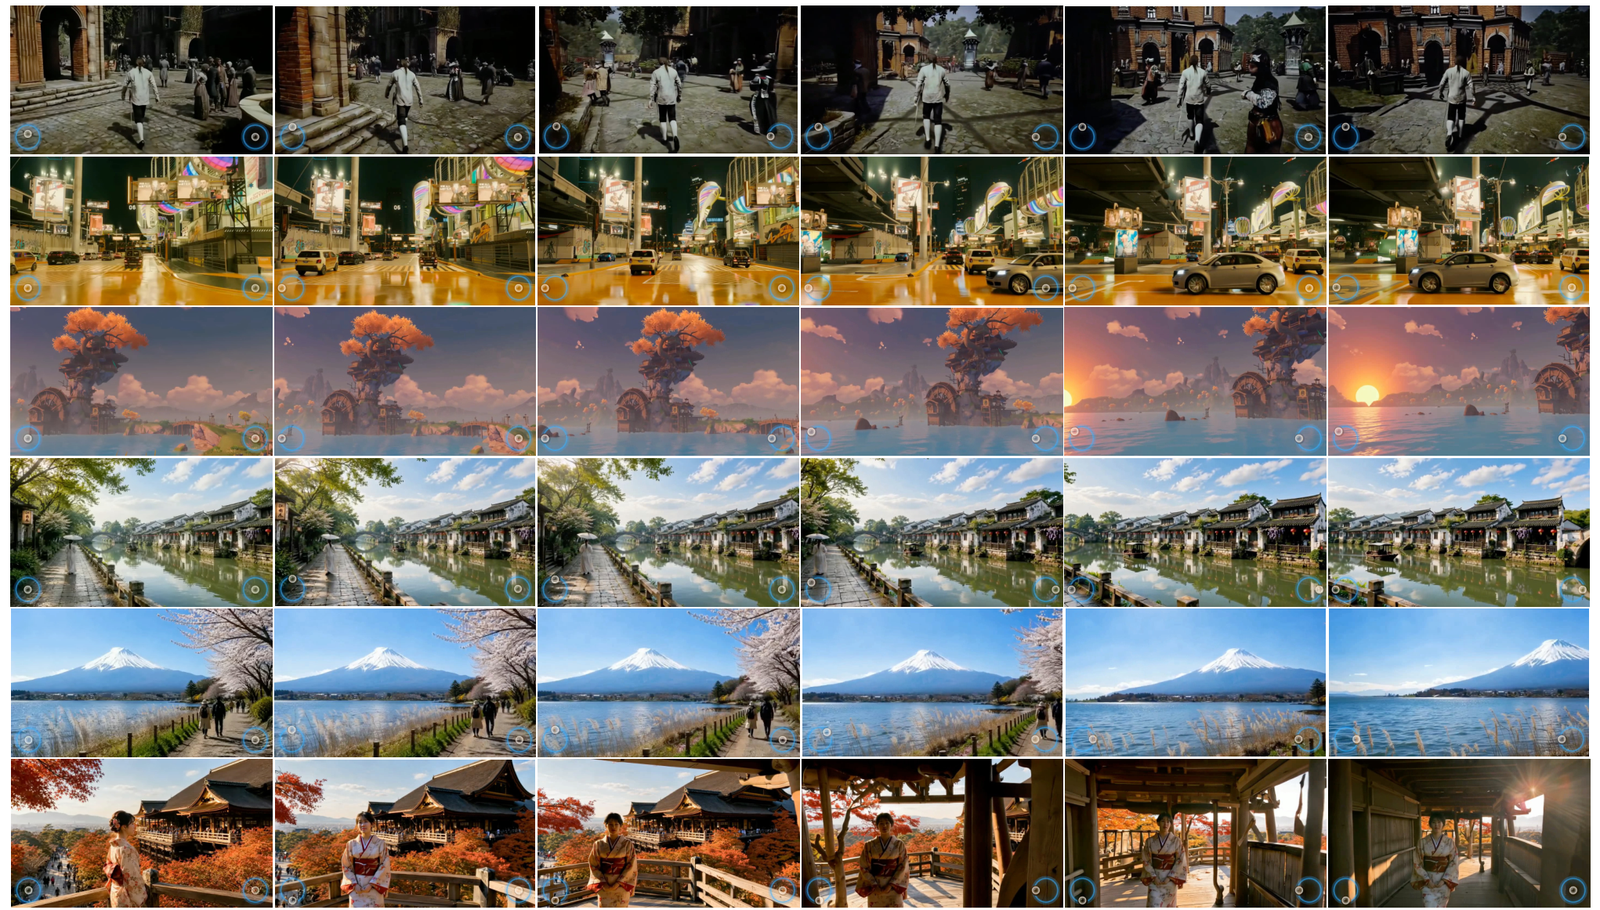
在动作与指令响应层面,连续的六自由度相机外参被平滑转化为潜空间的运动场变换(图 4);与此同时,当在生成块的边界动态切换文本提示时,模型能够即时根据“释放魔法阵”或“进入战斗态”的指令演进出合乎透视与光照的粒子效果,而不会打乱背景已有的三维几何结构。
结语与冷思考:走向具身智能与生成式现实的基石
AlayaWorld 的诞生,为原本处于各自为战状态的交互视频研究树立了一个高度集成的系统范本。它表明,打造一个真正可玩的长程世界模型,单靠堆砌参数量或扩大训练算力是远远不够的,必须在底层架构上彻底解构交互响应、空间记忆、误差累积与推理时延之间的张力。
然而,我们同样需要保持冷静的技术审视。正如作者在报告中所坦承,AlayaWorld 目前对世界的构建本质上依然是一种“基于密集视觉观测、深度估计与几何重投影的外观模拟”。模型对物体的状态演化(例如杯子打碎后的碎片物理分布)、因果推理链条以及长程任务逻辑的理解,依然锚定在“可见表象”的层面,而非真正内生了一个拥有严密物理学规律与状态转移图谱的底层引擎。
即便如此,AlayaWorld 将推理压缩至 4 步、在潜空间实现几何对齐有界记忆并全栈开源的举措,无疑为生成式现实(Generative Reality)、虚实共生游戏以及具身智能(Embodied AI)模拟仿真平台的演进,提供了一块兼具高性能与高可扩展性的核心基石。