Act2Intention:从70万次手机操作预判意图,理解准确率提升32分
Act2Intention: A Benchmark For Developing Active Mobile Agents Through Inferring User Intention from GUI Actions
在人机交互与移动智能体领域,主流的图形用户界面智能体(GUI Agent)绝大多数扮演着“被动响应者”的角色。无论是处理订外卖、打车还是预订机票,智能体通常只能静静等待用户输入明确的自然语言指令,随后按部就班地解析界面、规划步骤并执行点击。然而在真实的移动设备使用场景中,人类用户很少愿意反复向手机下达繁琐清晰的口令。真正的智能助理,不应该局限于“听令行事”,而应该具备洞察连续行为并主动预判潜在需求的能力。
ArXiv URL:https://arxiv.org/abs/2608.14132v1
西北工业大学与清华大学的研究团队提出了 Act2Intention 框架,首次系统性地构建了覆盖“意图理解(Understanding)$\rightarrow$ 意图预测(Prediction)$\rightarrow$ 经验执行(Execution)”全链路的主动式移动智能体体系。针对现有公开数据集仅包含离散单任务轨迹、缺乏连续人机交互流的缺陷,研究者构建了首个支持连续意图建模的大规模基准数据集 Act2Intention Bench,涵盖 360 种用户画像(Personas)、72,511 条高层意图以及超过 700,000 步低层 GUI 原子操作,横跨 52 款主流移动应用。
这项研究最显著的突破在于证明了利用底层操作反推上层意图的可行性:在经过 Act2Intention Bench 的监督微调(SFT)后,模型在未见过的真实操作流中,意图理解准确率绝对提升了 32.0 个百分点(Acc-S),未来意图预测准确率提升了 10.25 个百分点,而在下游引导执行任务中也取得了 6.9 个百分点的任务成功率(SSR)增益。这不仅打破了“GUI Agent 只能做执行器”的技术藩篱,也为下一代嵌入操作系统的原生主动智能体提供了关键范式与数据支撑。
从被动响应到主动预见:交互范式的根本转变
当前多模态大语言模型驱动的移动智能体(如 AutoGLM、CogAgent 等)主要聚焦于“指令到动作”的映射,即在给定高层命令的前提下,观察当前屏幕截图与控件树,预测下一步点击或滑动的坐标。这种模式在学术界被称为“反应式行动者”(Reactive Actor)。这类系统的核心假设是:用户始终清楚自己想要什么,并能主动发起清晰的交互。
但在日常手机使用中,用户的行为往往是碎片化、连续且充满隐式动机的。用户可能先在地图软件里搜索了一家餐厅,随后切换到打车软件,紧接着又打开了即时通讯工具。这一连串无声的屏幕滑动与点击背后,隐藏着高度连贯的生活意图序列。如果智能体仅仅在打车软件打开后等待指令,就错失了主动提供服务的最佳契机。
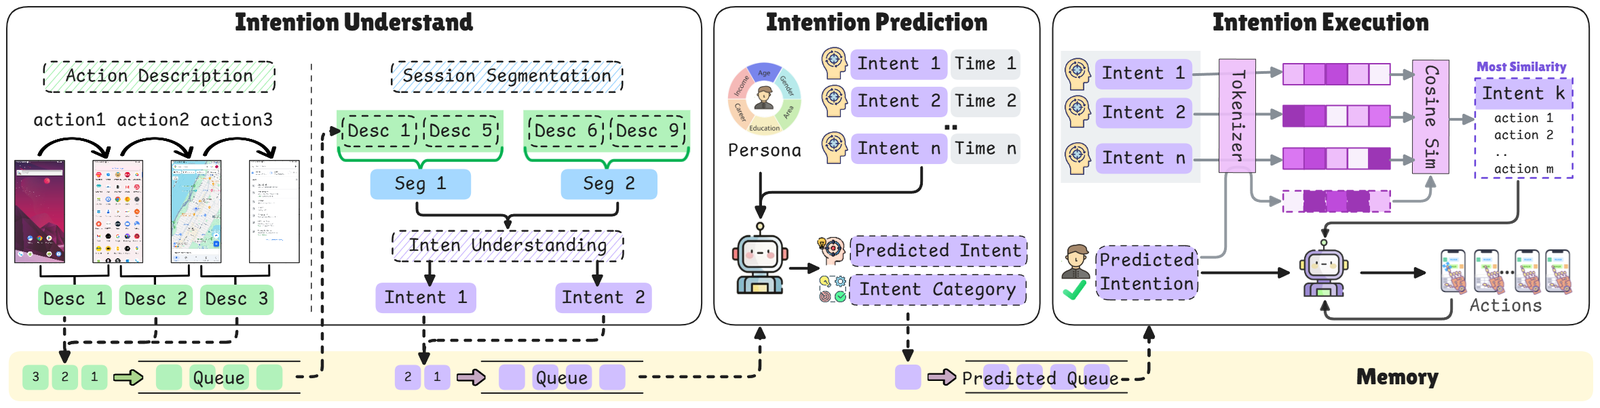
主动式移动智能体需要解决的核心难题是连续移动端 GUI 意图建模(Continuous Mobile GUI Intention Modeling)。具体而言,智能体必须实时捕获底层的原子动作流,精准识别出一段操作的起止边界,将其归纳为具体的高层意图描述,再结合当前时间、环境情境以及长期积累的用户画像,主动预判用户接下来的下一步行动,并在获得用户轻量确认后自动调用类似的历史经验完成执行。
为了确立这一全新的交互范式,研究团队将主动服务的全生命周期严谨地形式化为三个紧密耦合的子任务:
第一,面向主动服务的意图理解(Proactive-oriented Intention Understanding)。智能体需要从连续的动作序列 $\tau_{1:m}$ 中解析出隐含的高层意图序列 $I_{1:m}$。该任务本质上包含操作流的“会话分割”(Session Segmentation)与“语义意图描述”(Semantic Intention Description)。其数学表达为:
\[I_{1:m} = f_{\phi}(\tau_{1:m}^{des}) = f_{\phi}(\{d_{p_{i}}, d_{p_{i}+1}, \dots, d_{q_{i}}\}_{i=1}^{m})\]其中 $[p_i, q_i]$ 代表第 $i$ 个意图在原始动作流中的起始与结束索引,而 $d_t$ 代表动作级别的自然语言描述。
第二,个性化主动意图预测(Personalized Proactive Intention Prediction)。智能体依托历史上推断出的连续意图序列 $I_{1:t}$、当前时间戳 $T$ 以及从长期行为中沉淀的用户行为画像 $P$,在后台静默推测用户在下一时刻潜在的意图目标 $\hat{I}_{t+1}$:
\[\hat{I}_{t+1} = f_{\theta}(I_{1:t}, T, P)\]第三,经验引导的意图执行(Experience-guided Intention Execution)。当预测的建议在设备唤醒时得到用户确认后,智能体不再盲目从零规划,而是检索出用户过往执行同类意图的高质量历史轨迹 $\tau^*$ 作为少样本操作先验(In-context Demonstration),结合当前屏幕观测 $o_t$ 与即时历史 $h_{t-1}$,迭代完成动作执行:
\[a_{t+1} = f_{\pi}(I, h_{t-1}, o_t, \tau^*)\]这一设计彻底将智能体从单点式的“命令接收端”改造成了嵌入用户行为流的“认知中枢”。
Act2Intention Bench:首个多意图连续交互基准
以往的经典移动端 GUI 数据集(例如 Google 的 Android in the Wild、Android Control、AMEX 或 GUI Odyssey)普遍存在两大短板:一是任务指令彼此割裂,各条轨迹是孤立、人为预设的短指令执行过程,无法反映多应用联动的真实行为流;二是缺乏与用户意图高度绑定的情境上下文(如精确时间段、设备状态变迁及个性化特征)。
为填补这一空白,Act2Intention Bench 采取了“真实数据筑基、多智能体协同仿真扩充、双重模型严格过滤”的构建策略。整个基准的数据来源与结构划分展现了极高的工程严谨性。
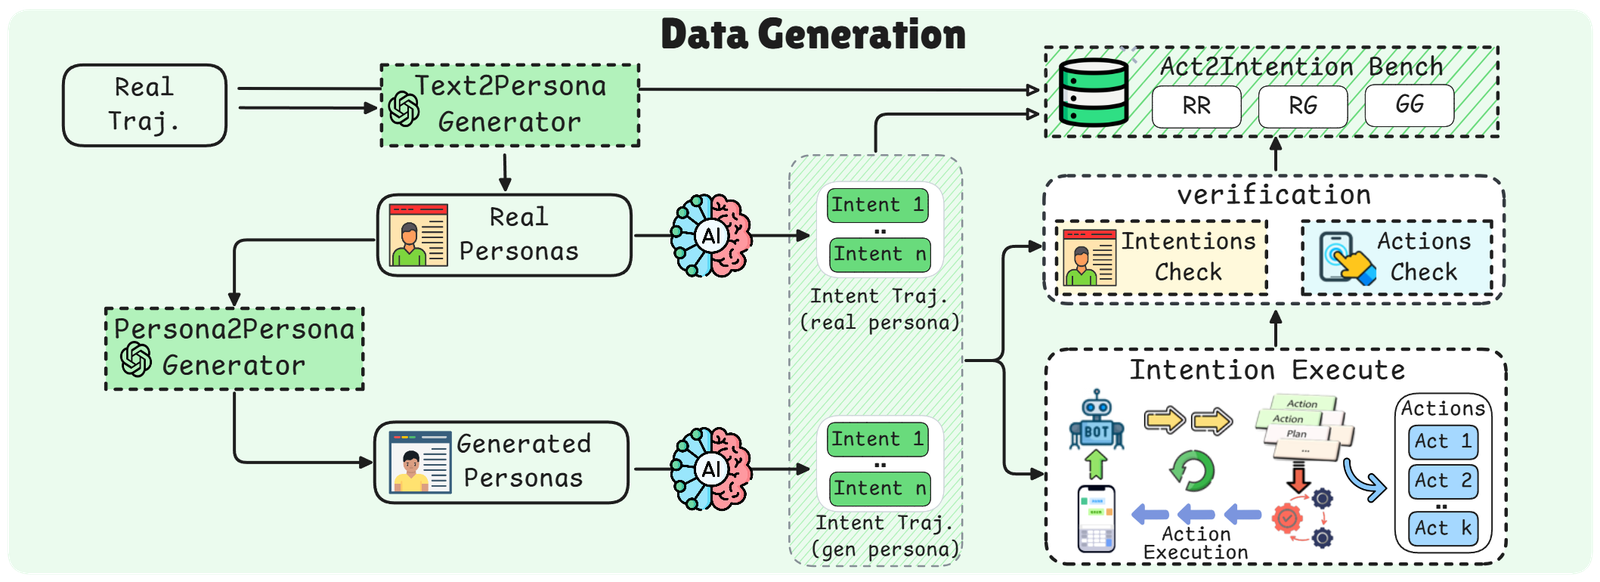
数据源头来自于国内主流智能手机厂商征得 90 位匿名志愿者授权后的真实交互日志。这些脱敏日志记录了 2024 年春季跨越两个月的真实行为,包含完整的屏幕截图、点击位置及控件元数据。基于这些第一手真实数据,研究团队划分了三个兼顾真实性与泛化多样性的子集:
-
Act2Intention-RR(真实画像-真实轨迹):直接整理真实用户的连续交互会话,并由大模型基于用户的历史交互流提取出对应的行为画像,完全保留最原汁原味的人类操作分布。
-
Act2Intention-RG(真实画像-生成轨迹):保留从真实用户提取出的行为画像,利用大模型推演该画像在不同时间与场景下合理产生的意图链条,并驱动自动化执行器生成对应的操作动作流。
-
Act2Intention-GG(生成画像-生成轨迹):通过“Persona-to-Persona”技术进一步外推合成出 100 个全新的人格画像,由此派生更为广泛的意图与跨应用交互轨迹,极大扩展了基准的长尾覆盖面。
为了保证仿真轨迹的可靠性,研究团队部署了多路 Android 模拟器矩阵,并采用当时顶尖的开源移动交互模型 UI-TARS-1.5-7B 作为底层执行器(Actuator)。但在大规模自动化生成过程中,幻觉意图与动作执行失败是不可避免的噪点。为此,该研究设计了一套基于 DeepSeek-R1 的双重质量校验机制。
在第一道意图过滤网中,验证模型根据生成的意图流反推用户画像,并与原始设定的画像向量计算余弦语义相似度,强制剔除相似度低于 0.7 的不一致意图,确保“人设不崩塌”;在第二道动作过滤网中,验证模型根据意图目标、每一步动作元信息以及最终的屏幕截图,从完整性(是否覆盖子目标)、正确性(动作是否偏航)和终态合理性(截图是否呈现成功状态)三个维度进行严格裁决。
统计显示,高达 92.63% 的生成意图通过了画像一致性筛查,87.03% 的动作轨迹通过了执行终态验证。最终入库的 Act2Intention Bench 汇聚了 360 个精细画像、72,511 条高层意图以及超过 70 万步动作,覆盖了 52 款真实 App。
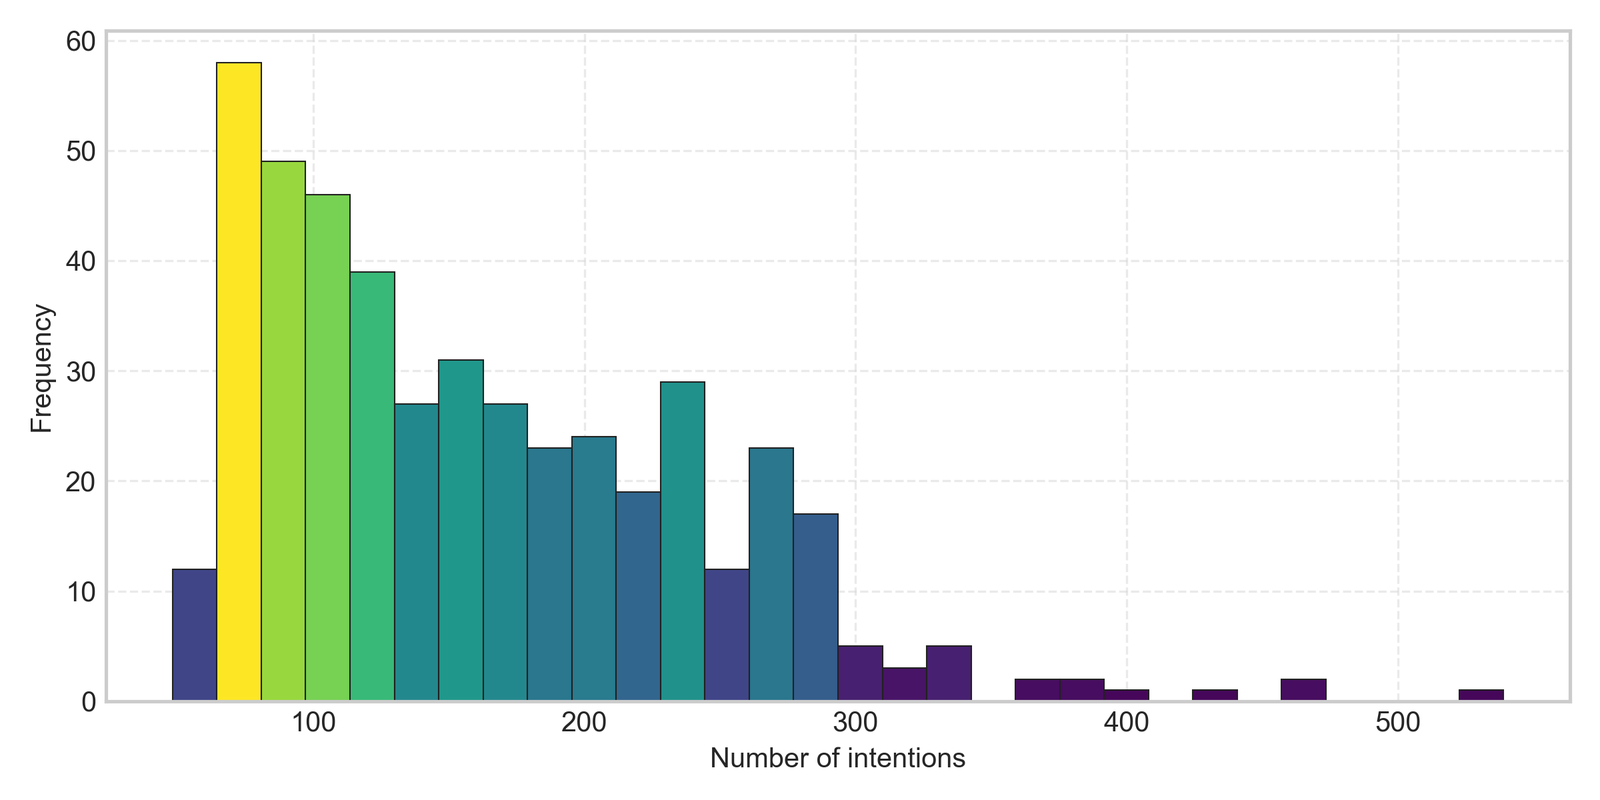
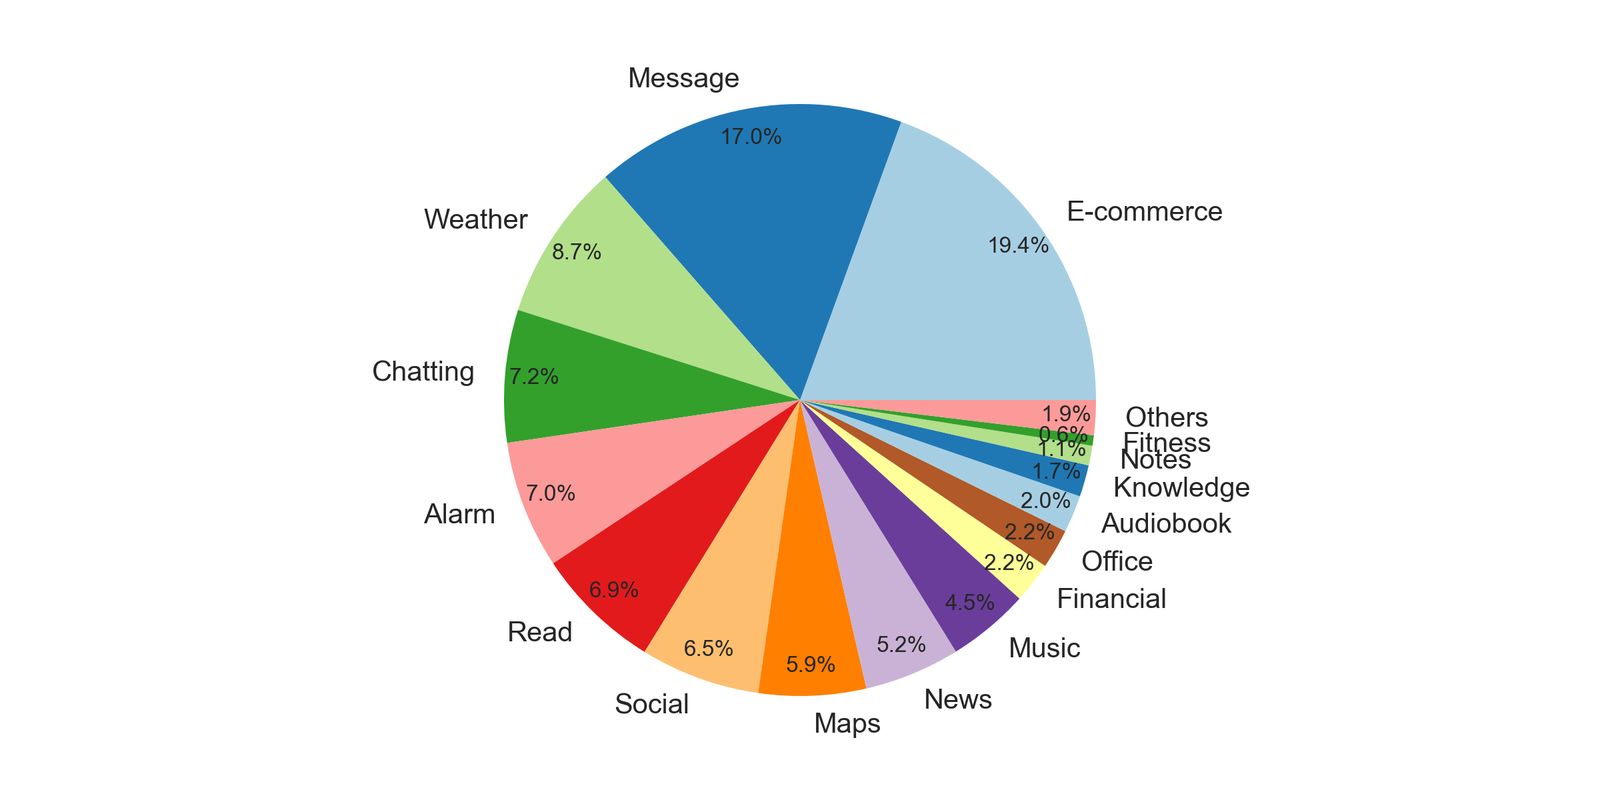
从分布特征来看,Act2Intention Bench 涵盖了约 120 种细粒度意图类型,广泛覆盖即时通信、电商购物、生活服务、影音娱乐与生产力工具等核心领域。意图序列的长度呈现出平滑的长尾分布,充分还原了人类既有单步快速查询、也有复杂跨 App 组合操作的真实行为习惯。
认知架构分解:将原子点击层层升维
让一个大语言模型直接阅读长达数十步的屏幕截图与原生坐标序列,并从中归纳意图,在计算成本和长上下文注意力上都是不切实际的。Act2Intention Agent 之所以能够高效运转,核心在于其精心构建的三级认知抽象流水线。
在第一层,动作语义化转译(Action Description)。智能体并不直接向中心推理模型灌入成百上千张原始截图,而是借助专用的轻量级视觉语言模型(VLM),对比动作执行前后的截屏变化(并在操作前截图上高亮标注交互边界框),将每一个原子交互映射为标准化的结构化文本元组:“在某应用/界面下,执行了何种动作,以达成何种直接目的”。这种将异构视觉输入归一化为稠密语义文本的做法,既压缩了上下文体积,又过滤了大量与意图无关的视觉底噪。
在第二层,联合会话分割与意图抽象(Session Segmentation & Understanding)。用户的连续使用往往包含多个意图的交替切换。智能体通过微调后的语言模型,在一个推理链条中同时完成两件事:切分操作流的时间边界,并生成高层意图描述。例如,面对“打开外卖应用 $\rightarrow$ 搜索无糖咖啡 $\rightarrow$ 加入购物车 $\rightarrow$ 返回主屏幕 $\rightarrow$ 打开音乐软件 $\rightarrow$ 播放每日推荐”这一动作描述流,模型不仅能精准输出前四步属于意图一(点咖啡),后两步属于意图二(听音乐),还能将其归纳为标准语义格式存入用户记忆模块(Memory)。
在第三层,时空条件化的个性化预判与召回执行。预测阶段被设计为后台静默运行机制(如在息屏空闲时运行)。模型结合时间上下文(如周五晚八点)、历史意图时序以及用户画像中的消费偏好,预判下一时刻的合理需求。当用户点亮手机时,建议以最低打扰度的悬浮提示呈现。一旦用户确认,智能体的记忆检索模块将迅速以当前意图为查询向量,在个人历史向量库中召回最高相似度且已成功执行过的历史轨迹 $\tau^*$。此时,底层执行模型无需从零摸索界面的层级跳转,而是以这段经验作为 Demonstrations 展开少样本上下文学习(In-context Learning),极大地规避了由于界面改版或复杂分支导致的动作规划迷航。
实验评测:监督微调释放的认知飞跃
为了检验 Act2Intention Bench 对模型能力的提升幅度,研究团队选取了多款主流开源基础大模型进行严格的端到端评测,涵盖 Qwen2.5-7B、Llama3.1-8B、DeepSeek-7B 以及 Mistral-7B。评测集严格来源于未参与训练的真实用户数据(Act2Intention-RR),并精细划分为同分布测试集(ID)与用于检验跨用户泛化能力的分布外测试集(OOD)。
评测的量化结果展现了监督微调在这一任务上的关键价值。在基线状态下,即便是能力出众的开源 7B/8B 基础模型,在零样本或少样本提示下解析连续 GUI 操作时,表现依然非常有限。由于缺乏将底层点击流映射为高层语义意图的认知先验,基础模型在多意图分割点上往往出现严重漂移,甚至无法识别出常见的跨 App 意图切换。
而在经过 Act2Intention Bench 的微调训练后,模型展现出了决定性的能力跃迁:
在意图理解任务中,微调后模型的意图准确率绝对提升高达 +32.0 Acc-S。这表明模型成功学会了如何从离散的单步动作描述中提取长程时序依赖,准确锁定意图转换的临界动作点。
在意图预测任务中,结合了行为画像与时间上下文的模型,其下一意图预测准确率实现了 +10.25 Acc-S 的绝对增益。实验表明,即便是在完全未见过的 OOD 用户身上,模型依然能依据其短期操作显式构建的粗粒度画像,实现高命中率的需求预判。
在最终的意图执行环节,依托历史成功经验轨迹的检索引导,下游 GUI Agent 的任务执行成功率获得了 +6.9 SSR 的净提升。消融实验进一步证实,当剥离检索召回的历史轨迹 $\tau^*$ 时,智能体在面对复杂嵌套界面的容错率明显下跌,证明了“意图-经验”闭环对鲁棒执行的决定性支撑。
迈向操作系统级主动智能体
从技术演进脉络审视,Act2Intention 最大的贡献并不仅仅是一套微调数据集或几个百分点的指标提升,而是为学界和工业界指明了 GUI Agent 进化的必由之路。
过去两年,大模型驱动的终端助手普遍困在“聊天框”里,或者只能被动充当特定语音指令的“宏脚本执行器”。这种形态距离大众对真正“AI OS”的期待仍有本质距离。操作系统级主动智能体的终极愿景,是像一位经验丰富的私人秘书一样默默观察你的工作流,在你不经意间完成前序准备。
Act2Intention 证明了一条切实可行的技术路径:通过将原生截屏操作低成本地升维为语义文本序列,大语言模型完全有能力在边缘端实时跟踪并理解人类的复杂动机。这种“看懂你在做什么、猜到你想做什么、帮你想好怎么做”的闭环,使得主动式手机操作系统的落地不再是科幻设定。
当然,走向真正无感的主动服务仍有若干深水区有待突破。例如,在用户界面的什么具体时机介入提示最为合适(Interruption Timing),才能既提供便利又不引发用户的反感与认知干扰;又如,在全天候动作捕获的严苛设定下,如何在端侧兼顾极低的电池功耗与高度敏感的用户隐私防线。但毋庸置疑的是,Act2Intention Bench 的开源与确立,已经为人机交互从“反应式自动化”迈向“预测式主动认知”奠定了关键的基石。