AMFD:快手等提出摊销矩匹配,单步生成在GenEval反超多步FLUX
Amortized Moment Matching for Visual Generation
在视觉生成领域,直接进行分布匹配(Distribution Matching)一直被视为一种非常优美但极难驾驭的建模范式。早期的矩匹配(Moment Matching)与最大均值差异(MMD)方法,长期受限于有限样本估计误差、高维核函数设计困难以及极为脆弱的优化动态,最终在生成质量上被基于粒子流动的扩散模型(Diffusion Models)、流匹配(Flow Matching)和自回归模型边缘化。后来的研究逐渐意识到,直接匹配分布并非不可行,关键在于匹配发生的空间——一旦将数据投射到具有丰富语义的深层表征空间(如 CLIP、DINO 或 MAE 特征),简单的低阶矩对齐就能迸发出惊人的生成约束力。
ArXiv URL:https://arxiv.org/abs/2607.26860v1
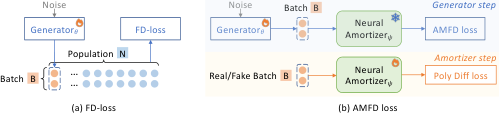
此前引起广泛关注的 FD-loss 便证明了这一点:通过在预训练特征空间中直接对齐真实样本与生成样本的均值与协方差矩阵,可以有效地进行模型蒸馏与后训练。然而,FD-loss 依赖显式的全样本边际统计量计算,这意味着每次更新都需要依赖庞大的样本群体来估算静态协方差矩阵。这种做法不仅面临严苛的维度灾难,更致命的缺陷在于它无法自然扩展到复杂的条件生成任务中——面对开放世界的文本提示词(Text Prompts),根本无法为每一个细分条件预先累积足够的样本来计算精确的条件协方差。
快手与香港中文大学的研究团队在论文《Amortized Moment Matching for Visual Generation》中,从扩散去噪模型的数学本质出发,提出了一种全新的解决路径:摊销矩匹配(Amortized Moment Matching),并在此基础上构建了摊销弗雷歇距离(Amortized Fréchet Distance, AMFD)损失函数。这项工作不仅在理论上揭示了扩散去噪器与数据高阶矩之间的严格等价映射,更用一个可学习的神经网络替代了昂贵且僵化的矩阵统计计算。在实测中,经 AMFD 进行后训练的单步生成模型,在复杂文本生成图像基准 GenEval 上取得了 0.846 的综合得分,显著超越了其多步 FLUX.2 [klein] 4B 教师模型。
理论基石:扩散去噪器本质上在学习高阶统计矩
理解 AMFD 的第一步,是重新审视扩散与流匹配模型中的核心组件——去噪网络(Denoiser)。在传统的动力学视角下,去噪网络学习的是从噪声分布向目标数据分布平移的速度场(Velocity Field)。在以线性插值 $X_t = (1-t)X_0 + tX_1$ 为基准的流匹配框架中,最优速度场定义为给定含噪观测值 $X_t$ 和条件 $c$ 下的条件期望:
\[v^\star(x,t,c) = \mathbb{E}[X_1 - X_0 \mid X_t = x, c]\]该研究跳出了速度场的传统物理学隐喻,转而从多项式投影的纯数学视角对最优去噪器进行正交分解。研究团队证明了一个关键理论命题(Theorem 3.1):去噪模型在不同多项式函数子空间上的最优正交投影,显式识别了目标数据分布的各阶统计矩。
具体而言,如果将最优去噪器限制在关于 $X_t$ 的 $n$ 阶向量多项式函数空间 $\mathcal{P}_n$ 中,所得到的最优 $n$ 阶多项式去噪器 $v_n^\star$ 的多项式系数,将一一对应于真实数据的前 $n+1$ 阶统计矩张量(Moments Tensor)。这就如同数学中的麦克劳林展开:标量指数函数可以展开为无穷项多项式级数,而扩散去噪网络在特征空间中的高阶非线性响应,本质上就是在隐式逼近数据分布的高阶张量统计。
当把多项式截断在最简明且计算可行的仿射(Affine)情况,即一阶多项式($n=1$)时,理论给出了极具指导意义的推论(Corollary 3.2):
-
零阶投影(常数项)严格等于条件均值:$v_0^\star(z, t, c) = \mu(c) = \mathbb{E}[X_1 \mid c]$。
-
一阶仿射投影则表现为均值项与偏离量的线性变换组合:$v_1^\star(z, t, c) = \mu(c) + R_t(c)(z - t\mu(c))$。
更重要的是,研究证明了算子 $R_t(c)$ 与条件协方差矩阵 $\Sigma(c) = \operatorname{Cov}(X_1 \mid c)$ 之间存在单射映射(Injective Mapping):
\[R_t(c) = [t\Sigma(c) - (1-t)I][t^2\Sigma(c) + (1-t)^2 I]^{-1}\]对于任意固定的时间步 $t \in (0, 1)$,只要知道了算子 $R_t(c)$,就能唯一且严格地确定条件协方差 $\Sigma(c)$。这一数学事实直接击碎了传统统计矩对齐必须显式计算大矩阵的定势思维:无须在内存中构造高维样本协方差,只要训练一个神经网络去学习这个仿射变换算子,就等价于捕捉了高维特征分布的全部一阶和二阶统计特性。
AMFD 框架:无矩阵计算与交替优化
基于上述数学推论,本文构建了名为 AMFD 的分布匹配损失。它彻底摒弃了 FD-loss 那套静态、经验式的边缘统计计算管线,换用一套纯粹的深度学习原生范式。
传统的 FD-loss 在每个 mini-batch 中直接利用实测样本去算均值向量和协方差矩阵,再通过矩阵迹数和矩阵平方根梯度回传给生成器。面对上千维的特征向量,显式维护 $D \times D$ 的协方差矩阵并计算逆矩阵或平方根,计算开销与显存占用极其恐怖;更严重的是,这种经验计算在细粒度条件(如文本输入)下彻底失效,因为你无法为一个特定提示词临时搜集数千张真实图来算矩阵。
AMFD 的核心破局点在于摊销(Amortization)。它引入了一个辅助参数化的神经摊销器(Neural Amortizer),专门用于学习特征空间的统计特性。在整个系统中,生成器 $G_\theta$ 与神经摊销器网络以交替更新(Alternating Optimization)的方式协同进化:
首先,冻结生成器,更新摊销器。在真实数据分支与生成数据分支上,摊销器各自维护预测模块。对于均值,网络直接输出条件向量 $\mu_b(c)$;对于协方差算子 $R_{b,t}(c)$,为了保证数值稳定性和规避直接构建大型矩阵,研究团队采用残差参数化,并结合雅可比向量积(Jacobian-Vector-Product, JVP)来实现无矩阵(Matrix-Free)作用:
\[A_{b,t}(c) u = \left.\frac{\partial f_{b,\psi}(s, t, c)}{\partial s}\right\vert{}_{s=0} u = \operatorname{JVP}_s [f_{b,\psi}(s, t, c)]_{s=0}(u)\]利用 PyTorch 等现代自动微分框架的前向模式微分(Forward-mode AD),JVP 能够直接输出矩阵与任意向量相乘后的结果,而从始至终不需要在内存中实例化哪怕一个 $D \times D$ 的协方差矩阵。这使得算子估计的复杂度从平方级 $O(D^2)$ 骤降至线性级 $O(D)$,使得高维全局特征的二阶统计匹配变得轻量且平滑。
其次,冻结摊销器,更新生成器。当摊销器准确追踪了当前生成分布与真实分布的条件矩之后,生成器便直接向摊销器“查询”两者的统计偏差。生成器通过最小化二者在一阶均值和二阶仿射算子上的距离来更新参数。此外,为了防止不同尺度的表征编码器(例如组合使用 SigLIP、Inception 和 MAE 特征)在梯度大小上出现失衡,AMFD 还设计了基于代理梯度模长的自适应归一化项(Proxy-gradient Normalization),确保优化过程极其平稳,免于传统对抗训练常见的模式崩塌。
原生生成空间探索:低阶矩何时足以定义一个分布?
由于 AMFD 的无矩阵特性彻底解除了维度对矩匹配的限制,作者借此完成了一项极具启发性的基础探索:仅匹配前两阶矩(均值与协方差),究竟在多大程度上能够完全定义一个图像分布?
过去的研究普遍认为,图像像素分布高度非高斯,仅靠二阶统计量绝不可能重构出自然图像。为了系统验证这一假说,研究团队使用 AMFD 在四种不同语义密度的原生生成空间中进行了测试:原始像素空间(Pixel Space)、SD-VAE 隐空间、VA-VAE 隐空间以及近来提出的表征自编码器 RAE(Representation Autoencoder)空间。
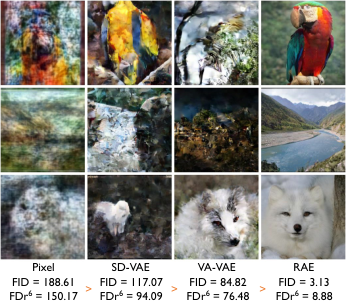
实验结果清晰地揭示了语义密度对矩匹配有效性的决定性影响:
-
在原始像素空间中,哪怕二阶统计量完全对齐,生成的样本依然呈现出大面积混乱无序的纹理与噪点,模型完全无法收敛到有意义的对象轮廓。
-
在 SD-VAE 和 VA-VAE 隐空间中,图像的宏观结构开始显现,但边缘依旧存在明显的模糊与伪影,高阶结构信息的缺失使得纯二阶约束力有不逮。
-
然而,当进入具有极强语义解耦能力的 RAE 隐空间时,仅通过一阶与二阶矩匹配,模型便直接生成了结构高度清晰、内容逼真的高质量图像,在 ImageNet 上达到了 3.13 的优异 FID。
这一对比得出了一个十分关键的结论:低阶矩匹配并不是一种弱约束,它的威力严格取决于它所依附的特征几何。 空间包含的语义越抽象、特征解耦越充分,高阶非线性相关性就被“线性化”得越彻底;在高度语义化的潜空间内,高斯假设或前两阶矩便足以锚定目标数据流形。
从 ImageNet 到 FLUX:单步生成反超多步教师
在标准基准 ImageNet-256$\times$256 的后训练评估中,AMFD 的优势得到了充分释放。在使用相同特征表征(SIM 组合:SigLIP + Inception + MAE)的前提下,基于神经摊销器的 AMFD 在优化稳定性上显著碾压了基于经验样本计算的原始 FD-loss 基线。
在 JiT-H/16 架构上,AMFD 取得了 1.79 的 FDr6 评分;在 pMF-H/16 上更是压低至 1.75。这种改进不仅体现在离线评估指标上,更直观地体现在生成样本的细节保真度与类间多样性上。相较于传统多步扩散模型漫长的积分采样过程,经 AMFD 蒸馏训练后的模型仅需一次前向传播(One-step Generation),就能输出高精度的图像。
更具震撼力的是 AMFD 在大规模文本生成图像(Text-to-Image, T2I)任务上的迁移能力。这是以往基于样本计算的矩匹配方法从未涉足的深水区。研究团队将 AMFD 应用于当前开源领域极具竞争力的 FLUX.2 [klein] 4B 基础模型,利用其条件感知架构(AMFD-C),直接通过文本 Cross-Attention 注入提示词特征。
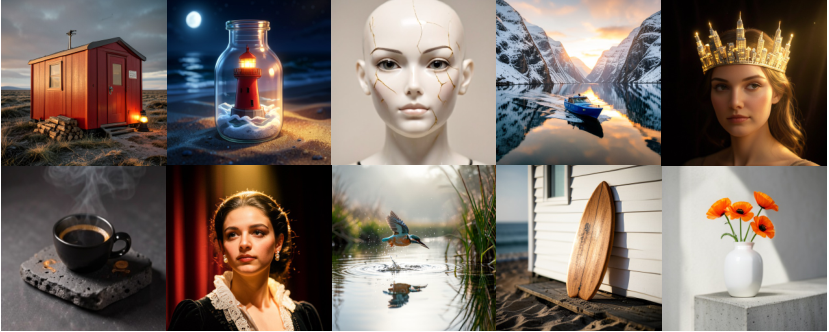
在评估提示词遵循能力的权威基准 GenEval 上,实验交出了一份惊人的成绩单:原始的多步 FLUX.2 [klein] 4B 教师模型得分为 0.794,常规的 4 步蒸馏版本得分相仿;而经由 AMFD 训练出的单步生成模型(One-step),GenEval 综合得分大幅跃升至 0.846。
| 模型配置 | 采样步数 | GenEval 综合得分 $\uparrow$ | PickScore $\uparrow$ |
|---|---|---|---|
| FLUX.2 [klein] 4B Base(教师模型) | 多步 (Multi-step) | 0.794 | 21.85 |
| 官方蒸馏变体 | 4 步 | 0.795 | 21.85 |
| AMFD 后训练(本方法) | 1 步 (One-step) | 0.846 | 21.85 |
单步模型在指令遵循能力上全面反超多步教师模型,这在以往的扩散蒸馏工作中极为罕见。深入分析其原因在于,多步去噪过程往往存在累积误差,且分类器无关引导(CFG)容易导致高对比度过饱和或局部属性错位;而 AMFD 直接在表征层面对齐了图文条件的真实分布矩,神经摊销器动态纠正了生成器特征与文本期望之间的偏差,从而使得单步前向传播便能极其精准地锚定复杂的属性绑定(Attribute Binding)与实体空间关系。与此同时,模型在人类偏好指标 PickScore 上稳定维持在 21.85,未牺牲任何视觉美感。
总结与未来取舍
快手与港中大这项工作的深层价值,在于它为生成式建模建立了一座跨越“粒子传输”与“分布对齐”的理论桥梁。它用严密的数学证明澄清了一个被忽视的本质:扩散模型的多步去噪本质上也是一种多项式矩投影,从而为完全抛弃繁琐采样的单步分布匹配提供了完备的正当性。工程上,通过 JVP 将矩阵统计“摊销”给神经网络,彻底解除了传统统计匹配的算力与显存枷锁,让分布匹配正式具备了拥抱大规模文本多模态的能力。
当然,该框架目前仍有其边界。AMFD 目前主要作为一种后训练(Post-Training)手段,将预训练模型转化为单步生成器,尚不具备完全从零开始初始化训练基座模型的能力;同时,算法严重依赖外部预训练特征编码器的表征质量,低分辨率编码器的瓶颈也在一定程度上制约了超高分辨率生成的直接扩展。但无论如何,AMFD 证明了在语义完备的潜空间中,以神经网络学习低阶统计矩,足以驱动极为强悍的单步图像生成,这为下一代实时视觉生成系统的构建指明了一条兼具理论纯粹性与极高实用价值的技术路线。