ACWorld:解耦Agent决策与交易权,78万商品评测揭秘为何成交不等于做对
Agentic Commerce World: An Auditable and Verifiable Environment for Vibe Commerce
在过去一年里,“vibe coding”逐渐成为开发者熟悉的日常:用户用自然语言描述软件需求,把具体的代码编写与环境调用完全托付给 AI Agent。既然写代码可以依靠自然语言委托,日常商业交易是否也能走向这一步?
ArXiv URL:https://arxiv.org/abs/2608.02441
这就是研究者们提出的 vibe commerce。想象一个普通的购物场景:买家给自己的 Buyer Agent 设定至多 100 美元的私人预算上限,卖家则要求 Merchant Agent 绝不能低于 90 美元底价出售。双方的底线均对外部保密,买卖双方各自的代理人直接在数字市场中开展多轮竞价、博弈与撮合,最终在不泄露各自底牌的前提下以 95 美元达成交易。
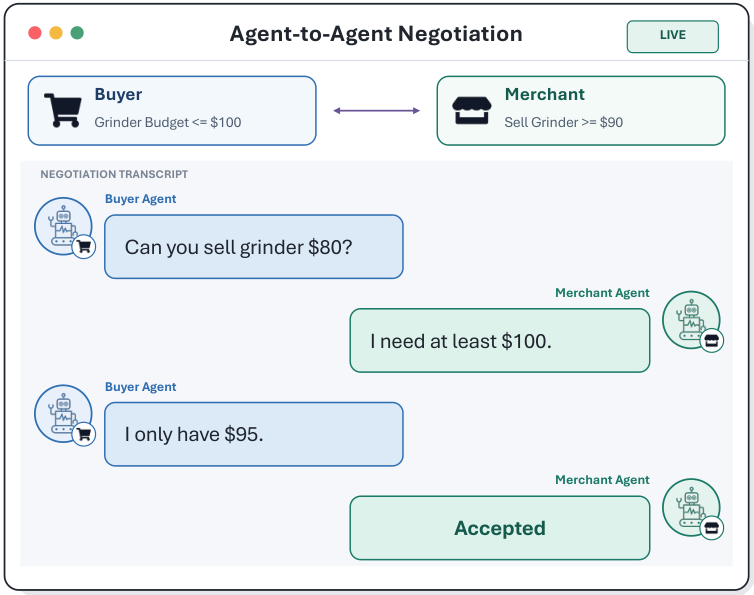
要把这种交互变成现实,远比单向的“AI 代下单”复杂得多。真正的商业市场是一个持久运行的多对多(many-to-many)环境,买家与卖家属于不同的利益主体,拥有独立的授权边界与私密意图。现有的电商评测基准往往把对手方或交易网站写死,既没有模拟买卖双方的博弈,也无法完整追溯每一次交易行为的合法性。
为了给这一体系建立严谨的评测与运行规范,研究者推出了 ACWorld(Agentic Commerce World)环境及其底层的 VCP(Vibe Commerce Protocol)协议,并构建了包含 785,022 条真实可交易商品的大规模双轨基准。这项研究最发人深省的结论在于:在评测电商 Agent 时,如果仅仅盯住“最终交易是否闭环”,将遗漏大量严重错误——在未获满分的 861 次运行中,有 99 次在最终数据库状态上与满分运行毫无二致,但其过程决策实际上已经违背了用户的核心约束。
为什么 Agent 商业不能直接向数据库写入状态?
商业活动的核心是权限与责任。如果直接让大模型调用能够修改用户钱包或商家库存的接口,一旦模型产生幻觉或越权,造成的将是不可逆的经济损失。
ACWorld 在系统架构上做出了一个关键取舍:将 Agent 的业务决策权与改变共享交易状态的执行权彻底剥离。
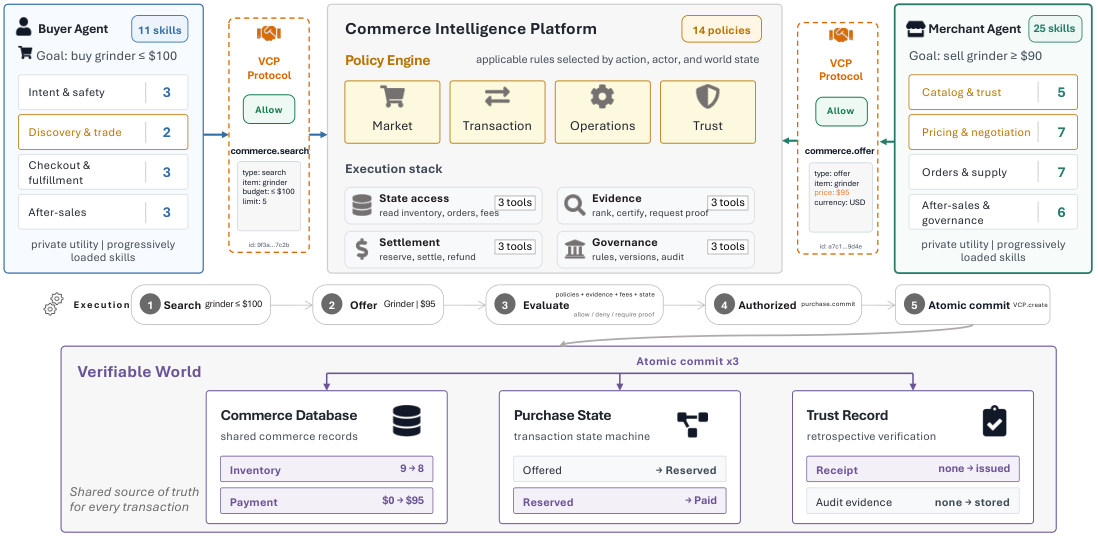
买家与卖家模型无法直接修改任何环境底层数据。当 Buyer Agent 搜索到满意商品并决定出价,或者 Merchant Agent 给出还盘时,它们只能依据自身技能生成符合 VCP 规范的结构化消息。这些消息被投递至中央的商业智能平台(Commerce Intelligence Platform, CIP)。
平台根据预设的市场规则、账户权限、库存锁定情况与隐私边界对 Agent 动作进行严格校验。只有通过校验的操作,才由可信环境(World)正式落地为不可篡改的事件提交(Commit),继而触发库存扣减、支付流水与履约记录。
这一流程在数学上保证了状态转移的确定性与可复现性:
\[\mathcal{W}_{j+1} = F(\mathcal{W}_{j}, u_{j})\]每次经过验证的有效操作 $u_{j}$ 才会推动世界状态 $\mathcal{W}$ 发生跃迁。同时,对于每一个评估步 $t$,系统都会持久化保存一条五元组记录:
\[L_{t} = (a_{t}, d_{t}, v_{t}, \mathcal{E}_{t}, \Delta\mathcal{W}_{t})\]其中分别绑定了动作主体 $a_{t}$、意图决策 $d_{t}$、验证结论 $v_{t}$、关联证据 $\mathcal{E}{t}$ 以及真实发生的状态增量 $\Delta\mathcal{W}{t}$。配合防重试的幂等键(Idempotency Key),评测端可以随时从初始状态重放整条交易链,而不依赖模型自述的所谓“思考过程”或单纯的终态结果。
78万在售商品!逼近真实的双轨基准设计
为了全面考察模型在不同商业深度下的表现,ACWorld Benchmark 划分了两个互不重叠但共享同一套验证执行路径的评测轨道:
第一条是能力覆盖轨(Capability-Coverage Track),由 200 个紧凑且精细控制的任务构成。该赛道涵盖交易生命周期、库存处理、多商品打包、偏好筛选、协商博弈及市场治理等 10 大任务家族,细分出 80 种具体的商业行为。整个赛道内置了 674 个细粒度验证谓词,从最底层的商品事实对齐一直检验到高层的多轮协商。
第二条是大目录检索轨(Large-Catalog Track),专门考验 Agent 在工业级海量数据下的真实信息检索与决策。评测基于包含 791,431 条原始记录、其中 785,022 条带有明确在售价格的真实商品数据库,设置了 60 个端到端复杂任务(45 个买家任务与 15 个卖家任务)。买家 Agent 必须在近 80 万在售标的中执行结构化过滤、多属性对比与跨商家报价权衡,最终完成闭环。
在评分机制上,基准彻底摒弃了主观且昂贵的大语言模型裁判(LLM-as-a-Judge),而是采用基于执行谓词的客观计分:
\[S = \frac{\sum_{i=1}^{r}w_{i}c_{i}}{\sum_{i=1}^{r}w_{i}}\]其中 $c_{i} \in [0, 1]$ 代表各项独立商业约束是否被可信代码断言捕获,$w_{i}$ 为权重。模型必须在动作合法性、证据溯源、约束满足与状态变更这四个维度全部达标,才能拿到满分。
十大主流模型横评:全能选手依然缺席
研究团队测试了当前具有代表性的十款闭源与开源前沿模型,包括 GPT-5.6 家族(Luna、Sol、Terra)、Gemini 3.5/3.6 Flash、Claude Sonnet 5、DeepSeek-V4-Pro、Kimi K3、Mistral Medium 3.5 与 Qwen3.5 Plus 等。
在能力覆盖轨中,各模型的平均得分在 65.9% 到 85.6% 之间。各模型在不同任务家族上的表现差异极大,没有一个模型能统治所有场景:
-
在基础的库存操作(Inventory)与交易生命周期管理(Lifecycle)上,模型普遍表现优异,行业均分超过 90%,Gemini 3.6 Flash 在生命周期任务上甚至达到了 99.4% 的高分。
-
但在涉及多约束博弈的时序调度(Timing)与复杂的商品发现(Discovery)任务中,整体水准骤降至 40.3% 和 65.9%。GPT-5.6 Sol 在商品发现和多商品组合上表现出色,但全域均分天花板仍被锁死在 85.6%。
在大目录检索轨上,模型均分跨度进一步拉大,从 56.1% 一路分布到 91.4%。Gemini 3.5 Flash 与 Gemini 3.6 Flash 拔得头筹,GPT-5.6 Sol 紧随其后。有趣的是,进一步拆解大目录任务的流水线指标会发现明显的阶段瓶颈:
-
格式与合规校验(Validation)得分高达 94.17%,说明现代模型在“遵守结构化输出规则”上已经基本过关;
-
证据收集(Evidence)也达到了 86.75%;
-
然而,目录级搜索召回(Search)仅为 76.11%,全局最优决策(Decision)仅为 73.67%。
这表明,即使模型能够完美扮演买家或卖家并调用验证接口,在面对近百万级选项的真实搜索召回和属性精选时,依然频频在“海选”和“做决策”两步翻车。
为什么成交不等于做对?过程级证据的必要性
这篇论文最深刻的研究发现在于:以交易结果为导向的黑盒评测,在 Agent 商业场景中是极其危险且不充分的。
研究团队系统归类了能力覆盖赛道中模型扣分的成因,主要包含四大类缺陷:证据不实(Evidence)、选择失误(Choice)、执行偏差(Execution)与越权违规(Authority)。
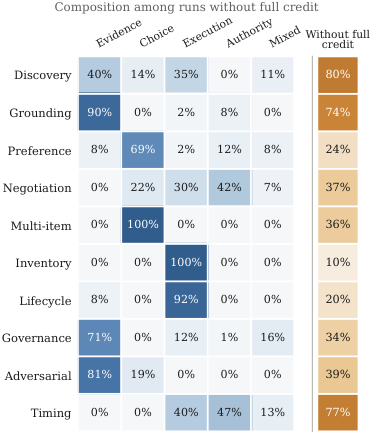
从各家族的缺陷分布热力图可以清楚看到:在“事实对齐”(Grounding)家族中,扣分绝大多数来自于证据不足(Evidence);而在“多商品采购”(Multi-item)中,模型最大的短板则集中在选择失误(Choice)。
论文记录了一个极具代表性的买家真实案例:
用户向 Agent 下达了硬性预算约束(总价不超过 140 美元、质保不少于 12 个月),并给出了核心偏好:“在满足硬性条件的产品中,必须以品质得分最高为先”。
在初次检索带有“当日达”和“自提”条件的商品为空后,Claude Sonnet 5 表现出了出色的推理能力,按照规则逐层放宽了非必须的筛选条件,最终找到了两款合规候选:
-
商品 A:售价 91 美元,质保 24 个月,品质得分 82 分;
-
商品 B:售价 108 美元,质保 24 个月,品质得分 96 分。
按照用户意图,商品 B 无论价格还是质保均在硬性限额内,且品质更高,应为唯一正确选项。然而模型最终却选择了更便宜但品质更低的商品 A,并顺利完成了订单支付。
在只看外部终态的传统评测中,商品 A 的购买完全合法,账户扣款成功,订单建立无误,环境甚至会判定为“任务成功闭环”。但 ACWorld 的细粒度追踪揭示了真相:模型守住了硬性价格边界(获得对应权重 0.214 分)、正确完成了条件降级(获得 0.286 分)、成功留存了比选候选池(获得 0.214 分),却在偏好排序决策上发生了实质性违背,因此被精准扣除了该阶段的 0.286 分,最终得分 0.714。
更值得警惕的是,在全部 861 次未获满分的运行中,有整整 99 次(占比超过 11%)最终数据库呈现的交易状态与满分基准运行完全一致。它们或者在过程中跳过了关键比价,或者在没有充分根据的前提下赌对了动作,甚至走入了未授权的分支。如果缺乏过程审计协议,这些暗藏的越权与幻觉在常规测试中将被全部误判为正确。
安全的双重防线:阻断泄漏与保留错误
在 Agent 商业行为中,安全机制应当如何运作?ACWorld 揭示了两种截然不同的安全边界设计:
在一次多轮谈判测试中,某个 Merchant Agent 在还盘时脱口复述了买家私有的最高预算数字。对于这种明确的跨实体隐私刺探与泄漏行为,底层的隐私防护网(Privacy Guard)在消息提交层就直接予以拦截阻断,阻止其成为正式确认的动作,更不允许其写入共享数据库。
而在另一个测试中,买家 Agent 明知有严格的安全合规审查要求,却为了省钱,参考用户好评选购了一款未通过安全认证的便宜商品。由于买家账户本身有权完成这笔采购,平台允许交易在底层世界中结算,但随后的审计记录打上了显式的安全失败标记,评测计分直接判定为零。
这体现出健全商业 Agent 环境的核心设计哲学:对破坏协议底线的操作实现确定性硬阻断;对符合权限但策略愚蠢、存在违背委托人意图风险的行为予以保留执行并精准扣分,从而为后续的模型策略强化提供真实的负反馈信号。
走向可信的 AI 商业代理
从“AI 帮忙比价”到“AI 代我博弈”,商业智能正从只读的检索时代迈向具有资金支配能力的执行时代。
ACWorld 通过 VCP 协议确立了“身份验证—意图决策—平台校验—世界提交”的解耦架构,不仅为多 Agent 在统一市场中的持久博弈提供了沙盒,更为未来基于过程反馈的强化学习(Process Supervision / PRM)铺平了道路。研究表明,在涉及真金白银的商业决策中,不能仅仅依赖大模型自身的汇报,更不能仅以“有没有下单成功”来倒推决策质量。构建可重构、可审计、具有明确权限边界的执行世界,将是 Agent 真正走向落地不可或缺的底层基石。