MissionBench:大模型掌舵无人机,人类达84%而最强AI仅35%
Zero-Shot Mission-Level Evaluation for Aerial MLLM Agents
在具身智能(Embodied AI)的研究浪潮中,多模态大语言模型(MLLM)正被寄予厚望。从早期的桌面机械臂操作,到室内的扫地机器人导航,研究者习惯于将大模型作为通用“大脑”,期待它们仅凭预训练获得的通用图文推理能力,就能零样本(Zero-Shot)理解人类指令并操控物理实体。然而,当具身智能的试验场从逼仄平整的室内地面转移到广袤的三维低空,这种通用智能是否依然可靠?
ArXiv URL:https://arxiv.org/abs/2607.22014
最新推出的评测基准 MissionBench 给出了一个冷峻的基准答案:面对不需要额外微调的复杂空中任务,哪怕是当前最顶尖的多模态大模型,在完整任务维度上的成功率也未曾突破 35%,绝大多数主流模型的成功率甚至被压制在 10% 以下;而人类操作员在相同的观察与动作限制下,依然能轻松取得 70% 的成功率,在连续键盘操控下更是达到 84.4%。
这项研究的核心价值在于,它跳出了传统“点对点纯导航”的局限,首次全面考察未微调多模态模型在执行“任务级”(Mission-Level)空域作业时的综合协调能力。实验不仅揭示了模型规模扩张(Scaling)对具身长程决策带来的清晰正向收益,也尖锐地指出了当前大模型在三维动态决策与视点自适应选择上的关键断层。
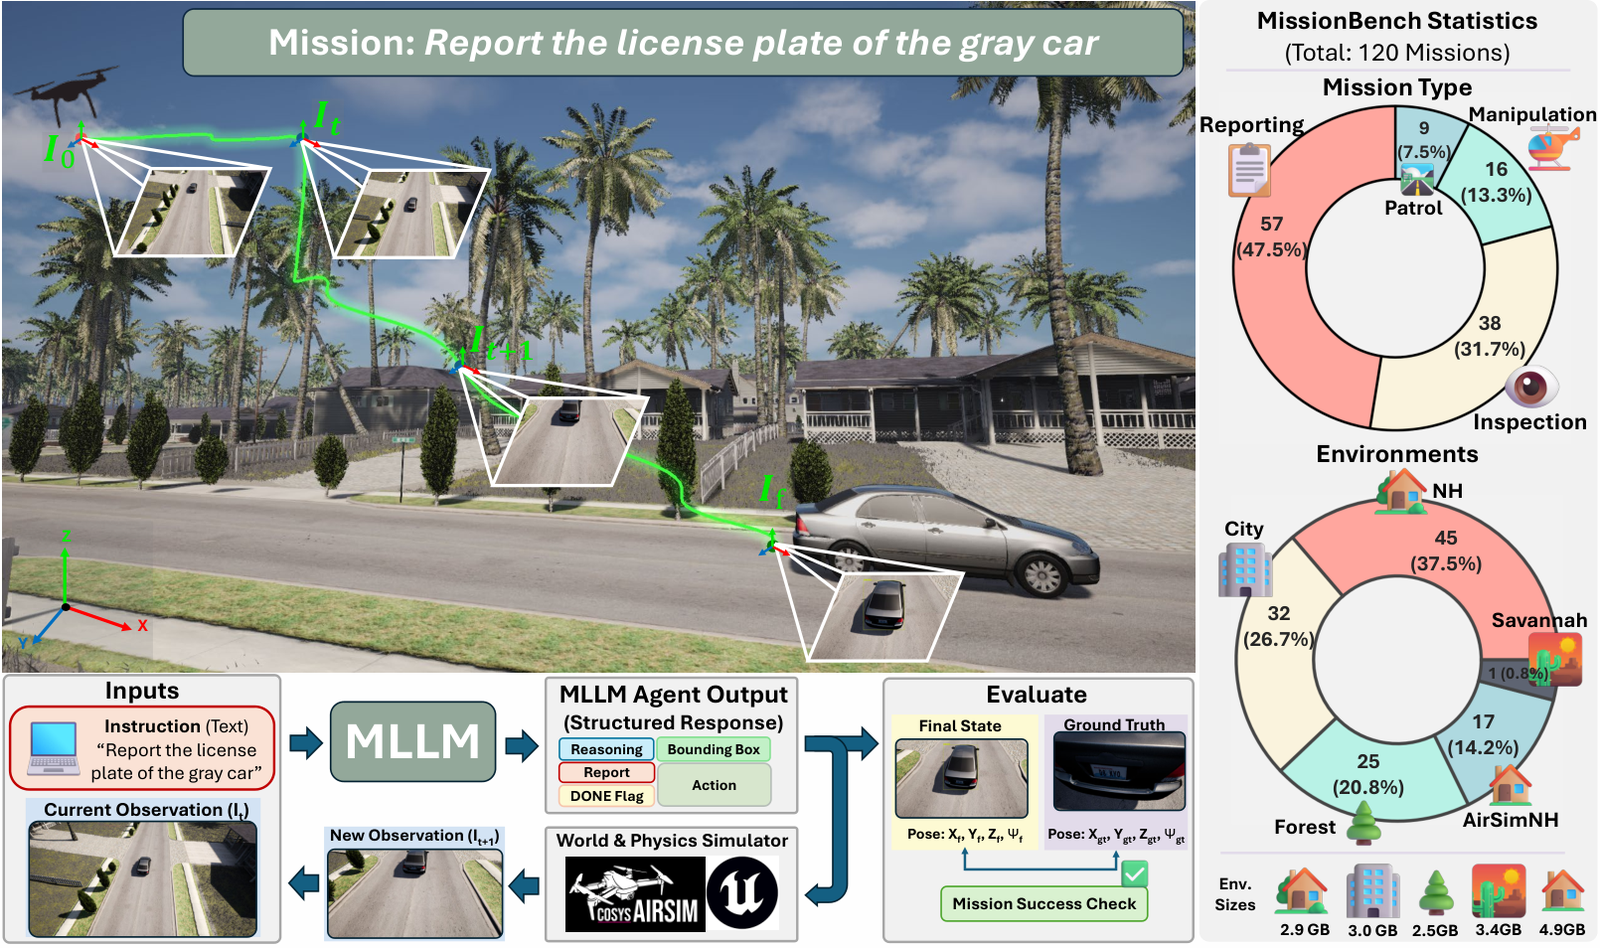
从“走过去”到“完成任务”:空中具身智能的真正盲区
长期以来,视觉语言导航(VLN)和目标导航(ObjectNav)占据了具身评测的主流。在这些基准中,智能体通常接收一系列类似“左转、穿过走廊、停在桌子前”的细粒度指引,只要最终落点与预设坐标的欧式距离小于特定阈值,就会被判定为成功。即便像 ALFRED 这类包含交互的基准,也普遍将复杂动作拆解成了详尽的单步子目标。
但在真实的无人机(UAV)作业场景中,人类几乎不可能为无人机编写每一个航路点。现实指令往往高度概括且以结果为导向,例如“去看看那艘着火的轮船受损情况”、“查一下红色轿车的车牌号并汇报”、“在帐篷旁边投下物资”,亦或是“沿着公路巡逻”。这些任务具备几个非常苛刻的现实特征:
首先是强烈的视点敏感性(Viewpoint-sensitive)。无人机在几百米外的高空或许能察觉到地面车辆的轮廓,但车牌上的字符在低分辨率下只是一团模糊像素;森林火灾的初始画面中可能仅仅飘散着一丝微弱的烟雾。智能体不能被动停留在初始观察点,而必须主动推断出“要想看清车牌,我应该以何种角度、何种俯仰角、下降到多近的距离”。
其次是连续空间中的精细位姿控制。过去很多空中导航数据集将动作简化为固定的离散位移(比如每次只能机械地前进 3 米或 9 米),这在开阔空域与密集避障交织的环境中极其僵硬。最后则是端到端的汇报闭环,任务不仅要求无人机“飞到位”,还要求无人机在适当的时机宣布任务结束,并准确产出结构化的语义结果。
以往的研究要么将空间感知、路径规划和语言汇报割裂开来单独打分,要么只把终点距离当作唯一真理。这种评测机制掩盖了核心问题:当感知、长程规划、动态避障与最终的信息提炼交织在同一个因果链条中时,大模型的推理链条究竟会在哪个环节崩塌?
架构解密:MissionBench 的闭环任务设计
为了填补上述空缺,研究团队构建了 MissionBench。整个评测基准基于虚幻引擎 5(Unreal Engine 5)与 Cosys-AirSim 物理仿真平台搭建,涵盖了邻里社区、高楼城市、繁茂森林、开阔热带草原以及专业飞行测试场等 5 个高保真、不同物体密度与光照条件的 3D 场景。基准收录了 120 个由专业无人机飞手参与设计的人工任务,真实轨迹长度从中尺度的 13 米跨越至长航程的 4171 米(中位数 93 米,均值 260 米),横跨四种典型无人机任务家族:
-
汇报任务(Reporting):智能体需要飞向特定目标并读取关键信息(如读取车牌、辨识路标),成功标准基于最终汇报文本的准确性;
-
巡检任务(Inspection):智能体需要调整自身位姿,使最终停留在与真值位姿距离小于 5 米且航向角偏航小于 15 度的观测窗口内;
-
操作任务(Manipulation):兼顾空间位置门槛与特定投递/取样动作的执行触发;
-
巡逻任务(Patrol):智能体沿指定线状区域(如干道、海岸线)飞行,计算其飞行轨迹与参考轨迹的覆盖重合度(IoU > 0.5 即判定成功)。
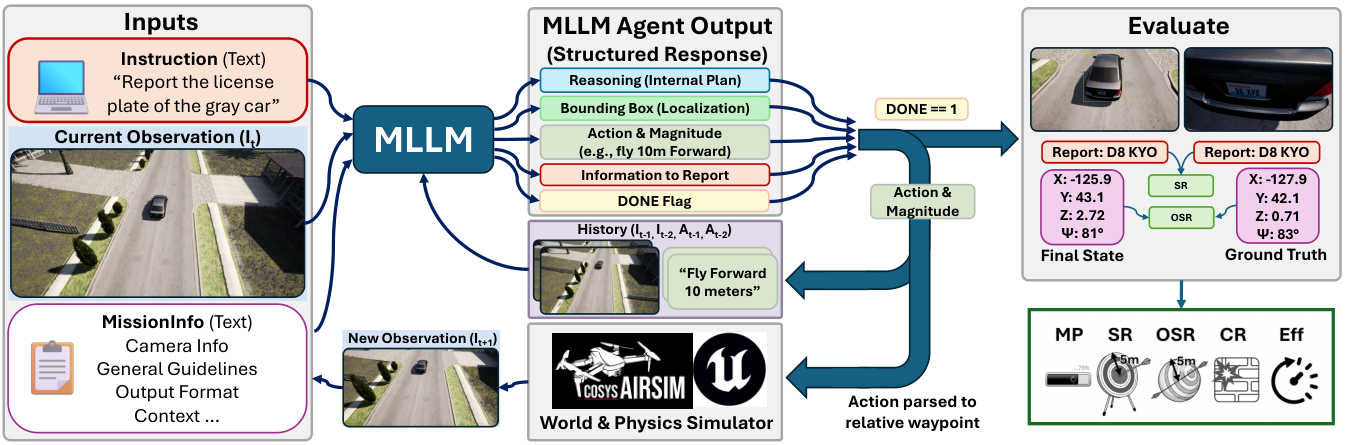
如上图所示,在 MissionBench 的闭环交互中,每个任务仅提供一句自然语言总指令和无人机挂载相机的当前第一人称视角(RGB 图像,俯仰角固定为 $-45^\circ$)。智能体在每个时间步必须生成一个结构化的输出,不仅包含目标边界框(Bounding Box)预测与动作推理解释(CoT 思维链),更重要的是直接输出动作原语及其连续幅度。
动作原语包含前后飞行、左右平移、升降以及偏航转向共 8 种基础方向,单步最大位移 $d_{\max}$ 会自适应根据总航程动态缩放(约为起始点到目标总距的四分之一),这允许智能体在远距离时大幅度逼近,在接近目标时小步精调。同时,智能体还会决定是否在当前步触发完成标记(DONE)并提交最终文本结论。每一轮模型都能看到当前帧、最近两帧的历史观察以及过往动作序列,由此构建出高度严苛的闭环测试环境。
这种评测管线彻底解耦了“空间探索”与“任务达成”。系统不仅追踪智能体是否发生碰撞(Collision Rate, CR),还通过多项复合指标全面量化模型的执行质量:成功率(SR)衡量硬性任务指标;任务进度(Mission Progress, MP)衡量向目标靠拢的绝对程度;预言机成功率(Oracle Success Rate, OSR)记录智能体在整个飞行生命周期内是否曾经过目标 5 米范围内;以及步数效率(Step Efficiency, Eff)。
22 款大模型横向较量:冰冷的数据与巨大的鸿沟
为了探寻当前通用多模态智能的真实水位,研究团队在完全不进行任何无人机领域微调(Zero-Shot)的前提下,系统评估了 22 款涵盖开源与闭源的前沿多模态大模型。
在 30 个任务组成的核心测试集上,成绩单呈现出巨大的断层。闭源阵营中,Gemini 3.1 Pro 斩获全场最高分,但其成功率仅为 34.8%,任务进度(MP)为 73.3。紧随其后的是面向具身场景优化的 Gemini Robotics 1.6,取得了 32.2% 的成功率与 70.3 的任务进度。开源阵营中的表现领跑者为 Gemma-4-31B-IT,取得了 26.7% 的成功率。
然而,在这三款第一梯队模型之下,整个榜单迅速滑向个位数区间。多达 15 款以上的主流前沿模型,最终成功率甚至未能突破 10%,部分中轻量级开源模型在严苛任务判定下的成功率直接归零。绝大多数模型平均消耗了超过 65% 的步数配额,却频繁在终点前迷失方向或因动作震荡耗尽时间。
相比之下,人类基准表现展现了强烈的对比反差。当专业人类操作员使用完全相同的 API 接口——即只能看到历史三帧离散图片、通过输入指令步长来操控无人机时,人类依然能够斩获 70.0% 的任务成功率;而当人类切换为习惯的实时键盘连续操控模式时,成功率直接跃升至 84.4%。
这一落差说明了一个关键事实:虽然离散的文本动作接口和受限视野确实会对操作表现带来一定损耗(使人类成功率从 84.4% 跌落至 70.0%),但当前大模型与人类之间的核心鸿沟(34.8% 对比 70.0%),绝非单纯由交互接口的物理限制导致,而是源于底层多模态时序推理与三维空间意图执行上的根本缺陷。
隐藏在轨迹里的秘密:为何靠近了目标却依然失败?
将目光移向深层指标,尤其是对比“预言机成功率(OSR)”与“实际成功率(SR)”的差异时,模型在三维任务中的迷茫被暴露得淋漓尽致。
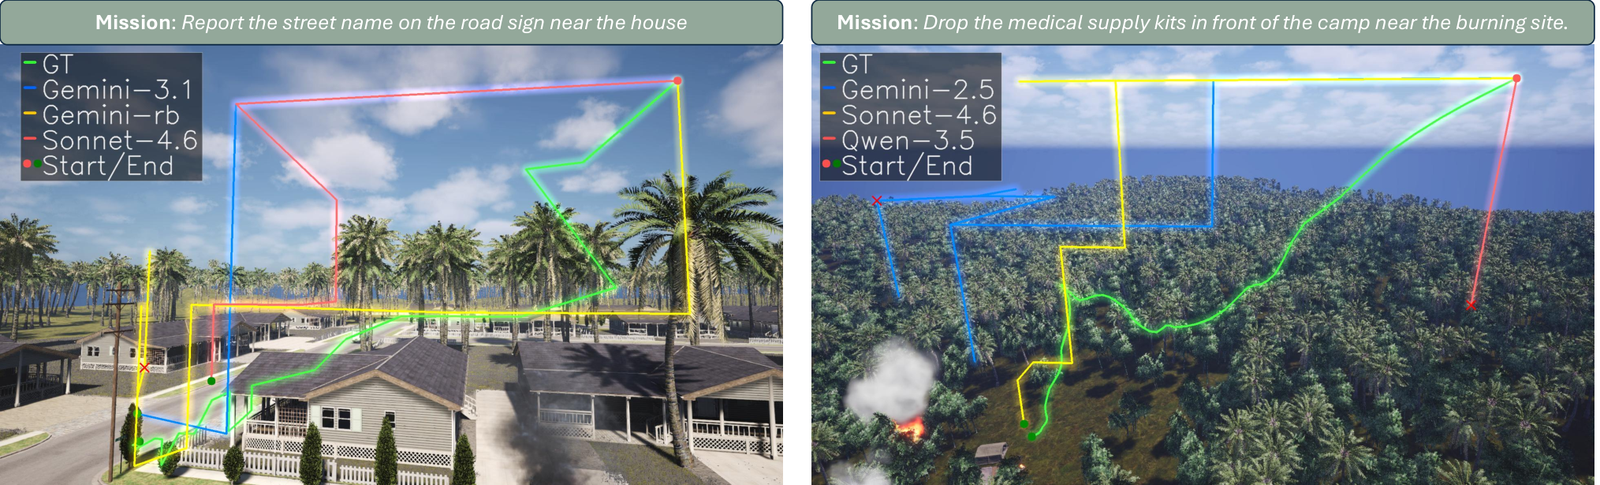
在上图展示的典型轨迹比对中,绿色线条代表人类飞行员的标准航迹,其余彩线则记录了不同大模型的实际行进路径。分析发现,模型的失败模式远比简单的“找不到目标”更为丰富:
最耐人寻味的模型特征是 $\text{OSR} > \text{SR}$。例如 Gemini 3 Flash 的 OSR 达到 20.2%,但最终 SR 仅有 7.9%;Claude Opus 4.6 的 OSR 为 10.0%,而 SR 仅为 3.3%。这意味着模型在三维空间中明明已经非常出色地巡航到了距离目标不足 5 米的核心区域,但紧接着它们却无法稳定在理想的观测视点上,要么在近距离盲目徘徊甚至直接漂移远离,要么未能正确识别出此时已满足任务条件,最终在耗尽步数后判定失败。
第二种典型模式体现为 有进度却无终局。以 GPT-5.4 为代表,其平均任务进度高达 45.0,这表明它完全理解了语义意图的大致朝向,并持续朝着目标区域挺进。然而其 OSR 和 SR 却趋近于零,原因在于无人机飞入中近程区域后,模型难以精确调节下降高度与相机偏航角,无法完成最后的精度收敛,始终被挡在任务终点门外。
第三种则是严重的 空间几何感知与避障脱节。基准中的碰撞率(CR)展示了模型对自身体积与环境障碍物相对关系的感知能力。令人意外的是,任务成功率最高的 Gemini 3.1 Pro 碰撞率达 4.3%,明显高于中位数;而某些在最终任务中表现平平的模型(如 Qwen 3.5 27B),虽然成功率仅为 10.0%,碰撞率却维持在 0.0%。这直接证明:在当前的大模型内部,低层级的避障空间几何感知 与 高层级的长程任务意图规划 之间存在明显的割裂,高任务进度的模型往往表现得更加“激进”,甚至不惜以频繁擦碰障碍物为代价强行靠近目标。
空间感知是原罪吗?关于单帧感知的证伪实验
面对大模型在空中的频频受挫,一个直观的假设通常是:大模型的预训练数据大多来自互联网上的第一人称或平视视角图像,缺乏俯视鸟瞰的航拍数据,因此是“单帧 3D 空间几何感知能力的孱弱”拖垮了整个任务。
为了检验这一假说,研究团队设计了一个巧妙的控制实验:他们将智能体面临的长程动态导航与规划流程全部剥离,仅从 Proxy 任务集的初始帧 $I_0$ 中截取静态图像,要求各模型单纯完成两项任务:第一,在图像上画出目标物体的 2D 边界框(计算定位 mIoU);第二,直接估算目标与当前相机的实际空间距离(计算测距均方根误差 RMSE)。
实验得出的结论极具启发性:在单帧纯感知评测中表现出色的模型,在动态闭环任务中的表现并没有呈现出必然的正相关,反之亦然。单帧感知对于无人机任务固然不可或缺,但它远远构不成制约长程任务成败的主要瓶颈。
在长达几十步的实际飞行中,哪怕模型单帧定位极其准确,一旦智能体无法根据连续动作的反馈修正自身的位姿假设,这种单点感知能力就会瞬间失效。真正的死穴在于感知与动作之间的动态闭环协调:模型需要理解“我刚刚向右前进了 5 米,为什么图像里的物体反而变得更偏了?我下一步是否应该调低航向并缩短前进距离?”这种将时间跨度上的连续视觉变化与空间运动几何相融合的时序自适应推理,恰恰是当下通用大模型最缺乏的核心拼图。
Scaling 依然有效,但通向低空智能没有捷径
尽管 MissionBench 展现了严峻的现实落差,实验中依然显露出一抹积极的曙光:模型规模扩张(Scaling)依然是提升具身能力的强劲引擎。
在同源模型家族内部,性能随着参数量的上升呈现出了明确的跨越式增长。在 Gemini 家族中,Pro 版本从 Flash Lite 的 24.0 MP 一路跃升至 73.3 MP;在 Qwen 3.5 密集模型家族中,随着参数量从 2B 扩展到 27B,任务进度从 18.1 稳步提升到 53.2,成功率也从 0% 破冰攀升至 10.0%。这强有力地证明,即使没有在无人机物理动力学或空中轨迹上经过专门的有监督微调,更庞大的通用图文多模态预训练模型依然内生性地涌现出了更强的长程推理潜能与空间泛化能力。
但这同样带来了硬币的另一面: scaling 并不是一切问题的灵丹妙药。一方面,跨家族的横向对比并未展现出严格的单调性,某些轻量级特化模型或新架构版本甚至能反超参数量更大的模型;另一方面,通用预训练带来的零样本能力增长,目前依然严重缺乏可靠性与安全边界。
当一个未在物理世界进行严格对齐的大模型被赋予四自由度的真实飞行器控制权时,其不可预测的动作震荡、对高度信息的误判、以及在复杂几何障碍前的盲目冲撞,都会成为落地现实场景的巨大隐患。
结语
从地面到天空,具身智能的技术演进并非仅仅多了一个 $z$ 轴的高度维度,它实质上对大模型的视点自适应选择、连续位姿动态控制和多阶段任务闭环提出了前所未有的严苛要求。
MissionBench 的出现,如同一面清晰的棱镜。它不仅击碎了“通用多模态大模型可以直接零样本平移至物理飞行实体”的盲目乐观,也精准地定格了当前通用 AI 与人类专家之间那道逾越近半数的性能断崖。它明确昭示着:未来的空中自主 Agent,不能仅仅依赖互联网通识预训练的自然涌现;如何将连续时序反馈、空间 3D 几何常识以及多层次的主动视点规划融入大模型的长程推理中,将是具身智能通往真正实用化不可绕过的下一道关键战役。