MMShopBench:首个多模态多轮电商Agent基准,开源模型准确率提升61%
MMShopBench: A Real-Log Benchmark for Multimodal, Multi-Turn Shopping Agents
随着以大语言模型为核心的智能体(Agent)在工具调用与多步规划上不断演进,电商导购被普遍视作极具商业价值与落地潜力的核心场景。然而,现有绝大部分电商 Agent 评测依然停留在“根据单一纯文本指令搜索”或“人工合成对话”的温室中。但在真实购物过程中,消费者几乎从不会在一句话里把所有需求条理分明地交代清楚。用户往往先发一张带有目标款式的截图,模糊地说一句“想要这种”,随后在多轮交互中逐步追加“预算两百以内”“要纯棉材质”“不要带拉链的”等一系列强约束。
ArXiv URL:https://arxiv.org/abs/2607.29002
面对这种碎片化、交织在图文历史中的真实诉求,现有的电商评测基准存在明显的脱节:要么只评测纯文本多步决策,要么只关注单轮的多模态图文检索,无法检验 Agent 能否从真实的图文对话流中准确提取硬性条件,并在多轮检索中完成跨模态证据的交叉核验。
为了弥补这一关键空白,研究团队推出了 MMShopBench。这是首个完全脱胎于线上真实导购助手交互日志的多模态、多轮对话电商 Agent 基准。该基准不仅构建了包含 289 个深度清洗与人工标注真实案例的评测集,还配套搭建了一个包含 10 万真实商品的离线可复现沙盒环境。更重要的是,研究表明未经专门微调的开源大模型在真实多轮图文导购中几乎处于瘫痪状态(如 Qwen3.5-122B-A10B 初始 Judge@1 仅 5.5%),但通过高质量专家轨迹的有监督微调(SFT)和证据驱动核验机制,开源模型的 Judge@3 准确率暴增 61.6 个百分点,逼近顶尖闭源模型的水平。
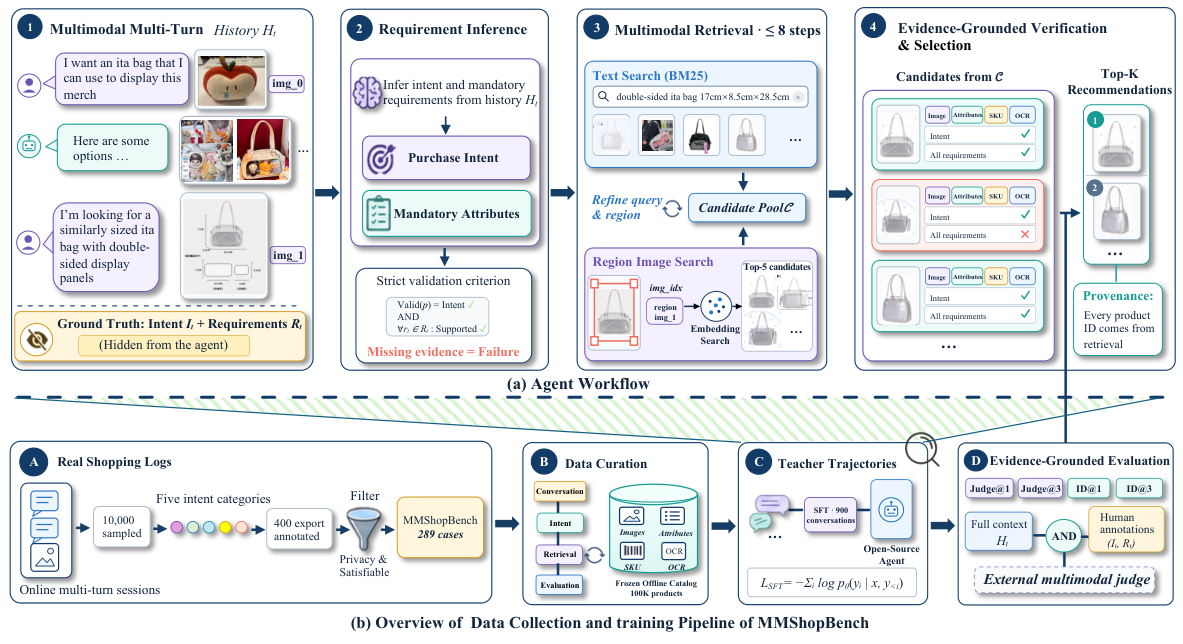
真实购物需求的本质:跨模态增量硬约束
以往研究在评估导购 Agent 时,往往把输入简化为形式规范的提示词(Prompt),或者让两个模型互相对话生成合成轨迹。这种设定忽视了人类线上购物的本质特征:需求的跨模态增量表达。
在真实的交互里,用户上传的图片可能只代表图案风格,真正的品类需求却在第三轮文本里才点明;或者用户图片中包含极其复杂的背景、附带了多个物品,用户随口一句“这个多少钱”,模型必须结合上下文推理出到底是在指代哪个主体。在此过程中,用户的每一次追加输入都会形成对目标商品的“与逻辑(AND)”硬性约束。只要商品违反了其中任何一条不可妥协的属性(例如尺寸不符、材质不对、缺乏特定接口),哪怕外观再相似、品类再吻合,对消费者而言也是一次彻底失败的推荐。
MMShopBench 的任务设定正是围绕这一严格逻辑展开的。在评测中,案例被形式化定义为三元组 $(H_t, I_t, R_t)$。其中 $H_t$ 是截至目标轮次 $t$ 的完整交互历史,包括用户发送的图片、用户文本和助手过往回复;$I_t$ 为真实购买意图;$R_t = {r_1, \ldots, r_m}$ 为该次交互中沉淀下的所有强制性属性集合。
Agent 在执行任务时,仅能观察到交互历史 $H_t$,必须完全自主推断出隐藏的意图与硬性约束。在调用工具完成多轮检索后,Agent 需给出排序后的商品候选列表 $P_k$。评测系统判定一个推荐商品是否有效,采用极其严苛的连取判定:候选商品所携带的全部证据,必须同时满足购买意图 $I_t$ 以及集合 $R_t$ 中的每一条硬性约束。只要有一项条件无法被证实或存在冲突,该推荐即被判为失败。这种设计清晰地将 Agent 的失败归因切分为两类:一类是意图与约束推理错误(没理解用户要什么),另一类则是模态落地与核验错误(虽然理解了,但检索或选品时缺乏扎实证据支持)。
数据提炼与意图分层:从1万条原生日志到真实基准
为了保证基准的真实性与严谨性,MMShopBench 从线上真实部署的电商 AI 助手日志中,随机抽取了 2026 年夏季产生的 10,000 条包含多轮交互且至少含有一张用户上传图片的原生会话。
真实的线上多模态流量极度繁杂,大量会话并非直接买东西,可能只是泛化的以图搜图识别、售前咨询或无意义闲聊。研究团队首先利用 Claude Opus 4.8 对这 1 万条会话进行一级意图分层与关键截断点定位(Target-turn Localization)。一级意图划分为五大类:寻找同款商品、寻找相似/替代/推荐商品、商品知识与对比决策、通用视觉识别以及模糊意图。同时,模型需要标定出哪一轮交互标志着用户需求的充分表达。
在过滤出明确具备导购行动意义的前两类意图后,团队引入电商资深专业标注团队进行极其严格的质检与深度标注。标注人员通读完整图文上下文,提炼出不可妥协的硬性约束属性,并在平台端核验确保至少存在一款真实商品能完全匹配全部约束。经过严格的隐私脱敏与可用性过滤,最终锁定了 289 个极具代表性的高难度评测用例。
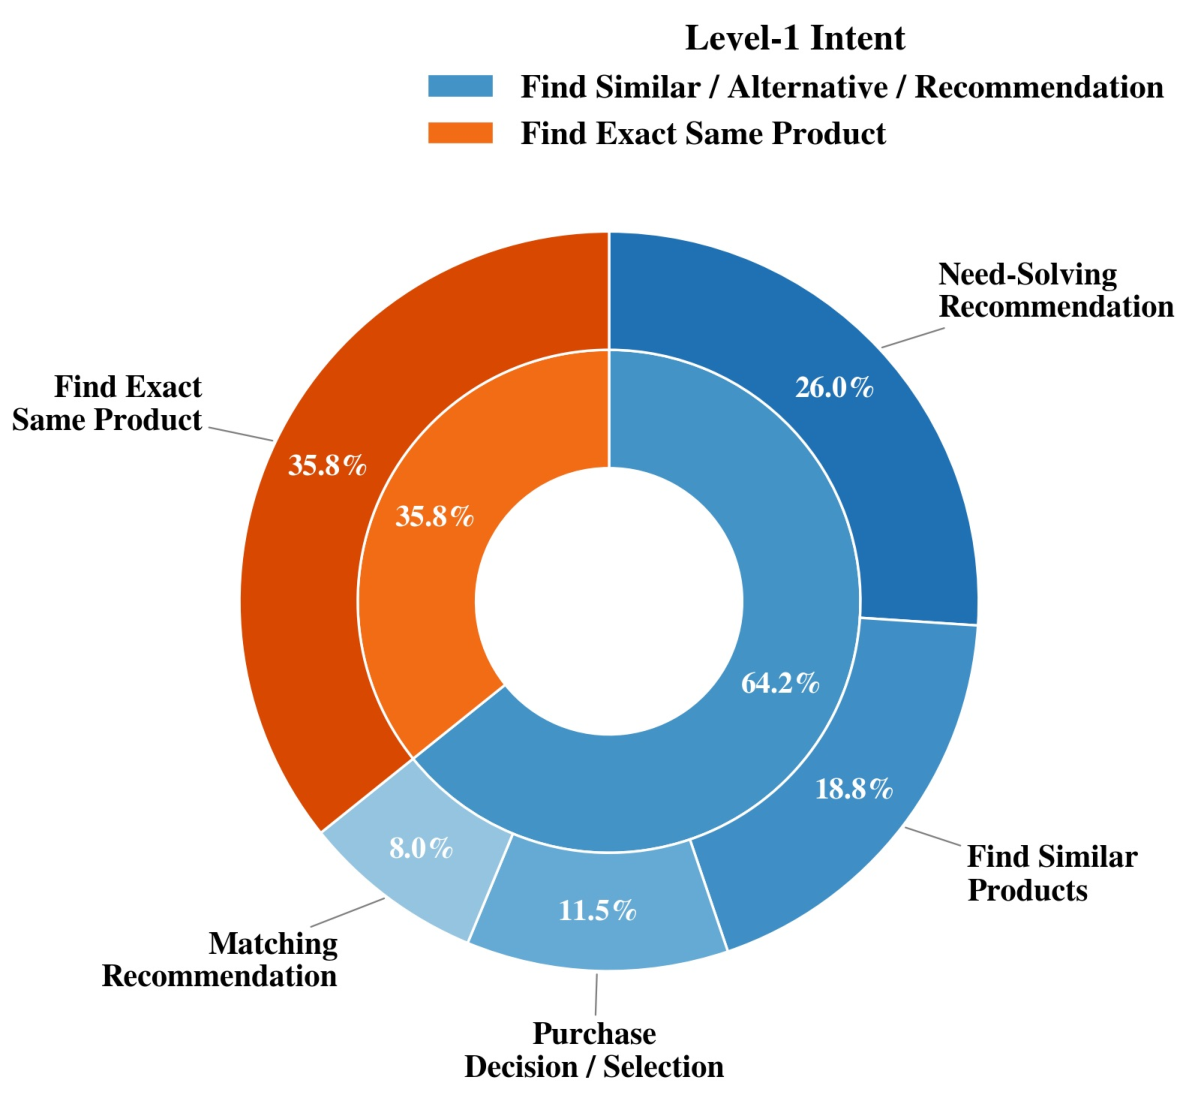
如上图所示,入选的评测用例进一步细分为二级意图:寻找同款商品(Find Exact Same Product,占比 35.8%)与针对特定痛点的解决方案推荐(Need-Solving Recommendation,占比 26.0%)占据了主体,其余则覆盖了相似品检索、选品决策和搭配推荐。这种意图分布高度还原了真实多模态导购的核心战场。
10万商品沙盒与条件驱动的区域视觉检索
真实电商环境每天都在动态变化,商品下架、价格变动都会导致 Agent 评测失去可复现性。MMShopBench 构建了一个包含 100,000 个独立商品的静态离线沙盒。
该沙盒以人工标注验证的目标商品为锚点,先通过分层抽样覆盖目标商品所在的叶子类目及二级类目,再均匀采样其余类目以确保品类的广度与真实干扰度。更关键的是,现实中大量硬性约束根本无法从简短的商品标题或主图判断,因此沙盒为每个商品补充了完备的多模态证据链:商品首图、标题、类目属性、SKU 级细分标签,以及从商品详情页长图中通过 OCR 提取的完整文本。
在交互工具层面,沙盒为 Agent 提供了两项互补的检索手段:
-
基于 BM25 的文本检索:覆盖商品标题、属性、类目及店铺字段,在用户以自然语言明确提出品牌、材质、特定型号等参数时发挥主要作用。
-
基于需求引导的区域视觉检索(Requirement-conditioned Region Retrieval):这是整个交互机制的关键创新。传统以图搜图往往直接对整张用户图片做全局 Embedding 提取,但在多轮导购中,整图嵌入往往会被复杂的背景、次要杂物或无关物体主导。MMShopBench 允许 Agent 将“裁剪框”作为动态预测动作:Agent 结合提取到的购买意图和已累积的约束,自主输出一个归一化的目标区域坐标 $(x_1, y_1, x_2, y_2)$。沙盒随后裁剪该区域,利用针对电商场景优化的 Marqo-Ecommerce-Embeddings-L 模型生成表征,并基于余弦相似度召回 Top-5 候选。当检索返回的商品存在偏差时,Agent 可以在后续轮次中自主修正裁剪范围或切换聚焦点,构建了从需求理解到视觉空间定位再到商品召回的动态闭环。
EGVS:弥合检索召回与最终挑选之间的鸿沟
在多模态 Agent 的实际运行中,经常出现一种令人惋惜的现象:检索工具其实已经在某一轮成功召回了完全符合条件的商品,但在后续的多步规划或最终生成时,模型却在无结构化的上下文里把正解“遗忘”或误判掉了,最终推荐了一个有缺陷的选项。
为了解决“能搜到却选不对”的问题,研究提出了证据驱动的核验与重选机制(Evidence-Grounded Verification and Selection, EGVS)。
在 Agent 完成上限为 8 步的自主搜索并终止交互后,EGVS 介入处理。它首先收集该轮会话中所有检索步骤产生的候选商品以及 Agent 最初给出的推荐结果,构建全量候选池 $\mathcal{C}$。针对池中的每个候选商品,系统将其多模态证据 $E(c)$(包括主图、结构化属性、SKU 标签和详情页 OCR 文本)与此前从对话历史中推导出的需求规范 $\hat{S}_t = (\hat{I}_t, \hat{R}_t)$ 进行严格比对。
模型在此处切换为自核验模式(Self-Verifier)。需要强调的是,自核验模型完全基于交互历史自行推断的需求进行判断,绝不泄露标注端的 Ground-Truth。通过自核验确认满足全部硬性条件的候选集合记为 $\mathcal{S}$。最终的推荐列表按以下优先级进行有序拼接组合:
\[A = \mathrm{top}_K \big( (\mathcal{S} \cap F) \;\|\; (\mathcal{S} \setminus F) \;\|\; (F \setminus \mathcal{S}) \big)\]这里的排序哲学非常精妙:排在最前面的是最初就被 Agent 看中且通过了证据核验的商品($\mathcal{S} \cap F$);紧随其后的是虽然最初被 Agent 遗漏、但在此次证据核验中证实完全合规的商品($\mathcal{S} \setminus F$);最后如果推荐位尚未填满,才由未通过核验的原始选择兜底($F \setminus \mathcal{S}$)。EGVS 并没有推翻 Agent 的自主判断,而是在固定算力预算内,利用多模态证据对召回结果进行严谨重排与拾遗,显著提升了输出结果的合规密度。
评测标准与实验洞察:开源模型的巨大鸿沟与轨迹微调的奇效
在评测指标上,MMShopBench 引入了双重评估体系:
-
ID@$k$:推荐列表的前 $k$ 项中是否命中了人工标注并核验过的唯一目标商品 ID。该指标极为客观,但相对保守,因为沙盒中可能存在同样符合全部约束但未被人工枚举的合规商品。
-
Judge@$k$:采用冻结提示词与证据 Schema 的多模态裁判模型(评测中采用 GPT-5.5)进行细粒度裁决。裁判模型对照完整的用户图文历史、人工标注意图与全部硬性约束,逐项审查推荐商品的多模态证据。只有在所有约束均有据可循且无矛盾时,才计为成功。
研究对比了包含 Gemini-3.1-Pro-Preview、Claude Opus 4.8、Kimi-K2.6、MiniMax-M2.7 在内的顶尖闭源模型,以及 Qwen3.5 家族不同尺寸的开源模型(9B、27B、122B-A10B)。闭源模型开启 Thinking 模式,而开源模型均在 Non-Thinking 模式下测试。
实验展现出几项极其鲜明且值得技术界深思的结论:
| 模型 | 微调状态 | Judge@1 (%) | Judge@3 (%) | ID@1 (%) | ID@3 (%) |
|---|---|---|---|---|---|
| Gemini-3.1-Pro-Preview | 原始闭源 | 64.7 | 73.4 | 61.4 | 70.2 |
| Claude Opus 4.8 | 原始闭源 | 60.9 | 71.3 | 57.1 | 67.8 |
| Kimi-K2.6 | 原始闭源 | 58.5 | 69.2 | 54.3 | 66.4 |
| MiniMax-M2.7 | 原始闭源 | 57.8 | 68.9 | 53.6 | 65.1 |
| Qwen3.5-122B-A10B | Base (未微调) | 5.5 | 5.9 | 4.8 | 5.9 |
| Qwen3.5-122B-A10B | SFT (本研究微调) | 52.9 | 67.5 | 49.8 | 55.4 |
| Qwen3.5-27B | Base (未微调) | 3.8 | 4.5 | 3.1 | 4.2 |
| Qwen3.5-27B | SFT (本研究微调) | 46.7 | 58.8 | 41.2 | 48.1 |
| Qwen3.5-9B | Base (未微调) | 2.1 | 3.1 | 1.7 | 2.8 |
| Qwen3.5-9B | SFT (本研究微调) | 38.4 | 48.8 | 33.2 | 41.5 |
从实验数据可以看出,真实的多轮多模态导购对未经适配的模型是一堵不可逾越的高墙。在未经微调前,即使是千亿参数规模的 Qwen3.5-122B-A10B,其 Judge@1 仅为 5.5%,几乎无法有效协调多轮图文检索工具。这证明通用的多模态理解与纯文本 Agent 规划能力,在面对真实电商场景时无法直接转化为业务效能。
然而,通过在沙盒环境中利用顶尖教师模型(Gemini-3.1-Pro-Preview)生成的 900 条高质量多模态交互轨迹进行有监督微调(SFT),开源模型的表现发生了根本性蜕变。微调后的 Qwen3.5-122B-A10B,其 Judge@1 飙升至 52.9%(绝对提升 47.4 个百分点),Judge@3 达到 67.5%(绝对提升 61.6 个百分点)。在完全不依赖慢速思考(Non-Thinking)的前提下,其 Judge@3 表现已逼近顶尖商业闭源系统,与最佳闭源成绩的差距被压缩到了 5.9 个百分点之内。即使是 9B 和 27B 的小尺寸参数模型,在 SFT 注入轨迹经验后,也展现出了极强的端到端检索与验证规划能力。
在消融实验方面,验证机制与多模态输入的必要性也得到了确凿的数据支撑:
-
EGVS 机制的有效性:消融表明,引入 EGVS 带来了普遍而稳定的性能增益。以 Gemini-3.1-Pro-Preview 为例,其 Judge@3 在加入 EGVS 后提升了 3.8 个百分点;在开源模型微调版本上,EGVS 帮助模型从检索池中找回了大量被初筛遗漏的合规商品,各模型的 ID@3 与 Judge@3 均有 3 到 5 个百分点的坚实提升。
-
对话图片的不可替代性:当评测强行剥离会话中的用户图片、退化为纯文本设置时,所有模型在同款搜寻与相似推荐用例上的成功率出现了雪崩式下跌,跌幅普遍超过 50%。这有力地印证了 MMShopBench 的核心立意:真实电商导购的核心信息增量正是深植于视觉媒介之中,任何忽视图像输入的评测都无法真实反映导购 Agent 的工业级能力。
对未来智能导购与多模态 Agent 的启示
MMShopBench 的出现,标志着电商领域大模型 Agent 评测正在由“概念验证式的虚拟玩具环境”向“逼近产业真实痛点的深水区”演进。
这项研究给后续的 Agent 研发与商业化落地带来了三点极其明确的启示:
其一,从检索到交付必须建立全模态证据闭环。以往许多系统过度依赖检索模型返回的相关性得分(Score),默认排在前面的就是对的。MMShopBench 的实验证明,在真实复杂需求下,通用召回极易受到视觉表象或单点关键词的欺骗。建立显式的、基于多模态详情(尤其是 SKU 级参数与详情页 OCR 图文)的核验机制(如 EGVS),是消除 Agent 幻觉、保证交付结果可信度的必要路径。
其二,工具调用的“主动视觉引导”至关重要。简单的全图 Embedding 检索在应对用户复杂的现实意图时往往显得力不从心。让 Agent 具备根据对话历史主动输出裁剪区域、动态调整视觉焦点的能力,不仅大幅提升了图像检索的信噪比,更为复杂场景下的视觉指代消解提供了优雅的工程解法。
其三,轨迹级合成数据的巨大杠杆效应。仅用 900 条高质量、由先进闭源模型在受限沙盒中探索出的完整交互轨迹,就能让一个在真实场景下几乎为零分的开源模型提升至可用状态。这表明,对于复杂的多模态工具交互任务,模型的通用参数储备往往已经足够,缺乏的只是如何理解多模态证据输入、如何调度异构检索工具、以及如何反思核验结果的“操作策略”。针对性构建闭环沙盒进行策略轨迹蒸馏,是当前打造高性价比垂直领域 Agent 的最佳捷径。