MemTxn:为Agent记忆引入事务边界,三层契约让F1提升24分
MemTxn: A Transaction Boundary for Source-Supported Updates and Complete-State Recovery in Agent Memory
长期运行的大语言模型智能体(LLM Agent)要想胜任跨会话、跨任务的复杂工作,离不开持久化记忆系统。无论是记住用户的个人偏好、更新日程安排,还是维护正在执行的项目状态,可写记忆(Writable Memory)都是让 Agent 从“单次对话工具”走向“全能助理”的核心基础设施。
ArXiv URL:https://arxiv.org/abs/2607.27834
然而,现有的 Agent 记忆研究几乎把全部精力都倾注在了“如何更精准地检索”和“如何分层存储”上。学术界和工业界普遍默认了一个危险的前提:只要抽取模型提出了记忆更新,底层存储就照单全收;只要发生冲突,就交给生成模型自己在 Prompt 里去权衡。这种做法将极大的不确定性留给了下游:抽取过程中的幻觉、颠倒极性的篡改、以及多键写入时的部分失败,会永久污染持久化数据库。一旦发生错误,错误的记忆会在后续的每次决策中反复发酵,导致整个系统产生连锁退化。
面对这一结构性缺陷,本文提出了 MemTxn。它的核心主张非常鲜明:Agent 的可写记忆不能再被当作随意的键值缓存,而必须建立起严格的“应用级事务边界(Transaction Boundary)”。MemTxn 完全独立于回答模型之外,通过有序补丁测试(Ordered PatchTest)、时间冲突解析器(Temporal Resolver)与持久化快照日志,分别在写入准入、版本可见性与故障恢复三道关口设立契约。在对抗性测试中,它拦截了全部 179 个硬负例写入;在标准基准 MemoryAgentBench 上,相比主流的稠密检索方案(Dense),其事实整合 F1 分数最高提升了 24.07 分。
Agent 记忆的本质隐患:缺乏事务契约
在数据库领域,“事务(Transaction)”是维持数据一致性的基本盘。然而在当下的 Agent 记忆架构中,事务概念几乎是缺位的。即便底层依赖 SQLite 等具备 ACID 物理原子性的数据库,物理层面的“全有或全无”也无法解决应用层面的语义一致性。
具体而言,现有系统面临着两大长期被忽视的瓶颈。
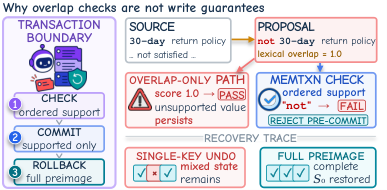
其一是缺乏写入准入审查与无监督的版本可见性仲裁。当大模型从对话中抽取新的事实时,极其容易产生细微但致命的错误。例如,原文表述是“退货政策不支持无理由退款”,模型抽取出的键值却可能变成“支持无理由退款”。这类错误保留了原文几乎所有的词汇,在传统的余弦相似度或词频重合度检索下得分极高,但逻辑极性完全颠倒。更棘手的是,系统在决定是否接受一条写入时,不能依赖下游回答模型的反馈,也不能提前偷看未来的评估问题或金标答案,否则就会发生严重的数据泄露。
其二是多物理键故障下的完整应用状态恢复难题。在复杂的智能体状态中,一次逻辑上的记忆更新往往需要级联修改多个物理键——包括版本号、状态指针、事实键值以及事件重放记录。当系统在写入中途发生故障、或是检测到状态不一致时,简单的“撤销单个键”操作极易导致数据库处于新旧交织的撕裂状态(Mixed State)。更严重的是,当系统重启(Reopen)之后,底层存储根本不知道上层应用原本期望的完整视图(Preimage)是什么。
MemTxn 的突破点在于:它将记忆更新提升为带有明确语义契约的应用级事务。它不修改大模型权重,也不干涉底层存储引擎的物理实现,而是在二者之间架起了一道外部治理层(Governance Layer)。
三道独立治理管线:准入、可见性与恢复
为了从机制上杜绝污染并保证可审计性,MemTxn 将记忆的生命周期清晰地切分为三条互不干扰的治理路径:写入治理、冲突解析治理与审计恢复治理。回答模型的路由逻辑绝不会暗度陈仓地变成写入许可,底层的状态修复也绝不会被误判为应用逻辑的完成。
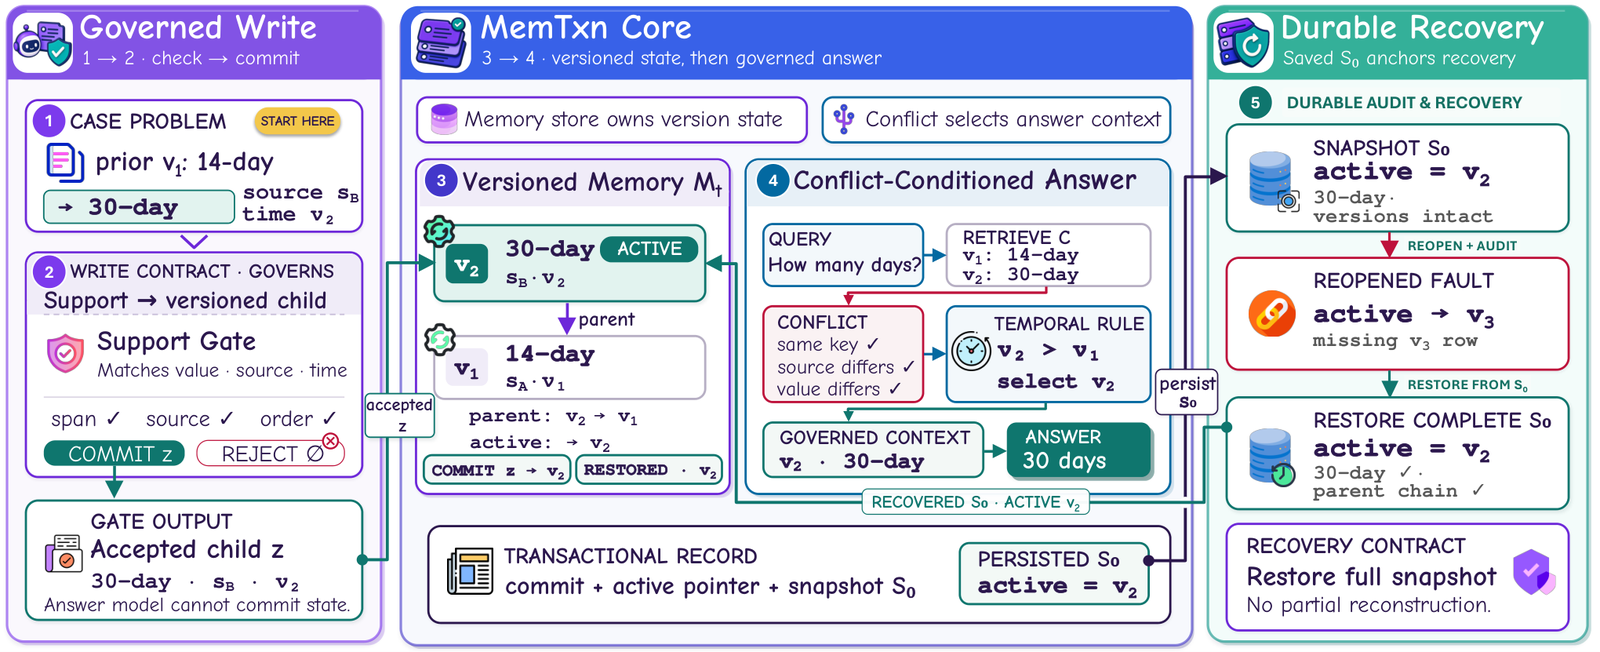
在系统形式化定义中,逻辑时间 $t$ 处的持久化记忆被表示为三元组 $S_t = (\mathcal{V}t, A_t, \mathcal{J}_t)$。其中 $\mathcal{V}_t$ 是只增不减(Append-only)的版本全集;$A_t: \kappa \mapsto \mathrm{vid}$ 是从事实键到具体版本标识符的活动版本映射表(Active Map);$\mathcal{J}_t$ 则记录了持久化的状态事件与恢复意图。智能体在回答问题时能看到的,仅仅是当前活动映射的应用级投影 $\Pi{\rm app}(S_t) = A_t$。基于这套系统模型,MemTxn 构建了三大治理核心。
1. 基于 Ordered PatchTest 的有序写入准入
传统的文本重合度过滤往往设置一个覆盖阈值 $\theta$,只要候选值中的词汇大部分来自原文就予以放行,这极易被词序颠倒或插入否定词的对抗样本攻破。MemTxn 提出了被严格固化的 Ordered PatchTest。
对于提议的更新 $q$,设其规范化内容 token 序列为 $T(v)$,引用的证据文本 token 序列为 $T(e)$,原始输入文档为 $D_s$。准入谓词定义为:
\[\operatorname{Support}_{\rm ord}(q) = F(q) \land Q(e, D_s) \land [T(v) \preceq T(e)]\]其中 $F(q)$ 校验基础元数据完整性,$Q(e, D_s)$ 验证引用的证据片段确实是原始数据源的连续子串,而最关键的核心在于符号 $\preceq$——它强制要求候选值的 token 序列必须作为保序子序列严格嵌套在证据片段中。
这一条件构成了坚不可摧的语法硬约束:如果抽取的记忆试图插入一个没有来源支撑的否定词,或者打乱了修饰词与核心名词的顺序,保序子序列校验就会立即触发失败。未通过校验的提案会被直接丢弃,持久化存储的状态完全保持不变;而一旦通过校验,系统便以原子操作创建新版本并推进指针。
2. 时序解析器驱动的冲突可见性选择
当智能体在不同时间点接收到同一主题的冲突信息时(例如用户上个月说“我不喝咖啡”,今天却说“请帮我点一杯美式”),系统必须决定暴露哪一个版本给模型。
MemTxn 并不依赖模糊的模型自省,而是引入了确定性的冲突触发器与时序解析器(Temporal Resolver)。系统首先对事实键进行规范化,通过主体与关系的 Jaccard 相似度(设定为 0.60 阈值)以及键精确匹配来聚合相关条目;若两个候选条目来源不同且内容存在实质分歧(Jaccard 相似度低于 0.80),即被正式标记为冲突集 $C_\kappa$。
在明确定义了时序契约的场景下,解析器执行以下确定性选择:
\[\operatorname{Resolve}(C_\kappa) = \arg\max_{q \in C_\kappa} \nu(q)\]即在冲突集合中精确挑选出时间戳 $\nu(q)$ 最新的条目,若时间戳相同则依照来源顺序与提案 ID 确定性破局。这种设计将“检索排序”与“事实裁决”彻底解耦:大模型不用再在长 Prompt 中艰难猜测谁真谁假,治理层直接向其提供符合业务时序契约的唯一可见版本。
3. 完整的持久化快照日志与无感知回滚
在持久化故障恢复方面,传统的单一键撤销(Single-key undo)在面对多物理键更新失败时往往束手无策。MemTxn 引入了持久化意图机制。
在发起任何受控的记忆事务 $\tau$ 之前,系统首先在日志中固化当前的活动指针映射快照 $A_0 = \Pi_{\rm app}(S_0)$ 以及待执行的意图。当更新执行完毕且数据库重启得到状态 $S_1$ 后,系统会自动校验状态不变量 $I(S_1)$,涵盖指针有效性、键一致性与事件可重放性。一旦发现应用投影偏离 $A_0$ 或不变量被破坏,回滚逻辑即刻启动:
\[\operatorname{RB}(\tau) \iff \operatorname{PersistIntent}(A_0) \land \operatorname{Reopen}(S_1) \land \bigl([\Pi_{\rm app}(S_1) \neq A_0] \lor \neg I(S_1)\bigr) \land \operatorname{Restore}(A_0) \land \operatorname{Reopen}(S_2) \land I(S_2) \land \Pi_{\rm app}(S_2) = A_0\]通过这种基于快照的补偿事务,MemTxn 无需知道底层物理写入到底触碰了哪些具体的键(Write-set Independence),便能将整个应用可见的活动图谱完整还原,且在再次重启后依旧能通过全部一致性检查。
严苛评测:对抗性负例与多键故障下的绝对防御
为了验证这套事务边界的有效性,研究团队设计了一系列极具对抗性的实验,涵盖端到端 API 治理、对抗性写入准入审计、基准问答时序整合以及持久化故障恢复四个维度。
在端到端 API 测试中,研究人员在 GPT-5.3-Codex-Spark、GPT-5.4-mini 和 GPT-5.4 等多种顶尖模型端点上构建了涵盖有效写入、非法写入与旧任务状态保留的 100 组受控案例。实验显示,MemTxn 在合法更新通过率和非法更新拦截率上均取得了 1.0 的满分,并在旧任务记忆保留率上达到了 0.992;作为对比,传统的检索方案(Retrieval)在受到干扰后仅能保留 0.225 的旧任务状态,而普通的多版本方案(Versioned)保留率甚至直接跌落至 0。
在独立于训练集的写入准入审计(Item-disjoint Source-Support Audit)中,测试集包含了来自真实对话抽取的 60 个合法原始更新,以及 179 个极具欺骗性的硬负例(通过否定词插入、词序颠倒和跨文本实体替换精心构造)。对比基准包括基于无序词袋覆盖率的阈值策略(固定阈值与校准阈值)。
测试结果呈现出断层式差距:
-
Ordered PatchTest 达成了 100% 的准确率、精确率、召回率与 F1 分数,不仅毫无遗漏地接纳了全部 60 个合法原始样本,还将 179 个精心伪装的硬负例全数拦截,误判率为零。
-
反观所有的词袋覆盖对比方案,均出现了不可接受的系统性误报。即便是调校到最佳表现的基线模型,也错误地放行了多达 49 个攻击样本;有的基线误放行样本甚至超过百个。这强有力地证明了:在记忆写入的准入把关上,无序的词汇统计完全无法识别颠倒黑白的语义篡改,必须依赖保序子序列的硬性约束。
在故障恢复维度,实验对源自 LongMemEval-S 的 58 个历史记录和 LoCoMo 的 10 组长对话施加了四类持久化故障,受影响的物理键在 2 到 16 个之间不等。面对跨多个键的物理状态破坏,传统的单键撤销完全瘫痪,留下了大量指针悬空、版本失联的混合撕裂状态;而 MemTxn 在完全不知道物理写入集合的前提下,成功实现了 100% 的完整应用前像恢复,其恢复质量与拥有特权信息的“写入集先验模型(Write-set Oracle)”完全一致。
事实整合性能跃升:超越 Dense 检索逾 24 分
将治理层落实到下游问答任务中,MemTxn 的收益同样显著。在评测智能体动态更新能力的权威基准 MemoryAgentBench FactConsolidation 任务上,评测要求智能体在接收到一系列冲突陈述后,能够始终以最新声明为准来回答问题。
所有参与评测的方法均采用完全一致的提示词与单次回答调用,MemTxn 带来的改变仅仅是利用其时序解析器重构了上下文的版本可见性。
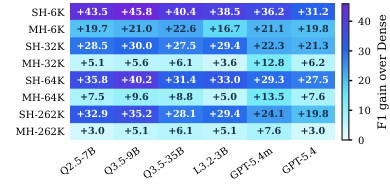
从涵盖不同跳数(Hops)与上下文长度的系统性评测中,可以看到全局性的性能跃升:
-
在所有被测试的十二种回答模型配置下,MemTxn 均取得了全场最高的平均 F1 得分。
-
在五种具有代表性的主力模型测试中,MemTxn 相较于通行的稠密检索基线(Dense),F1 分数的净提升幅度达到了惊人的 17.06 至 24.07 个绝对百分点。
-
即便是在控制检索预算、两边均严格匹配 Top-8 上下文片段的严苛控制组中,MemTxn 依然稳稳保持了 15.01 至 22.93 点的净胜优势。
这一结果击碎了一个常见的工程偏见:许多人认为长上下文大模型已经足够聪明,只要把带有时序信息的文档通通塞进 Prompt,模型就能自己理清线索。实验数据证明,面对庞大而混乱的对话历史,未经版本仲裁的原始文本块会对大模型产生严重的注意力干扰,导致其频繁出现“新旧混淆”。MemTxn 在外部先期执行确定的时序版本解析,本质上是把原本极其脆弱的隐式上下文推理,转化为了确定性的外挂事务保障。
消融实验进一步证实了各个组件的不可或缺性。如果去除 Ordered PatchTest,系统的写入准入检测能力瞬间崩塌;如果拿掉快照日志,旧任务的持久化恢复直接归零。只有三者协同运作的完整 MemTxn,才能在承受连续 1,000 次剧烈状态更新的压力测试下,依然保持整体事务成功率、故障检测率和任务保留率全线拉满。
重新定义 Agent 基础设施的边界
MemTxn 的提出,标志着智能体记忆系统的研究视角正在发生重大转变:从单纯追求高召回的“算法思维”,转向强调确定性保障与可恢复性的“系统架构思维”。
在过往的认知中,人们习惯于将智能体犯错归咎于基座模型的理解力不足,进而不断用更昂贵的抽取模型、更复杂的提示工程去填补漏洞。但现实证明,在持久化状态维护这种严肃场景下,概率模型永远存在不可消除的扰动与幻觉。如果把这些带有概率瑕疵的状态不加节制地写入持久化存储,整个智能体系统迟早会因为状态腐化而崩溃。
MemTxn 划定了一条清晰的工程红线:大模型负责理解与提案,但提议的状态能否变成持久事实,必须通过形式化的事务边界由确定性契约裁决。保序检查堵住了语义漂移的缺口,时序解析清除了回答时的干扰噪声,而应用级快照恢复则为不可避免的系统故障提供了兜底的安全网。
当然,MemTxn 目前的契约设计仍有其明确的边界。正如作者在文中所坦陈,它解决的是“引文一致性”与“时序可见性”,而非“世界事实真伪性”;同时它假设恢复意图本身未遭物理损坏,尚未覆盖大规模并发事务写入的锁机制设计。但无论如何,MemTxn 为业界提供了一个极其有价值的架构范本:赋予 Agent 记忆系统以真正的“事务边界”,才是长程大模型智能体迈向高可用、工业级落地的必由之路。