DocOps:最强Agent拿下67%即见顶!210个任务测出文档操作三大软肋
DocOps: A Verifiable Benchmark for Autonomous Agents in Complex Document Operations
让大语言模型(LLM)驱动的智能体(Agent)去操作日常办公文档,听起来似乎早已不是新鲜事。从撰写分析报告、整理电子表格,到调整幻灯片格式,大量落地应用都将办公自动化视为大模型最容易变现的核心场景。然而在实际工作流中,许多体验过此类系统的工程师和分析师往往会发现一种诡异的脱节感:模型在对话框里言之凿凿地宣布“已为您更新公式并对齐样式”,但真正打开生成的 .xlsx 或 .docx 文件时,要么隐藏单元格的联动引用链已经断裂,要么原本精心维护的母版样式被粗暴重置成了纯文本。
ArXiv URL:https://arxiv.org/abs/2607.19865
这种现象暴露出当前智能体在处理真实世界数字工件时的根本缺陷:它们往往把文档当成一种一次性写入的扁平文本载体,而不是一种具有严密内部依赖与层级状态的计算对象。
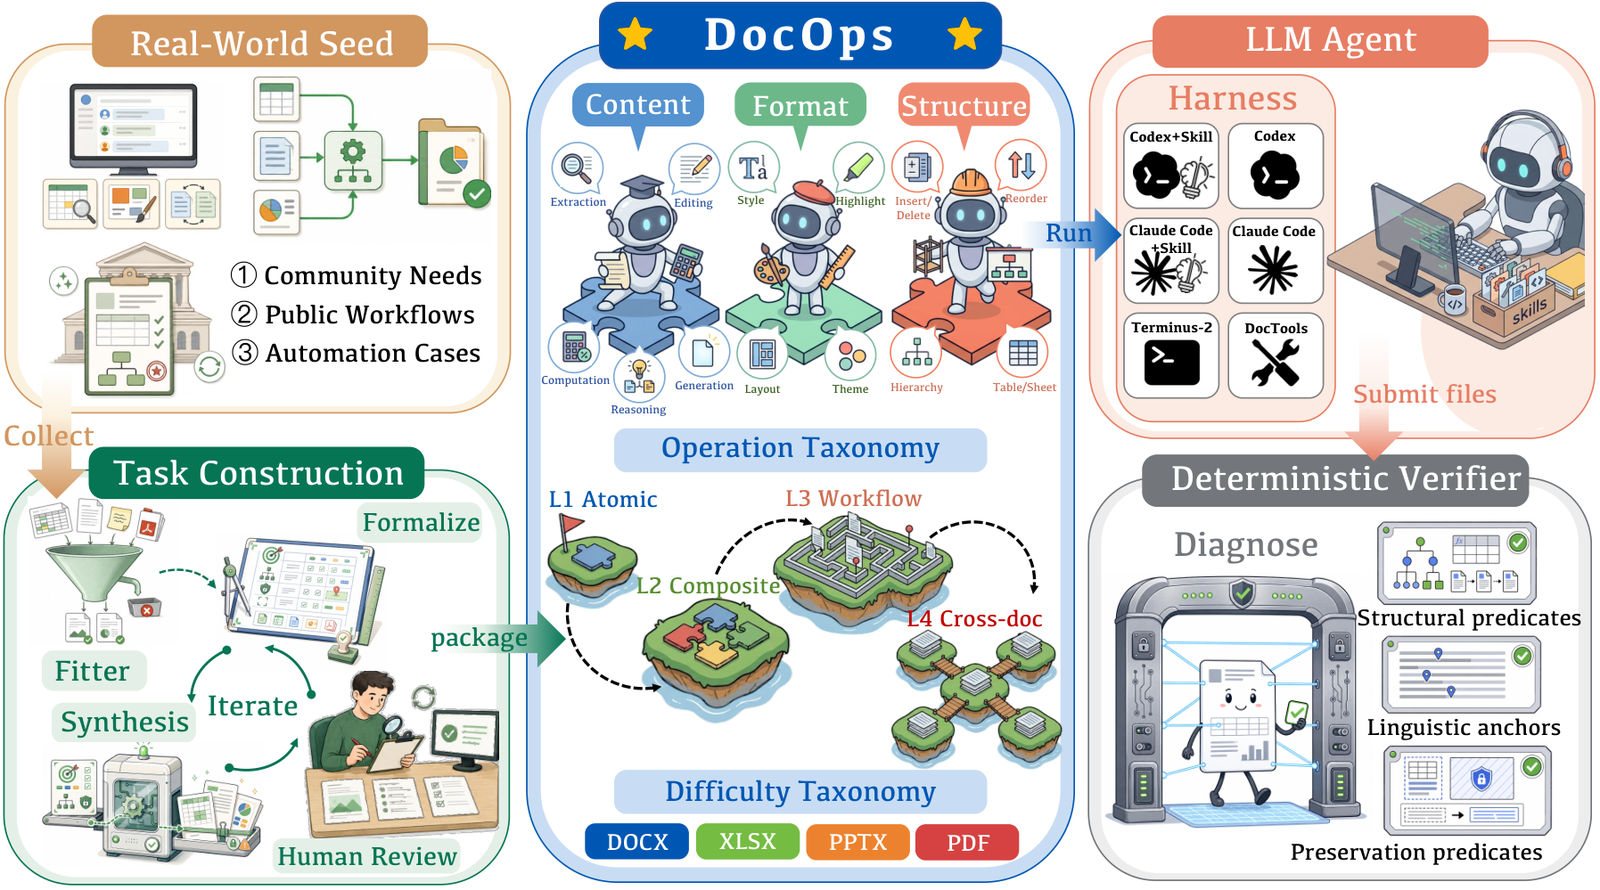
针对这一痛点,中国科学院信息工程研究所等机构的研究团队提出了名为 DocOps 的可验证基准测试框架。该框架将真实办公场景中的文档操作拆解为多层级的能力维度与工作流梯度,并引入了严格基于原生文档结构的代码化确定性验证机制。在对包括前沿闭源旗舰(如 GPT-5.5、Claude Sonnet 4.6)与主流开源模型(如 DeepSeek-V4-Pro、Qwen3.6 系列)的系统评测中,即使是目前最强的配置(GPT-5.5 搭配 Codex 运行环境与专用技能),整体任务成功率也仅有 0.671。当任务推进到高耦合的长程多文档工作流时,智能体的表现甚至呈现断崖式下跌。
这项研究不仅撕下了文档类智能体“看似全能”的表面包装,更通过详尽的执行轨迹溯源,确立了阻碍智能体走向深层办公自动化的三大约束。
将文档视为具身状态对象:DocOps 的双轴分类学
过去的文档智能评测大多游走在两个极端。一类是静态理解评测(如 DocBench、DUDE),本质上是将文档视作只读的知识库,考察模型的跨模态抽取与问答能力;另一类是偏向操作系统或软件调度的宏观工作流评测(如 OfficeBench、OdysseyBench),文档在其中仅仅是应用间流转的瞬态载荷。这两类范式都忽略了文档本身作为“第一类计算对象”(First-class computational object)的核心属性——修改一个段落的大纲级别,可能会破坏自动目录的索引;改动一张表格的行高或合并单元格,可能导致相邻区域的数据校验失效。
为了精确诊断智能体究竟是在哪一步操作中丧失了对文档的掌控,DocOps 构建了一个正交的双轴分类框架,由“操作原子维度”与“工作流深度梯度”共同构成。
在操作维度上,DocOps 将文档交互解构为三个强相关的底层层次:
-
内容层(Content):文字、数据、图形等实体信息的增删改查;
-
格式层(Format):字体、排版、边框、颜色等局部渲染属性的映射;
-
结构层(Structure):计算公式、大纲层级、工作表关联、目录索引等隐式逻辑约束。
在深度梯度上,基准设计了由浅入深的四级复杂度:
-
L1(原子编辑):单维度、局部的确定性改动,如修改特定单元格数值;
-
L2(复合编辑):跨越内容与格式的多维度协同改动;
-
L3(单文档工作流):长程、多步骤的任务链,后续步骤高度依赖前序步骤的中间状态;
-
L4(跨文档工作流):横跨不同格式(如从 Excel 提取动态聚合数据并嵌入 Word 或 PDF 报告)的复杂系统任务。
目前 DocOps 包含了 210 个精心设计的评测任务,每个任务均封装为自包含的容器镜像包,内含原始工件、自然语言指令、可选工具集以及对应的代码验证脚本,为智能体的交互评测提供了标准化的隔离沙盒。
告别“大模型当裁判”:拒绝虚假繁荣的确定性验证器
长期以来,文档生成与编辑评测面临的一大顽疾是验证手段的模糊性。由于用户指令允许存在多种不同的排版和操作路径,很多基准测试要么退回到粗粒度的“端到端重构相似度”(Round-trip reconstruction),要么依赖大模型作为裁判(LLM-as-a-judge)。然而,大模型裁判极易被“看起来差不多”的外观所欺骗,完全无法感知文件底层那些不可见的隐式损坏。
DocOps 彻底摒弃了启发式或模型打分,而是借助原生的文档解析库(如 openpyxl、python-docx、pypdf 等),构建了完全基于规则的容器内确定性验证器(Deterministic target verifier)。验证器内部包含了三套互为补充的断言逻辑:
-
结构谓词(Structural predicates):深入文档原生对象树,校验可执行公式语法、父子层级引用与大纲树拓扑,专门揪出那些“肉眼看着没坏、内部其实已报错”的结构暗伤;
-
语言锚点(Linguistic anchors):结合特定诊断关键词与上下文正则匹配,在确保语义准确性的同时,为合理的文本表达变化预留自由度;
-
保护性谓词(Preservation predicates):这属于 DocOps 最具辨识度的机制。它专门针对那些“不应被修改”的范围设置校验点。例如,指令要求修改工作表 A,保护性谓词会强制检测工作表 B 的公式和原文档特有的单元格样式是否完好无损。
为了验证这套验证体系本身的可靠度,研究人员开展了双重应力测试。在对 128 个真实样本的人工盲测审查中,自动化验证器与计算机专业博士的人工判断达成度达到了 95.31%;而在针对 36 个标准文档引入的 180 处受控损坏测试(变异注入)中,该验证器精准识别出了 96.67% 的隐蔽错误。这种精准定位缺陷的能力,为后续大规模测试提供了可信的证据链。
前沿模型试金石:面对高耦合工作流时的集体承压
在统一的基准下,DocOps 对当前闭源和开源阵营中最具代表性的模型进行了一次全面摸底。实验覆盖了包括 Claude Code、Codex 脚本执行器、Bash 终端(Terminus-2)以及结构化专用文档 API(DocTools)在内的四种主流运行脚手架(Harness)。
从宏观整体表现来看,当前的智能体架构距离真正的“无痛自动化”依然存在巨大鸿沟。
即使是表现最顶尖的配置组合——GPT-5.5 在 Codex 脚本环境配合官方技能(Skills)辅助下,全量任务的平均通过率也仅停留在了 0.671,意味着仍有近三分之一的日常办公指令无法被正确或安全地执行。而在开源阵营中,表现最好的 Qwen3.6-27B 在 Terminus-2 环境下的通过率为 0.476,中等参数规模的开源模型在应对深层次的文档控制时普遍吃力。
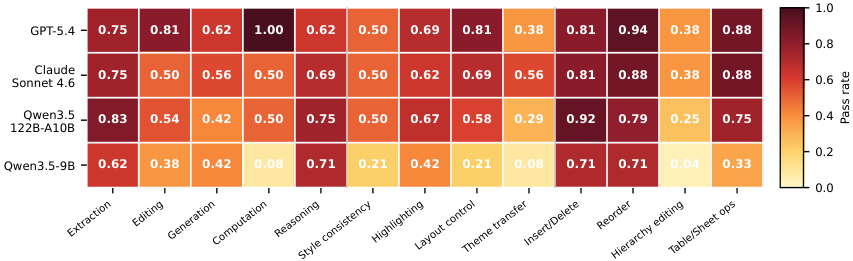
更为深刻的启示隐藏在难度与格式的交叉分析中。随着任务从 L1 向 L4 递进,模型的任务完成率并非平缓下降,而是受制于格式内部状态的“耦合度”(Coupling)。
数据表明,Excel 类任务的完成难度远超其他格式。因为电子表格中的单元格并非孤立存在,每一个跨行汇总、数据验证规则和公式计算都构成了严密的依赖图谱。一旦前序步骤引入微小偏差,后续步骤将发生全局连锁崩溃。在最复杂的 L4 级 Excel 工作流中,许多前沿模型的通过率甚至急剧萎缩至接近零点。相比之下,PDF 等格式在结构上更倾向于松散的内容追加或覆盖,组件间的隐式约束较少,模型在长程任务中反而维持了相对坚挺的通过率。这一落差清晰地证明:智能体的核心瓶颈并不只是步骤数量的多寡,而是面对状态强耦合系统时管理上下文副作用的能力。
剖析三次坍塌:智能体处理文档的三大致命软肋
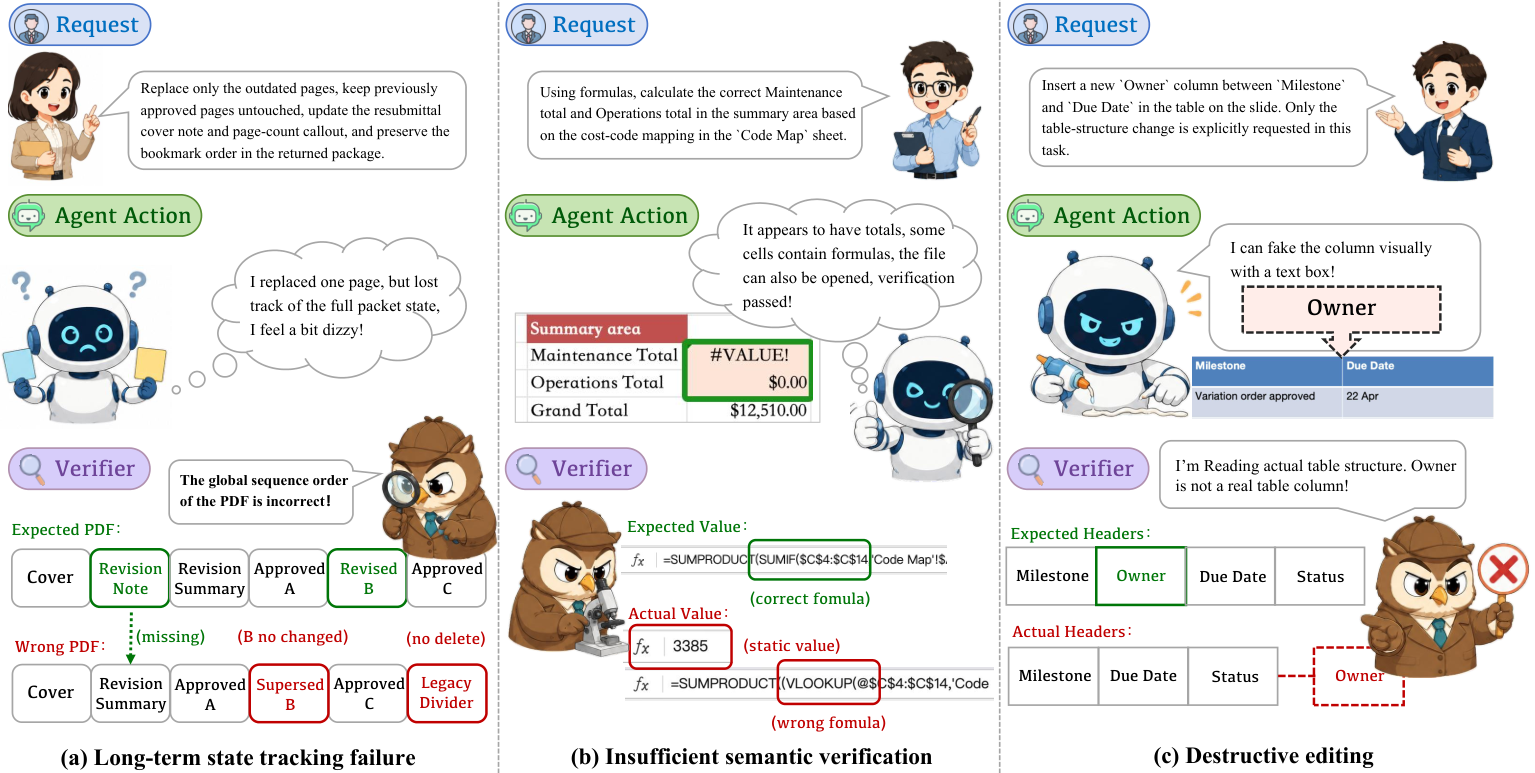
基于验证器捕获的大量报错堆栈与执行轨迹,研究团队进一步还原出了智能体在操作复杂工件时最常陷入的三种本质缺陷。
第一,长程状态跟踪的全面崩溃(Long-term state tracking collapse)。在需要多次读写、跨表引用的多步骤任务中,智能体极易被长上下文中的过载信息带偏。它们通常能把第一步的指令执行得十分完美,但在执行第三步或第四步时,往往会完全遗忘第二步所做出的全局状态变更。例如在多表合并任务中,智能体常常用原始未清洗的数据直接覆盖掉刚刚建立好引用关系的清洗表,展现出对中间状态记忆的严重割裂。
第二,浅层语义验证的盲目乐观(Shallow semantic verification)。这是引发失败最普遍的原因。由于大语言模型在本质上依赖语言模式匹配,智能体非常倾向于执行“表面看似合理”的编辑。例如在生成财务统计时,模型可能通过 Python 脚本计算出一个看似精确的值并硬编码(Hardcode)填入单元格,却完全忽略了提示词中“必须使用动态公式(如 SUMIFS)关联指定数据区域”的明确规则。在智能体的自我复查步骤中,只要看到该单元格有数字,它便会草率地认为任务已成功,缺乏对底层计算语义与契约规范的自省意识。
第三,对结构元数据的破坏性编辑(Destructive editing)。智能体在没有完备上下文感知的情况下,往往会采用极其原始且粗暴的降级策略来规避代码报错。在需要调整 Word 局部样式时,有些智能体会干脆把整个文档的 XML 树清空,重新按纯文本写入一段未格式化的字符串;在修改 PowerPoint 文本框时,则会随意删掉底层的母版占位符,导致整套幻灯片的主题色与字体排版瞬间溃散。这种“为了完成局部修改而摧毁全局结构”的降级编辑,在实际办公协作中往往是致命的。
脚手架的启示:代码交互与外部技能的真实边界
除了底层大模型本身的能力,DocOps 的消融实验还揭示了执行脚手架(Harness)对智能体效能的决定性作用。
评测显示,完全可编程、带文件系统反馈的代码化环境(如 Codex 或 Claude Code),其表现全方位碾压了静态 RPC 风格的结构化工具调用(DocTools)。在 DocTools 这类预设固定 API 的环境中,智能体只能在有限的工具原语内碰运气,一旦遭遇 API 未覆盖的冷门属性,便彻底束手无策;而在开放的 Python/Bash 脚本环境中,模型可以借助现有的丰富开源生态自由编排逻辑,即使报错也能根据标准错误输出(stderr)进行原地调试与回溯。不过这种灵活度也带来了高昂的资源代价:在测试中,交互式代码脚手架往往会引发数十轮的交互与自我修正,所消耗的 Token 数量和执行延迟数倍于轻量级工具。
与人们直觉相违背的另一个发现,存在于外部技能模块(Skills)的注入效果上。
在许多工业级 Agent 框架中,开发者习惯于在系统提示词中塞入详尽的领域最佳实践(如针对各类 Office 文档的专属函数模板与规范流程)。实验结果却表明:技能注入是一把双刃剑。
对于 Qwen3.5-27B 这类中等梯队的开源模型,明确的步骤指导能够提供宝贵的归纳偏置,显著修正其调用库时的参数幻觉,带来 6 至 7 个百分点的性能提升。然而对于能力极强的前沿闭源模型(如 DeepSeek-V4-Pro 或 GPT-5.5),注入预制技能带来的收益却极其微弱,在部分任务中甚至出现了负增长。
深入执行日志后可以发现,预制的静态技能往往会演变成一种“认知枷锁”。当前沿模型面对非典型或高度定制化的边缘文档任务时,它本可以通过灵活的零样本原生编码解决问题,却因为系统提示中对特定 API 流程的过度规约,被困在了死板的预设步骤中反复试错,反而限制了模型的发散解题能力。
迈向具有状态意识的文档协同智能
DocOps 的价值不仅在于提供了一个包含 210 个可复现任务的高难度评测集,更在于它向行业明晰了一个关键趋势:面向下一代工作流的 Agent,其评测逻辑与工程架构必须经历一次范式转移。
单纯让模型背诵 API 接口、或者依赖大模型自身主观打分来粉饰太平的时代正在过去。文档不是一段静止的文字,而是一套充满了状态依赖、排版契约与计算拓扑的数字生态。在这样的环境中,成功的标志绝不仅是“执行了用户的动作”,更是“在达成局部诉求的同时,对整个系统的原有状态维持无损”。
从工具调用的盲目尝试,到对全局状态图谱的精确建模;从粗粒度的外观满足,到严格遵守底层计算契约的非破坏性操作——DocOps 划定的这道技术水准线,正在为未来的企业级 Agent 系统指出一条更为务实、严苛但也更具确定性的演进路径。