FilmBench:首个电影级视频生成评测基准!拆解38项专业视听语言
FilmBench: A Film-Grade Benchmark for Cinematic Video Generation
视频生成模型的演进速度令人惊叹。从早期的模糊像素块,到如今能够生成十余秒高保真、支持运镜控制乃至音画同步的画面,AI 生成的内容似乎正在无限逼近真实的影视工业片段。在各类公开排行榜上,主流大模型的各项指标动辄逼近满分,展现出一派“通用视频生成已然攻克”的繁荣景象。
ArXiv URL:https://arxiv.org/abs/2607.24241v2
然而,一旦将这些模型生成的片段放进专业影视制作流水线,交给前线导演和剪辑师审视,结果往往是迅速遭遇否定。原因在于,现有评测基准大多停留在“画面是否清晰、动作是否顺畅、文本是否粗略对齐”这一通用层面上。在真正的电影工业中,衡量一段影像合不合格的标准不是简单的物理画质,而是历经百年沉淀的电影视听语言(Cinematic Language)——从景别、运镜轨迹、视线与机位角度,到构图法度、光影基调、场面调度以及跨镜头的时空剪辑连续性。
为了打破这种“榜单高分与专业弃用”的割裂状态,阿里巴巴联合北京电影学院导演系师资团队以及互鲸数智影视团队,共同推出了首个面向影视专业标准的基准体系——FilmBench。该工作不仅摒弃了传统的网络随机 Prompt 与通用大模型打分,更是首次将学院派电影视听语言系统化地转化为可量化、可自动评估的 38 项核心指标,并开源了底层的视听语言专用算子库 FilmOps。
现有基准的三大结构性盲区
回顾过去几年视频评测的发展脉络,从早期的分布统计指标(如 FVD、IS),到以 VBench 为代表的细粒度通用评测,再到针对物理常识、长视频或多镜头的一系列专项测试,学术界一直在尝试量化视频生成的质量。然而,站在专业影视创作的视角下,现有评测体系依然存在三个不可忽视的结构性盲区:
第一,Prompt 来源与影视创作现实严重脱节。主流基准的提示词大多抓取自网络论坛、公开数据集的简短字幕,或是依靠大语言模型通过特定模板机械扩写。这类提示词往往堆砌了“超高清、8K壁纸、大师级光影”等自欺欺人的泛化词汇,却缺乏电影分镜头脚本中不可或缺的景别、机位、主体运动轨迹与叙事动机。
第二,评测维度未能覆盖视听语言核心。大多数基准的评估维度停留在单帧美学(如画面锐度、饱和度)和基础动作合理性上,或是将极其复杂的综合审美粗暴压缩为一个孤立的分数。电影工业极为看重的人物视线匹配、轴线规则、光影情绪一致性、演员微表情表演以及镜头切换的流畅度,在传统指标中几乎全部缺席。
第三,测试样本局限于孤立单镜头。电影是镜头的组接艺术,真正的制作挑战在于镜头与镜头之间的空间、逻辑与视听连贯性。现有评测绝大多数测试的是单镜头(Single-shot)生成,无法检验模型在面对真实拍摄分镜表时,处理多镜头(Multi-shot)调度与剪辑点的叙事能力。
这导致现有评测基准迅速饱和,模型在纸面数据上展现出“几乎封顶”的假象,但专业导演在实际使用时,依然无法将其作为生产力工具。
逆向工程:让每条 Prompt 都锚定经典电影真片
为了让测试基准真正具备影视级水准,FilmBench 采取了一种反常规的数据构建逻辑:不是凭空编造提示词,而是从影史经典作品中逆向工程(Reverse-Engineering)出结构化分镜脚本。
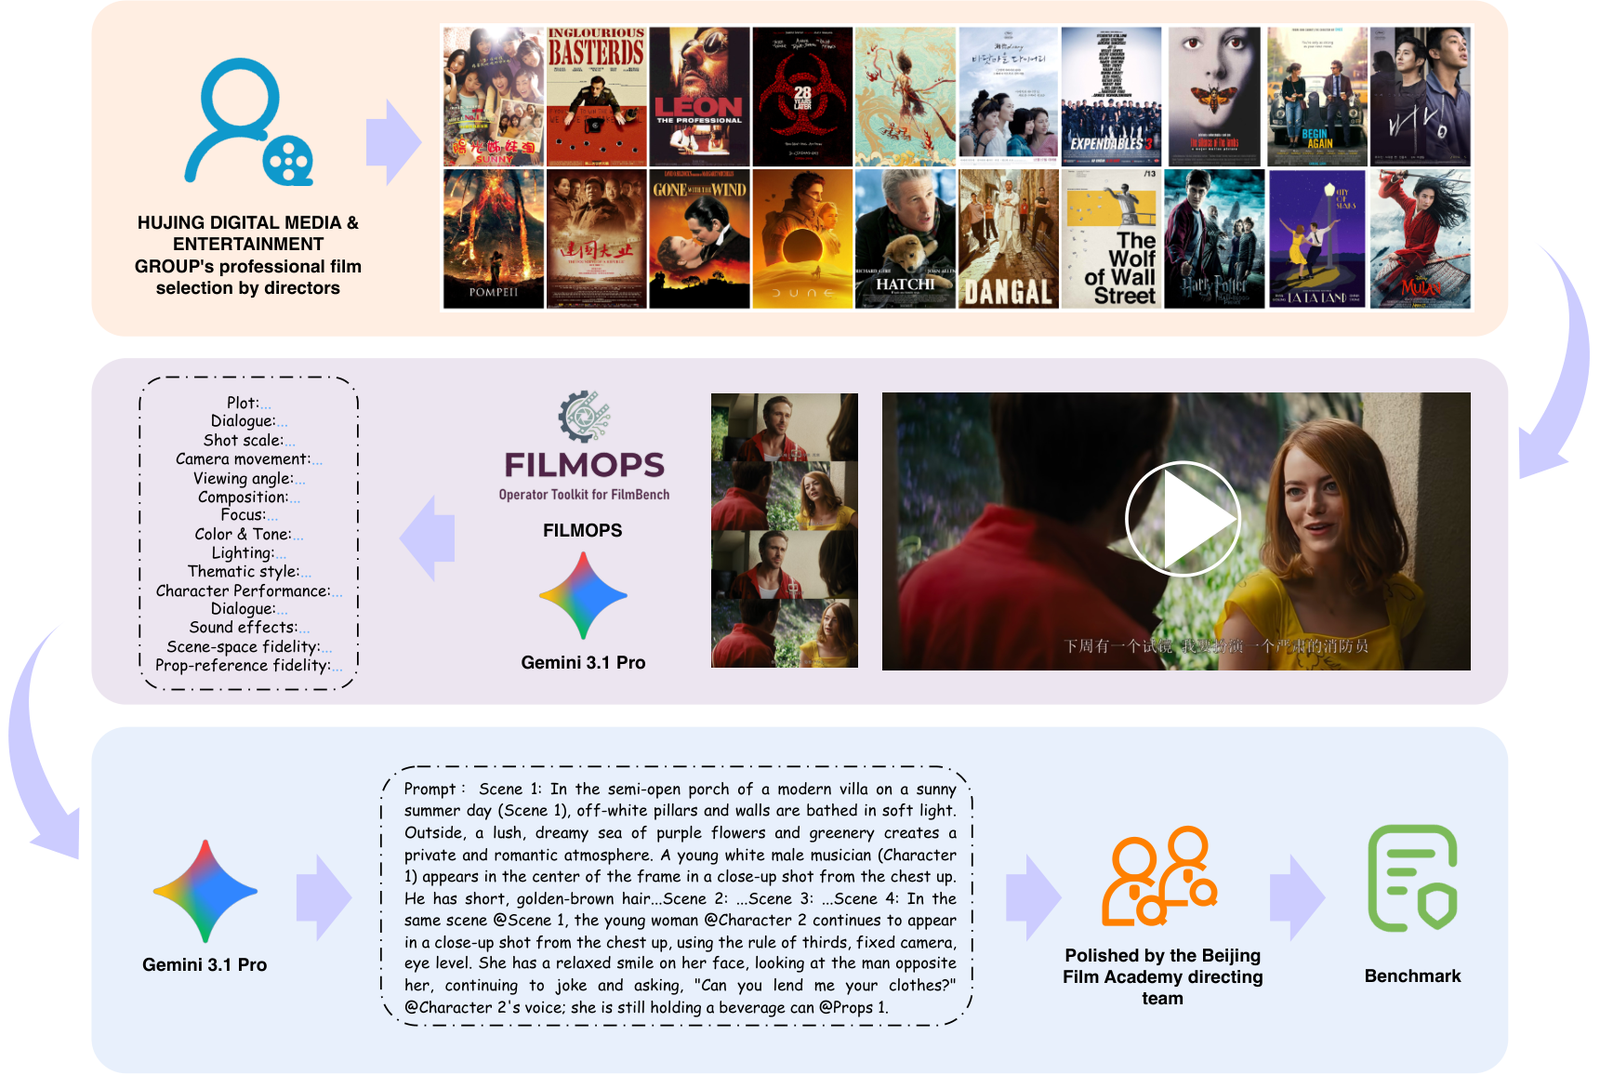
整个构建流程由专业影视团队深度介入,分为三个阶段:
首先是专业镜头筛选。来自北京电影学院和影视制作公司的导演团队,在覆盖动作、科幻、悬疑、剧情、文艺等 20 个主流电影流派的获奖片库(涵盖奥斯卡、金马奖、百花奖等)中,精心挑选出具有极高视听语言表现力与拍摄难度的多镜头片段,绝大多数片段包含 4 个镜头以上。
其次是草稿逆向抽取。研发团队结合专用视听算子与高阶多模态模型 Gemini 3.1 Pro,对真片镜头中的视听要素进行反向解构,逐一抽离出叙事脚本、镜头景别、运镜轨迹、构图方式、光线色调以及人物表演指令,拼装成初步的结构化 Prompt。
最后是学院级专业重写。北京电影学院导演团队对每一条生成的 Prompt 进行逐字精修和格式标准化,严格将其转化为工业级的分镜头语言。提示词显式打上影视级标签,明确规定了镜头序号、景别、机位、构图规则、场景标识(@scene)、角色标识(@role)与道具标识(@prop)。
通过这种方式,FilmBench 共构建了涵盖文生视频(T2V)和参考图生视频(R2V)两大任务的高质量评测集。在全部 1,169 条提示词中,有 1,056 条均为多镜头分镜脚本,且每条提示词都存在一个真实拍摄的影史获奖镜头作为绝对的 Ground-truth 参照,彻底杜绝了空泛的“AI 自嗨式”描述。
学院派三级视听语言体系与 FilmOps
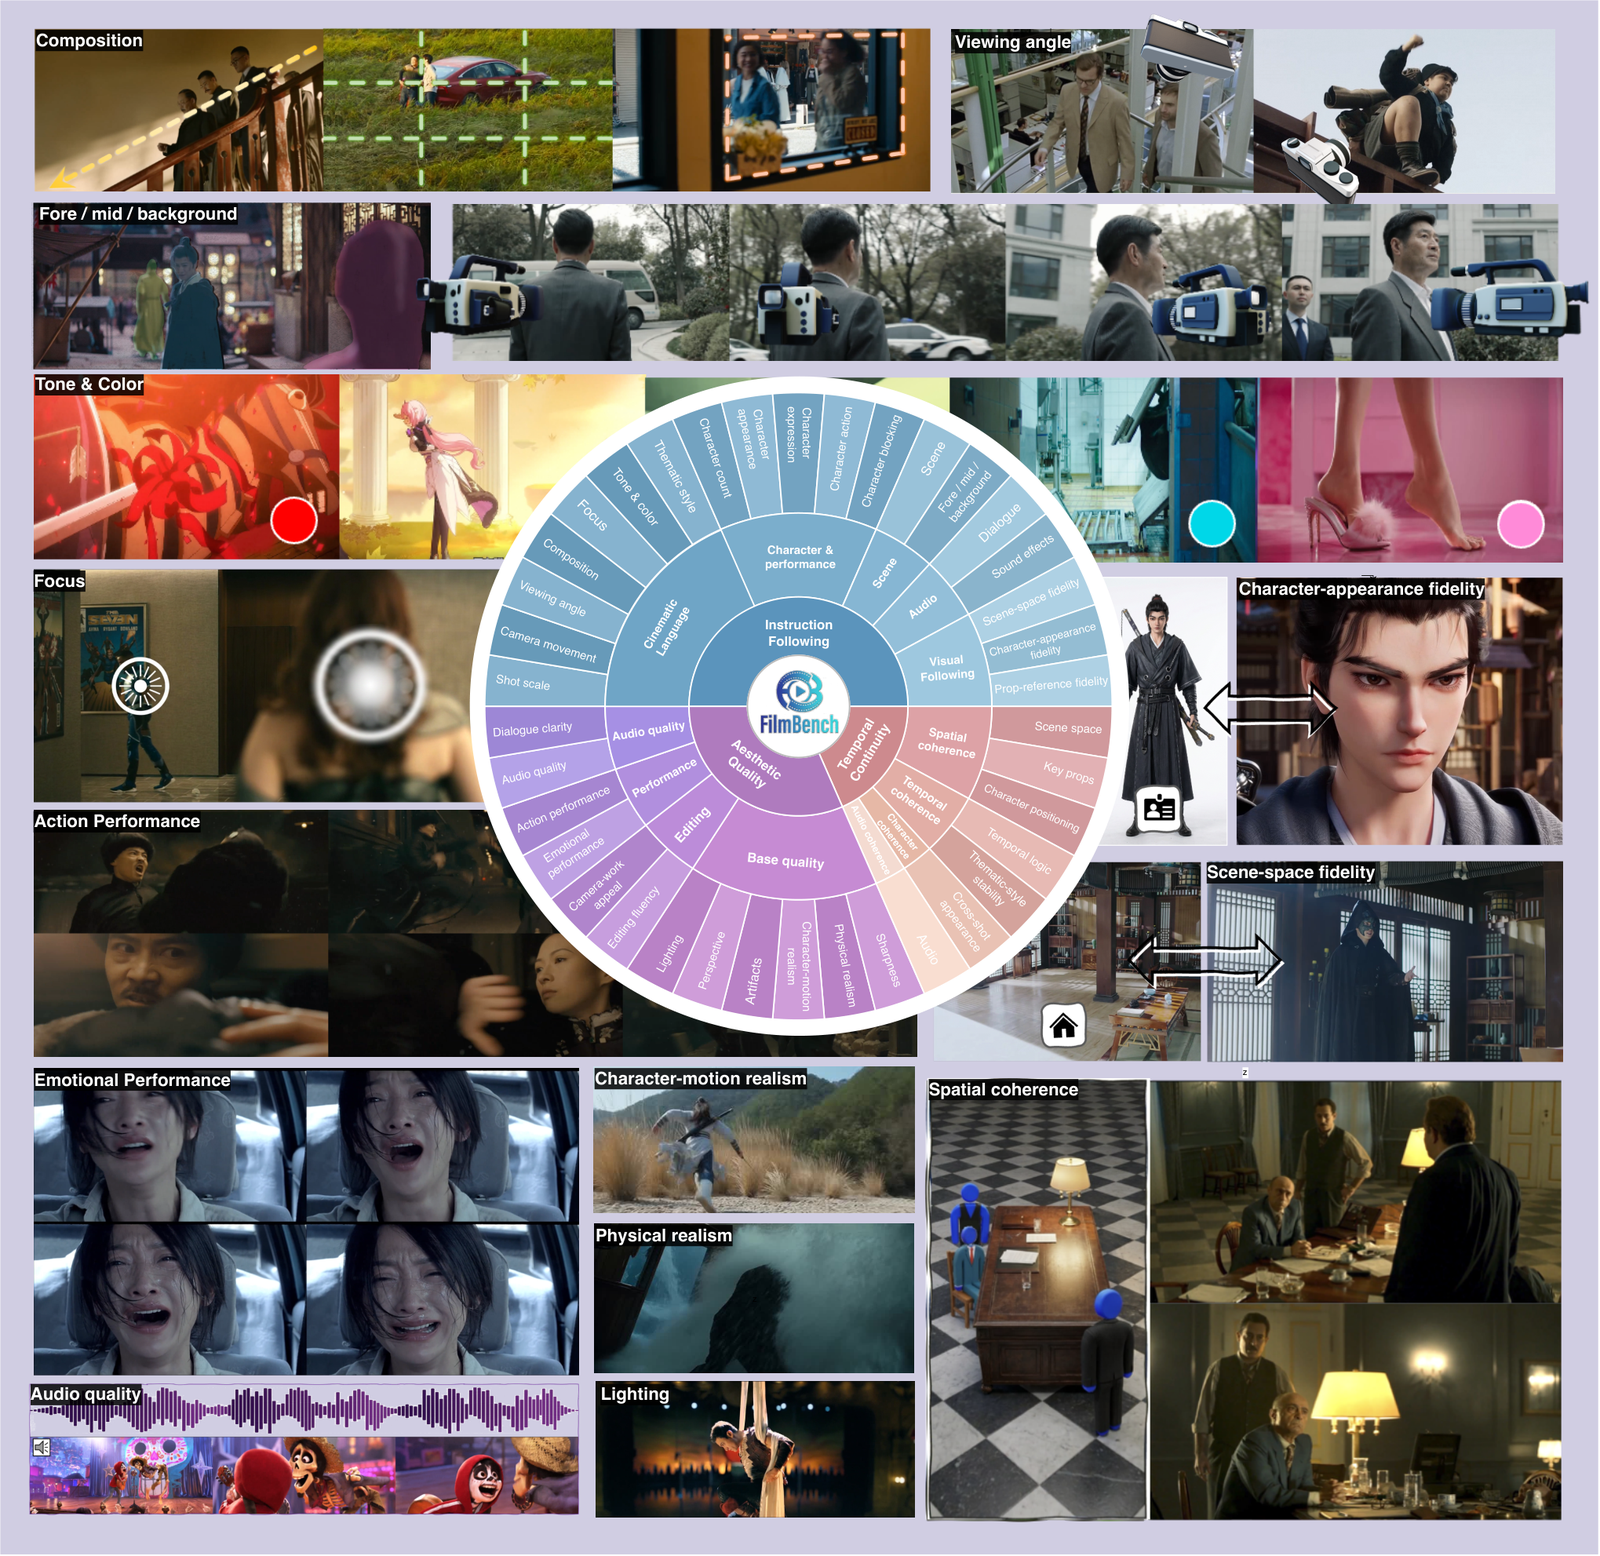
在评测体系的设计上,FilmBench 严格遵循了北京电影学院的视听语言教学与工业制作标准,搭建起一套“3 大一级轴向(L1)— 12 个二级维度(L2)— 35+3 项三级细粒度子指标(L3)”的立体评估架构:
-
指令遵循(Instruction Following):不仅考察传统的场景、角色、道具和声音是否被生成,核心在于视听语言遵循度,细化为景别控制、运镜轨迹、拍摄视角、构图法则、焦点变化、色调氛围和主题风格 7 个具体子项。
-
时空连续性(Temporal Continuity):用于衡量生成内容是否是一部真正连贯的“电影”,划分为空间连续性、时间动作连续性、角色一致性以及跨镜头的音频连贯性。
-
美学质量(Aesthetic Quality):打破单一的静态美学,细拆为基础画面质量、剪辑流畅度与运镜美感、情绪与肢体表演质感,以及影视级音频表现力。
-
视觉参考遵循(Visual Following,R2V 专属):在参考生视频任务中,增设对参考场景空间、角色外观特征和关键道具的精准还原度考核。
为了能够自动且精准地评测上述极为专业的电影指标,研究团队并未直接依赖未经微调的商用通用大模型,而是自研并开源了专业视听语言算子库——FilmOps。
通用多模态大模型在日常物体识别上表现优异,但在辨别“过肩中景”、“荷兰式倾斜视角”、“三分法与向心构图”以及复杂的“推拉摇移甩”综合运镜时极易出现专业性误判。FilmOps 针对这些行业特有概念,基于 5,000 多部影视作品中抽取的数万个高标准标注切片进行了专门训练。
针对单帧维度的景别、构图、角度等几何与美学特征,FilmOps 选用强大的视觉表征底座(如 DINO、BEiT)构建判别算子;而对于涉及角色布局推理与时序运镜轨迹的复杂动态指标,则利用 InternVL3-14B 进行 LoRA 指令微调。在评测流程中,FilmOps 算子首先从生成视频中提取出标准化的专业镜头元数据,再交由评估智能体结合打分细则给出 1 到 5 分的精准裁决。实验表明,这一套自动化评测流程与一线影视专家人工打分的一致性高达 Spearman $\rho=0.95$(T2V)与 $0.96$(R2V),达到了足以替代专业人工复审的可靠度。
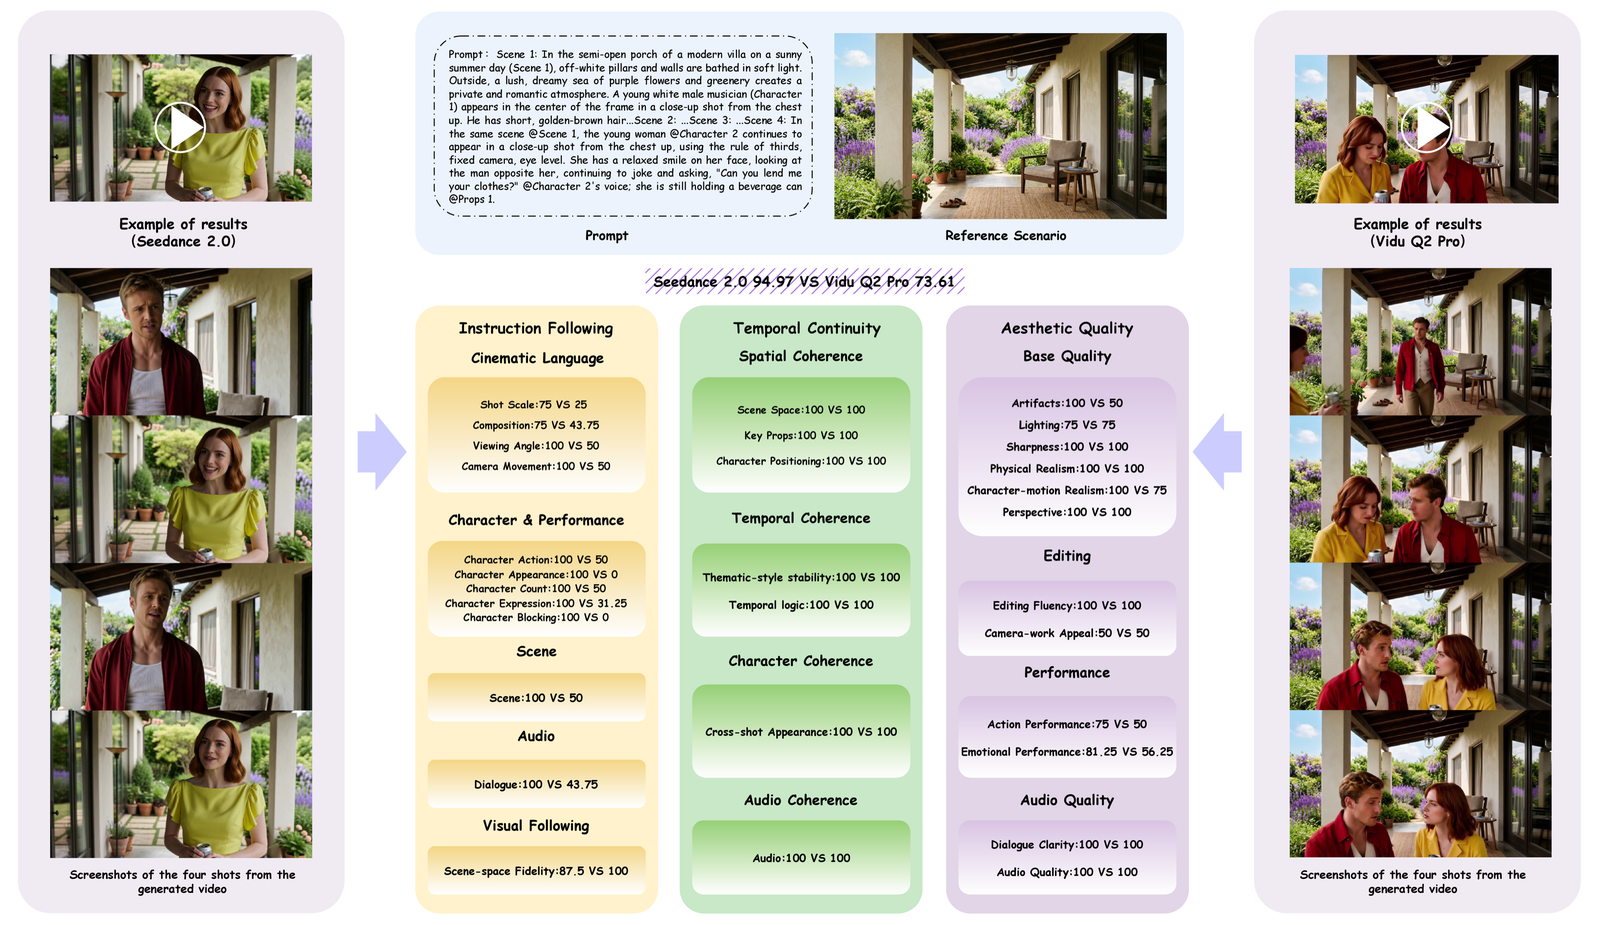
在逆向工程自电影《爱乐之城》(La La Land)的一个四镜头 R2V 测试样例中,FilmBench 的解耦分析能力展现得淋漓尽致。如图 3 所示,虽然某款模型在场景参考保真度(Scene-space Fidelity)上拿到了满分 100 分,但在随后的分镜头切换中,为了死死保住静态背景,牺牲了正反打镜头的调度逻辑,其机位视角、景别控制和构图评分直接出现断崖式下跌,人物调度指标甚至被判定为 0 分。相比之下,领跑模型不仅镜头语言执行到位,而且在剪辑节奏与时空连贯性上远胜对手。FilmBench 能够精准捕获这种“顾此失彼”的技术缺陷,而不会被单一维度的高分所掩盖。
核心发现:大模型距离“电影级”还有多远?
研究团队使用 FilmBench 对业界顶尖的视频生成系统进行了全方位大考(包括 Seedance 2.0、HappyHorse 1.1/1.0、Kling 3.0、Veo 3.1、Vidu、Hailuo 2.3 等体系)。综合大量详实的评测数据,论文揭示了当前视频生成技术在专业影视创作维度的五大核心规律:
1. 榜单不再饱和,差距拉开在“专业视听”
在传统的通用视频排行榜中,头部模型的分数几乎全部挤在 90 分以上的微小区间内。但在 FilmBench 的严苛审视下,没有任何一款模型能够接近天花板。在文生视频(T2V)任务中,综合冠军得分仅为 88.93;而在难度更高的参考生视频(R2V)中,最高分仅为 86.66。
拉开顶尖模型与中后梯队差距的,根本不是清晰度、噪点这类基础图像质量,而是集中在指令遵循中的景别控制、运镜精度、视角匹配以及运镜美感等视听语言专业维度上。
2. “动态审美”成为整个行业共同的瓶颈
纵观各家模型的雷达图,普遍呈现出严重的“偏科”现象。在画面清晰度、基础布光这类静态特征上,绝大部分模型都能取得极高的分数;然而,动作表演质感、运镜美学吸引力、角色运动真实感以及情绪表演表达,在全行业范围内均处于最低得分区间。这直观印证了一个事实:现有扩散和自回归视频模型已经学会了“渲染精美的静止帧”,但在理解角色如何像真人演员一样进行富有情绪张力的表演、摄影机如何带有叙事呼吸感地运镜等高阶动态审美上,依然处于非常初级的阶段。
3. 从单镜头到多镜头:性能遭遇断崖式暴跌
多镜头叙事是电影工业的基石,也是当前视频生成模型面临的最残酷考验。评测显示,当输入提示词从单镜头切换为多镜头时,所有模型的生成质量全线溃败,平均跌幅高达 7.9 分,而在较弱的模型上,跌幅甚至达到了惊人的 22.8 分。
这种性能崩溃主要集中在构图稳定性、机位切换的合理性以及剪辑点的时空动作流畅度上。当模型试图在一个生成过程中完成多个镜头的组接时,极易产生画面逻辑崩塌、角色突兀闪烁或空间朝向完全错乱的问题。可以说,当前的大模型更多是在执行“视觉特征插值”,离构建具备长程因果逻辑的“影视世界模型”还有相当长的路要走。
4. 参考图注入是压舱石,也是照妖镜
在 R2V 测试中,引入角色、场景或道具参考图后,由于模型不仅要解析文字逻辑,还必须维持高保真的外部视觉特征,这使得生成过程中的约束维度剧增。虽然整体模型的梯队排名基本保持稳定,但不同模型面对条件约束时的鲁棒性差距被进一步拉大。尤其在多镜头切换中,弱模型在维持角色面部特征或特定道具时,往往直接放弃了对运镜指令的响应。
5. 没有“全能冠军”,细分领域互补性显著
在单项维度的角逐中,没有出现任何一家模型在 38 个指标上全面登顶的情况。总分第一的 Seedance 2.0 拿下了 T2V 任务中 18 个子项冠军以及 R2V 中的 20 项第一,其优势高度集中在影视语言执行、剪辑流畅度和表演质感上;而 HappyHorse 1.1 则展现出完全不同的特长,在音频表现力、角色外观保真度以及场景稳定性等 11 项子指标上独占鳌头,甚至包揽了 R2V 中全部三项视觉参考遵循的冠军。这种子维度冠军的交错分布证明,单一的总分榜单掩盖了各家架构在专业能力上的巨大互补性。
从生成可信视频到掌握影视语法
FilmBench 的提出,标志着视频生成的评测重心正从“普通网民视角的可用性”迈向“专业创作者维度的严苛性”。通过将北京电影学院的视听语言训练体系与前沿 AI 评测技术结合,该基准为模型研发者提供了一面直面工业缺陷的镜子。
它清楚地告诉行业:仅仅追求单张画面的逼真与静态构图的讨喜,并不能让 AI 真正胜任电影制作。未来的视频生成攻坚战,必然聚焦于多镜头间的时空一致性保持、富含叙事动机的镜头调度控制,以及从深层次刻画人物灵魂的动态表演建模。FilmBench 与开源的 FilmOps 算子库,正是为这场通向专业级影视生成的蜕变,树立起了第一套不可绕过的度量衡。