4D-WAM:给自动驾驶世界模型注入4D几何监督,高难榜单提升3.7分
4D-WAM: 4D Consistent World Modeling for Autonomous Driving
在端到端自动驾驶的技术演进中,世界-动作模型(World-Action Models,简称 WAM)正迅速成为学术界与工业界关注的核心路线。相比于直接将传感器输入映射到自车轨迹的视觉-语言-动作(VLA)模型,WAM 通过联合建模“未来环境的视觉演变”与“自车未来的行驶动作”,试图让自动驾驶系统拥有预判世界动态的常识能力。
ArXiv URL:https://arxiv.org/abs/2608.10107v1
当前主流的 WAM 几乎无一例外建立在 2D 视频生成或潜空间扩散的基础上。这类模型虽然能在像素层面生成极为逼真的前向未来视频,却往往在底层物理世界中“露怯”:2D 像素的合理性并不等于三维物理空间加时间维度的连续性与真实性。一旦世界模型预测的未来画面在几何尺度、深度顺序或运动速度上出现扭曲,下游的自车轨迹规划就会受到致命误导。
针对这一根本性断层,来自美的集团、中国科学技术大学、西安交通大学与引望智能的研究团队提出了 4D-WAM。该工作首次将前沿的几何基础模型作为训练期的离线几何导师,为联合预测的未来视频施加 4D 一致性约束;同时揭示了世界模型去噪过程中的“早期决策现象”,提出针对关键决策阶段的时间步重采样策略。这项研究不仅在基准评测 NAVSIM-v1 与 NAVSIM-v2 的 navtest 榜单上刷新了单目输入的最佳成绩,更在极具挑战性的闭环 navhard 测试中将综合指标 EPDMS 从 32.2 提升至 35.9,展现出 4D 几何约束对高难度博弈场景的决定性意义。
2D 视频监督的致命隐患:为什么“看起来很真”的模型会撞车?
自动驾驶系统本质上运行在一个连续、刚性与动态并存的 4D 物理世界中(3D 欧氏空间加上时间维度)。人类驾驶员通过视觉感知路况时,大脑自发完成了对周围物体的深度距离估计、遮挡推理以及相对自车的运动速度解算。
但现有基于视频生成的 WAM 模型,其训练监督信号全部来自于行车记录仪采集的 2D 投影。当网络只学习去最小化像素层面的重建误差(例如 Flow Matching 或扩散模型的潜空间噪声匹配误差)时,它很容易利用画面的纹理连续性钻空子,产生两种在 3D 几何上完全崩溃的典型失效模式。
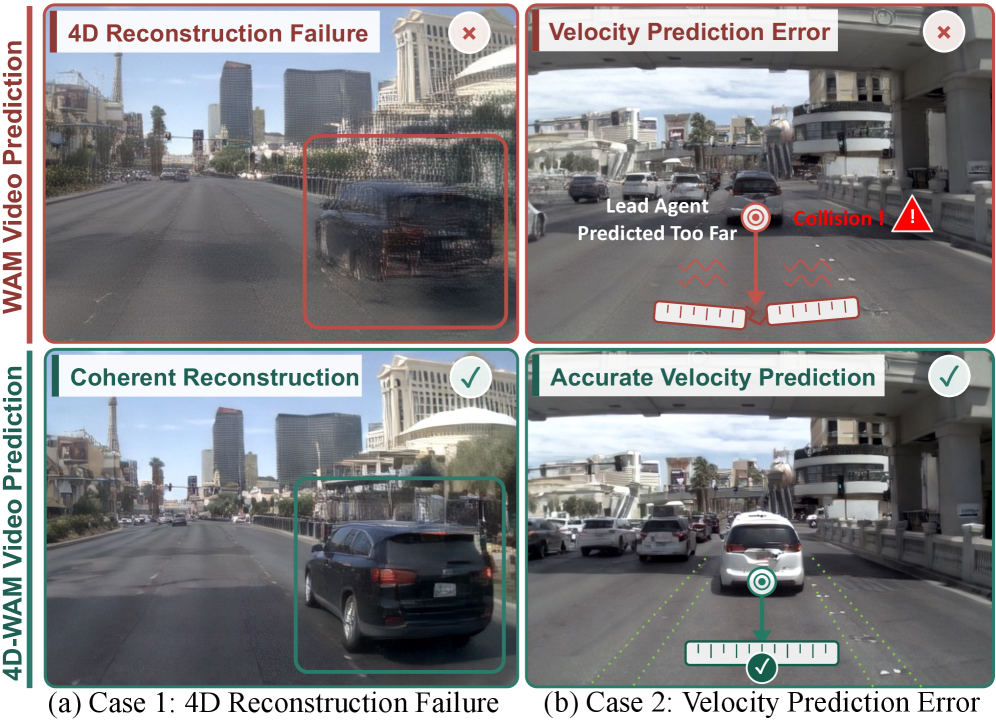
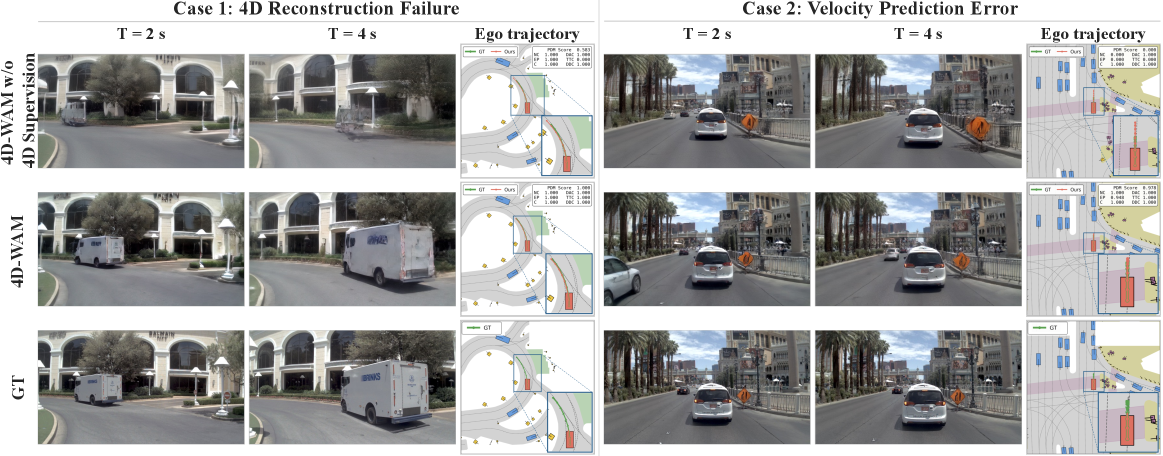
第一种是高动态物体的 4D 几何崩溃与重构失真。如图 1(a) 所示,当自车前方存在快速穿插或相对位移剧烈的工程车、大卡车时,传统 WAM 预测的未来图像往往伴随着形变、拉伸以及边缘模糊。如果用几何探测头去还原该场景的时空点云,会发现物体的三维包围框在时间轴上出现了不符合物理规律的膨胀或收缩。由于自车规划分支在特征层与视频分支深度耦合,这种几何畸变会直接导致规划分支误判障碍物占用的空间,给出偏离安全车道的错误轨迹。
第二种是纵向距离与前车测速的系统性偏差。图 1(b) 揭示了一个更为隐蔽且危险的现象:视频分支生成的前车在画面中心比例适中、视觉清晰,但因为缺乏显式的深度约束,模型并未真正解算出前车与自车的真实物理间距。一旦前车采取制动,传统 WAM 无法准确感知距离的变化率,导致测速严重偏高。下游规划器因此错误地认为前车仍处于安全巡航速度,进而维持激进的加速策略,最终演变成追尾事故。
这两个现象清楚地表明,纯粹依靠扩大 2D 视频数据集的规模,无法自然涌现出精准的 4D 几何常识。世界动作模型必须在训练中显式补齐几何与物理维度的监督信号。
引入几何基础模型:零推理开销的 4D 物理一致性监督
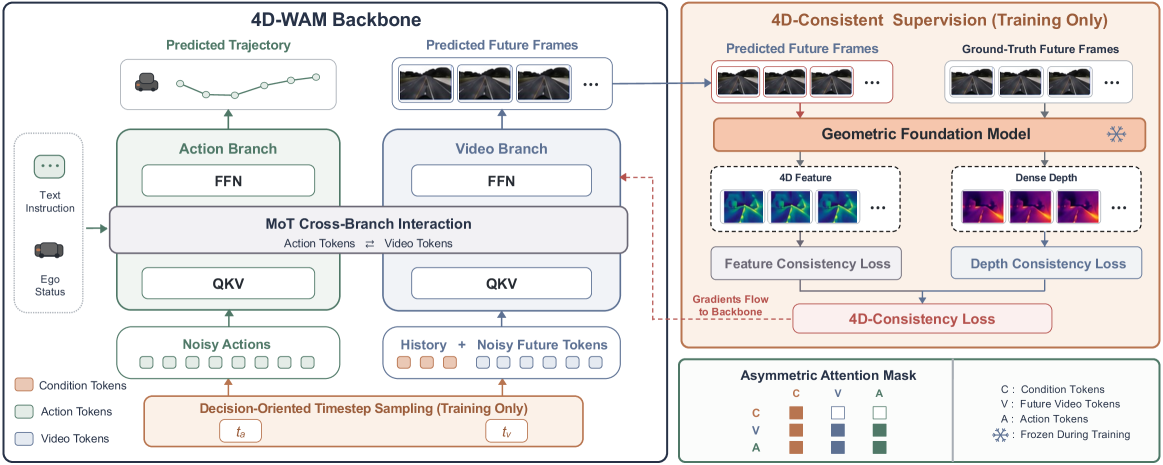
为了让模型学会物理一致的 4D 场景演化,最直观的想法是在输入端挂载昂贵的激光雷达(LiDAR)或在推理时运行复杂的 3D 重建算法,但这会破坏纯视觉方案的轻量性,并引入巨大的实时计算负担。4D-WAM 给出的解法非常巧妙:只在训练阶段引入先进的几何基础模型作为“导师”,在推理阶段完全抛弃导师网络,保持极佳的部署效率。
近两年,以 DUSt3R、VGGT 以及最新的 VGGT-$\Omega$ 为代表的前馈式三维/四维重建大模型取得了突破性进展。这类几何基础模型经过海量三维几何数据的预训练,能够仅凭几张连续的 2D 图像输入,直接以前馈方式预测出高保真度的稠密深度图、三维点图、相机运动轨迹以及时空跨帧点对应关系。4D-WAM 选择冻结的 VGGT-$\Omega$ 作为几何一致性监督的核心源泉。
整个框架采用多任务混合 Transformer(Mixture-of-Transformers, 简称 MoT)作为骨干网络。给定历史多帧前视画面 $\mathbf{v}{-T_h:0}$、自车当前自车状态 $\mathbf{e}_0$ 与导航指令 $q$,模型的目标是联合输出未来视频帧 $\mathbf{v}{1:T_f}$ 与未来规划动作轨迹 $\mathbf{a}_{1:T_p}$。
在模型内部,为了确保条件信息的安全单向注入与视频-动作之间的深度双向交互,研究团队设计了特定的非对称注意力掩码(Asymmetric Attention Mask)。条件 Token(包括历史视频、自车状态、文本指令)对未来的时空 Token 可见,但不能反向关注尚未生成的未来信息;而在预测未来的视频 Token 和轨迹动作 Token 之间,则开放全双工的双向交叉注意力。这种交互结构使得自车的驾驶动作能够充分感知周围物体的演变,未来画面的推演也以自车意图轨迹为参照。
在训练阶段的流匹配(Flow Matching)去噪前向中,网络预测出未加噪的干净视频隐变量 $\hat{\mathbf{z}}0^v$,并通过视频 VAE 解码器重建出未来视频的预测像素帧 $\hat{\mathbf{v}}{1:T_f}$。随后,预测的未来帧与真实的未来帧 $\mathbf{v}_{1:T_f}^{\mathrm{gt}}$ 被分别送入冻结的 VGGT-$\Omega$ 网络中,提取多层时空几何表征和稠密深度图,并定义了联合 4D 一致性损失:
\[\mathcal{L}_{\mathrm{4D}} = \lambda_{\mathrm{feat}}\mathcal{L}_{\mathrm{feat}} + \lambda_{\mathrm{depth}}\mathcal{L}_{\mathrm{depth}}\]其中,特征一致性损失 $\mathcal{L}_{\mathrm{feat}}$ 衡量预测画面与真实画面在几何模型内部各层特征的余弦距离:
\[\mathcal{L}_{\mathrm{feat}} = \frac{1}{\lvert \mathcal{S} \rvert}\sum_{\ell\in\mathcal{S}} d_{\mathrm{cos}}\left(\hat{\mathbf{F}}^{\ell}, \mathbf{F}_{\mathrm{gt}}^{\ell}\right)\]由于 VGGT-$\Omega$ 的隐层特征高度编码了三维空间的全局布局与跨时间步的点线轨迹,这一项损失强力迫使视频生成网络维持全局视角下几何结构的时空连续性。
细粒度几何约束则由深度损失 $\mathcal{L}_{\mathrm{depth}}$ 提供,它使用平滑的 Smooth-L1 损失来直接对齐预测画面与真实画面导出的稠密深度:
\[\mathcal{L}_{\mathrm{depth}} = \frac{1}{\lvert \mathcal{Q} \rvert}\sum_{q\in\mathcal{Q}}\mathrm{SmoothL1}_{\beta}\left(\hat{d}_q - d_{\mathrm{gt},q}\right)\]这套 4D 监督不仅惩罚了物体边缘在时间维度上的微小几何形变,还精确校正了前车与静态背景的相对纵深距离。最关键的是,VGGT-$\Omega$ 仅在反向传播计算梯度时参与工作,推理部署时完全切除,实现了真正意义上的“零推理额外耗时”。
揭开黑盒:世界模型的“早期决策现象”与时间步重采样
在基于扩散机制或流匹配的世界动作模型中,视频与轨迹是在多个去噪时间步(Timesteps)中逐步从高斯噪声还原而来的。直觉上,人们通常认为轨迹规划是一个多轮反复修改、逐步推演逼近最优解的过程。
但 4D-WAM 团队在做多步去噪检查时,发现了一个出人意料的物理机制:早期决策现象(Early-Decision Phenomenon)。
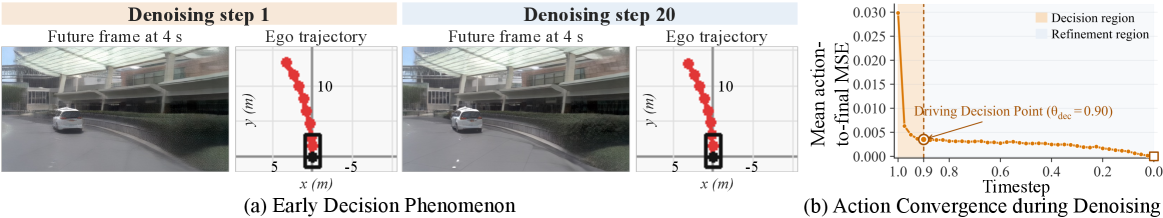
研究人员构建了一个 20 步的去噪过程,并在每一步去噪结束后,提取出当前步估计的“干净视频帧”与“预测轨迹”,观察规划动作随去噪阶段的变化轨迹。如图 3(a) 所示,在极高噪声水平的第 1 到第 2 步,自车的宏观驾驶意图(例如是向左变道、右转还是保持跟车减速)就已经彻底定型。
为了定量证明这一点,作者统计了去噪第 $k$ 步估计的动作轨迹与最终第 20 步收敛轨迹之间的均方误差(MSE):
\[D^a(k)=\frac{1}{NT_p}\sum_{i=1}^N\sum_{t=1}^{T_p}\left\|\hat{\mathbf{a}}_{i,t}^{(k)}-\hat{\mathbf{a}}_{i,t}^{(20)}\right\|_2^2\]如图 3(b) 曲线所示,当连续时间步参数从高噪区 $\theta = 1.0$ 下降到 $\theta = 0.90$ 时,动作 MSE 发生断崖式下跌并迅速达到平颈期。这意味着在去噪进度的前 10% 阶段,整套系统关于“去哪里、怎么开”的核心决策就已经完成;后续 90% 的低噪声去噪步骤,主要是在修饰视频的微观高频纹理、平滑轨迹曲线上的微小扰动。
这一发现直接颠覆了传统的均匀时间步采样策略。在标准训练流程中,模型对各个去噪时间步一视同仁。但在 WAM 中,如果模型在决定全局命运的最初一两步给出了错误判断,后续即使把局部画质雕琢得再精美也无济于事。
为此,4D-WAM 提出了面向决策的时间步重采样策略(Decision-Oriented Timestep Sampling)。该策略以阈值 $\theta_{\mathrm{dec}} = 0.90$ 为界,将扩散时间轴严格划分为高噪的决策区 $\mathcal{R}{\mathrm{dec}} = [\theta{\mathrm{dec}}, 1]$ 和精细化区 $\mathcal{R}{\mathrm{ref}} = [0, \theta{\mathrm{dec}})$。
为了在训练中将宝贵的 4D 几何监督梯度更多地灌注到决策区,算法通过非线性单调映射,将均匀分布的随机数 $u \sim \mathcal{U}(0,1)$ 转换为偏向决策区的时间步:
\[\theta = \frac{su}{1+(s-1)u}\]通过调节缩放因子 $s$,可以精确控制落在决策区的时间步采样概率质量 $\rho_{\mathrm{dec}}$:
\[\rho_{\mathrm{dec}} = \frac{s(1-\theta_{\mathrm{dec}})}{\theta_{\mathrm{dec}} + s(1-\theta_{\mathrm{dec}})}\]消融实验证明,当设置 $s=9.0$ 时,决策区的采样概率提升至 50%(原始均匀分布下仅占 10%)。这种策略强行将几何一致性监督聚焦在驾驶意图破土而出的关键几步,让世界模型在萌发变道或刹车想法的瞬间,就受到真实物理规律的精准纠偏。
决战高难工况:实测成绩与关键消融
为了客观检验 4D 几何约束的效力,4D-WAM 在业内公认高难度的自动驾驶仿真基准 NAVSIM 上进行了详尽测试。NAVSIM 不仅考查无过错碰撞率(NC)、可行驶区域合规性(DAC)、自车通行效率(EP)等指标,其 v2 版本还引入了极度严苛的 navhard 评测集。navhard 采用两阶段闭环机制:系统第一阶段基于真实传感器输入做决策,第二阶段则必须依赖基于历史推演生成的合成场景继续闭环驾驶,十分考验世界模型在长时间推演下的物理不失真度。
整个网络在训练上分为两个阶段,均在 16 张 NVIDIA H200 GPU 上完成。第一阶段先利用 navtrain 训练基础的视频-动作联合扩散流匹配,耗时 40 个 Epoch;第二阶段冻结或接入 4D 几何监督损失,再微调 40 个 Epoch。
在标准测试集 NAVSIM-v2 navtest 上,4D-WAM 仅凭前视单目摄像头输入,便斩获了 90.6 的综合 EPDMS 得分,刷新了此前由 DriveFine 保持的最佳成绩(89.7),并在无碰撞率(NC)、行驶方向依从度(DDC)、自车通行度(EP)和碰撞时间余量(TTC)等关键安全与合规项上包揽第一。
而在工况最残酷的 NAVSIM-v2 navhard 榜单上,4D-WAM 的优势更为显著:
-
综合指标 EPDMS 达到 35.9,相比此前业界最优基准(32.2)大幅增长了 3.7 分。
-
在第二阶段基于合成观测的闭环推演中,4D-WAM 在碰撞控制、变道合规、通行进度与车道保持(LK)上全线登顶。这强力证明,由于 4D 几何导师在训练期的纠偏,模型“脑补”出的合成场景没有发生物理崩溃,从而让第二阶段的下游规划依然能做出安全可靠的抉择。
在消融实验部分,图 4 直观地揭示了 4D 监督带来的质变:
-
复杂动态大车交互(Case 1):一辆大型卡车在右前侧快速移动。缺乏 4D 监督的基线模型在推演后期,卡车轮廓逐渐拉长融化,自车规划因对其占用范围估计不足而发生轨迹向右偏移;而 4D-WAM 生成的卡车不仅三维刚体结构始终保持完好,空间位移也严丝合缝,自车规划给出了符合避让常理的稳健路径。
-
跟车巡航测速(Case 2):面对前方减速的领航车,基线模型因缺乏对纵向尺度的感知能力,低估了与前车的接近速率,给出了激进且具备潜在碰撞风险的高速轨迹;4D-WAM 在深度特征约束下准确解算出了前车相对速度,自车规划果断平滑减速,消除了追尾隐患。
此外,“早期决策现象”还带来了一个极具工程价值的副产物:推理时延的大幅压缩。实验数据显示,在测试时将扩散推演步数从常规的 10 步直接骤减至 2 步,模型的 EPDMS 得分仅从 90.6 微幅变化至 90.5,决策表现几乎没有受到任何实质影响。但这一改动将系统的单帧规划延迟从 0.79 秒急剧压低至 0.31 秒,为原本被诟病“太慢而难以实车部署”的扩散类世界模型撕开了一条通往量产落地的可行通道。
总结与展望
4D-WAM 的成功展现了具身智能与自动驾驶领域的一个重要趋势:生成式模型不仅需要像素层面的以假乱真,更需要物理世界维度的规律严谨。
以往基于纯 2D 视频的端到端学习,本质上是将大量 3D 到 2D 投影损失的几何反问题强加给一个无先验的神经网络去拟合;而 4D-WAM 借力几何基础模型,将成熟的时空几何常识在训练期间转化为高密度的监督场,既不用承担昂贵的传感器与多视角标定包袱,又完全免去了推理时的算力负担。同时,对去噪动力学中“早期决策现象”的捕捉与时间步再分配,展示了针对生成式规划器底层规律做定制优化的巨大潜力。
随着自动驾驶从“开得动”全面迈向“在复杂长尾场景下开得像老司机”,这类具备物理世界一致性感知与推演能力的世界-动作模型,很可能将成为下一代端到端基础底座的标配架构。