ARAC-Bench:顶会审稿视角评测Auto-Research,最高分仅67.9
ARAC: Benchmarking Auto-Research's Alignment and Completeness on End-to-End Researchs
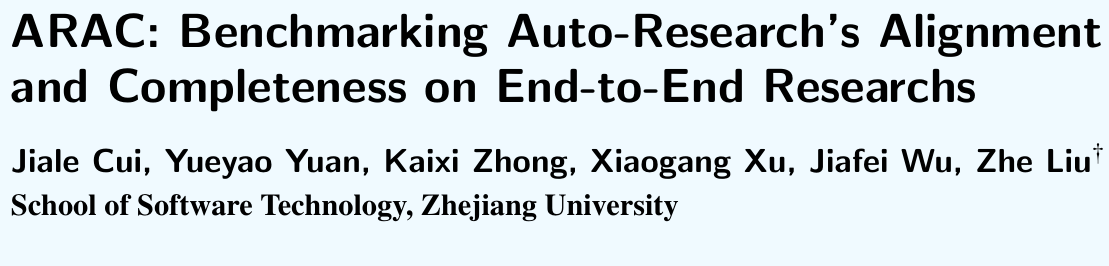
让大语言模型(LLM)驱动的智能体独立承担科研任务,即 Auto-Research(自动化科研),正在迅速从单纯的概念验证走向具体系统落地。从能够端到端生成论文草稿的早期系统,到 ARIS、Dr.Claw、EvoScientist 等引入对抗纠错与跨任务演化的框架,自动化科研正逐步覆盖选题立项、代码实验以及论文综合归纳的全流程。
ArXiv URL:https://arxiv.org/abs/2608.12788v1
然而,衡量这些智能体是否真正具备科研能力的评测基准,却始终陷在两难困境中:依赖沙盒运行脚本的传统指标虽然客观,却完全无法理解科学问题的深度与逻辑连贯性;若改用纯粹的 LLM-as-Judge,又极易带来非结构化的主观偏差与幻觉。更关键的是,许多基准只看最终结果(如代码是否跑通、论文排版是否整齐),无法区分真实的科学洞见与暴力试错,更无法衡量研究过程是否遵循严谨的科研方法学规范。
针对这一核心断层,来自浙江大学等机构的研究者提出了 ARAC-Bench(Auto-Research’s Alignment and Completeness Benchmark)。该基准不再单纯以“最终答案是否匹配”来定胜负,而是将研究过程对齐真实人类科研行为与完整性作为评测核心。通过从 NeurIPS、ICLR、ICML 等顶会的 7,000 篇高质量论文及其实际 Rebuttal 辩论中提炼出的学术认知技能库(Academic Cognition Skills, ACS),ARAC-Bench 将资深审稿人的隐性经验转化为分阶段、可量化的评测规则。在统一底模环境并对 11 个主流框架进行严格诊断后,结果呈现出一个发人深省的事实:当前最顶尖的自动化科研系统在综合对齐与完整性上的最高得分仅为 67.9 分(满分 100 分),暴露了 AI 在模拟严密科研方法学时的显著差距。
从“结果导向”转向“模拟人类科研过程”
当前评测自动化科研系统时,常见的做法往往是给定一个问题,看系统最终生成的代码能否在基准数据集上超越 SOTA,或者评估论文初稿与真实论文的重合度。这种粗粒度评估方式存在严重的结构性盲区。一方面,代码偶尔跑出高分可能仅仅来自于参数的随机碰撞,并不意味着模型掌握了理论归因;另一方面,某些理论假设非常严谨的科学探索,可能仅仅因为第三方库的版本冲突或偶然的工程实现 bug 导致报错,在传统测试集中就会直接被判为 0 分。
这种“重结果、轻规范”的导向,导致测试集上的高分与真实的科研高质量严重脱节。为了解决这个问题,ARAC-Bench 将“以人类科研者为镜像”(Researcher-Mimicking)作为核心设计哲学。该框架选取了 ICLR 2026 接收的 200 篇真实前沿论文作为黄金参考标准(Gold References),并将复杂的科研活动拆解为三个严格隔离的阶段:选题开题(Proposal)、实验实施(Experiment) 与 综合沉淀(Synthesis)。
在评测执行时,评测框架对信息泄露施加了物理级别的硬性隔离。所有被测框架的学术文献检索范围均被严格截断在 2025 年年中,在物理层面上杜绝了模型通过搜索引擎直接爬取作为 Gold References 的完整论文或其引用网络的可能性。此外,为了防止上一阶段的执行偏差滚雪球般拖垮后续评估,评测采用严格的阶段独立输入协议,前序步骤的标准事实作为已知条件提供,确保每一次扣分都能精确归因到特定的能力缺陷。
学术认知技能(ACS):将审稿人隐性经验量化为结构化准则
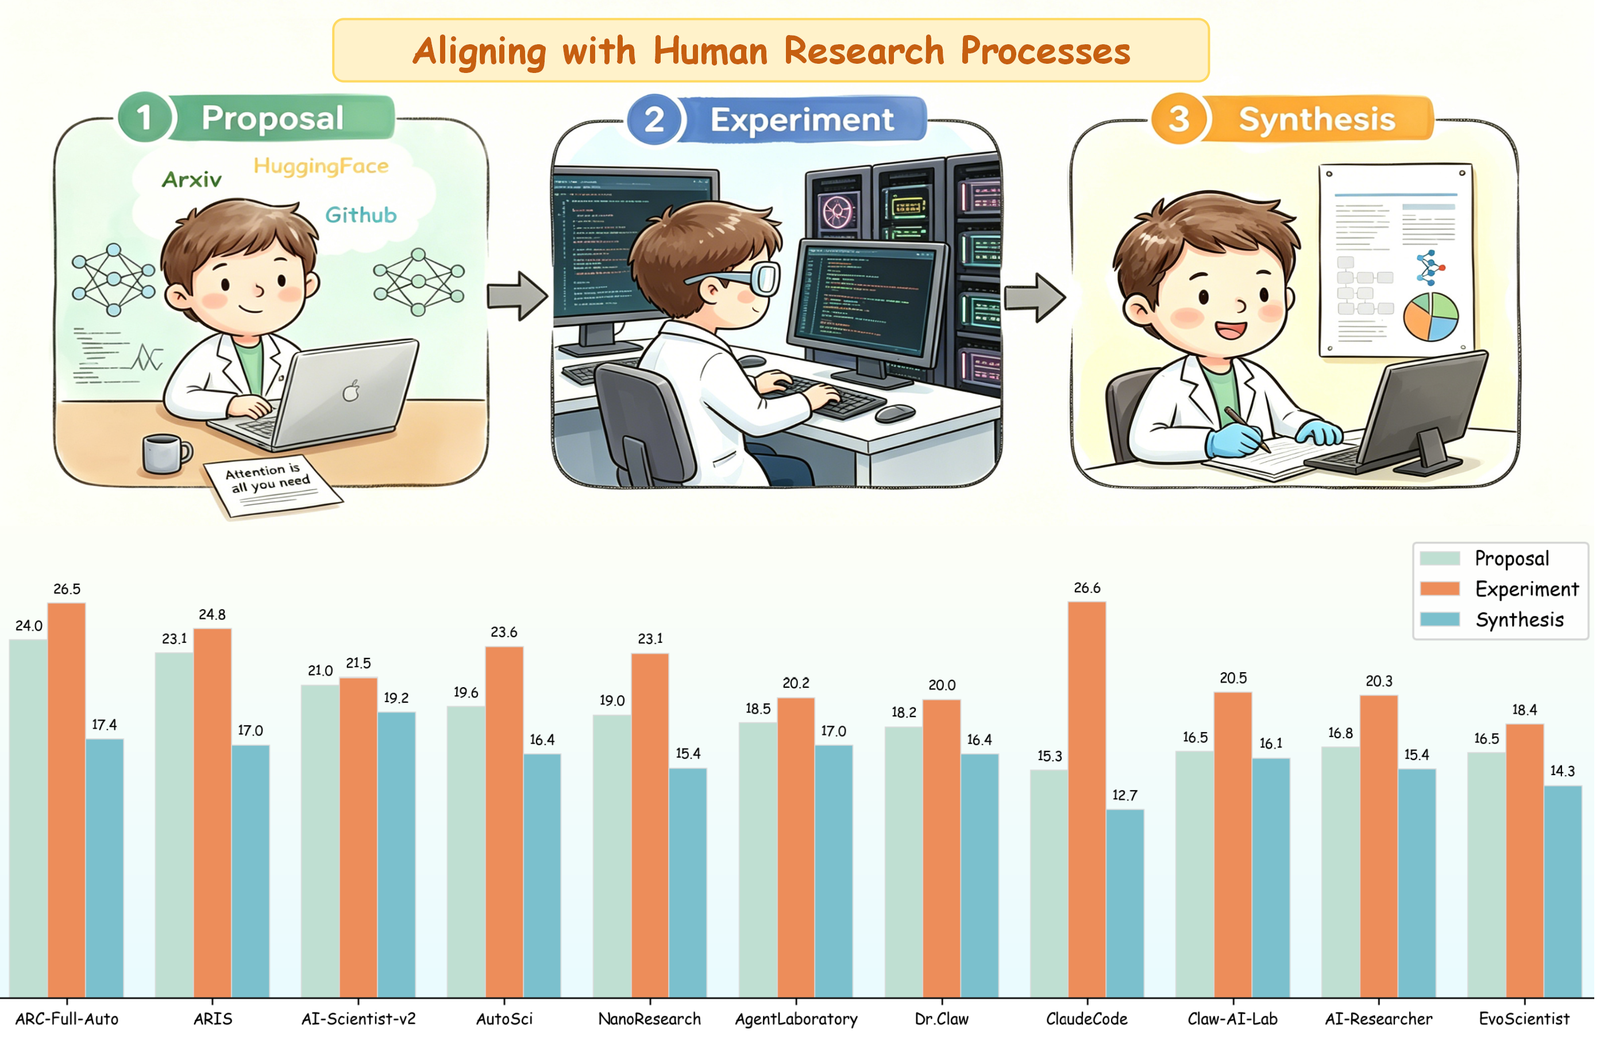
如何让评测既具有类似资深教授的学术审美,又具备自动化计算的可复现性?ARAC-Bench 的核心创新在于提炼了 Academic Cognition Skills (ACS) 体系。
审稿专家在评价论文时,依靠的往往不是生硬的打分表,而是深厚的领域沉淀:例如实验设置是否考虑了关键变量的消融、文献综述是否遗漏了核心的对比路线、消融实验的结果是否真能支撑其理论归因。这些隐性标准很少被成文定义。研究团队从过去两年顶会接收的 7,000 篇学术论文中,系统提取出核心科学问题,并结合作者与审稿人在公开评审过程中的辩论策略,经过清洗与重构,凝练成了一套可跨任务迁移的学术认知规范。
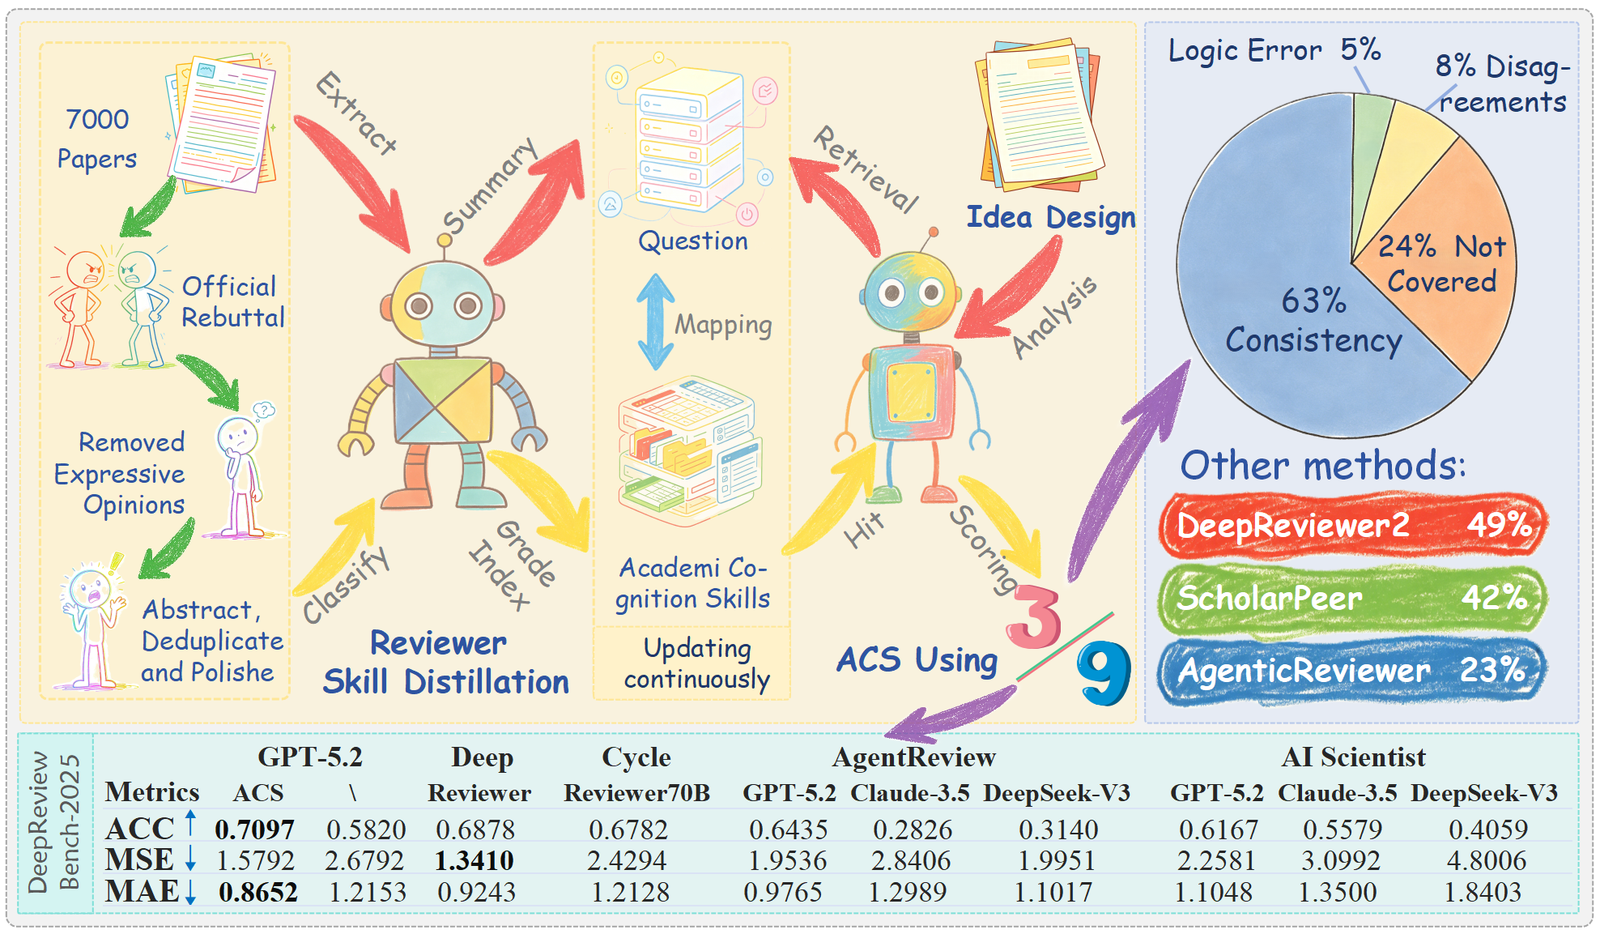
如上图所示,当被测系统针对某项科学问题生成方案或代码时,ARAC-Bench 并不依赖宽泛的提示词让大模型打分,而是首先进行语义与技能匹配,筛选出最相关的 Top-5 学术认知技能标准。这种机制将 LLM-as-Judge 的上下文语义理解能力,与标准化技能库的量化刻度紧密缝合在一起。
在具体诊断方案上,三个阶段分别确立了极为细致的客观标准:
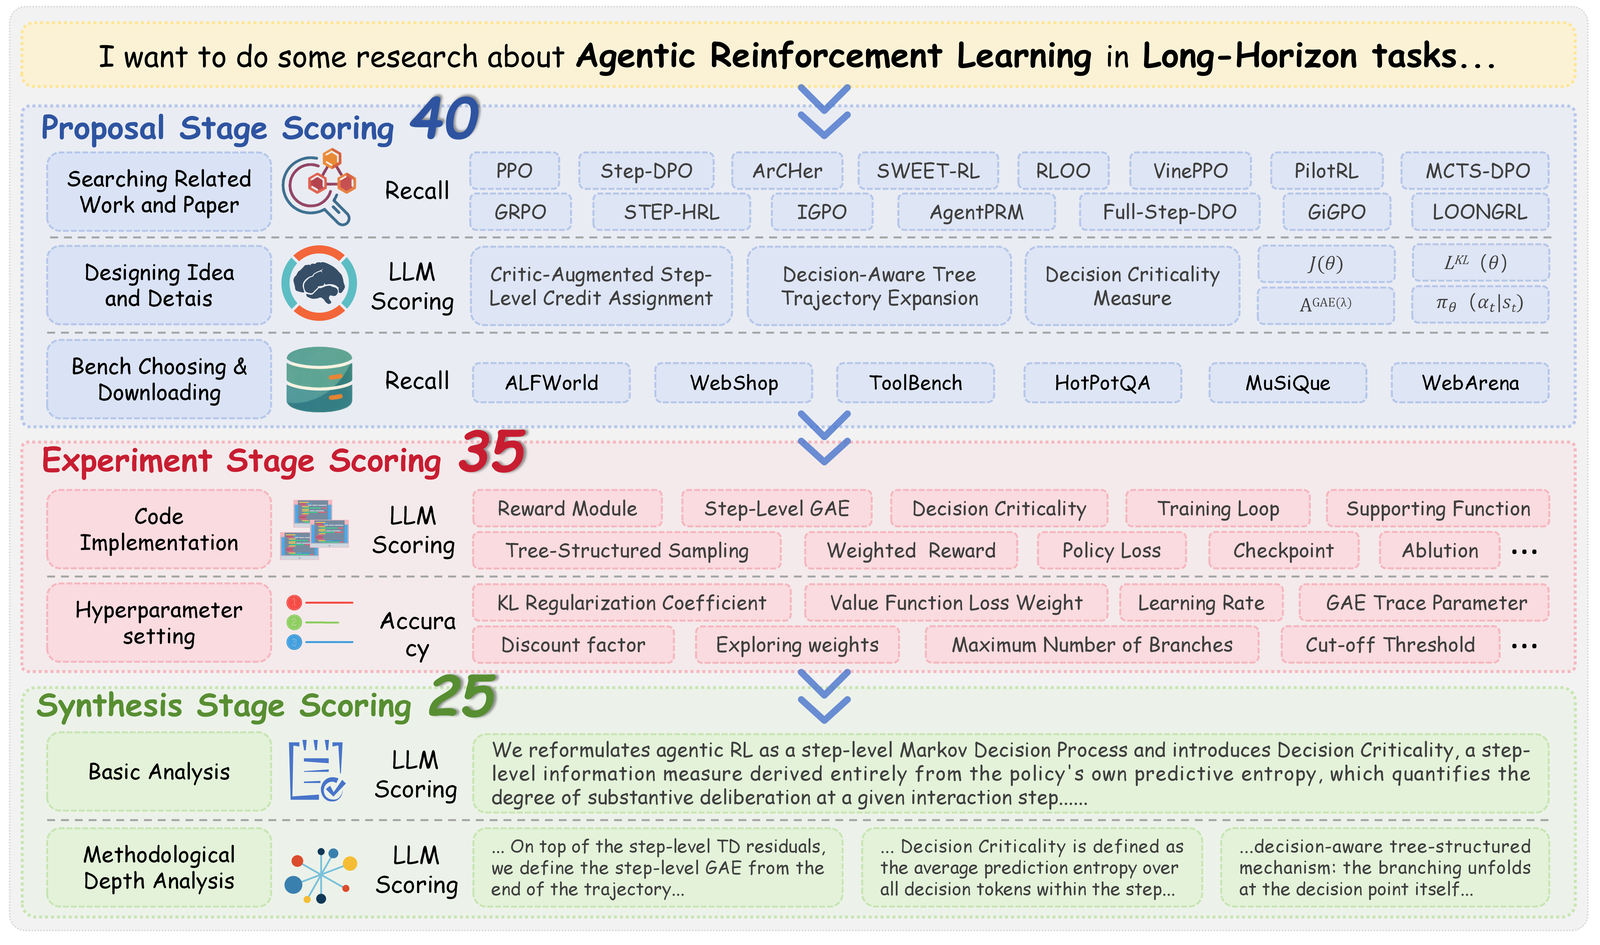
在 Proposal 阶段,系统不再凭空编造研究思路,而是基于前置的灵感线索,考察其提炼科学假设的敏锐度;其文献调研部分的打分,则以真实论文的原始参考文献集合为真值基准进行召回与覆盖率校验。
在 Experiment 阶段,为了消除代码质量的主观争议,代码实现部分的评分基于预定义的标准模块库(Standard Module Library)。如果关键的方法模块在代码架构中缺失,该项直接计为 0 分,强力施加工程完整性约束,同时对参数直觉与执行鲁棒性进行精细考察。
在 Synthesis 阶段,评估重点放在因果归因链条与正式的逻辑自洽性上。系统必须基于真实的实验结果输出推导结论,任何未被实验支撑的过度声称或因果跳跃都会被 ACS 规则精准捕获并扣分。
评测结果:最高仅 67.9 分,代码能力不等于科研深度
为了消除底层基础模型本身的能力差异对各科研框架评测带来的干扰,评测将所有参评框架的底层模型全部统一固定为 Kimi-K2.6。评测覆盖了业界代表性的 11 个自动化科研框架,包括 AutoResearchClaw、ARIS、AI-Scientist-v2、NanoResearch、Dr.Claw、Claw-AI-Lab、AI-Researcher、EvoScientist、AutoSci、Agent Laboratory,并引入了搭载通用科研技能的 ClaudeCode 作为对比基准。
评测结果揭示了极具价值的几个核心结论:
第一,自动化科研距离达到人类严密标准仍有巨大鸿沟。在总分为 100 分的量化体系下,目前表现最好的系统最终仅取得了 67.9 分。多数框架在生成看似像模像样的文献综述和排版漂亮的初稿时游刃有余,但一旦进入严密的方法论校验,漏洞便暴露无遗。
第二,ARAC-Bench 与真实资深科研人员的直觉高度对齐。研究团队组织了由博士研究生(Ph.D. Candidates)组成的人类专家组进行盲审排序打分,ARAC-Bench 的评测结果与人类综合排名的 Pearson 相关系数达到了 0.8141。分阶段来看:
-
Proposal 阶段 的相关性高达 0.8788;
-
Synthesis 阶段 的相关性达到了惊人的 0.9030;
-
Experiment 阶段 的相关性为 0.6606,虽表现出中等偏强的正相关,但相对前两个阶段略低。
论文指出,人类专家在评估实验阶段时,往往会主观融入对整体工程美感、研究哲学以及计算资源取舍策略的综合感知;而 ARAC-Bench 为了保证评测的可追溯性与因果确定性,刻意剥离了这部分较为模糊的“软性指标”,重点聚焦在标准模块完整性、运行健壮性与参数逻辑上。这一取舍虽然略微降低了与人类主观感知的完全同步,却换来了可复现、可定位的精确归因能力。
第三,通用代码能力无法自然泛化为科研推理能力。实验中,融入通用学术技能包的 ClaudeCode 在 Proposal 和 Synthesis 阶段带来了可见的改善,能够有效辅助前期的文献调研与后期的形式化校验;但在 Experiment 阶段,这种工具注入并没有带来显著的实验质量跃升。这证明,科学实验不仅仅是编写可执行的代码片段,更在于如何针对假说构建严密的实验对照体系。单纯提升写代码的速度与正确率,并不能填补科学方法论本身的欠缺。
自动化科研的下一步演进
ARAC-Bench 揭示了自动化科研领域的一个核心现实:当前的智能体系统大多擅长于表层形式的模仿,而深层的科学归因与实验设计仍是极大的技术瓶颈。
这项研究的价值不仅在于提供了一个严苛的测试集与排行榜,更在于它构建了一套具备细粒度归因能力的反馈框架。每一次得分的起伏,都可以清晰地追溯至某一特定学术认知技能的缺失、一个标准工程模块的遗漏,或是逻辑推导中因果关系的断裂。
伴随着前沿模型的持续迭代,ARAC-Bench 建立的动态演进机制,也将随着顶会接收论文的滚动更新而不断扩充黄金参考库。对于下一代完全自主的科研智能体架构设计而言,这种能够精确定位认知偏差与方法论缺陷的评估机制,将成为训练与强化学习阶段极为关键的高质量标尺。