BDH-CQ:摆脱思维链Token,150M小模型以0.07美分刷爆ARC能效比
BDH-CQ: In-Context Learning with Recurrent Latent Reasoning
大语言模型在复杂推理任务上的突破,在很长一段时间内都深度绑定在“思维链”(Chain-of-Thought, CoT)这一范式之上。为了推导出一个答案,系统必须在自回归机制下逐字生成成百上千个中间 Token。这种机制将严密的逻辑推演与离散的自然语言叙述捆绑在一起,使得推理的每一步都必须经过词表投射、串行输出并重新作为上下文读入。伴随长思考模型而来的,不仅是显存和宽带的巨大开销,还有极其昂贵的单次推理成本。
ArXiv URL:https://arxiv.org/abs/2608.09888v1
如果人类在脑海中进行抽象空间推理时并不需要字字句句默念出来,AI 为何必须把每一个中间推导状态都显式打印为 Token?
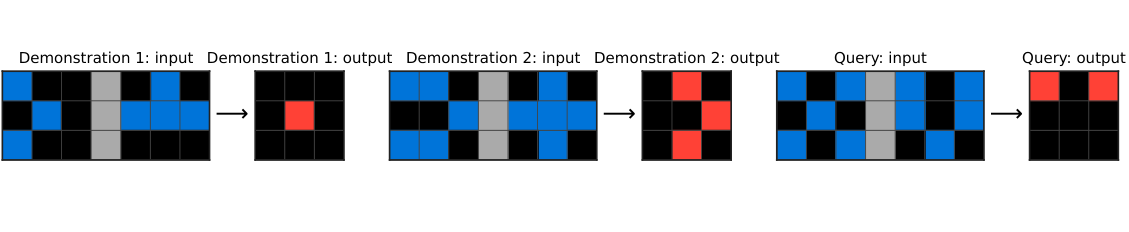
由 Bielik AI、纽约大学(NYU)与 Pathway 联合推出的推理模型 BDH-CQ 针对这一痛点给出了截然不同的解法。BDH-CQ 将上下文学习(In-Context Learning)与循环隐式推理(Recurrent Latent Reasoning)深度融合:模型在推理阶段直接吸收少样本示例以持续更新自身的循环记忆,随后在连续的高维隐空间中进行多轮迭代计算并直接解码出最终结果,整个推理过程完全不生成任何中间自然语言 Token。
更为惊人的是其在极小体量下展现的能效。基于仅仅 150M(1.5 亿)参数 的配置,BDH-CQ 在极具挑战性的抽象推理基准 ARC-AGI-1 公开评测集上取得了 29.5% pass@2 的优异成绩,而其计算出的单任务平均推理成本仅为 0.0007 美元(折合人民币不足 0.005 元)。这一结果直接穿透了此前由各类前沿大模型与递归求解器构建的成本-精度帕累托前沿(Pareto Frontier),在基准测试的经济性与计算效率上立下了新的标杆。
双轨机制:解耦上下文记忆与隐式工作空间
理解 BDH-CQ 的核心,在于厘清它如何打破“上下文适应”与“隐空间深度计算”之间的长期割裂。
以往的研究中,具备上下文少样本泛化能力的系统几乎清一色依赖序列 Transformer,计算增量全靠生成 Token;而擅长隐空间多轮递归计算的小模型(如 HRM 或 TRM),在面对 ARC 等少样本任务时,通常需要在测试阶段对新任务执行参数微调或梯度更新(Test-Time Training / Transductive Optimization),不仅破坏了通用推理的纯粹性,更使得单任务推理成本飙升至 1.5 美元以上。
BDH-CQ 的底层承袭了后 Transformer 架构 BDH(Dragon Hatchling)。该架构放弃了传统自注意力的庞大键值缓存(KV Cache),转而利用高维正激活(ReLU-low-rank)与大特征空间中的线性注意力机制,构建了一种脑启发的局部交互与持久关联状态。在 BDH-CQ 中,推理引擎被精妙地解耦为两个数学过程:
首先是通过循环记忆实现的上下文学习。给定一个包含 $K$ 个少样本示例的任务集 $D={(x_t, y_t)}_{t=1}^K$ 以及待求解的测试输入 $x^\star$,系统并不把示例压缩成单一静态向量,而是依序更新循环状态:
\[S_t = U_\theta(S_{t-1}, D_t)\]其中模型参数 $\theta$ 完全保持冻结。这种设计使得模型在摄入后续输入时,能够自动调配前面示例累积形成的关联信息,功能上等价于注意机制建立的上下文绑定,却彻底规避了膨胀的 KV 显存开销。
其次是高维隐空间内的循环潜在推理。当全部 $K$ 个示例被写入上下文记忆 $S_K$ 后,系统为测试输入 $x^\star$ 开辟了一个独立的连续隐式工作区 $H$:
\[H_0 = E_\theta(x^\star, S_K)\] \[H_{r+1} = F_\theta(H_r, S_K), \quad r=0, \ldots, R-1\] \[\hat{y} = G_\theta(H_R)\]在上述计算流中,上下文记忆 $S_t$ 负责承载任务规范(定义“做什么”),而隐式工作区 $H_r$ 则承担多轮循环推理(执行“怎么做”)。在这连续的 $R$ 次隐式迭代中,模型并不受离散语言词表的投射束缚,可以同时保留并并行探索多条潜在假说分支。直到最后一步,解码器 $G_\theta$ 才将高阶表征直接映射为目标输出网格。
0.0007 美元击穿帕累托前沿:独立审计下的基准突破
ARC-AGI 旨在衡量系统以极少先验快速习得全新规则的“技能获取效率”。由于要求输出绝对精确的像素级网格,该测试对规则抽象、执行一致性以及抗噪能力有着极高要求。
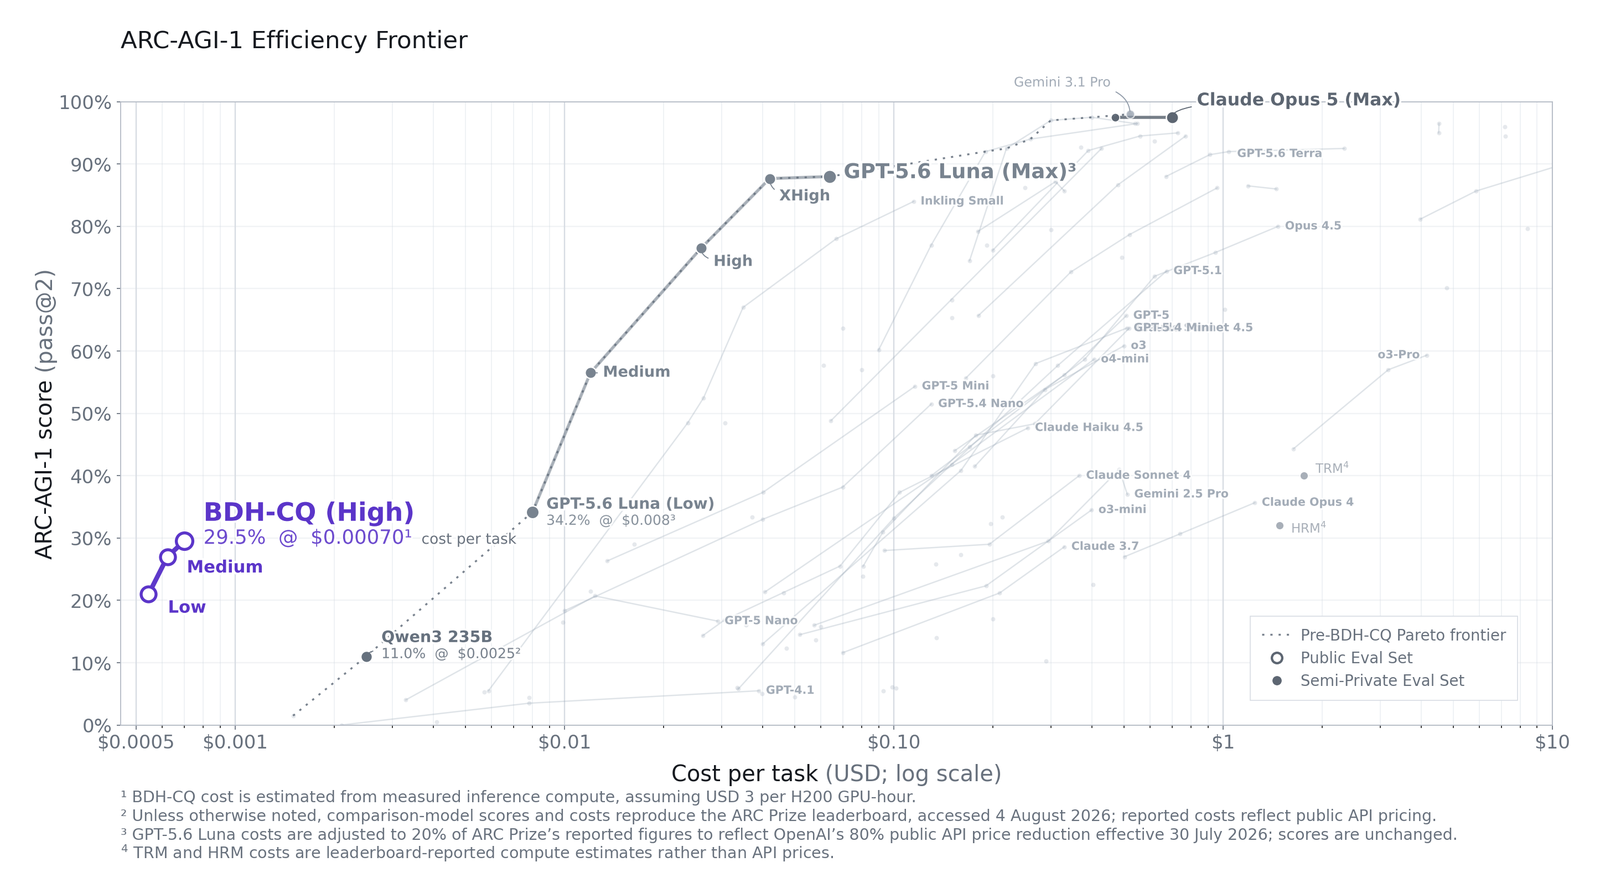
在 ARC-AGI-1 官方包含 400 个公开任务的评测集上,BDH-CQ 展现出了惊人的能耗比反差。以往能够在 ARC-AGI 上达到 30% 左右精度的系统,往往依赖庞大的前沿大模型集群配合蒙特卡洛树搜索(MCTS),或者需要借助复杂的多轮微调框架。例如 ARC 竞赛中知名的递归架构 HRM 和 TRM,其报告的单任务成本分别高达 1.48 美元和 1.76 美元。
相比之下,参数仅 150M 的 BDH-CQ 在纯前向推理、无须任何测试期权重更新的前提下,以 29.5% pass@2 的表现将单任务成本拉低至 0.0007 美元,较现有方案降低了三个数量级以上。由 Bielik AI 与纽约大学研究人员联合执行的黑盒独立审计,在完全不接触模型内部权重、严格遵循盲测协议的条件下,完整复现了这一基准得分。这种极致的能效意味着,在相同的计算预算下,原本只能评估单个任务的算力,如今足以支撑上千次复杂隐式推演。
算子绑定的解剖学:从 ConceptARC 看能力边界
为了穿透单一的分数汇总,研究团队采用包含 16 类概念家族的 ConceptARC 基准,对 BDH-CQ 进行了精细化的认知探测。在严格标准(一个任务下的全部 3 个测试用例均答对才计为任务成功)下,模型的概念解耦表现浮出水面。
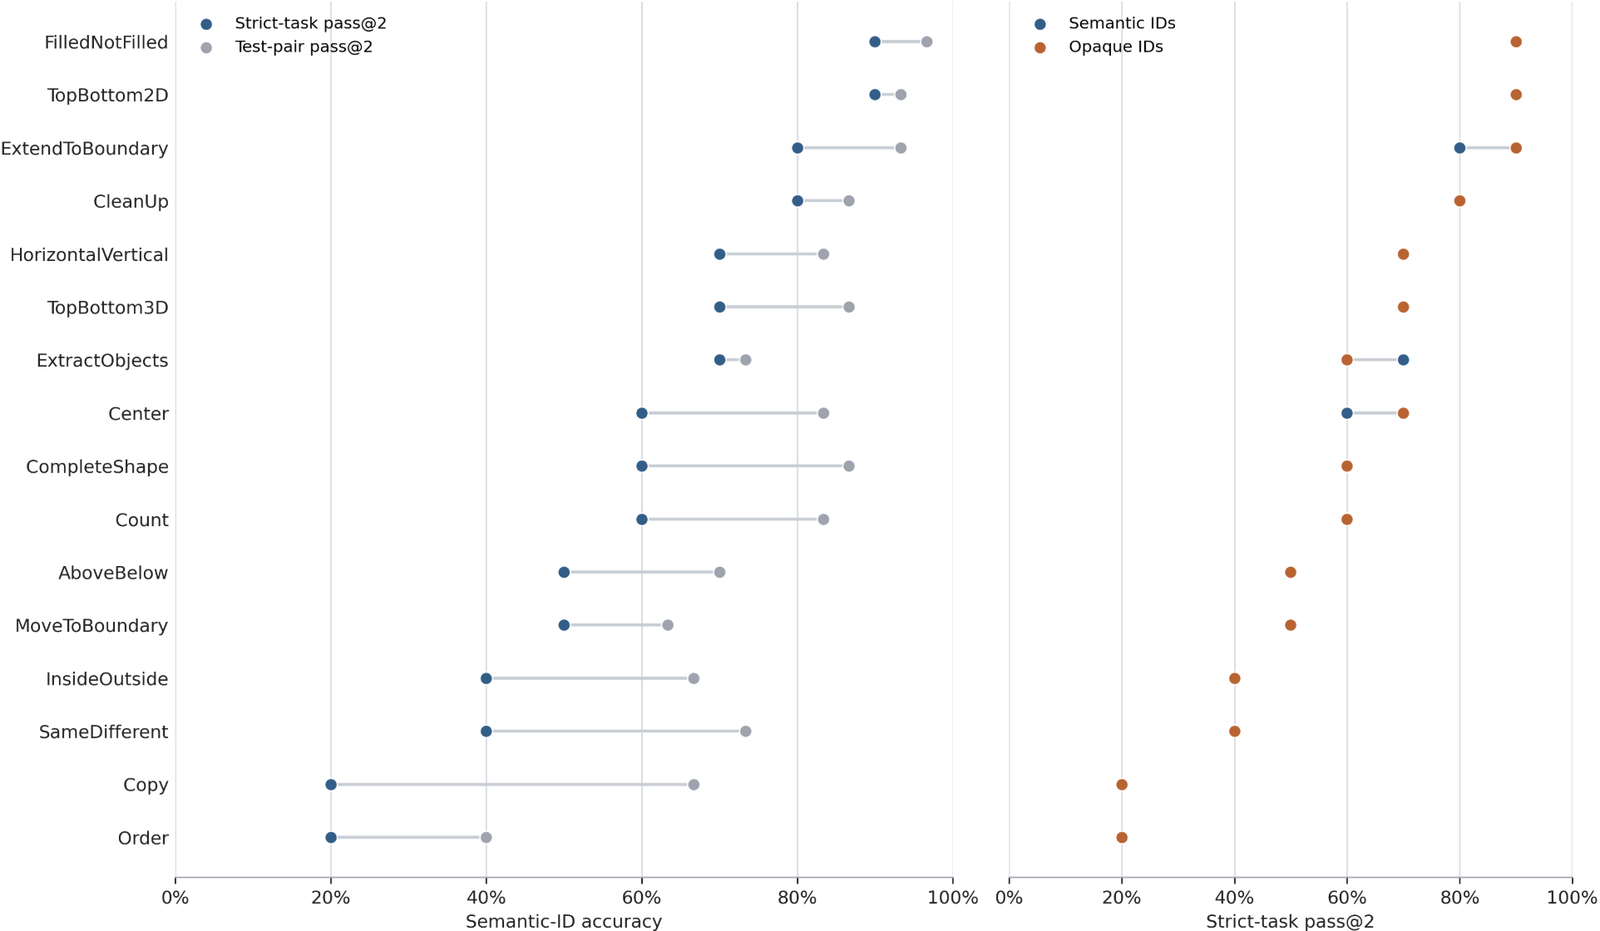
测试结果揭示了隐式上下文学习对不同抽象层级的独特响应偏好:
-
强项算子:在“沿边界传播”(Propagation)、“质心提取”(Center)、“基础填充”(Inside/Outside)等几何与拓扑属性明显的任务上,BDH-CQ 展现了极强的泛化一致性,测试对准确率超过 90%。
-
压力算子:在涉及多对象严格排序(Ordering)、逐像素精准复制(Copying)以及多重嵌套包含(Nested Containment)的场景中,模型性能出现明显衰减。
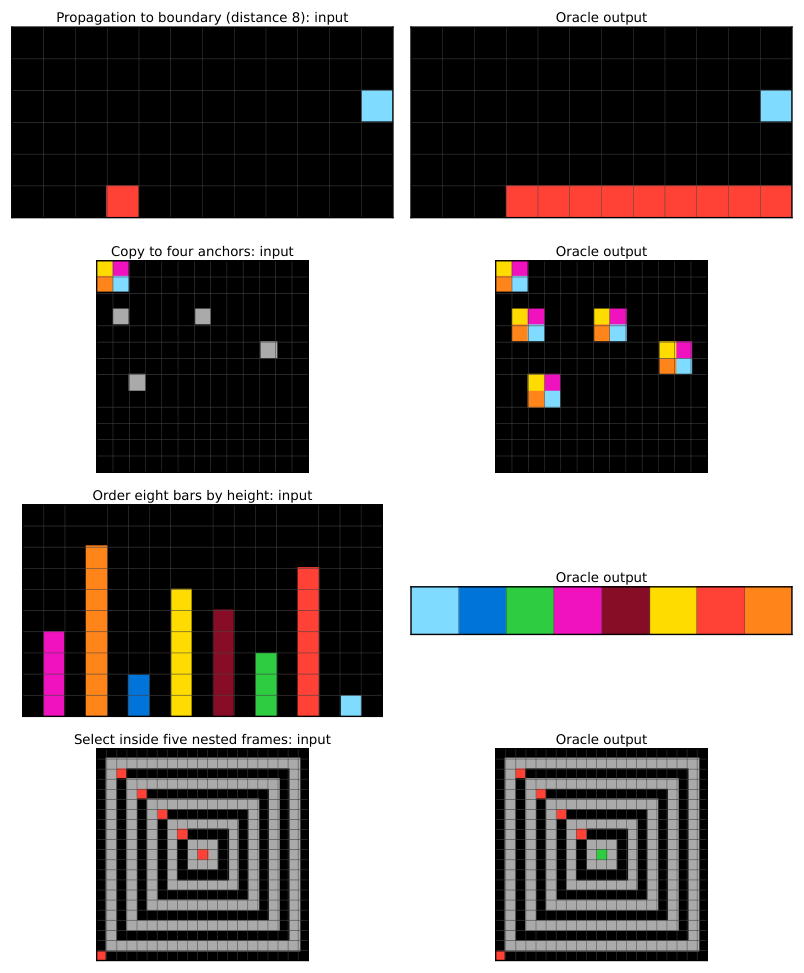
为了进一步探究模型是真正习得了通用规则还是形成了局部过拟合,作者设计了一组受控对抗实验。在冻结模型的前提下,人为操纵单项复杂度进行压力测试:
-
在规则传播任务中,无论画布从 6 格拉长到 14 格,BDH-CQ 均能维持稳定的正确率,展现出近乎完美的算子外推能力。
-
在密集颜色映射测试中,让示例在上下文中动态绑定一种全新的颜色置换规则。随着同时绑定的映射对从 2 组增加到 8 组,模型在全部 96 个测试用例中取得了 100% 的一次性命中(Rank 1 完美解析),证明其循环记忆单元 $S_t$ 具备极高密度的即时信息写入与符号关联容量。
-
然而,当算子引入顺序与嵌套深度时,随着逻辑步数的线性加深,模型在隐式空间中的表征出现了混淆与漂移。这种断崖式下跌清晰标定了纯隐式循环在缺乏显式状态栈时面临的固有瓶颈。
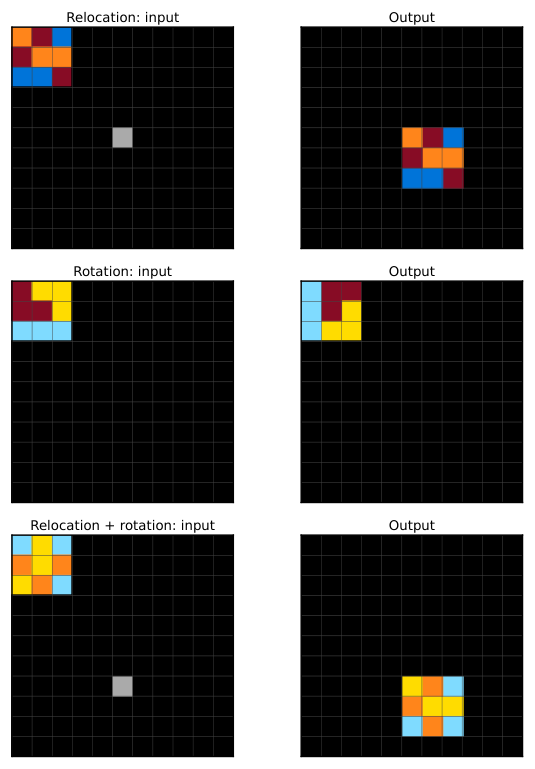
此外,复合实验进一步揭示了“算子组合”的非对称性。当简单的位移算子(Relocation)与顺时针翻转、颜色反转等原子操作进行逻辑复合时,复合后的执行精度并不取决于单个算子的线性叠加,而是与隐式空间表征的拓扑干扰密切相关。这一发现明确了所谓“规则归纳”在连续表征系统中的物理现实:系统确实在执行抽象,但抽象的复合受到高维张量投影重叠的物理制约。
隐式思考深度:测试期算力缩放法则的新可能
当前大模型领域的核心驱动力之一是“测试期计算扩展”(Test-Time Compute Scaling)。在传统思维链范式下,增加测试算力意味着让模型生成更多、更冗长的思考 Token。而在 BDH-CQ 中,测试期算力展现了一种完全正交的存在形态:增加隐空间循环迭代轮数(Latent Reasoning Effort)。
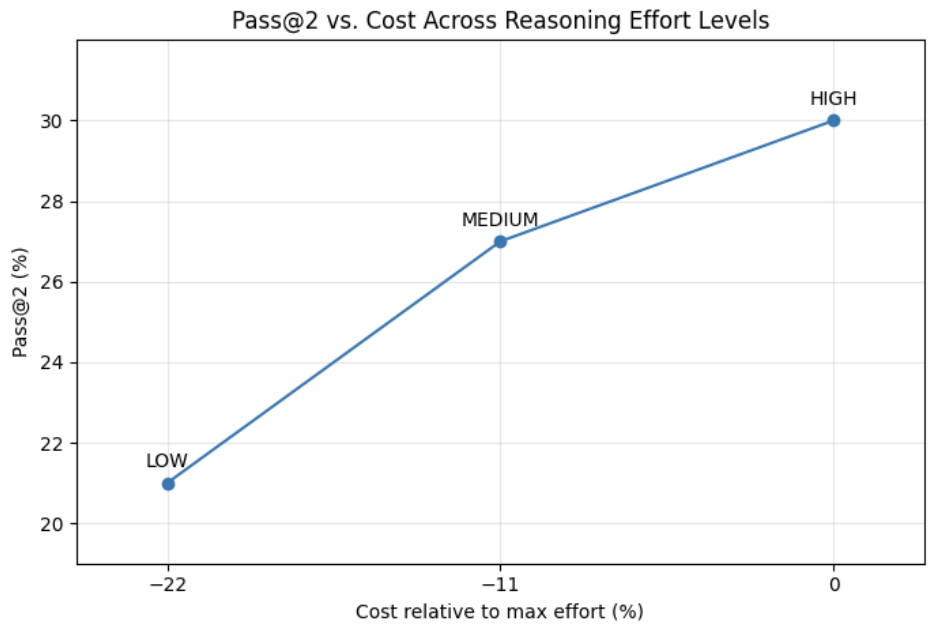
通过调节工作区隐式演化步数 $R$,实验完整描绘出了潜在思考深度对 pass@2 表现的驱动曲线。随着隐式循环轮数的增加,模型对复杂网格的候选解排序与局部错误修复能力呈现出单调递增的趋势。这意味着,即使完全剥离外在的离散词表,系统依然能够在连续流形上通过反复折叠与非线性变换获得计算增量。
更为关键的是其对于评测可重复性的保障。许多基于采样生成的大模型在重复调用时表现出极大的方差,而 BDH-CQ 在标准努力层级下的重复请求达到了字节级别的完全一致(Byte-identical),消除了由于随机 Token 采样带来的偶发假阳性。而在排除任务 ID 与批次上下文干扰的“不透明标签”对照实验中,模型维持了完全一致的总分表现,确立了其所依赖的决策依据纯粹来自示例网格底层的几何拓扑,而非外部语义暗示。
迈向连续与离散交融的通用推理体系
BDH-CQ 的出现不仅为低成本突破 ARC 提供了一个具体的模型实例,更在深层次上引发了对通用人工智能(AGI)推理载体的再思考。
纯粹依赖思维链生成离散 Token 的模式存在天然短板:自然语言具有很强的局部序列约束,并不适合高效表达多重假设的高维并存与矩阵式的全局几何变换;而完全依靠梯度反向传播在测试期微调小模型,又由于计算开销与环境假设过于苛刻,难以嵌入实际的推理流水线中。
BDH-CQ 用极其精简的 150M 参数证明:在冻结权重的前提下,利用循环记忆高效摄取上下文少样本规范,并在高维连续隐空间内直接进行非语言式的多步逻辑计算,是一条完全可行且极度高效的技术路线。由于 BDH 底层原生支持张量切分并具备与 Transformer 类似的参数扩展法则,作者在展望中透露,该架构目前在向十亿(1B)乃至千亿(600B)规模拓展时依然保持着良好的预训练可扩展性。
在未来的智能架构中,最理想的状态或许既不是单一的纯文本长思维链,也不是完全封闭黑盒的隐空间推演,而是二者的系统性杂交:系统在内部以超低成本的连续隐式流形执行高维探索、并行假说验证与空间想象,仅在需要进行形式化验证、工具调用或跨智能体交互协作时,才按需将关键认知状态解码投射为离散语言。BDH-CQ 在 ARC-AGI-1 上迈出的这极具能效比的一步,正清晰勾勒出这一融合范式的早期轮廓。