PAUSE:面对真实系统权限与状态,顶尖大模型完成率为何不足70%?
PAUSE: A User-Centric Benchmark for Personal AI Assistants in Unified Service Environments
在大模型技术快速向应用层渗透的今天,打造一个无所不能的“个人 AI 助理”(Personal AI Assistant)已经成为各家头部实验室与创业公司的兵家必争之地。业界设想的助理不仅要能聊天答疑,更要作为具备工具使用能力的自主智能体(Tool-augmented Agent),深入用户的日常数字化生活:管理健康档案、跨设备同步生理数据、甚至自主在电商平台中统筹优惠券并下单。
ArXiv URL:https://arxiv.org/abs/2607.27354
然而,实验室里的演示 demo 往往与真实的部署环境存在巨大鸿沟。最新提出的基准测试 PAUSE(Personal AI Assistants in Unified Service Environments)直截了当地揭穿了这种繁荣表象:在包含持久化用户状态、严格权限隔离和动态系统配置的真实个人服务环境中,即便是当前最强大的前沿模型,在涉及状态推理与配置感知的任务上,任务完成率也普遍跌破了 70%。
这项研究表明,大模型智能体在现实场景中的核心瓶颈,已经不再是“能不能根据描述调对 API”,而是在于面对复杂的个人系统权限、隐式的前置条件依赖以及需要用户亲自介入授权的交互闭环时,智能体能否维持长程状态的一致性与推理能力。
从工作流拼装到一体化个人环境
要理解 PAUSE 的独特价值,首先要审视当前主流智能体基准的局限。近年来,以模型上下文协议(Model Context Protocol,MCP)为代表的评测体系大幅扩充了工具的调用规模,智能体动辄面对成百上千个外部真实接口,测试重点主要集中在复杂工作流的规划与工具编排能力上。
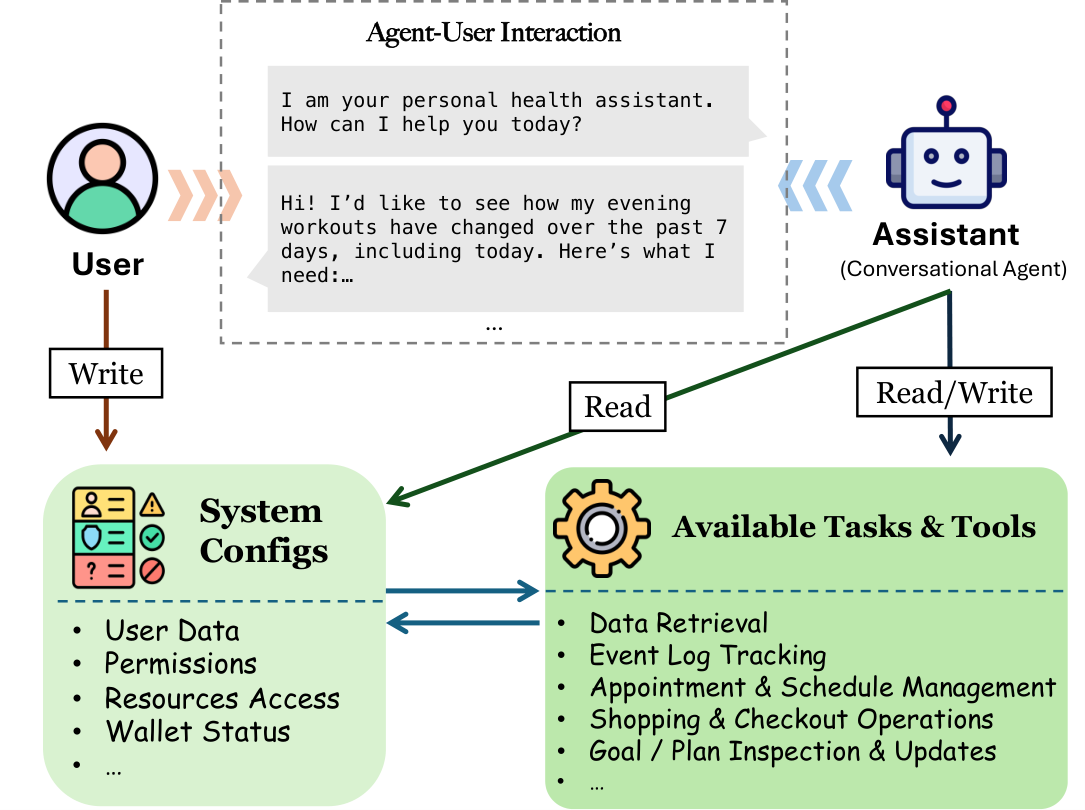
但这类测试往往将环境抽象成了扁平化的工具箱,忽略了个人数字助理最核心的运行底座:一个统一且具有强约束的“个人中心服务系统”。在现实场景中,用户的个人助理绝非拥有无所不能的管理员权限。相反,它面临着严格的权限防火墙——助理可以读写部分日常业务数据(如查看心率记录、添加健康日程),但涉及底层系统配置(如开启第三方数据共享权限、绑定医疗机构接口、激活订阅服务)时,助理通常只有读取权限,修改动作必须明确引导真实用户在客户端手动完成。
此外,真实环境具有明显的“持久化状态”(Persistent User State)特征。服务之间存在强烈的隐式依赖,例如未在隐私设置中授权外设同步,智能体就无法抓取特定传感器的数据;如果用户没有开启某项高级功能,相关的高级分析接口就是处于被屏蔽或锁死的状态。以往基准要么割裂了不同服务之间的上下文,要么抹去了这层至关重要的系统权限限制,让智能体在无约束的“温室环境”中刷出了虚高的高分。
PAUSE 正是针对这一盲区设计的基准测试框架。研究团队将测试场景具象化在对隐私和多源数据要求极高的个人健康管理与个人消费领域,系统内生包含异构数据源(穿戴设备、体检报告、饮食记录)、外部医疗机构集成以及严格的权限门禁,彻底还原了智能体面对真实系统时的受挫环境。
状态化建模与双角色交互闭环
为了精确刻画这一环境的动态变化,PAUSE 将用户与助理的交互抽象为部分可观测的马尔可夫决策过程。在任意交互步 $t$,环境的潜在状态由三部分构成:用户拥有的多源数据资源、系统内部与外部的集成通道,以及最关键的用户级系统配置。系统配置直接决定了哪些工具是可见且可调用的,哪些数据源处于锁定状态。
在这一架构下,助理不仅要执行工具调用,还要在察觉到前置条件不满足时,通过自然语言与用户互动,告知权限缺失并给出明确的配置引导。整个交互流形成了一个严谨的交替链条:用户提出目标,助理评估后调用工具或返回自然语言,模拟的用户在收到反馈后根据意图推进对话或亲自修改配置,再将控制权交回助理。
为了让这种评测具备可复现性与扩展性,研究团队构建了一套自动化的端到端合成流水线。
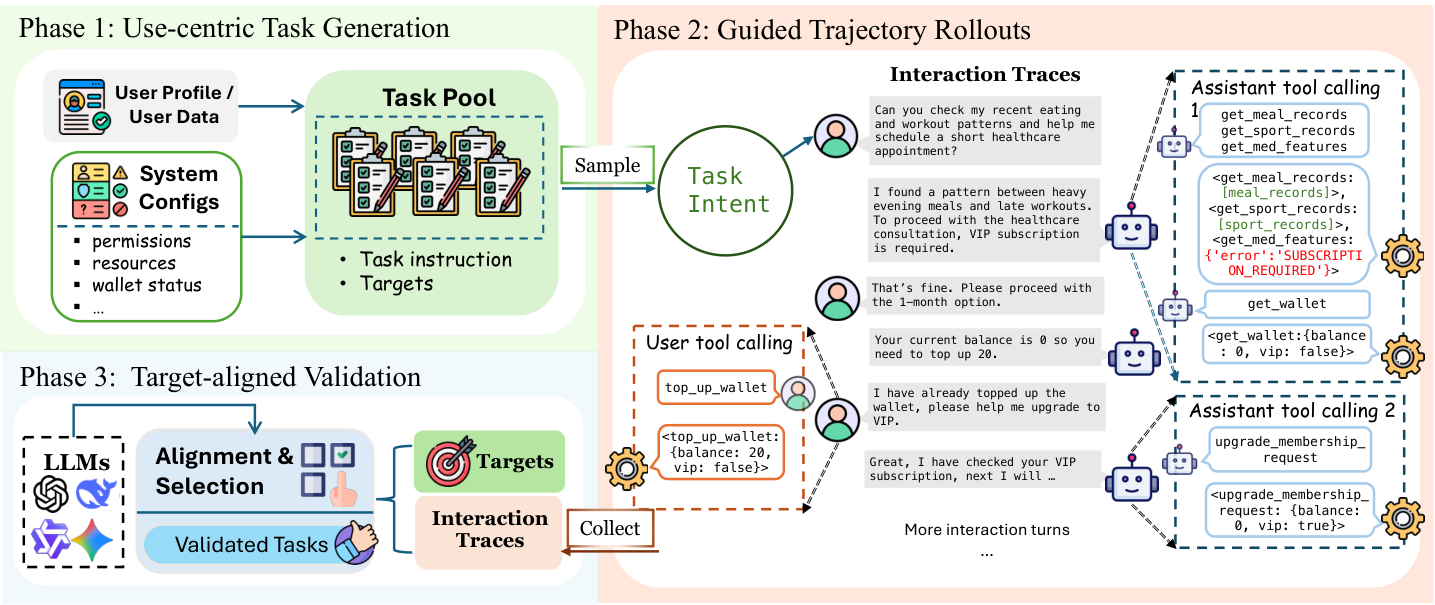
该流水线分为三个连续阶段:
-
任务与环境生成阶段:基于设定的用户画像与底层环境状态,合成出包含明确任务目标与隐式配置约束的复合任务,并将初始状态精准注入受控的沙箱环境中。
-
引导式轨迹展开阶段:由多个前沿模型分别扮演助理与用户角色,并在专家策略提示的辅助下协同完成交互,生成候选执行轨迹。
-
目标对齐与质量过滤阶段:由大模型仲裁委员会(LLM Committee)对候选轨迹进行严格的细粒度审核,不仅筛选出逻辑通顺、工具调用完备的优质轨迹,还将其拆解为一系列确定性的子目标集合。只有在能找到完全满足全部目标条件的参考轨迹时,该任务才会被纳入正式测试集。
这一流程从 300 多个候选场景中精心筛选提炼出 180 个高质量任务,划分为简单数据与日志追踪(63 项)、复杂数据与日志追踪(57 项)以及多约束购物任务(60 项),构成了高难度、高保真的评测集。
多范式评估:兼顾语义目标与状态确定性
面对高度开放的多轮人机交互,如何判定任务是否真正成功?如果完全依赖规则匹配,任何正常的交互变体都可能被误判;如果完全依赖 LLM 裁判,又容易出现主观幻觉。PAUSE 针对不同任务类型采取了差异化的多范式评测策略(Multi-regime Evaluation Framework)。
对于数据与日志追踪类任务,往往不存在唯一的标准执行路径。PAUSE 采用“目标导向的裁判”与“行为级轨迹重叠度”相结合的混合模式。一方面,将任务在生成阶段确定的一组可验证目标 $\boldsymbol{\tau}$ 作为锚点,由评估模型逐项核对智能体在交互结束后是否全部达成;另一方面,利用参考轨迹与候选轨迹中工具调用的精确率(Precision)、召回率(Recall)及 F1 分数,从行为模式层面对比智能体的调用相似度。
实验数据证实,目标完成度与轨迹重叠 F1 之间呈现出高度的强正相关性。这意味着高分模型确实走出了与优质解题路径相近的操作,排除了“巧合蒙对”的可能。同时,在针对大模型裁判与人类专家标注的一致性抽检中,两者取得了高度吻合,证明了这套语义与行为双重锚定方案的鲁棒性。
而对于商品导购与结算类任务,由于涉及清晰的数值与离散状态转移,PAUSE 则直接采用确定性的状态机验证。评测机制将任务分解为目标商品识别、尺码与数量匹配、最优优惠券使用以及总预算可行性四个硬性指标,不依赖主观评分,完全根据最终订单对系统状态造成的修改进行严格规则核验。
实验剖析:强弱模型的分水岭到底在哪里?
研究团队对业界多款主流前沿闭源与开源模型进行了深入测试,实验结果揭示了极具启发性的能力断层。
在简单数据追踪任务中,各家模型表现尚可,但在进入涉及长程交互与多重隐式限制的困难任务时,模型普遍表现出明显的疲态。即便是 GPT-5、Gemini-3-Flash 等最前沿的闭源大模型,在困难任务下的综合完成度依然被压制在 70% 以下;开源阵营和较小尺寸的模型在这些任务上的表现更为低迷。
仔细分析错误类型的分布,可以清晰看到模型能力的阶梯式断层。强模型与弱模型在 PAUSE 环境下的失效模式截然不同:
对于基础较弱的开源或小规模模型,其失败是全方位的系统性崩溃。它们在面对庞大的工具命名空间和复杂的个人资源库时,首先在资源导航层面就迷失了方向。这类模型经常出现幻觉调用、混淆相近的 API、或者在多轮对话中过早丢失上下文,连维持基本的数据一致性都无法做到。
相比之下,最顶尖的闭源模型展现出了极强的单一工具调用准确率和清晰的局部规划能力,能够准确检索到绝大部分个人数据。然而,它们主要折戟于系统配置推理与隐式依赖解耦。
在典型失败案例中,某个健康分析工具要求必须先在系统设置中激活“外部医疗提供商同步”。顶尖模型在遭遇工具报错或空返回时,缺乏逆向推导环境配置状态的洞察力;它们往往机械地重复调用相同的失败接口,或者在没有意识到权限缺失的情况下,轻率地向用户输出错误的虚假结论,完全忘记了自己应当在对话中扮演引导者角色,提醒用户前往设置面板完成授权。
在针对性的消融实验中,这一推论得到了决定性的验证。当研究人员在提示词中显式补全系统配置的运行语义,指引智能体在遇到权限缺失时该如何引导用户处理后,以 Gemini-3-Flash 为代表的前沿模型在复杂任务中的系统级报错出现大幅骤降,整体完成率显著反弹。这直接证明:当前模型欠缺的并非是执行动作的执行力,而是在没有显式说明时,自主发现“动作受阻源于底层配置”、并能够跨越对话与系统边界进行溯因推理的元认知能力。
而在电商多约束优化场景下,模型则暴露出另一种有趣的短板。几乎所有前沿模型都能以极高的准确率找到目标商品,但在涉及尺码挑选、多张优惠券互斥计算以及最终账户余额校核时,得分却明显偏低。这反映出智能体虽然具备高超的语义理解能力,但在真实世界涉及多步状态转移的数值约束优化问题上,依然无法保持可靠的计算一致性。
面向未来:从工具拼装走向真实系统对齐
PAUSE 的提出给当前沉浸在工具调用打榜中的 Agent 研究敲响了警钟。过去以 API 集合为核心的评测路线,在不知不觉中过滤掉了真实部署时最刺手、也最危险的边界条件。
当个人助理真正进入手机操作系统或个人云端环境时,它所面对的一定是一个充满权限隔离、长久状态留存且极度依赖用户协同修改配置的系统。仅仅教会模型“按规范生成 JSON 参数”是远远不够的。未来的智能体必须具备系统级的环境意识(System-level Environment Awareness):能够动态追踪自己在当前系统中所处的权限等级,敏锐察觉调用失败背后的配置依赖,并在合适的时间点以最自然的方式把决策权安全地交还给人类用户。
通过构建这样一个兼具真实约束与可扩展流水线的评测底座,PAUSE 不仅揭示了当前顶尖大模型在通往真正个人智能助理道路上的核心短板,其开源的任务合成与轨迹筛选机制,也为后续针对系统级推理能力的数据蒸馏与模型微调提供了宝贵的基础设施。大模型要真正接管我们的数字化生活,必须先学会如何在一个处处受限的真实系统里,做一个懂分寸、知进退的合格助理。