中科院自动化所发布 PhiZero:不是像素预测,而是用 256 个离散符号推理物理世界
PhiZero: A World Model Built Around Physical Language
视频生成模型在画面质感和动态纹理上已经足以乱真,但在面对真实的物理交互时,往往暴露出难以掩盖的缺陷:网球高速撞向橡皮鸭,橡皮鸭纹丝不动;玻璃杯从桌沿滑落,却像气球一样漂浮或毫无阻力地穿过地面。这种“看似逼真、实则反物理”的现象,根源在于主流世界模型普遍采用在像素空间或高维视觉潜空间进行端到端预测的路线。这种做法把物体的质量、摩擦、重力和碰撞等复杂动力学规律,全部隐式包裹在巨大的连续张量之中,模型本质上是在拟合像素统计关联,而非理解物理演化。
ArXiv URL:https://arxiv.org/abs/2607.28624
针对这一本质瓶颈,中国科学院自动化研究所(CASIA)多模态人工智能系统全国重点实验室(NLPR)提出了全新的物理世界模型框架 PhiZero。PhiZero 的核心逻辑是摒弃直接在像素空间做隐式预测的旧范式,转而构建一套紧凑且离散的“物理语言(Physical Language)”。它将人类“观察现象—抽象归纳—显式推理—具象表达”的认知路径引入物理世界建模,开创了“先推理、后渲染”(Reason-then-Render)的两阶段架构:先在紧凑的离散物理符号空间内自回归推演未来的状态演变,再调用具有强大生成先验的扩散解码器将状态演化渲染为高清视频。
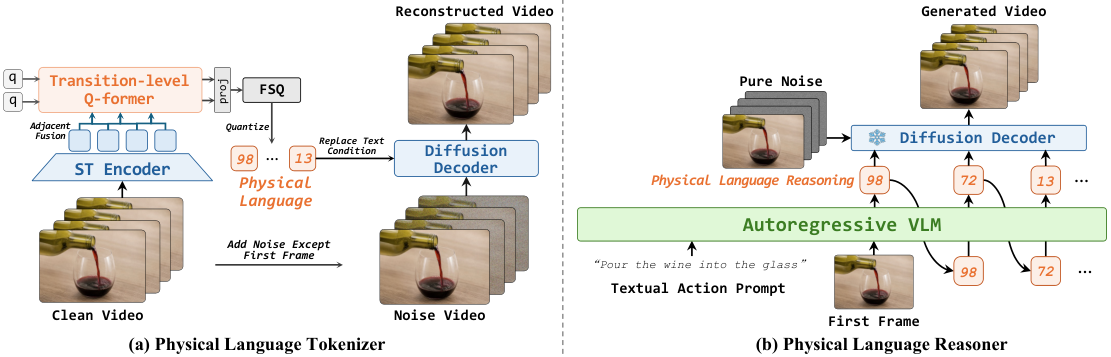
在该框架下,一段包含丰富物理交互的 4 秒高清视频,其全部未来状态转移可以被高度浓缩为仅 256 个离散符号。PhiZero 在 Physics-IQ Verified、PhyGround、WorldModelBench 等权威物理生成基准,以及 IntPhys2、LikePhys、YoCausal 等因果与物理理解基准上均取得了领先表现,展现了其在交互式仿真、细粒度动作控制以及零样本运动迁移上的广泛应用潜力。
为什么像素级预测难以学会真实物理?
人类在理解物理世界时,并不会在大脑中逐像素重构每一个视网膜细胞的明暗变化,而是提炼出因果与动力学模式——比如“推力导致位移”“重力导致自由落体”。自然语言是人类进行符号化逻辑推理的重要载体,但如果要精确描述物理世界的连续微观动态,自然语言词汇往往显得过于粗糙、模糊,存在严重的“信息带宽不足”。
以往的世界模型尝试用高维视频 VAE(如连续隐向量)直接建模,但这导致模型将有限的表征容量大量消耗在背景纹理、光影明暗和静态物体细节等外观信息上。真正关乎物理因果的状态转移反而被淹没在海量视觉冗余中。一旦测试场景的光影或外观发生微小变化,模型内隐的动力学预测就会迅速崩溃。
PhiZero 解决这一矛盾的核心切入点,在于将“静态外观”与“动态物理演化”实现彻底的结构性解耦:
-
静态场景由第一帧锚定:首帧图像提供场景中物体的纹理、光照、几何结构等静态背景先验;
-
未来演化由物理语言承载:视频的后续演进不再逐帧直接预测,而是被压缩并抽象为由离散符号序列构成的“物理语言”;
-
视觉生成由预训练先验兜底:扩散模型无需再强行隐式学习复杂的物理规律,只需扮演一个忠实的“渲染器”,在物理语言的显式约束和首帧外观的锚定下完成像素合成。
核心机制:物理语言分词器与离散状态转移
要建立这套物理语言,首要任务是在没有人工标注的情况下,完全通过自监督学习从海量自然视频中提取状态转移规律。PhiZero 设计了专门的 Physical Language Tokenizer(物理语言分词器)。
基于 Transition-level Q-Former 的时序归纳偏置
常规的视频 Tokenizer 通常将整段视频输入 3D 卷积或注意力网络,压缩出一个全局的表征向量,这抹平了不同时间步之间的因果因数。PhiZero 则显式建模相邻潜状态之间的单步转移。
给定一段视频 $\mathbf{V} \in \mathbb{R}^{B \times 3 \times T \times H \times W}$,首先通过时空编码器(基于 Wan2.2 VAE 架构初始化)提取隐层时序特征 $\mathbf{x} \in \mathbb{R}^{B \times C \times t \times h \times w}$。对于每一个相邻的时间步对 $(\mathbf{x}^{i}, \mathbf{x}^{i+1})$,PhiZero 使用一个共享权重的局部 Transition-level Q-Former 提取其状态变化表征:
\[\mathbf{q}_{i} = \operatorname{QFormer}\left(\mathbf{Q}; \mathbf{x}^{i}, \mathbf{x}^{i+1}\right)\]这种逐对建模机制引入了强烈的局部时序归纳偏置,强迫模型只关注“前一刻到后一刻发生了什么位移与交互”,大幅降低了单次压缩的学习难度,同时自然保全了物理时间序列的方向性与连续性。
有限标量量化(FSQ)构建离散词表
为了将连续的特征向量转化为可以像语言一样被自回归推理的离散符号,PhiZero 抛弃了传统 VQ-VAE 容易出现码本坍塌(Codebook Collapse)的离散码本学习方案,引入了有限标量量化(Finite Scalar Quantization, FSQ):
\[\mathbf{z} = \operatorname{FSQ}\left(\operatorname{Proj}_{\mathrm{down}}(\mathbf{q})\right)\]研究团队将 FSQ 的标量量化层级设置为 $(8, 5, 5, 5, 5, 5)$,在无需显式维护离散码本聚类的前提下,通过各个维度的笛卡尔积自然构建出一个规模为 $K = 8 \times 5^5 = 25{,}000$ 的离散物理符号词表。
在实际实现中,一段 33 帧的视频被编码为 9 个时序潜状态,产生 8 个相邻转移对。每个转移对通过 Q-Former 提取 32 个量化符号,最终整段视频的物理动态被精确压缩为 $(9 - 1) \times 32 = 256$ 个物理语言 Token。相较于常规视频 VAE 动辄需要 44,800 个连续 Token 来描述一段视频,PhiZero 将动态特征压缩了两个数量级以上。
注入扩散先验与 Pure-noise 预热训练
压缩到 256 个符号的极窄瓶颈,必须保证能被高质量解码还原。PhiZero 选择基于开源顶级视频生成模型 Wan2.2-5B 搭建 Diffusion-prior Decoder。解码器将预训练文本输入通道替换为投影后的物理语言上下文 $\mathbf{P}_{c} \in \mathbb{R}^{B \times N \times d}$,并以第一帧图像 $I^0$ 作为无噪声的清洁条件输入。
通过标准流匹配(Flow Matching)目标进行监督:
\[\mathcal{L}_{\mathrm{FM}} = \mathbb{E}_{\mathbf{x},\, \mathbf{\epsilon},\, \tau}\left[\left\|v_{\psi}(\mathbf{x}_{\tau}, \tau;\, I^{0}, \mathbf{P}_{c}) - (\mathbf{\epsilon} - \mathbf{x}_{0})\right\|_{2}^{2}\right]\]为了防止预训练强大的扩散模型在去噪早期偷懒(即仅依赖破损像素的局部关联而忽略输入的物理语言),团队设计了 Pure-noise Warm-up 机制:在训练初期,未来所有帧的潜变量全部从纯高斯噪声初始化输入,迫使网络必须全额依赖物理语言上下文与第一帧外观来重构后续画面。这一技巧有效避免了解码器退化走捷径,使得物理语言中沉淀的动态信息极其坚实。
显式物理推理:让 VLM 掌握物理语言的自回归推演
分词器构建了物理世界的“符号词表”,接下来的核心则是如何让模型在给定当前状态和操作意图时,自主“写”出正确的物理演变过程。这便是 Physical Language Reasoner(物理语言推理器) 的工作。
该推理器基于预训练多模态大模型 Qwen3-VL-4B 构建。大语言模型天然具备强大的逻辑连贯性和世界常识,但以往受限于只能输出文字或粗糙的 2D 检测框。PhiZero 将 Qwen3-VL 的词表直接扩充了 25,000 个新的离散物理原子符号。
推理器的任务被严格定义为:输入第一帧图像 $I^0$(世界初始状态)和文本形式的动作意图 $c$(例如“推翻桌上的积木”),自回归生成长度为 $N$ 的物理语言序列 $\mathbf{z}$:
\[p_{\theta}(\mathbf{z} \mid I^0, c) = \prod_{j=1}^{N} p_{\theta}(z_j \mid I^0, c, z_{<j})\]训练目标采用自回归交叉熵损失 $\mathcal{L}{\mathrm{VLM}} = -\sum{j=1}^{N} \log p_{\theta}(z_j \mid I^0, c, z_{<j})$。在推理阶段,当推理器输出 256 个物理 Token 后,直接接入已冻结的 Diffusion Decoder,渲染输出高清视频。
渐进式数据工程:从通用物理规律到强交互动作
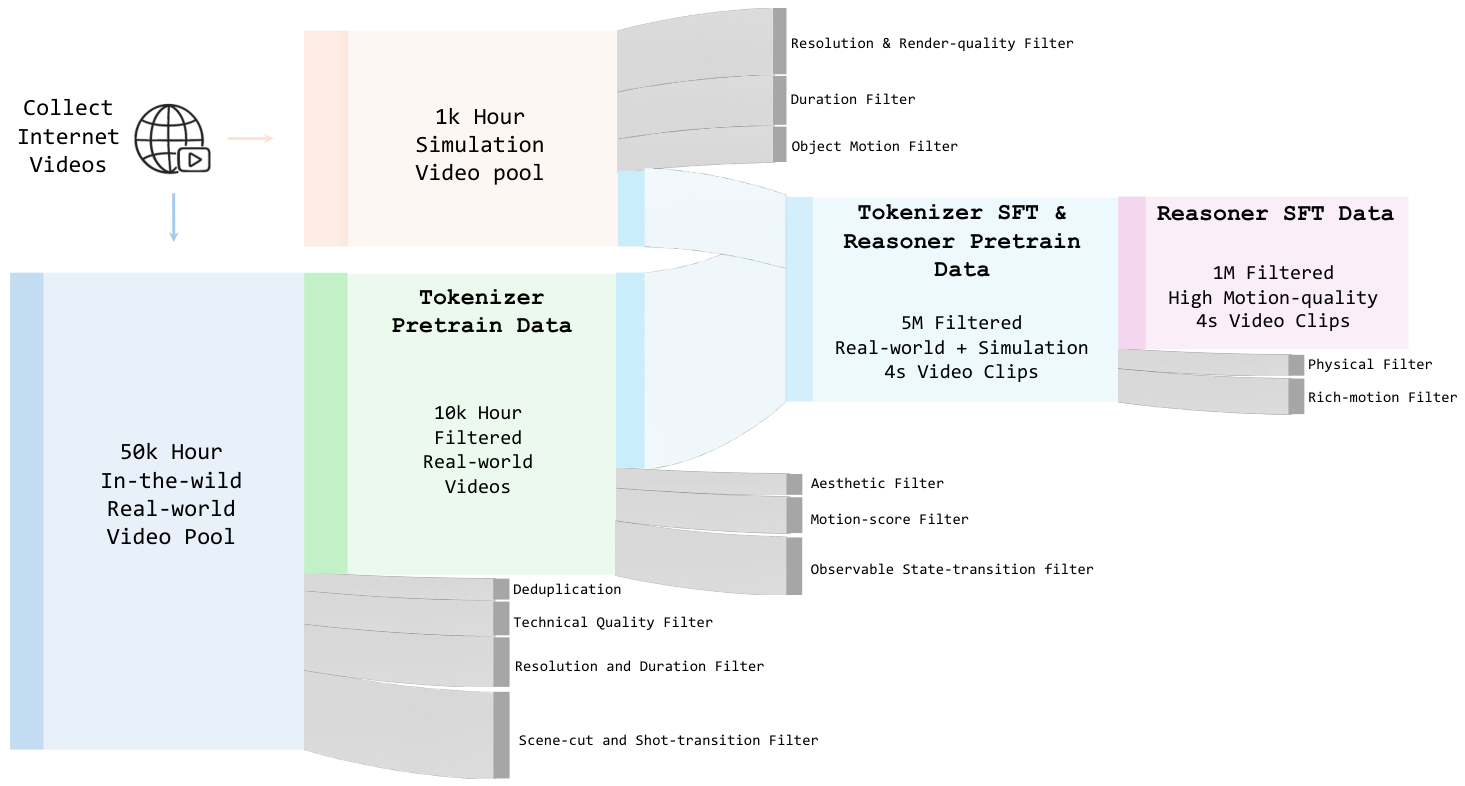
为了让模型学会准确预测动力学演化,研究团队搭建了严格的分层数据筛选管道(如上图所示):
-
分词器训练数据:从 50,000 小时真实网络视频中清洗出 10,000 小时无水印、无快速镜头切换、高保真的视频用于预训练;再结合 1,000 小时物理仿真视频,通过 VLM 动作可见度打分,筛选出 500 万条 4 秒高质量片段进行微调。
-
推理器训练数据:在 500 万条片段上,利用多模态大模型生成文本描述,强制要求 Prompt 仅总结发起动作与意图,严禁剧透后续交互结果,避免因果倒置。随后,通过基于运动幅度与物理交互显著性的过滤算法,精炼出 100 万条高动态、强物理交互片段实施第二阶段有监督微调(SFT)。
实验结果:物理规律一致性与全方位判别
实验针对“物理视频生成质量”与“物理因果理解能力”两个维度展开了系统评估。
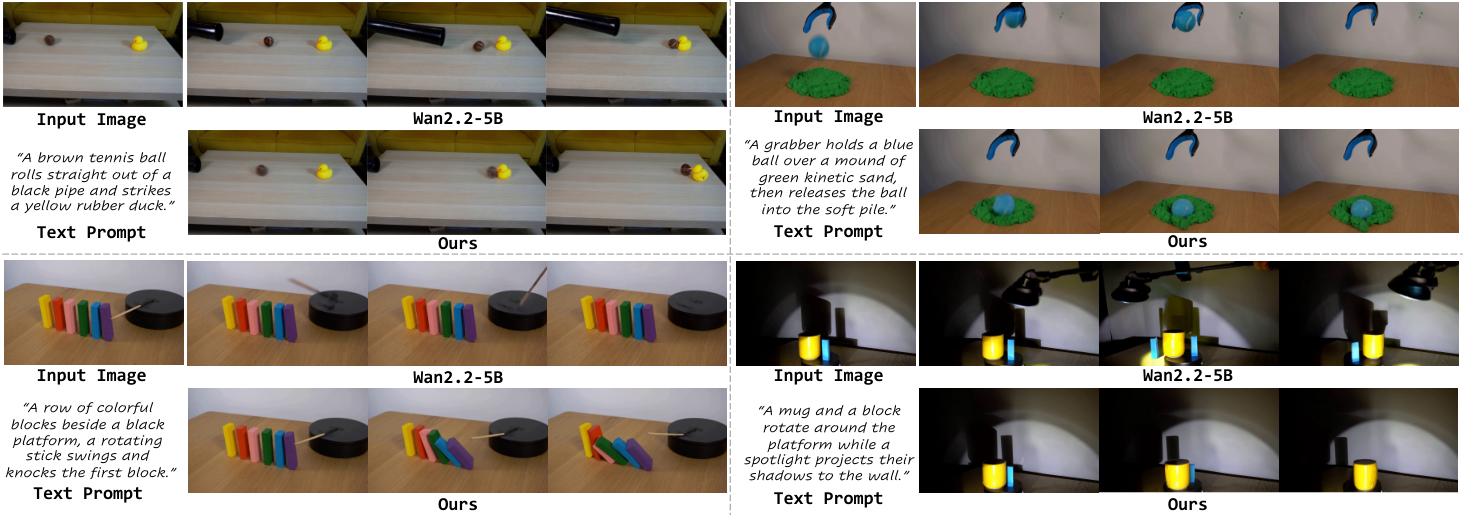
视频生成基准:解决“只见碰撞、不见反应”的通病
在 Physics-IQ Verified、PhyGround 和 WorldModelBench 三大生成评估集中,PhiZero 展现了显著超越直接在像素空间预测的基线模型的能力。
-
在专门衡量物理结果真实性的 Physics-IQ Verified 上,PhiZero 取得了最佳的 IQ-Score。
-
在引入物理专家 VLM 判别的 PhyGround 和综合性评测 WorldModelBench 中,PhiZero 的物理遵循度(Physics Adherence)均位列榜首。
从定性对比中可以清晰看到这种范式转变带来的质变。如上图所示,当网球击打橡皮鸭时,强大的直接扩散基线 Wan2.2-5B 能够生成网球击中物体的画面,但橡皮鸭在受力后几乎没有任何空间位移,重力形变与后续链式反应完全缺位。而 PhiZero 能够准确推演出击中后的弹性位移、因碰撞产生的重心倾覆、重力造成的下落挤压以及伴随光源变动产生的影子同步迁移。
重构能力消融:仅用 256 个 Token 的高保真表达
在针对分词器自身的测试中,研究人员在 500 条实拍视频($512 \times 896$ 分辨率、8 FPS)上评估了重构表现。常规 Wan2.2 VAE 输出的连续特征包含了 44,800 个连续 Token,而 PhiZero 仅使用 256 个离散 FSQ 符号。消融实验揭示了几个至关重要的设计取舍:
-
扩散解码器先验不可替代:若将扩散解码器替换为传统的确定性卷积或 ViT 解码器,重构质量出现断崖式下跌。这证明正是扩散解码器强大的生成先验承担了静态纹理与画质渲染,才将离散瓶颈彻底释放,专注于动力学转移。
-
Transition-level 设计带来关键增益:若将 Transition-level Q-Former 改为从全视频抽取全局特征的传统结构,重构指标显著恶化,证实了显式建模相邻步局部差分对学习状态转移的必要性。
-
Pure-noise Warm-up 的防惰性作用:若移除纯噪声预热环节,解码器更容易依赖去噪过程走捷径,导致物理语言包含的动态信息利用率受损。
物理判别理解:用对数似然进行因果检验
理解世界的物理规律,不仅要求“能生成”,还要求“能判断”。PhiZero 可以自然利用其自回归推理器计算给定视频的先验对数似然 $\log p_\theta(\mathbf{z} \mid I^0, c)$。
在 IntPhys2(直觉物理)、LikePhys(仿真物理合理性判断)和 YoCausal(真实世界因果关系分析)三大理解基准中,测试均采用严格的成对比较协议——即在一组符合物理常识的真实视频与其经过对抗性编辑修改的“反物理/反因果”版本之间进行二选一判别。PhiZero 将两段视频分别输入物理分词器得到离散序列,计算推理器给出的条件似然度,选择似然度更高的一方作为真实合理结果。实验表明,PhiZero 在三大基准上均显著优于传统多模态模型,准确识别出物体突然悬空、穿模、逆因果运动等物理违例。
广阔应用:交互式模拟与零样本运动迁移
拥有了显式、离散、模块化的物理语言后,PhiZero 的能力边界不再局限于单次视频补全,而是展现出作为通用物理模拟引擎的多重潜力。
-
交互式连续世界模拟(Interactive Rollouts):在序列化控制信号输入下,PhiZero 能够以自回归方式将前一步预测输出的视频最后一帧作为新的初始状态 $I^0$,接收新的动作意图后持续推演下一个 256 Token 的物理语言序列。这种闭环步进推演保持了极高的物理因果连续性,不易出现传统长视频自回归退化引起的画面崩溃。
-
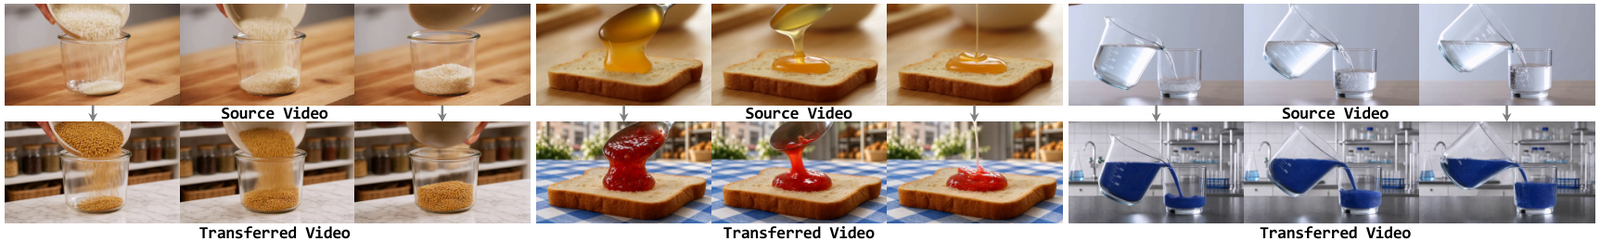
零样本运动迁移(Zero-shot Motion Transfer):既然物理语言独立于物体的表面外观,那么从视频 A 中提取出的物理语言序列 $\mathbf{z}_A$,理论上可以直接施加给完全不同外观的物体 $I^0_B$。如上图所示,模型可以将一段机械臂抓取杯子的物理动作语言,无缝作用于一个处于全新场景、完全不同材质特征的容器上,完成零样本的动力学轨迹迁移,而无需对目标场景进行重新训练微调。
-
细粒度动作条件模拟:由于推理器接受文本动作意图作为显式条件输入,在物理语言的桥梁作用下,用户输入“轻推”“猛击”或带有特定方向、受力大小的控制指令时,模型能精准映射出不同幅度的离散物理状态转移序列,呈现出细粒度动作驱动的物理模拟。
走向显式推理的物理世界模型
PhiZero 的核心价值在于提供了一种跳脱出纯像素自回归局限的物理世界建模解题思路。
长期以来,视频生成界存在一种假设:只要网络规模足够大、训练视频足够丰富,在像素空间执行大规模预测就能“自然涌现”出完整的世界物理规律。然而这一路线不仅带来了巨大的计算冗余,而且在遇到长尾物理因果与高频精细交互时频繁碰壁。
PhiZero 的实践表明,将动态因果(物理语言)与静态外观(第一帧及扩散渲染先验)解耦,把生成问题重构为“显式离散推理 + 扩散高保真渲染”,不仅大幅降低了物理表征的维度(仅需 256 个符号),更让预训练语言模型的常识推理能力得以真正下沉至三维物理世界。这项工作为具身智能(Embodied AI)在虚拟空间内的闭环交互仿真、动作策略预演以及物理常识对齐,开辟了一条兼具可解释性与计算效率的全新路径。