RoMeRL:降维效用状态打破智能体“记忆-奖励陷阱”,显存开销直降84%
RoMeRL: Balancing Feedback Coverage and the Memory-Reward Trap in Self-Evolving Agent Memory via Reduced-Order Utility States
在大语言模型(LLM)驱动的自主智能体(Agent)研究中,如何让智能体在不微调模型参数的前提下“越用越聪明”,一直是一个核心命题。近年来的主流路线逐渐从基于预设规则、文本反思的静态记忆库,演进为借助强化学习机制进行自演进的“可学习记忆系统”。其基本逻辑非常直观:智能体将过去的交互轨迹存入记忆库,并为每条轨迹赋予一个可更新的效用值(Utility / $Q$ 值);后续执行新任务时,检索模块结合语义相似度与该效用值挑出最优经验放入 Prompt,最后根据任务成败利用奖励信号更新被检索轨迹的效用。
ArXiv URL:https://arxiv.org/abs/2608.02508
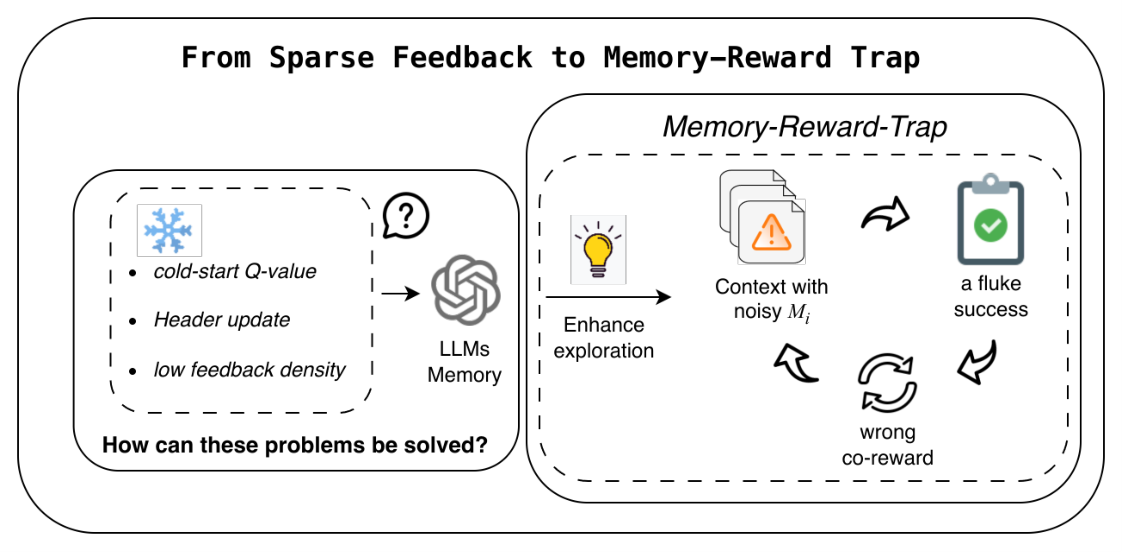
然而,这种看似自洽的机制暗藏着一个根本性的结构矛盾。随着智能体交互轮数的增加,记忆库中轨迹索引的效用状态空间不断膨胀,导致有限的下游反馈被严重稀释,出现大量从未被更新的“冷启动”效用(Cold-Q)。如果采用强探索策略(如 UCB)强行提升低频记忆的召回率,又会触发更致命的记忆-奖励陷阱(Memory-Reward Trap, MRT):当无关、低质或失败的记忆与有效记忆被打包召回、且该轮任务最终成功时,粗粒度的整条轨迹奖励会被无差别分配给所有被召回的记忆,导致劣质记忆被错误强化并持久盘踞在检索前列。
针对这一困境,最新研究提出了 RoMeRL(Reduced-Order Memory Reinforcement Learning)。它放弃了给每一条历史轨迹单独赋予效用值的传统做法,而是将无限膨胀的轨迹级状态空间映射为每个任务仅保留 4 个固定语义坐标的降维效用状态。这一设计不仅在理论上证明了可以大幅聚集反馈密度、限制错误扩散,还在 ALFWorld、LifelongAgentBench 和 AppWorld 等多项严苛基准上,实现了综合胜率超越强基线 MemRL、冷启动率骤降 $80.0\%$、记忆池体积缩减 $84.4\%$ 以及 LLM 调用减少 $21.1\%$ 的综合提升。
探索越强死得越快:什么是记忆-奖励陷阱?
要理解 RoMeRL 的动机,首先需要看清现有基于强化学习的智能体记忆(如 MemRL 等)究竟卡在了哪里。
传统的自演进记忆库普遍采用以轨迹为索引(Trajectory-Indexed)的效用建模。假设交互到时间步 $t$ 时,记忆库中存储了 $N_t$ 条轨迹,整个系统需要维护的效用向量就是 $\mathbf{Q}t = (Q{1,t}, \dots, Q_{N_t,t}) \in \mathbb{R}^{N_t}$。在每个任务中,智能体检索出一个子集 $\mathcal{S}_t$,执行完任务获得整体奖励 $R_t$ 后,便对 $\mathcal{S}_t$ 中的所有记忆执行梯度或在线均值更新:
\[Q_{i,t+1} = Q_{i,t} + \alpha\,\mathbb{I}[m_i \in \mathcal{S}_t](R_t - Q_{i,t})\]这种设计必然遭遇反馈稀释。新经验不断写入,状态维度 $N_t$ 随交互历史线性单调递增,但下游任务给出的真实交互反馈总数 $T$ 是极其有限的。其直接后果是大多数历史轨迹长期处于低访问状态,效用未收敛,系统对好坏经验的辨别力趋于失效。
一个直觉的补救措施是在检索阶段引入探索机制,例如在检索打分中加入置信度上界(UCB),强制模型多去查看访问次数少的记忆。然而作者在实验中发现,强行引入 UCB 后的系统不仅没有变好,任务成功率反而显著下滑。
这背后的根本原因正是图 1 所示的记忆-奖励陷阱(Memory-Reward Trap)。在多步智能体决策中,环境给出的奖励通常是整个交互轨迹级别的标量(0 或 1),属于典型的“捆绑式奖励”(Bundle-level Reward)。当多条记忆被同时召回进 Prompt 时,其中可能只有一条提供了关键线索,而其他低频记忆可能只是无关噪音甚至包含误导信息。但在整轮任务成功后,任务级奖励被同等赋予了上下文中的每一个成员。那些边际贡献为负或为零的记忆,仅仅因为搭了“便车”,其观测效用便被虚假推高,进而在此后的检索中频繁出现并持续污染下游决策。
作者从因果推断的角度严格形式化了这一现象:一条记忆的真实价值在于其干预边际效用 $\theta_i = v_i^1 - v_i^0$(即引入与不引入该记忆时的预期表现差异),而强化学习直接估计的只是观测效用 $\mu_i$。两者之间的差距不仅包含基线偏移 $v_i^0$,还包含混淆偏差 $a_i$。当一条记忆实际边际贡献 $\theta_i \leq 0$,但由于协同召回导致其观测值超过基线时,它就落入了记忆-奖励陷阱。随着存储轨迹数量 $N_t$ 的增加,潜在陷入陷阱的记忆期望数量 $\mathbb{E}[\lvert \mathcal{B}_t \rvert] = N_t \rho_t$ 也会无节制扩张,形成一个越探索越混乱的恶性循环。
降维打击:基于二维正交因式分解的 4 坐标记忆状态
既然“按轨迹索引效用”是膨胀与污染的根源,RoMeRL 的核心思想就是釜底抽薪:彻底切断“记忆条目数”与“可学习效用参数维度”之间的绑定关系。
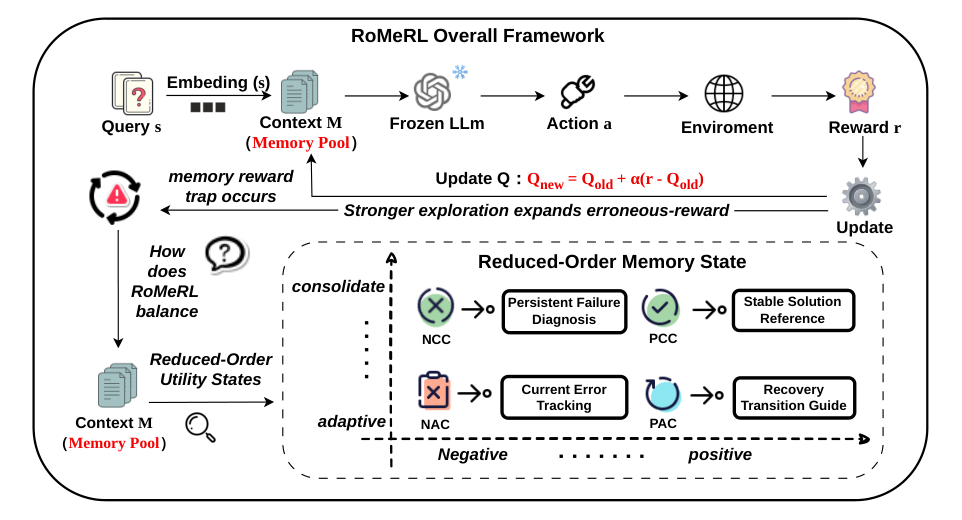
如图 2 下半部分所示,RoMeRL 将每个任务膨胀的效用空间压缩为一个固定维度的效用状态矩阵 $\mathbf{Z}_{g,t}$。这种降维并非随机投影,而是基于认知与控制逻辑,在两个二元正交维度上进行因式分解:
-
结果极性(Outcome Polarity, $\mathcal{O}$):区分正向证据($+$)与负向证据($-$),分别对应成功与失败经验。
-
记忆动态(Memory Dynamics, $\mathcal{D}$):区分全局固化的历史最佳证据(Consolidated, $\mathrm{C}$)与刻画状态跃迁的自适应证据(Adaptive, $\mathrm{A}$)。
二者的笛卡尔积构成了一个极其精炼的 $2 \times 2$ 语义坐标系(Semantic Coordinates):
\[\mathcal{I}^{\mathrm{fact}} = \{+, -\} \times \{\mathrm{C}, \mathrm{A}\}\]对任意任务 $g$,记忆状态在任意时刻只维护至多 4 个具名坐标,每个坐标包含一段具体交互内容及其对应标量效用 $z_{g,t}^{o,d} = (m_{g,t}^{o,d}, Q_{g,t}^{o,d})$。当新交互发生后,新经验并不以新变量的形式无限堆叠,而是在这 4 个固定卡槽中竞争、更新或替换:
-
正向固化坐标(Positive Consolidated Coordinate, PCC, $z_{g,t}^{+,\mathrm{C}}$):记录全局最高效的成功参考。在所有成功轨迹中,系统始终保留执行步数最少、效率最高的一条。当出现更高效的成功路径时,替换发生,但新轨迹会直接继承前任累积的效用值作为热启动,保障效用收敛的延续性。
-
正向自适应坐标(Positive Adaptive Coordinate, PAC, $z_{g,t}^{+,\mathrm{A}}$):记录智能体从“失败到成功”的跃迁经验。系统锁定该任务第一次遭遇失败的时间点 $t_g^{\mathrm{fail}}$,并在该时间之后捕捉最早出现的一条成功轨迹。它刻画了智能体跨越失败边界的转折点,为复杂问题提供纠偏示范。
-
负向固化坐标(Negative Consolidated Coordinate, NCC, $z_{g,t}^{-,\mathrm{C}}$):并非所有失败都是无价值的垃圾,部分失败经验具有极高的下游警示或边界探索价值。NCC 专门筛选效用超过负向初值阈值 $Q_{\mathrm{init}}^{-}$ 的失败轨迹,并在其中挑选受反馈验证后效用最高的经验保留下来。
-
负向自适应坐标(Negative Adaptive Coordinate, NAC, $z_{g,t}^{-,\mathrm{A}}$):动态追踪智能体当前最直观的失误状态,始终锁定时间戳最新的一条失败轨迹,防止模型在近期踩过的坑里重复犯错。
在检索阶段,检索池的最大候选量被严格约束在 $\le 4$ 个条目内。检索打分结合文本 Embedding 余弦相似度与对应坐标的效用值:
\[\operatorname{score}_t(m_{g,t}^{o,d}) = (1-\omega_Q)\cos(e(x_t), e(m_{g,t}^{o,d})) + \omega_Q Q_{g,t}^{o,d}\]并依据任务预算取出 Top-$k_{\mathrm{ret}}$ 个坐标喂入上下文。
为什么只有 4 个维度却更有效?理论保证
将庞大的历史库压缩到 4 个坐标,会不会严重损失表达能力?论文在理论层面对这种“低阶效用状态”的收敛性与抗污染性给出了严谨论证。
首先是反馈集中效应(Feedback Concentration)。在传统的全量轨迹索引下,根据 Hoeffding 不等式与联合界约束(定理 2),要以高概率保证所有条目的效用估计误差在 $\epsilon$ 以内,所需的交互步数规模与记忆库大小呈现 $O(\frac{N_t}{k\epsilon^2}\log \frac{N_t}{\delta})$ 的超线性关系,且该理论预算只能控制估计方差,完全无法消除由协同召回带来的固有归因偏差 $v_i^0 + a_i$。
而 RoMeRL 将有效状态维度固定为 $d=4$。在总交互预算为 $T$、单次更新上限为 $k$ 的平衡分配下(定理 3),每个效用坐标平均接收到的反馈次数从全量方案的 $\bar{n}_{\mathrm{full}} \approx \frac{kT}{N_t}$ 直接跃升为:
\[\bar{n}_{\mathrm{fact}} = \frac{N_t}{4}\bar{n}_{\mathrm{full}}\]其平均效用估计方差从 $O(\frac{\sigma^2 N_t}{kT})$ 骤降为 $O(\frac{4\sigma^2}{kT})$。这意味着在极度稀疏的真实场景交互中,有限的奖励信号被高浓度注入到这 4 个核心语义槽位中,使得每个槽位的效用值能够极速收敛,彻底根除冷启动问题。
其次是错误常驻上界的严格受限(Proposition 1)。在全量池中,一旦噪声轨迹进入陷阱,其往往因为长期不被访问而“永久存留”。而在 RoMeRL 的马尔可夫替换机制下,假设单坐标从未受污染向受污染状态跃迁的概率至多为 $\gamma$,而被干净样本替换清洗的概率至少为 $\lambda > 0$,则在稳态分布下,受污染坐标的期望数量上限被锁死为:
\[d \cdot \frac{\gamma}{\gamma + \lambda} = 4 \cdot \frac{\gamma}{\gamma + \lambda}\]只要该数值小于全量池中的预期陷阱规模 $N_t \rho_{\mathrm{full}}$,降维系统就能在数学上天然屏蔽错误反馈的无限扩散。
实验评测:全维度压制全量记忆,性能与效率双赢
为了验证 RoMeRL 的真实表现,作者在涵盖终身操作系统/数据库交互的 LifelongAgentBench、具身家庭规划基准 ALFWorld 以及复杂多应用协同工作流 AppWorld 这三大异构 Benchmark 上,与静态检索(RAG、Mem0)、智能体反思记忆(MemP)、测试时缩放(Pass@$k$)以及当前最先进的运行时强化学习记忆(MemRL)展开了全方位对比。所有基线均基于冻结的 LLM 底模运行。
在涵盖 10 个评估单元的综合指标中,RoMeRL 展现出了极强的一致性优势:
-
核心任务胜率全面领先:如文内综合表现所示,RoMeRL 取得了 0.753 的全场最高宏观平均分,较目前最强的在线学习基线 MemRL(0.724)高出近 3 个百分点。在 ALFWorld 的 6 类具身规划任务中,RoMeRL 在其中 5 类取得第一;在以长程工具调用著称的高难度场景 AppWorld 中,RoMeRL 将场景目标完成率(SGC)从 0.286 显著提升至 0.326。
-
彻底解决效用冷启动与反馈稀释:在反馈动态追踪实验中,基线 MemRL 随着任务轮次推进,由于记忆条目激增,其未充分更新的冷启动效用占比(Cold-Q ratio)从最初的约 $29\%$ 恶化至 $44.9\%$。而 RoMeRL 凭借固定维度的坐标卡槽设计,将这一比例大幅压制到 9.0%(降幅达 80.0%),单位状态接收到的反馈密度更是实现了 6.0 倍 的暴增(从 4.96 跃升至 29.93)。
-
极佳的抗噪与抗陷阱能力(MRT 压力测试):在人为注入强探索机制与环境噪声的极端测试中,传统 MemRL 搭配 UCB 探索后,正向错误更新次数由 3.7 次飙升至 7.2 次,最终受污染记忆比例上升至 1.20%,成功率溃败;而 RoMeRL 依靠 4 坐标的在线替换与稳态约束机制,将错误更新压制在 2.4 次,最终污染率低至 0.15%,任务成功率稳定在 82.0% 的最高位。
-
惊人的系统级资源节省:自演进系统往往伴随着高昂的 Token 与显存开销。RoMeRL 不仅在打分逻辑上免除了对大模型庞大历史的逐条遍历,还将系统实际维护的记忆池体积直接降低了 84.4%(从 4.5 万条轨迹暴降至 7 千条以内)。更为关键的是,由于检索出的上下文极为精准,智能体在决策规划时的无效尝试和重试轮次大幅减少,整体 LLM API 调用次数下降了 21.1%(平均节省约 12 万次 LLM 调用)。
对未来智能体记忆系统架构的启示
RoMeRL 的研究提供了一个极具颠覆性的视角:在为自主智能体设计长期记忆演进系统时,“存得越多、记性越全”非但不是优势,反而是拖垮策略收敛的罪魁祸首。
此前的大量工作沉迷于借助矢量数据库构建无限膨胀的外置记忆库,随后引入复杂的遗忘曲线、重要性重采样或分层抽象算法试图从中捞出黄金。然而,真实交互环境的奖励信号本身就是稀疏、延迟且充满归因噪声的。在无限自由度的离散存储空间里强行运行强化学习,在统计学上注定会走向反馈稀释与奖励误归因的双重泥潭。
RoMeRL 证明了结构化“低阶参数化”的威力:通过将记忆的语义职能预先正交解耦(好与坏、稳态与跃迁),将有限的强化信号集中在极少数具备明确认知角色(Cognitive Roles)的语义坐标上,不仅大幅减轻了下游检索与提示词工程的负担,还让原本脆弱的运行时强化学习获得了罕见的抗噪收敛性。这一范式为后续构建高能效、可终身进化的轻量级自主 Agent 记忆底座,开辟了一条极具工程落地价值的新路径。