SciDataSailor:树搜索驱动科学数据探索,9B小模型成功率升至96.1%
SciDataSailor: Deep Scientific Data Exploring
在大模型技术重塑科研范式的浪潮中,大语言模型智能体(LLM Agent)在文献阅读、代码辅助乃至自动化实验设计上展现出不俗潜力。然而,当真正深入科研日常的“脏活累活”——面对未经过清洗、层级杂乱、缺乏文档说明的多模态科学数据仓库时,现有智能体往往暴露出致命短板。这些数据分散在各式各样的原始测量文件、注释脚本、衍生制品中,格式千奇百怪,缺乏统一的 Schema 和对外接口。人类科研人员尚且需要花费数天时间写脚本翻看目录、对齐元数据、做统计算法验证,而依靠文本 RAG 或简单 ReAct 循环的模型更容易在深层文件系统迷宫里迷失方向,陷入无休止的盲目试错。
ArXiv URL:https://arxiv.org/abs/2607.28098
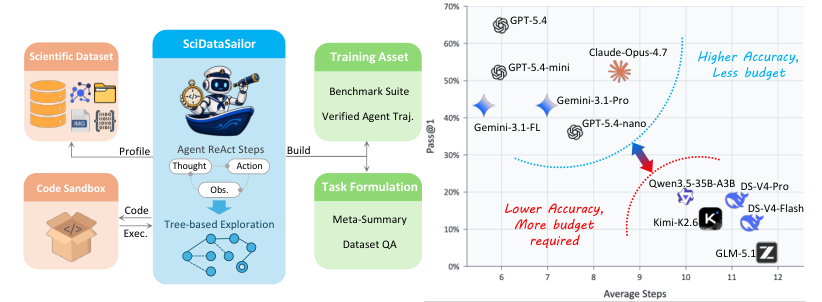
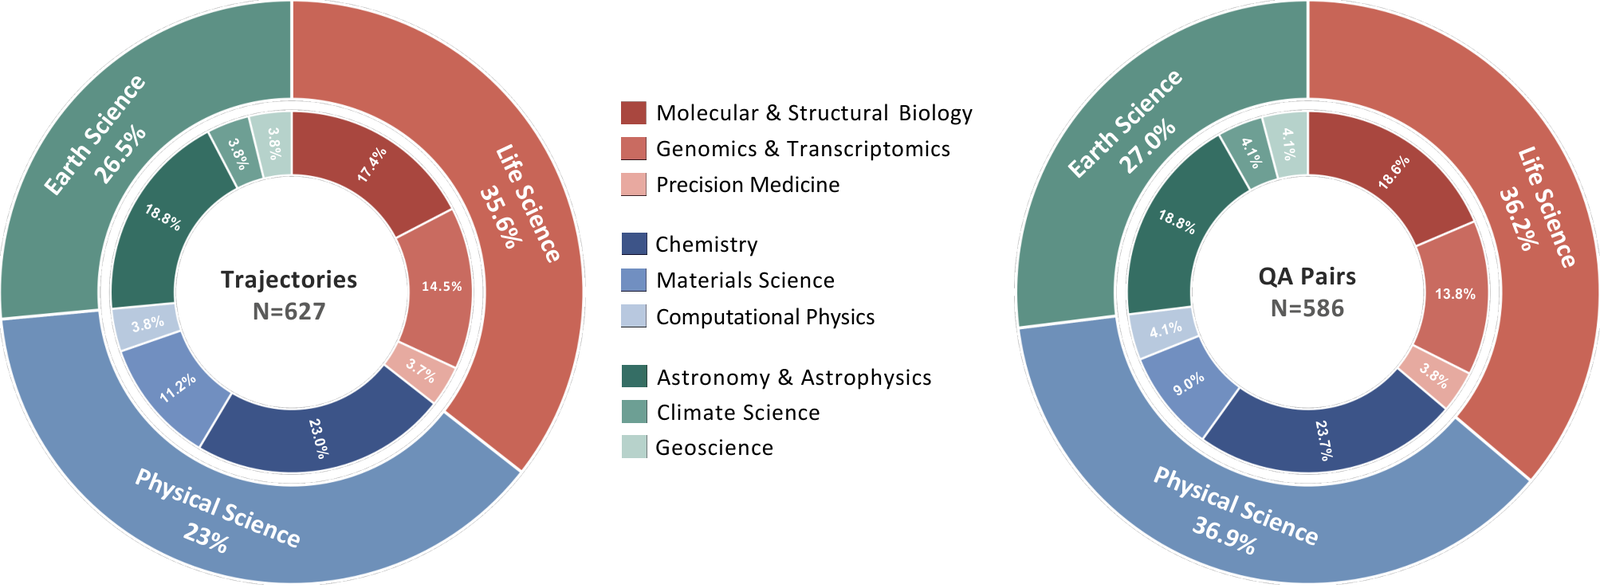
针对这一未被充分探索的真实现实痛点,上海人工智能实验室与同济大学等机构的研究团队提出了全新的任务范式——深度科学数据探索(Deep Scientific Data Exploring),并推出了端到端轨迹合成框架 SciDataSailor。该框架通过结合执行反馈的蒙特卡洛树搜索(MCTS),设计了难度分层探索种子、双反馈先手紧迫度、分层策略动作生成及熵自适应分支机制,成功低成本合成了高质量的可执行探索轨迹。基于此,团队开源了首个涵盖生命、地球与物理科学 27 个复杂数据集的评测基准 SciDataSailor-Bench 以及监督微调数据集 SciDataSailor-SFT-2K。
这项研究最引人注目的结论在于行为模式的迁移与突破:在严苛的 12 步交互预算下,原本在复杂科学仓库探索中表现低迷的开源模型 Qwen3.5-9B,在接受 SciDataSailor-SFT-2K 微调后,任务成功率(Success Rate)从 49.76% 提升至 96.14%,Pass@1 准确率由 14.01% 翻倍达到 28.99%,平均探索步数更是从 10.21 步缩减至 6.24 步,展现出媲美前沿闭源模型的探索与执行效率。
科学数据探索:为什么不是简单的“写代码+网页检索”?
要理解 SciDataSailor 的价值,首先需要明确科学数据探索究竟难在何处。以往的 Agent 研究多聚焦在两类环境:一类是像 WebVoyager 这类网页端任务,强调通过浏览、点击、检索文本并总结回答;另一类是 SWE-bench 这类软件工程代码仓库,代码有严密的类定义、函数签名和测试用例可供抓手。
科学数据仓库的现实条件则恶劣得多。科学家在长期研究积累中生成的文件往往包含以下特征:
-
多模态与异质性并存:同一个实验目录下可能同时存放着 NetCDF4 气象格点数据、FITS 天文光谱图像、HDF5 高维矩阵、无表头的 TSV 实验记录以及零散的 Python 数据读取脚本;
-
Schema 隐式且强耦合:数据字段的实际物理意义、单位、坐标系统并没有明文规范,往往隐藏在代码脚本的注释或前置实验的日志文件里,读取一个数据文件必须先到另一个衍生目录找到对齐索引;
-
证据链依赖沙箱执行:模型无法仅凭肉眼或简单的“查看文件”指令获取答案,必须现场编写数据解析与统计分析代码,在可执行沙箱中动态运行,并根据程序输出(如数据分布、缺失率、交叉关联值)调整下一步探测行为。
在这一设定下,智能体面临长跨度(Long-horizon)的“探索(Exploration)与利用(Exploitation)”权衡难题。若缺乏有效策略,智能体要么在最表层的几个目录反复“打转”,耗尽交互轮数;要么在尚未摸清字段语义时便草率猜测,导致严重的幻觉。
为此,研究团队将科学数据探索形式化为长序列决策过程:智能体需要从探索意图出发,穿梭于目录层级,推断隐式结构,执行统计脚本,并在可复现的真实观察结果支撑下生成结论。
SciDataSailor:如何用树搜索合成科研探索轨迹?
若想让开源模型学会高难度的数据探索,高质量的过程级监督数据(Process-level Supervision)是核心前提。然而,依靠人类领域专家手动在真实数据集里一步步敲命令、记录日志来标注探索轨迹,成本高昂且难以规模化。SciDataSailor 的破局点在于,将轨迹合成转化为面向科学证据搜寻的改进版蒙特卡洛树搜索(MCTS)。
标准 MCTS 主要针对具有明确胜负结果的游戏环境(如围棋或通用单目标规划),直接套用在数据探索上会出现严重水土不服:传统价值估计偏好最快达成预设目标的分支,往往会抑制对数据全貌有益的“多维度探测”;冗余的浅层探测会过快消耗计算资源,而最终保留一条最优路径也无法满足高质量轨迹的多样性需求。
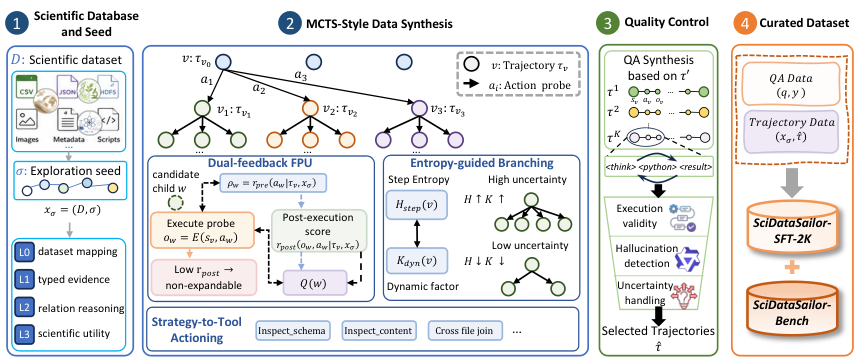
针对这些瓶颈,SciDataSailor 提出了四项关键机制,构建起一套自适应的数据生成闭环:
1. 难度分层探索种子(Difficulty-stratified Exploration Seeds)
研究者提炼了 8 类核心科研探索意图(包括文件组织与布局探测、隐式模式与类型推断、多源数据对齐、统计分布验证、异常值与质量审计等),并依据依赖关系划分为由浅入深的执行难度级别。搜索过程严格锚定初始探索意图,防止智能体在树搜索深处发散为无目的乱撞。
2. 双反馈先手紧迫度(Dual-feedback First-Play Urgency, DF-FPU)
在 MCTS 中,未访问节点的初值估计(FPU)至关重要。若初值过高,会触发大量低效的盲目试探;若初值过低,可能遗漏真正关键的深层线索。DF-FPU 引入了“执行前预判”与“执行后观测”的双重校准机制。对于候选动作 $a_w$,首先由模型生成执行前价值预估 $\rho_w = r_{\mathrm{pre}}(a_w \mid \tau_v, x_{\sigma}) \in [0,1]$。在同一父节点 $v$ 已经访问过的子节点集合 $\mathcal{S}_v$ 中,计算预估偏差:
\[\Delta_v = \begin{cases} \frac{1}{\lvert \mathcal{S}_v \rvert}\sum_{u \in \mathcal{S}_v}(Q(u) - \rho_u), & \lvert \mathcal{S}_v \rvert > 0 \\ 0, & \lvert \mathcal{S}_v \rvert = 0 \end{cases}\]进而对未访问节点的 $Q$ 值进行动态平移与修正:
\[\widehat{Q}(w) = \operatorname{clip}_{[0,1]}(\rho_w + \Delta_v - \delta_{\mathrm{fpu}})\]这一机制允许算法利用同级已执行动作的真实反馈,去动态抵消大模型对未执行动作的盲目自信或过度悲观。
3. 分层策略到工具动作生成(Hierarchical Strategy-to-Tool Action Generation)
大模型直接写代码往往缺乏全局规划。该机制要求树节点在扩展时遵循两阶段策略:先由 High-level 策略器决定科研意图(例如“需要先验证两张表的时间戳是否对齐”),再由 Low-level 工具执行器将其具象化为一段可运行的 Python 代码。这种设计确保了动作空间在科学策略层面的多样性,避免模型只在代码语法的细枝末节上无意义穷举。
4. 熵自适应分支(Entropy-guided Branching)
搜索预算不能平均摊派。当智能体处于关键分岔路口(例如发现多种潜在的文件关联方式)时,预测分布的熵 $H_{\mathrm{step}}(v)$ 较高,系统自适应扩大分支宽度 $k_{\mathrm{dyn}}(v)$,允许更宽广的探索;而当后续步骤显而易见(例如读取已定位文件的头几行)时,熵极低,系统收拢分支至单一路径,大幅节省算力。
在完成树搜索后,系统执行严格的反幻觉与可执行性过滤:丢弃任何无法在沙箱中复现的轨迹,并抽取核心观测事实生成科学问答对,最终提炼出高质量的微调语料库 SciDataSailor-SFT-2K 与评测集 SciDataSailor-Bench。
实验评测:闭源与开源的鸿沟,以及开源模型的逆袭
为了客观衡量模型在未见真实科学环境下的自主探索水平,研究团队构建了涵盖 27 个真实科研仓库的 SciDataSailor-Bench,内含 627 项元信息总结任务(Meta-Information Summarization)与 586 项科学问答任务(Scientific QA)。评测在严格的 Docker 代码沙箱中展开,分别设置 12 步和 24 步 ReAct 预算。
实验暴露出基座开源模型与前沿闭源模型之间显著的行为鸿沟。在 12 步预算的元信息任务中,GPT-5.4 展现出极高的一致性与专注度,仅用平均 6.03 步就达成了 65.22% 的 Pass@1 和 98.07% 的任务成功率。相比之下,主流开源模型表现普遍吃力:即便是 120B 规模的 GPT-OSS-120B,Pass@1 仅为 27.54%;而 Qwen3.5-9B-Base 的 Pass@1 仅有 14.01%,成功率不足一半(49.76%),平均步数逼近上限(10.21 步)。
当交互预算放宽到 24 步时,开源模型通过反复试错,性能出现了补涨(例如 DeepSeek-V4-Pro 的 Pass@1 从 16.43% 提升至 52.66%)。这一鲜明对比清晰地反映出:开源基座模型并非完全不具备工具调用和代码运行能力,其核心症结在于缺乏有条理的科学证据搜寻策略,在面对复杂文件布局时极易陷入漫无目的的试探。
然而,经过 SciDataSailor-SFT-2K 轨迹监督微调后,轻量级的 Qwen3.5-9B 展现出了脱胎换骨的性能跃迁。在 12 步限制下:
-
Pass@1 准确率翻倍:从基座的 14.01% 飙升至 28.99%;
-
任务成功率接近满分:从 49.76% 暴增至 96.14%;
-
探索步数近乎折半:平均步数由 10.21 步锐减至 6.24 步,不仅大幅领先同量级开源模型,更在步数效率上比肩 GPT-5.4。
即便在更具挑战性的科学问答(QA)子集中,微调后的 9B 模型同样表现亮眼,在 12 步和 24 步预算下,Pass@1 分别从基座的 9.56% 和 14.85% 跃升至 24.57% 和 22.53%。这表明,模型通过监督微调学到的并非简单的模式记忆,而是跨学科的通用科学数据探索逻辑。
行为学分析:单片求解器与代码密度的秘密
为什么仅用 2000 条高质量轨迹微调,就能让 9B 级别的小模型产生如此巨大的行为改变?研究团队针对代码抽象语法树(AST)与交互行为进行了细粒度的确定性对比分析,揭示了一个极其有趣的现象。
| 评估指标 | GPT-5.4 | DeepSeek-V4-Pro | Qwen3.5-35B-A3B | Qwen3.5-9B (SFT) |
|---|---|---|---|---|
| 平均代码行数 (Lines) | 29.7 | 42.1 | 51.3 | 74.9 |
| 控制流节点数 (Nodes) | 5.8 | 6.7 | 7.2 | 11.4 |
| AST 树深度 (Depth) | 8.2 | 9.4 | 10.1 | 12.3 |
| 单任务引入库数 (Imports) | 6.7 | 5.1 | 4.8 | 4.2 |
从行为统计中可以看出,不同模型展现出了截然不同的求解哲学:
-
闭源标杆 GPT-5.4 倾向于“模块化拆解”:它生成的单步代码块相对精简(平均 29.7 行),但调用的三方库种类极多(平均 6.7 个),擅长借助丰富的先验工具库,通过多次轻量交互逐步拼凑证据;
-
微调后的 Qwen3.5-9B 演化为典型的“单片求解器”(Monolithic Solver):受到 MCTS 高质量轨迹的熏陶,该模型生成的单次代码块极长(平均 74.9 行),控制流节点数几乎翻倍(11.4 个),AST 树深达到 12.3。它在单次工具调用中,就会构建包含复杂分支判断、循环遍历以及异常处理的完备脚本,力求在一个动作内把当前子任务的排查、对齐与计算全部跑通。
在超过半数探索无需容错恢复的场景下,这种“一鼓作气、首击必成”的单片求解策略展现出极佳的计算性价比,直接压低了交互轮数,避免了在多轮 ReAct 对话中上下文变长带来的注意力涣散。
从轨迹模仿到自主科研:前沿智能体演进的下一步
SciDataSailor 的研究表明,大模型智能体走向真实科研纵深,其核心卡点不是单点的 API 调用能力,而是在长程、不透明、高异质性的数据环境中,维持连贯的证据搜寻与验证策略。通过融合真实执行反馈的树搜索,研究者可以低成本且规模化地为开源社区注入这种高阶探索认知。
同时,论文也坦率地指出了当前的局限与边界:监督微调(SFT)虽然能让小模型迅速习得“专家级”的开局排查套路与长代码组织范式,但在面对未曾遇见的突发性运行时异常时,单纯的 Token 级模仿在自我纠错韧性上仍显单薄。将 SciDataSailor 产生的树搜索结构与具备环境反馈的强化学习(RL)相结合,让智能体在反复执行失败中学习动态回溯与自适应修复,将是通往完全自主“AI 科学家数据助手”极具潜力的下一站。