SG-WAM:告别像素级预测,策略内自指导动力学让0.9B模型在LIBERO达到98.5%
SG-WAM: Self-Guided World Modeling in Geometry-Aware Policy Space
在具身智能与机器人操作领域,世界动作模型(World Action Models, WAMs)正逐渐成为超越传统“看图出动作”端到端策略的核心范式。传统模仿学习策略仅依赖当前的单帧或多帧观察直接回归动作,往往难以对复杂、长程交互中的物理因果形成深层理解;而世界动作模型试图赋予机器人一种“前瞻”能力——不仅要输出当前怎么做,还要预测环境在动作执行后将如何演变。
ArXiv URL:https://arxiv.org/abs/2608.01397
然而,如何为未来的物理状态构建监督信号,一直存在关键取舍。以视频生成为代表的显式观测空间预测,需要耗费大量模型容量去复原光照、阴影、背景纹理等细枝末节,这些感知细节通常与操作成败弱相关;若转向紧凑的隐空间预测,以往方法又往往依赖外部预训练编码器或独立的辅助潜变量分支,导致预测空间与控制策略实际需要的特征空间脱节,同时极易丢失精细的空间几何信息。
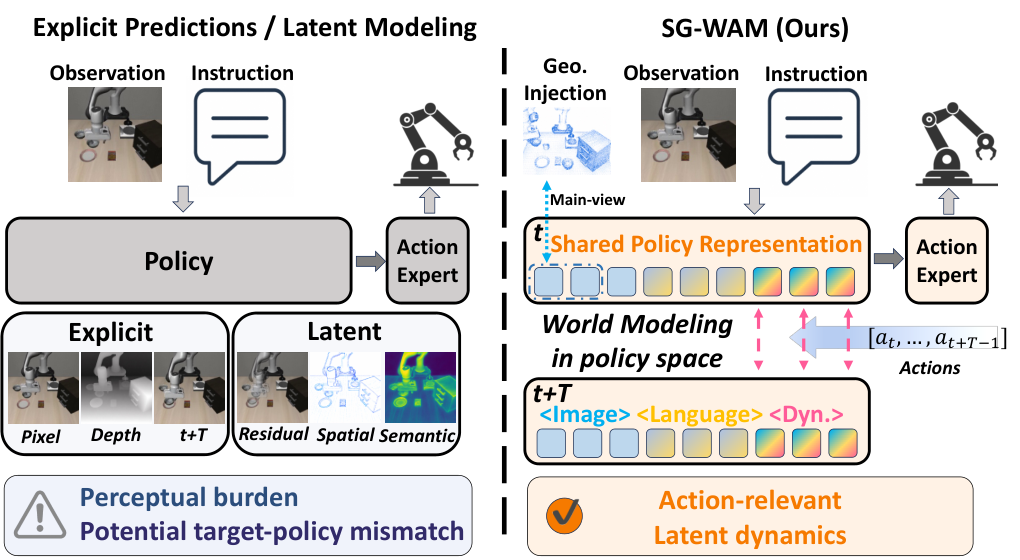
针对这一核心冲突,最新研究提出了 SG-WAM(Self-Guided World Action Model)。该框架摒弃了繁重的未来像素生成,也不引入外部异构的未来表征编码器,而是直接在策略自身的表征空间内建立动力学预测。整个系统仅基于 0.9B 参数量级的轻量骨干网络,在完全不依赖大规模具身数据预训练的前提下,在 LIBERO 基准测试中取得了 98.5% 的平均成功率,并在考验零样本抗扰动迁移的 LIBERO-Plus 上达到 73.0%,全面超越了参数量更大或依赖预训练的同类基线。
显式像素与外置隐空间的双重困境
为了理解 SG-WAM 的设计动机,需要先看清过去世界动作模型在状态表示上遇到的结构性矛盾。
第一类路线是观测空间显式建模。这类方法通常以生成未来图像、视频或光流图为媒介,再通过反向动力学推导动作,或是将预测的视觉特征注入策略。这种设计虽然直观,但在工程和表示学习上面临显著的“感知负荷”。真实操作场景中,抓取物体时桌面的木纹反光、背景中走动的人影、相机曝光微调等像素变动,对完成任务毫无帮助,却在均方误差或扩散损失中占据极大比重。模型被迫将宝贵的表征容量浪费在“生成一张逼真的图片”上,而非“理解夹爪与物体的空间接触关系”。
第二类路线是隐空间建模(Latent WAMs)。研究者尝试在特征空间规避像素重建负担,例如预测未来的视觉特征向量,或是利用自监督联合嵌入预测架构(JEPA)对齐潜在状态。然而,这类方法大多存在“目标与策略脱节”的隐患:生成未来预测目标(Target)的网络通常是预先冻结的通用视觉主干,或是与动作生成分支并行的辅助编码器。预测分支努力对齐的目标空间,并不等同于下游动作专家(Action Expert)生成位姿控制指令时所依赖的特征分布。更重要的是,过度的特征压缩往往会牺牲局部的三维几何结构,而机械臂操作恰恰极度依赖“物体边缘在哪里、法向如何、夹爪距离表面还有几厘米”这类高精度空间几何。
这就引出了一个核心挑战:如何构建一个既完全服务于动作生成策略、又内蕴精确局部三维几何的未来动力学对齐空间?
自指导动力学:用策略自身的 EMA 生成演化目标
SG-WAM 给出的解法,是在视觉语言模型(VLM)骨干序列中直接嵌入可学习的动力学查询标记(Dynamics Tokens),并提出自指导世界预测器(Self-Guided World Predictor, SGWP)。
在 SG-WAM 体系中,当前时刻 $t$ 的多视角图像观测与自然语言任务指令经过编码后,与一组可学习的动力学标记 $\mathbf{Q}$ 拼接在一起,统一送入在线 VLM 主干网络。模型在顶层输出上下文特征 $\mathbf{H}_t = [\mathbf{H}_t^V, \mathbf{H}^L, \mathbf{H}_t^Q]$。其中,$\mathbf{H}_t^Q$ 作为这组动力学标记提取出的高阶表征,充当了对当前物理状态的紧凑动力学摘要。
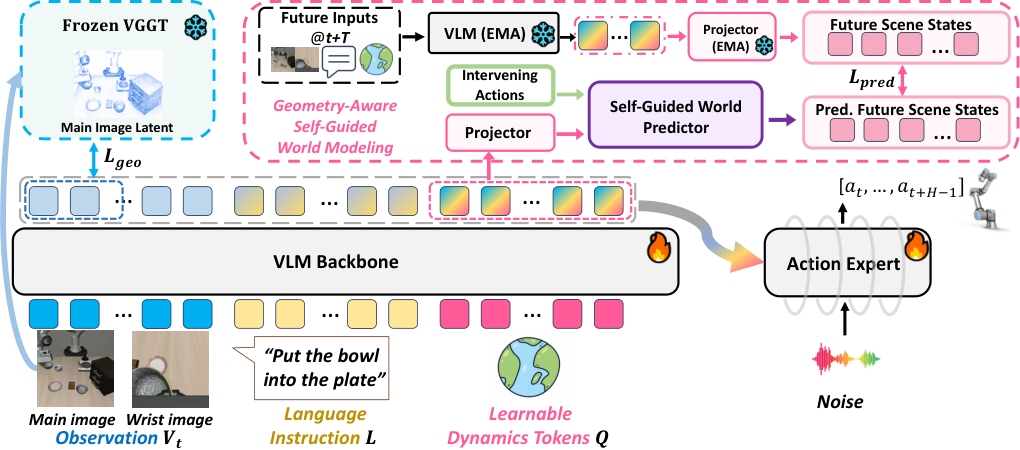
为了建模环境随动作的演化,系统并不去预测未来的整张图片,而是预测这组动力学标记在未来的状态。具体而言,模型给定介入动作序列 $\mathbf{A}t^{(\Delta)} = [\mathbf{a}_t, \dots, \mathbf{a}{t+\Delta-1}]$,通过一个轻量的动作编码器映射为动作嵌入,再由 SGWP 预测模块结合当前的动力学特征 $\mathbf{z}t^Q$(由 $\mathbf{H}_t^Q$ 投影得到),推断出经过 $\Delta$ 步物理动作交互后的未来动力学标记状态 $\hat{\mathbf{z}}{t+\Delta}^Q$。
关键的创新在于未来监督目标的来源。SG-WAM 没有引入第三方的未来特征提取器,而是保留了一个结构完全相同、参数通过指数移动平均(EMA)缓慢更新的目标策略分支。在训练阶段,未来的实际多视角观测输入到该 EMA 策略网络中,提取出对应的未来动力学标记表征 $\bar{\mathbf{z}}_{t+\Delta}^Q$。预测损失直接在二者之间计算:
\[\mathcal{L}_{\mathrm{pred}} = \frac{1}{N_{q}d}\left\|\hat{\mathbf{z}}_{t+\Delta}^{Q} - \operatorname{sg}\left(\bar{\mathbf{z}}_{t+\Delta}^{Q}\right)\right\|_{F}^{2}\]其中 $\operatorname{sg}(\cdot)$ 表示停止梯度反向传播。
这一机制带来了多重收益:首先,预测的目标与输入特征源自完全相同的模型表征家族,避免了跨模型特征对齐时的语义漂移;其次,EMA 缓慢演化的特性为在线策略提供了稳定、平滑的自监督锚点,规避了特征坍缩问题;最后,动力学预测的梯度直接回传至在线 VLM 主干,迫使这组动力学标记自主学习“哪些环境变化与动作因果直接相关”。
冻结几何教师:注入空间感知结构
单纯将动力学建模移入策略自身的隐空间,依然面临隐空间丢弃空间细节的风险。纯粹由动作模仿损失和潜变量预测驱动的表征,容易演变成高度抽象、缺乏精细空间坐标定位能力的语义向量。
SG-WAM 的第二个核心设计,是在训练阶段引入一个冻结的 3D 几何基础模型(VGGT)作为教师,对主视角的图像标记施加几何蒸馏监督。需要特别强调的是,这个几何教师并不参与未来预测目标的构建,也不直接约束动作头,它的唯一任务是规范在线 VLM 主视角视觉标记(Image Tokens)的局部几何表征。
主视角图像标记通过一个轻量投影层映射至几何特征空间,并与冻结几何教师提取的稠密几何特征计算余弦相似度损失 $\mathcal{L}_{\mathrm{geo}}$。由于自注意力机制的存在,这组带有显式空间几何约束的图像标记,会在 VLM 内部与动力学标记 $\mathbf{Q}$ 进行深度跨模态交互。
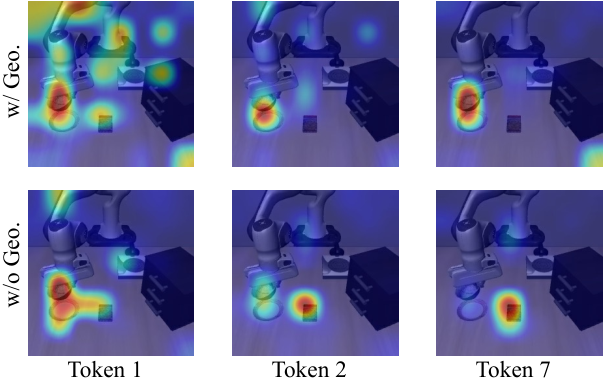
从注意力热力图的可视化结果可以清晰看到几何监督的物理意义:在没有几何监督时,动力学标记的注意力分布相对涣散或偏移;而引入几何监督后,动力学标记的交叉注意力高度聚焦在机械臂夹爪与目标物体即将接触的关键物理交互区域。几何结构先沉淀在视觉标记中,再作为底层上下文支撑动力学标记的预测,从而让隐空间动力学真正具备了三维空间定位的物理度量感。
在动作生成端,SG-WAM 接入了一个基于条件流匹配(Conditional Flow Matching)的动作专家。该动作专家直接以包含视觉、语言和动力学标记的完整上下文 $\mathbf{H}t$ 为条件,利用流匹配生成多步连续动作块(Action Chunk)。整个训练过程由动作模仿损失 $\mathcal{L}{\mathrm{act}}$、动力学预测损失 $\mathcal{L}{\mathrm{pred}}$ 和几何蒸馏损失 $\mathcal{L}{\mathrm{geo}}$ 联合端到端优化。
这种架构设计在推理阶段极其轻盈高效:几何教师、SGWP 动力学预测分支以及 EMA 目标分支在部署时全部剪除,在线推理只需保留单分支 VLM 和流匹配动作专家,以零额外计算负担换取了高质量的物理特征表征。
模拟与真实世界基准实测
为了严格检验表征在面对物理干扰与分布偏移时的稳健性,研究团队在标准仿真基准 LIBERO、包含系统性扰动的 LIBERO-Plus 以及实体机器人操作平台上展开了全面评估。
仿真表现:小参数量实现性能压制
在涵盖空间推理(Spatial)、目标操控(Object)、目标驱动(Goal)以及长时程任务(Long)的四大标准 LIBERO 套件中,SG-WAM 取得了 98.5% 的平均成功率。这一成绩不仅超越了大量依赖数十亿参数通用多模态大模型的具身策略,也显著优于依赖数千万级具身轨迹预训练的代表性架构。
更严苛的测试来自 LIBERO-Plus。该基准在原版任务基础上,对相机视角、机器人本体构型、自然语言提示、光照环境、背景纹理、观测高斯噪声以及物体空间布局施加了零样本强扰动。策略直接在未经任何微调的情况下进行迁移评测。
在这一极限泛化场景下,众多在标准基准上得分极高的强基准(如 Spatial Forcing、Fast-WAM)遭遇了明显的性能滑坡,其抗扰动能力因依赖脆弱的表征关联而大幅衰减。SG-WAM 则以 73.0% 的整体成功率位列榜首,并在相机扰动(81.5%)、语言语义泛化(78.5%)、光照突变(79.5%)和场景布局变化(72.5%)等维度上大幅领先对手。这直接证明了“几何感知约束 + 策略内动力学建模”能够剔除与操作无关的表面特征噪音,让表征牢牢锚定在物体的物理与空间属性上。
实体机器人验证:长时程与视觉扰动下的鲁棒表现
在真实硬件部署中,实验平台采用单台 UR5e 机械臂,配备 Kinect Azure 主视角深度相机与 RealSense D405 腕部相机,设置了抓取放置(Pick and Place)、毛巾对折(Towel Folding)以及更为复杂的工具箱收纳(Toolbox Organization)三项任务。每项任务仅依赖 100 条示教轨迹进行微调。
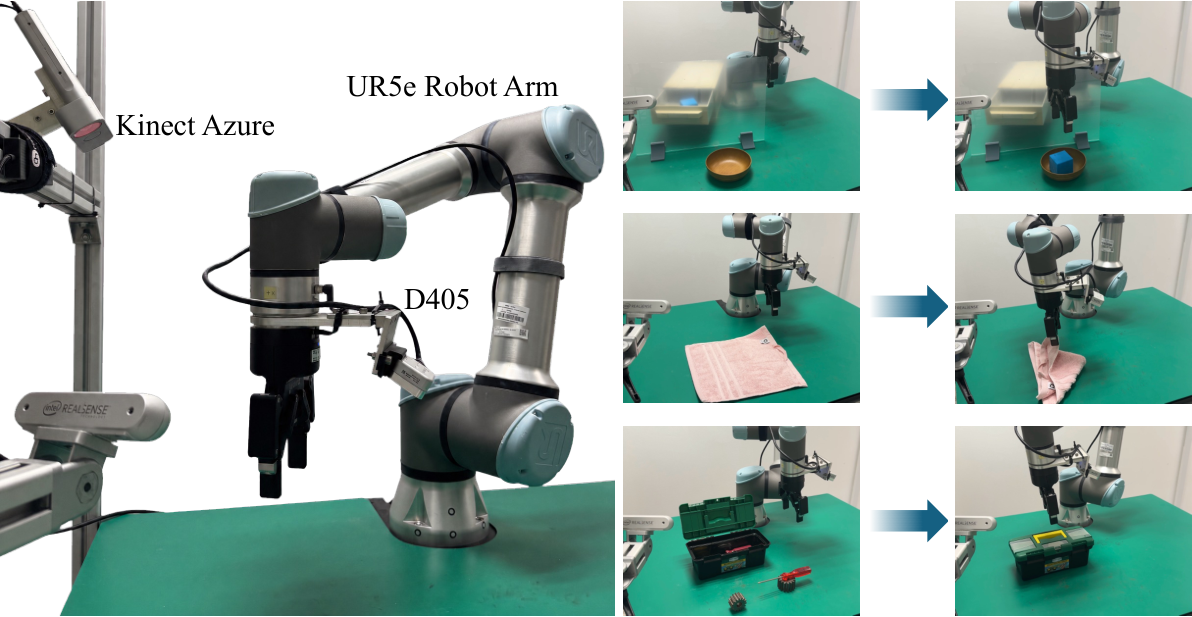
在分布内(ID)测试中,SG-WAM 在三项真实任务中均保持了最高的动作执行成功率。更为关键的是分布外(OOD)扰动实验:当操作台换用未见过的杂色桌布(背景偏移)、关闭主光源或引入局部强阴影(光照剧变),以及替换目标工件的外观形貌时,基线模型(如 VPP 和 VLA-JEPA)频繁出现夹爪定位失误或在长程任务中间状态停滞的现象。
而在多阶段长程的工具箱收纳任务中(机械臂需依次捡拾螺丝刀与两个齿轮放入收纳箱,再执行合盖动作),随着动作步数的拉长,微小的动作漂移极易产生复合误差。SG-WAM 在扰动环境下依然展现出极为稳定的轨迹规划能力,这印证了自指导动力学标记在长序列因果推断中所扮演的“状态锚点”作用。
消融实验揭示的机制协同
为了量化几何监督与自指导世界建模各自带来的增益,论文在 LIBERO 四大套件上进行了严格的消融对比。
当完全剥离几何监督与自指导动力学建模、退化为纯粹的 VLM 流匹配策略时,模型的平均成功率为 95.3%。单独引入几何监督,平均成功率微升至 96.6%(提升 1.3 个百分点);单独引入自指导世界预测,成功率提升至 97.6%(提升 2.3 个百分点)。而当二者协同工作时,模型表现跃升至 98.5%。
这一增益在长程任务子集 LIBERO-Long 上表现得尤为明显:剔除世界建模后,长程任务的成功率由 96.2% 骤降至 92.2%(下降 4.0 个百分点)。这一数据清晰表明,动作模仿对于长程多阶段状态演化的弱约束,必须通过显式的未来动力学前瞻来弥补;而几何结构则为这种前瞻提供了空间维度的底层支撑,二者在表征学习中构成了强有力的互补。
总结与未来展望
SG-WAM 提供了一种具有启发性的世界动作模型解题思路:具身策略无需沉溺于未来高维图像的高保真像素重构,也不必盲目依赖外部独立的潜变量特征空间。通过在策略骨干内部嵌入动力学标记,并利用自身的 EMA 分支构建演化预测目标,模型能够在完全内生、与动作专家高度对齐的隐空间内高效掌握因果动态;辅助的几何蒸馏机制,则确保了这一表征空间不会在特征压缩中丧失至关重要的三维物理坐标。
这种架构不仅在 0.9B 的极小参数预算下压榨出了惊人的操作泛化性能,更在推理端实现了零冗余开销。未来,随着该框架向更大参数规模的多模态底座迁移,并在涵盖多双臂、四足移动操作等更广泛的跨本体数据集上进一步展开验证,自指导物理动力学有望成为构建通用、高鲁棒性具身基座模型的一条极具竞争力的技术路径。