SciExplore:从文献检索到结构化合成,前沿科研 Agent 正式迎来分级大考!
SciExplore: Evaluating Autonomous Agents from Scientific Navigation to Information Integration
当下的大语言模型(LLM)与深度研究智能体(Deep Research Agent)在日常问答、通用网页检索乃至撰写长篇报告方面展现出了惊人的效率。但如果把它们直接推向真实的科研一线——去专业结构化数据库里跨表追踪实体、根据一段语焉不详的方法描述定位原始论文、给学术段落精准补全引用,甚至从数十篇文献中抽提数据并合成完整的科研对比表格——这些先进模型究竟能发挥几成实力?
ArXiv URL:https://arxiv.org/abs/2607.20926
许多科研人员在使用所谓“科研 Agent”时都会遭遇类似的落差:模型在撰写文字时看似引经据典、辞藻流畅,但一旦要求其针对具体实验参数或细粒度事实进行跨文献归纳,结果往往充满幻觉、关键数据遗漏或张冠李戴。现有的评测体系往往处于两个极端:一类是像 SuperGPQA 或 SciBench 这类静态问答基准,单纯考察模型内部的参数化记忆与计算推理,脱离了真实的检索与证据挖掘过程;另一类则是通用的 Deep Search 基准,大多面向开放互联网检索简短事实,忽略了科学研究所必需的专业数据库交互与跨文献事实交叉对齐。
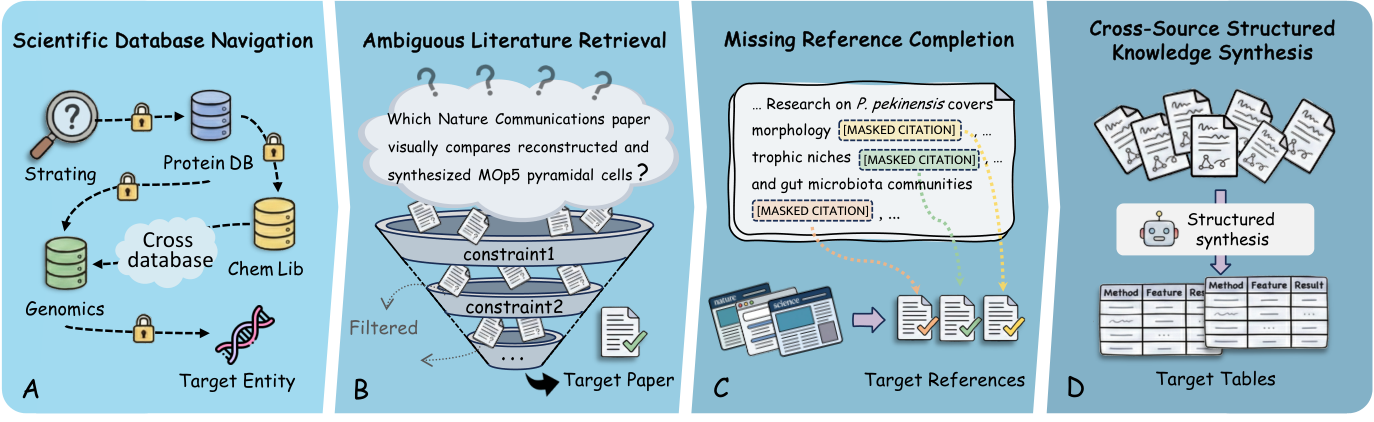
为了填补这一评测空白,最新研究提出了 SciExplore。该基准将真实的科研信息搜寻抽象为一个渐进的认知阶梯,涵盖跨 10 多个学科的 103 项博士级深度任务,系统性评测大模型从最底层的实体推理到顶层的领域级结构化知识合成能力。评测结果给当前所有的科研助手泼了一盆冷水:面对最复杂的跨源结构化合成任务,即使是业界顶尖的自主研究智能体,准确率也跌落到了 20% 以下。
拆解科研认知链:SciExplore 的四层任务进阶
人类学者在探索未知领域时,信息搜寻绝非单步查找,而是一个不断递进的认知链条。SciExplore 拒绝使用容易诱发信息泄露的合成模板,全部由各领域专家深度介入构建,将其划分为四个层层递进的核心任务(T1 至 T4):
第一层是科学数据库导航(Scientific Database Navigation, T1)。这一层考察实体级推理能力。科研人员经常需要在 UniProt、PDB、PubChem 或材料数据库等专业平台中,顺着复杂的关联字段逐步跳转,以获取特定实体的精确属性。模型需要具备多跳路径规划与模式理解能力,而不是仅靠关键词撞大运。
第二层是模糊文献检索(Ambiguous Literature Retrieval, T2)。科研场景中最常见的痛点之一,是读者仅能回忆起某篇论文采用的独特实验设计、特殊的合成温度或非标准的评价指标,但完全忘记了作者、题目与发表年份。T2 任务故意隐藏论文标题与标准元数据,仅提供一段含糊或嘈杂的方法学描述,要求模型像资深同行评审一样,从浩瀚的文献海洋中精确揪出那篇关键文献。
第三层是缺失引用补齐(Missing Reference Completion, T3)。从单篇文献的识别更进一步,科研写作要求极强的证据对齐能力。在 T3 中,模型会拿到一段抹去了所有引注文献的科学论述,并被要求针对文中的具体主张、实验发现或理论断言,精准检索出最贴切的支撑文献。这要求 Agent 不仅理解文献在讲什么,还要理解它在论证链条中充当了哪一块基石。
第四层则是难度最高峰——跨源结构化知识合成(Cross-Source Structured Knowledge Synthesis, T4)。这一层代表了真正的领域级全局概括能力。模型面对一个宏观的研究课题,必须自主检索数十篇相关论文,并在长文本中提取对应的核心参数,最终合成一张完整、精确的多维对比表格。此任务的成败由两项指标严格判定:单元格级准确率(Item-level)与整行对齐准确率(Row-level)。任何一个核心实体遗漏,或关键属性提取错误,都会导致整个结构崩溃。
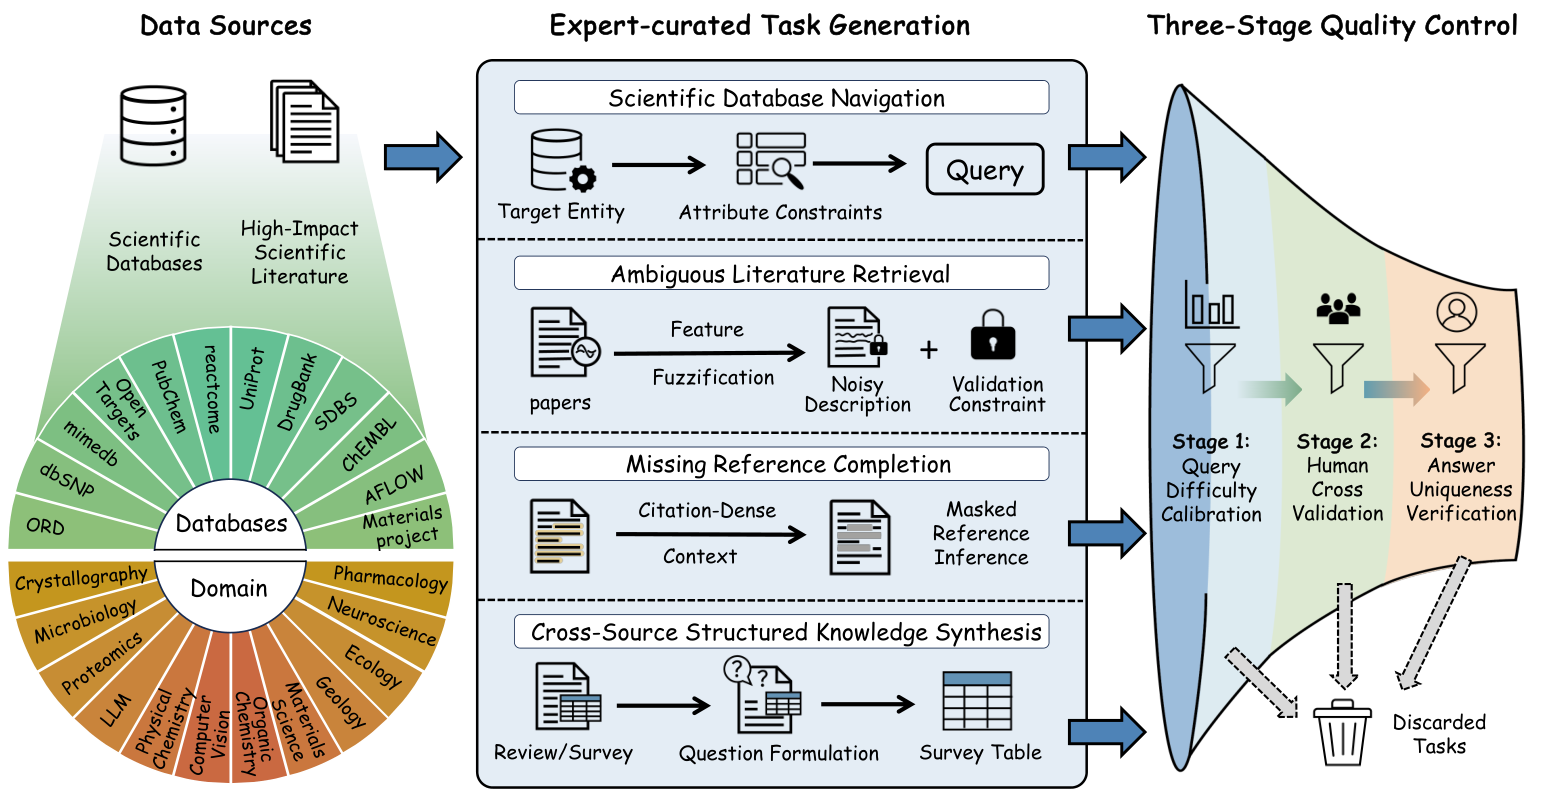
为了保证这套基准的绝对硬核,研究团队建立了严格的人机交叉验证闭环。如上图所示,在专家构建初始任务后,团队引入顶尖的搜索增强大模型进行极限压力测试。一旦发现某道题目存在非唯一的合理答案,或者可以通过捷径(例如纯参数化记忆直接蒙对)解出,该题就会被立即废弃或重构,彻底杜绝了模型依靠幻觉或记忆“刷分”的可能。
评测实验:前沿模型为何纷纷在 T4 遭遇滑铁卢?
研究团队在 SciExplore 上系统评测了 12 种主流系统,涵盖基础大模型(如 GPT-5.1、Gemini-3-Pro、DeepSeek-V3.2、Qwen 系列)、引入搜索引擎插件的检索增强模型,以及代表最高自主水平的 Deep Research Agent(包括 OpenAI Deep Research、Gemini Deep Research 和 Tongyi-DeepResearch)。
整体评测呈现出几项极其鲜明的特征:
首先,具备长期规划与自主调度工具能力的 Deep Research Agent,在所有任务上全面压制基础大模型与简单的检索增强模型。在复杂的科学数据库导航(T1)上,Tongyi-DeepResearch-30B-A3B 展现出极佳的实体寻路能力;而在模糊文献检索(T2)中,Gemini Deep Research 展现出了极强的方法学理解深度;综合表现最佳的系统则是 OpenAI Deep Research,在多项长周期推理任务上摘得桂冠。
然而,一旦进入代表真正科研深水区的 T4(跨源结构化知识合成),所有系统的得分曲线瞬间呈现断崖式下跌。即便是最强大的 OpenAI Deep Research,其在 T4 任务上的单元格准确率也仅在 30% 左右,而整行完全正确的比例甚至低于 20%。其他基础模型在此任务上的有效输出几乎归零。
这一巨大鸿沟揭示了当前模型能力的致命脱节:局部碎片信息的获取并不等价于全局结构的准确构建。模型或许能在单篇论文里找到一个具体数据,但当面对 20 篇论文、数十个相互关联又在表述上各有差异的属性时,它们无法维持全局认知的一致性。模型往往“按图索骥”地抓取了一些互不兼容的事实,最终拼凑出一张看似详尽、实则漏洞百出的表格。
症结所在:Agent 陷入了“先猜后验”的思维误区
为了探究模型在真实科研检索中频频失准的根本原因,研究团队对 Agent 的交互轨迹进行了深入的定量与定性分析,发现了一个极具启发性的现象:大模型智能体的搜索模式与人类专家存在本质逻辑偏差。
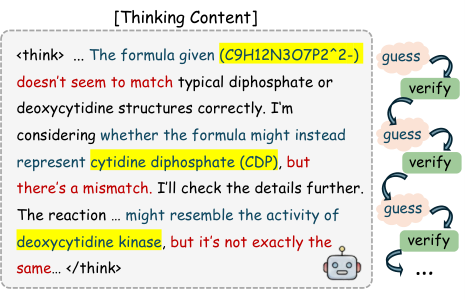
人类学者在面对模糊信息时,通常会采用“自下而上”的结构化过滤策略。研究人员会提取文献描述中不可动摇的实体锚点、特定化学反应类型或实验环境参数,利用布尔逻辑或高级筛选器逐步缩小候选空间。
相反,当前的 LLM Agent 高度依赖一种“先猜后验”(Guess-and-Verify)的运作逻辑。如上图所示,Agent 在拿到题目后,首先会利用其内部的参数化知识库“脑补”出一个看似最可能的候选实体或特定论文,随后发起网络检索。但它们检索的目的,往往不是为了客观求证或广撒网排查,而是为了去网络上寻找证据来支撑自己的这个初始猜想。
这种自上而下的认知偏见在科学领域极其致命。如果 Agent 的初始猜想略有偏差,它就会在搜索中不断自我强化这一错误认知。更糟糕的是,很多模型展现出了严重的“过早放弃”现象:一旦用猜想的关键词搜不到直接匹配项,它们不会退回到更高抽象层级调整搜索策略,而是立刻产生幻觉,捏造虚假参数强行交差;或者走向另一极端,直接宣布该信息无法查证。
此外,深入的错误归因分析指出,T4 任务失败的首要元凶是主键召回率(Primary-Key Recall)严重不足。统计显示,哪怕是行业领先的 Agent,在领域级合成任务中,针对核心实体的检索召回率也普遍低于 60%。在结构化表格中,主键行实体的缺失是无法弥补的致命伤——如果最关键的几篇标杆文献根本没有被检索到,那么后续无论是长文本阅读、信息抽取还是对齐整理,在起始阶段就已经注定了失败。
科研智能体的演进,远未走到“交钥匙”阶段
SciExplore 带来的核心启示在于,单纯堆叠更长的上下文窗口、接入更快的搜索引擎,已经无法从根本上跨越科研级信息获取的鸿沟。目前的大多数科研 Agent 本质上仍然是“披着 Agent 外衣的长篇写作模型”,它们擅长用华丽的语言组织泛化的综述,却在面对硬核、精密、容错率为零的科学事实网络时捉襟见肘。
未来的自主科学研究助手若想真正承担博士级助手的重任,必须在三个底层架构上做出变革:
-
重构检索规划范式:从脆弱的“猜想与验证”走向更具广度与韧性的“系统化空间探索”,具备像人类专家一样的全局过滤与主动策略回溯能力;
-
抗噪声与抗模糊鲁棒性:在面对实验细节的歧义表述与科学术语的异名同义现象时,能够维持证据链的严谨推导,拒绝为了追求输出完整而凭空造假;
-
强模式约束下的超长文档精确抽取:针对海量 PDF 全文,具备精准锚定特定章节、特定图表并完成跨文献单位归一化的结构化合成能力。
科研是一项绝不容忍轻率妥协的事业。SciExplore 的出现,以极其严苛的尺度丈量出了真实科研与现有 AI 能力之间的真实距离,也为下一代真正严谨、可靠的科学智能体的研发指明了攻坚方向。