SceneActBench:看懂3D不等于能动手?11款顶尖VLM实测最高仅50.2分
SceneActBench: Can Agents Act on the 3D Scenes They See?
在大模型的多模态能力评测中,三维空间感知一直存在一个尴尬的断层:绝大多数基准要么只让模型充当“解说员”,看着三维点云或房间渲染图回答文本问答(VQA);要么只允许在隔离环境中摆弄单个茶杯、椅子,评测指标也往往简化为单步成功的二元标签。然而,在具身智能、空间计算与虚拟资产生成的真实管线里,人类需要的不是一个只会报菜名的观察者,而是一个能根据真实视角图像、在复杂的三维环境中调度多个资产并完成精准装配与动画制作的工程师。
ArXiv URL:https://arxiv.org/abs/2607.22393
针对这一脱节,全新评测基准 SceneActBench 将核心命题直接推向前线:如果一个智能体能够“看见”场景,它能否在三维环境中采取真实行动,把这个场景还原出来? 这一工作将基于视觉条件的三维空间操作形式化为一个完全可执行的闭环评估框架,涵盖空间布局、相机定位、铰接机构、网格重建与多物体动态交互五大能力维度。
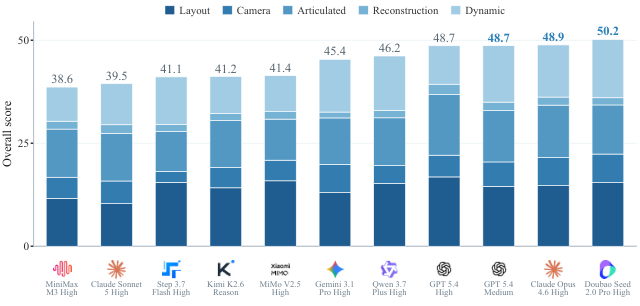
基准对包括 Claude Opus 4.6、GPT 5.4、Gemini 3.1 Pro、Doubao Seed 2.0 Pro、Qwen 3.7 Plus 等在内的 11 款前沿专有视觉语言模型(VLM)配置进行了严格评测。在归一化至百分制的满分标准下,各大顶尖模型的综合得分仅分布在 38.6 至 50.2 之间。最高分得主 Doubao 也仅拿到 50.2 分,且没有任何一款模型能在五项子任务中保持全面稳健。这表明多模态模型通往“可操作的三维智能”依然存在巨大的能力鸿沟。
从单纯描摹到环境闭环:SceneActBench 的核心机制
以往的三维理解基准之所以容易被模型“蒙混过关”,是因为语言描述具备很高的容错度。即便智能体在文本中准确推断出“桌子在沙发前方 1.5 米”,一旦把它放到仿真器或建模软件里,写出的变换矩阵可能就会把桌子塞进地表或发生穿模。SceneActBench 摒弃了纯文本问答与粗粒度成败反馈,直接构建了一套端到端的无头 Blender 执行评测回路。
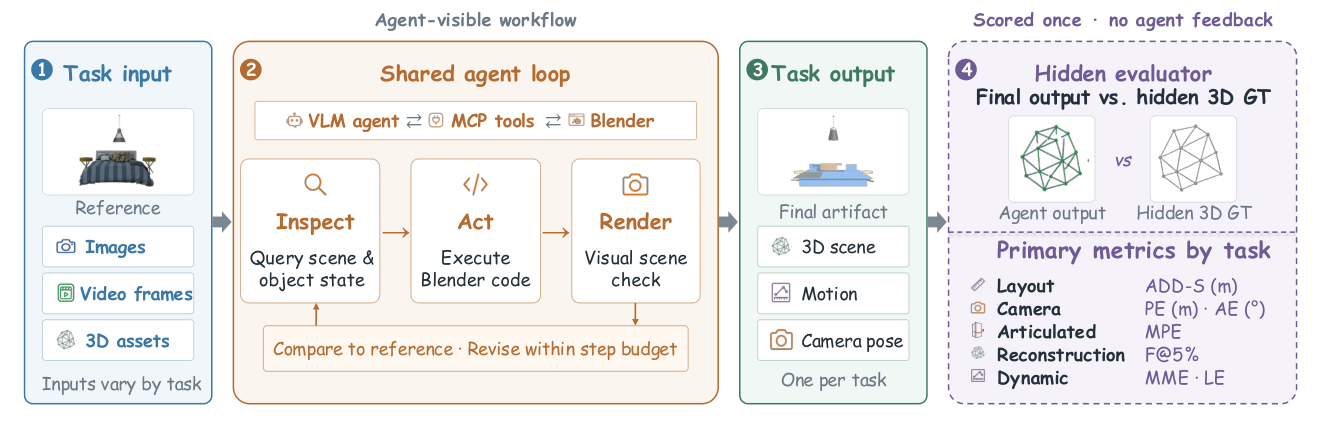
整个评测回路高度标准化且对环境实施了严格的“防信息泄漏”处理。原始资产往往会在文件命名、初始坐标或元数据节点中无意识泄露真实位置与尺寸。为了彻底杜绝作弊,基准对所有三维资产进行了标准化清洗:室内家具资产全部平移至世界坐标原点、偏航角(Yaw)归零并统一度量单位;所有可动铰接物体的关节参数被强制封存;文件与节点名称全部替换为匿名哈希标识,迫使模型只能通过输入的 PNG 图像或视频抽帧提取视觉线索。
智能体通过模型上下文协议(Model Context Protocol, MCP)与后台运行的 Blender 无头环境交互。在固定的操作步数预算内,智能体能够调用指令审查场景、生成并执行 Python 代码、从虚拟相机视角渲染画面,并比对渲染图与参考图的残差进行多轮自我迭代。当智能体主动停止或预算耗尽时,系统导出的最终成果(GLB 模型、相机位姿 JSON 或动画状态序列)会直接与隐藏的真实几何真值(Ground Truth)进行点云距离或轨迹误差比对。在整个交互过程中,任何真值几何信息与评分反馈都不会向智能体泄露。
拆解五大维度:智能体在空间中需要克服的难关
SceneActBench 从 210 个基础实例中衍生出 520 个任务用例,通过五个独立但同等权重的子任务,对三维操作的不同核心能力进行压力测试。
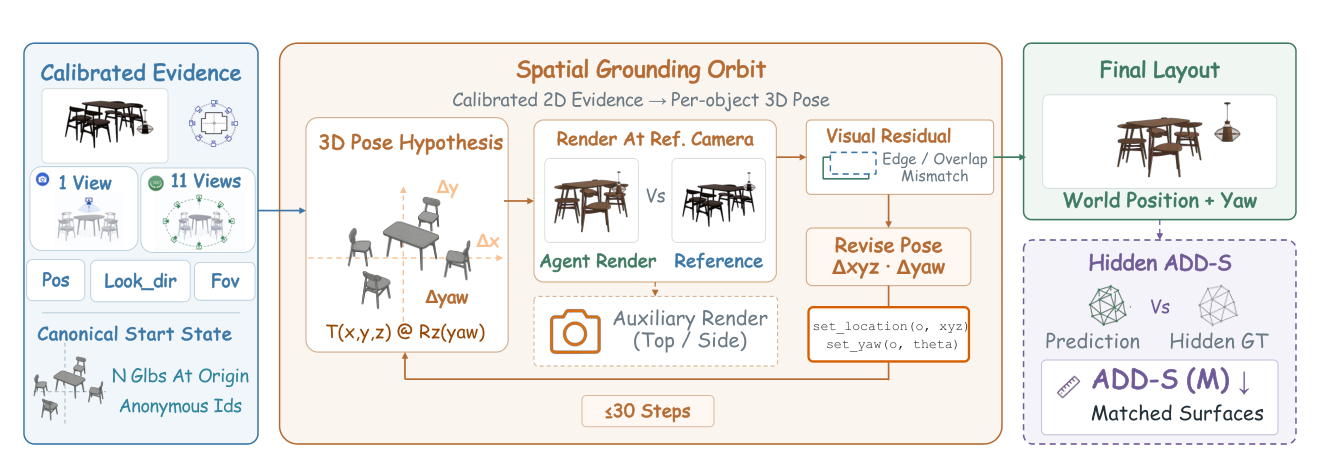
第一个任务是布局还原(Layout),考察模型的基础空间接地(Spatial Grounding)能力。环境给出一间摆放了 3 至 7 件家具的房间参考图,并提供移至原点的标准化三维资产库。智能体必须准确估算每件物品在世界坐标系中的度量平移向量与偏航旋转角。评估采用双向表面最近点距离(ADD-S),严密衡量网格对齐误差。
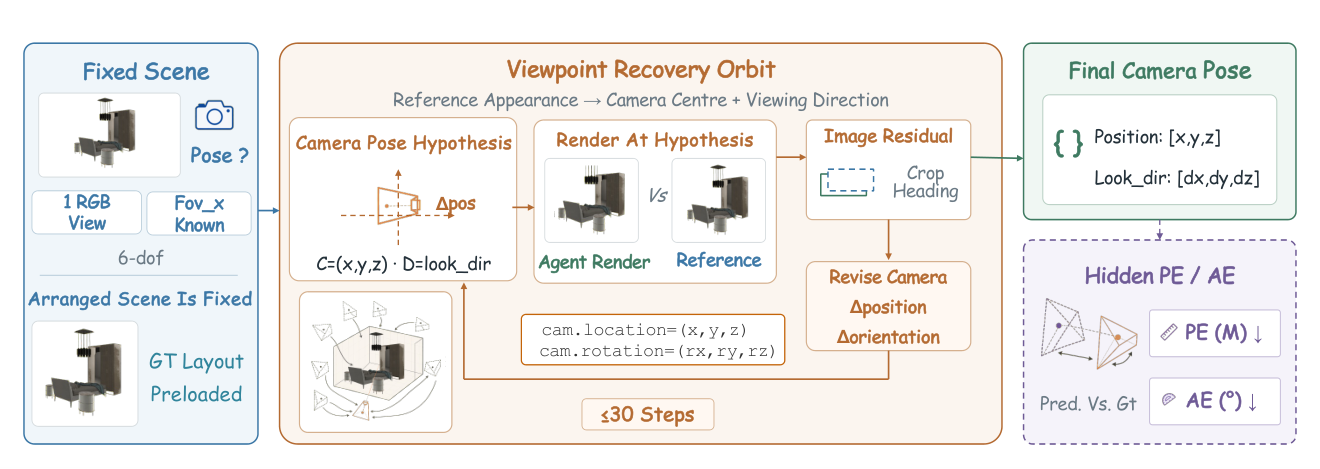
第二个任务是相机位姿推断(Camera),对应以自身为中心的空间推理(Egocentric Spatial Reasoning)。智能体看到一间已经布置完毕的房间与相机的视场角(FOV),但不知道相机在房间中的六自由度外参。智能体必须根据房间内物体的透视收缩、相对遮挡关系,在三维空间中放置虚拟相机,并通过反复比对渲染残差来调准拍摄机位。最终以平移位置误差(PE,米)与视线朝向夹角误差(AE,度)综合打分。
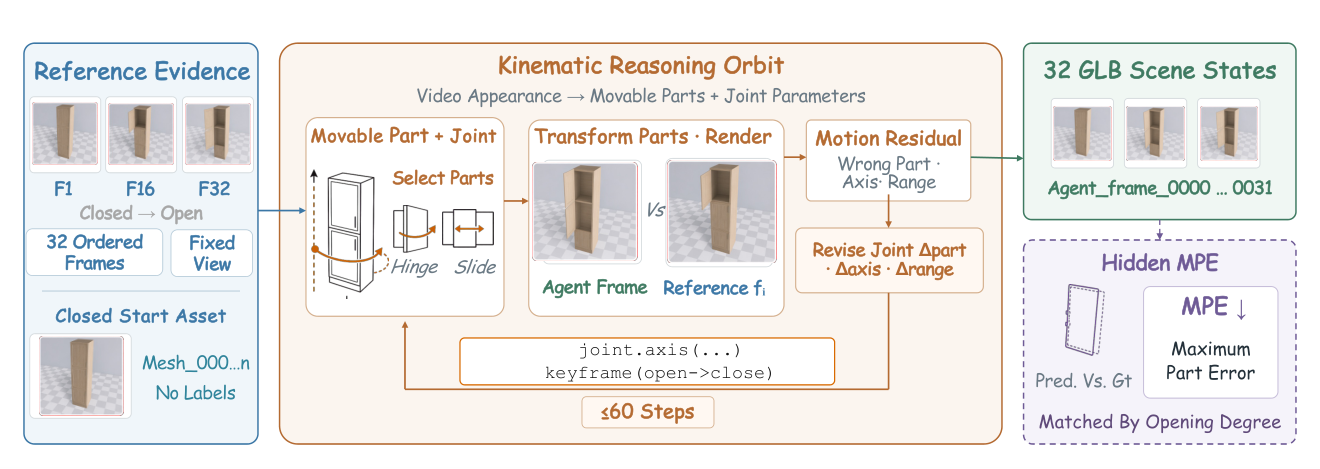
第三个任务是铰接运动学推理(Articulated),测试智能体的运动学链理解能力。系统输入一个处于闭合状态的无标签三维物体(如双门柜、微波炉、抽屉),并附带 32 帧开闭过程的参考视频帧。智能体需要自主识别物体的可动构件(Movable Parts),推断其铰接类型(旋转关节或平移关节)、转轴矢量、旋转中心轴心点及运动幅度,并输出 32 帧全场景运动状态。评测使用最大构件误差(MPE)来捕捉运动学还原的短板。
第四个任务是从零网格重建(Reconstruction),直接挑战三维形状想象力(Shape Imagination)。智能体面对一个空无一物的场景和约 11 个校准视角的参考图,在没有现成 3D 模型资产的情况下,必须自主编写 Blender 代码创建网格几何体、定义几何拓扑、配置材质基色(Base Color)并对齐多物体尺度。真值评估采用对角线相对公差为 5% 的 F-score(F@5%)。
第五个任务则是多物体动态轨迹还原(Dynamic)。系统提供一段 144 帧的动态交互视频与组件模型库,场景涵盖转盘传输、赛车竞速等九种运动机制。智能体不仅需要搭建静态背景,还要定位多个动态移动物体的初始位置,并沿时间轴插入关键帧(Keyframe)以精确还原复杂物体的同步运动轨迹。评测兼顾了静态背景布局误差(LE)与所有移动物体的最大运动轨迹误差(MME)。
成绩单背后:单项冠军为何成不了总分第一?
在 11 种顶尖模型配置的横向角逐中,综合得分呈现出胶着且普遍偏低的状态。排名靠前的模型各有长短,而总分的最终走势暴露出一个关键规律:在这类多维复合基准中,决定排名的往往不是你拿了几个单项冠军,而是短板被击穿时的溃败深度。
以 GPT 5.4 系列为例,GPT 5.4 High 在五项任务中横扫三冠:在 Layout 中取得 69.2 的高分,在 Articulated 拿到 62.5 分,在 Reconstruction 中也位居榜首。然而,它在 Dynamic 任务中遭遇重大滑铁卢,仅得 30.1 分,比计算投入更低的 GPT 5.4 Medium(51.9 分)整整低了 21.8 分。这使得 GPT 5.4 High 的总分被拉低至 48.7,最终屈居第四。
相比之下,Doubao 凭借极度均衡且无绝对软肋的表现登顶(50.2 分),并在 Dynamic 任务中取得了 58.7 分的全场最高分。但深入的贡献分解表明,Doubao 对 Claude Opus(48.9 分)建立的 1.34 分优势具有很高的结构集中性:在 Dynamic 任务的十个测试场景中,仅 raceloop(环形赛车)和 factory(工厂流水线)这两个超大型复杂场景,就为 Doubao 贡献了 1.54 分的优势增量,而剩余八个场景的总贡献甚至为负。研究团队通过 50,000 次配对重采样(Bootstrap)计算发现,其置信区间均跨越了零点。这说明当前的领先优势高度依赖测试集内部具体长尾分布的权重,各大旗舰模型在三维执行底座上的技术代差并未真正拉开。
隐藏在分数背后的诊断:四种截然不同的失败机制
若只停留在宏观分数,很容易误以为相似得分的模型具有同等的三维推理能力。SceneActBench 提供的细粒度诊断指标进一步穿透表面,揭示出模型内部极为迥异的失败机制。
第一种是规避操作带来的“虚假及格”。在 Articulated 铰接任务中,Doubao、Claude Opus 与 GPT 5.4 Medium 的表面 MPE 误差高度接近(0.375 至 0.404 米),但背后的执行策略大相径庭。整个测试集包含 391 个真实可动部件,Claude Opus 尝试驱动了其中的 255 个,并成功锁定了 248 个部件的关节类型和 238 个部件的旋转方向;而 Doubao 表现出极强的保守倾向,在 391 个部件中仅尝试操作了 13 个部件。因为未动部件的几何位移误差往往受限于物体自身包围盒尺度,这种近乎“躺平不动”的生成策略反而避开了大范围形变可能带来的极端离群惩罚,在宏观几何指标上维持了体面的表面分数。
第二种是识别成功与几何完备性的断层。在 Reconstruction 任务中,要求模型在白纸上通过代码凭空捏造家具几何。前三名模型在实体匹配诊断上表现尚可,从 515 个目标家具中成功检索并放置了 425 至 432 个物体,目标检出率超过 80%。然而,在严谨衡量三维表面与厚度对齐的 F@5% 指标上,所有模型的得分暴跌至 0.088 到 0.104 之间。细查网格拓扑会发现,大多数模型仅仅写出代码生成了简单的立方体包围盒或退化的平面片,无法利用代码逻辑补齐椅背的弧度、桌腿的截面以及细分曲面的几何厚度。
第三种是以自身为中心的位姿耦合崩溃。在 Camera 相机推断任务中,位置误差(PE)与角度误差(AE)呈现出 0.76 至 0.93 的极高斯皮尔曼正相关性。在相当一部分测试用例中,智能体完全无法将物体的二维像素投影分解为相机的三维位移与俯仰角,导致相机位置朝相反方向漂移数米,视线方向偏离数十度,最终双双触及零分惩罚线(在 Doubao、Claude Opus 和 GPT 5.4 Medium 中,此类完全失控案例分别占到 18、16 和 24 例)。
第四种是连续时间运动语义的混乱。在 Dynamic 任务中,Doubao 能够精准在场景中摆放 29 个可移动物体中的 28 个,但在能够提取有效运动轨迹的 16 条轨道中,仅有 7 条方向正确;反观 Claude Opus 和 GPT 5.4 Medium,在更少的有效构件中均正确还原了 11 条运动轨迹的物理方向。可见,很多模型仅仅把多帧视频当成了“带时间戳的孤立静止帧”,未能建立起具备连续速度与因果约束的世界模型。
颠覆直觉的发现:算力与交互并非万能灵药
这项研究还推翻了多模态 Agent 领域常有的两项直觉惯性。
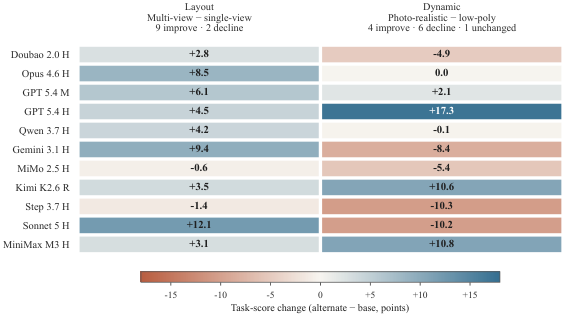
其一是“多看几眼未必管用”。为了探索视觉输入量对 3D 操作的影响,基准设计了对比实验。在 Layout 任务中,从单张视图切换到约 11 个视角后,绝大多数模型获益匪浅,Claude Sonnet 的得分飙升了 12.1 分,Gemini 提升 9.4 分。多视角提供的极线几何与视差显著消除了深度模糊。然而,当把 Dynamic 任务中的简模渲染视频换成 NVIDIA Cosmos 渲染的逼真照片级视频时,画面纹理、物理阴影与高光反射的增加却干扰了部分模型的注意机制,导致得分不增反降。这证明当前的视觉大模型对非几何视觉噪声极为敏感,更丰富的视觉表面信号可能反向破坏对底层拓扑与运动学的抽象判断。
其二是“交互轮数越长,成绩反而越差”。在传统的文本与代码任务中,增加迭代与反思步数通常能提升最终质量。但在 SceneActBench 的任务均衡交互统计中,交互体量与总体得分竟然呈现出显著的负相关(斯皮尔曼相关系数 $\rho = -0.68$)。
Claude Opus 几乎耗尽了环境提供的预算配额,平均每次运行使用 82.9% 的预算步数,调用多达 39.1 次工具,但最终得分(48.9)并未压制采取极简操作风格的模型。GPT 5.4 Medium 仅使用 32.8% 的预算和 19.9 次调用,拿到了 48.7 分;总分第一的 Doubao 更是仅消耗了 34.3% 的预算,平均每轮仅调用 11.4 次工具便迅速收敛并退出循环。这揭示出当前智能体在物理交互闭环中的致命弱点:缺乏清晰的空间纠错梯度。在没有真值指引的情况下,模型仅凭自己渲染的参考图对比,往往无法推导出正确的空间梯度下降方向,反而会在反复的代码编辑与位姿微调中陷入自激振荡,最终把原本大致正确的粗糙场景越改越乱。
迈向真正可动的三维世界
SceneActBench 的推出,将业界对 3D 大模型的评估体系从“能否聊两句空间”拉回到了“能否在引擎里动真格”。评测结果证明,高超的通用视觉推理与代码生成能力,并不等价于能够在度量空间中稳定装配物体。空间接地、自体位姿消歧、运动学约束和参数化网格建模,是彼此割裂且高度特异的能力模块。
对于未来的空间计算与多模态 Agent 开发而言,纯粹依靠扩大上下文窗口或盲目堆砌自我反思交互,已经很难在复杂的三维场景操作中带来实质跃迁。开发具备显式三维几何归纳偏置的专用工具回路、强化模型对时序物理运动的因果建模,并在训练中引入严格的度量几何反馈,将是让智能体真正“看懂并动手重塑三维世界”的关键分水岭。