SCHEMA:用知识拓扑揪出科研Agent幻觉,终局正确率与推理过程严重脱钩
Tracing the Cascade: A Topology-Aware Evaluation Framework for Scientific Agent Hallucinations
在生命科学、生物制药等高风险领域,基于大语言模型(LLM)的自主科研智能体(Agent)正被寄予厚望。人们期待它们阅读海量文献、串联分子通路、推导机制并编写实验脚本。然而,这类严谨的科学场景对“幻觉”(Hallucination)有着近乎零容忍的标准。一个在关键酶催化机制上的微小虚构事实,会在长链条推理中不断放大,引发雪崩式的级联错误,最终得出一整套看似自圆其说、实则致命荒谬的实验假说。
ArXiv URL:https://arxiv.org/abs/2608.00711
以往评估大模型幻觉的基准,往往局限在单轮事实问答或孤立的关系抽取中。这种评估方式不仅缺乏解释力——只能告诉你模型“答错了”,无法回答“为什么错”以及“从哪一步开始脱轨”;更关键的是,它忽视了科学知识本身网状交织的本质。在科学领域,核心枢纽概念(Hubs)与边缘事实在拓扑网络中的权重天差地别。
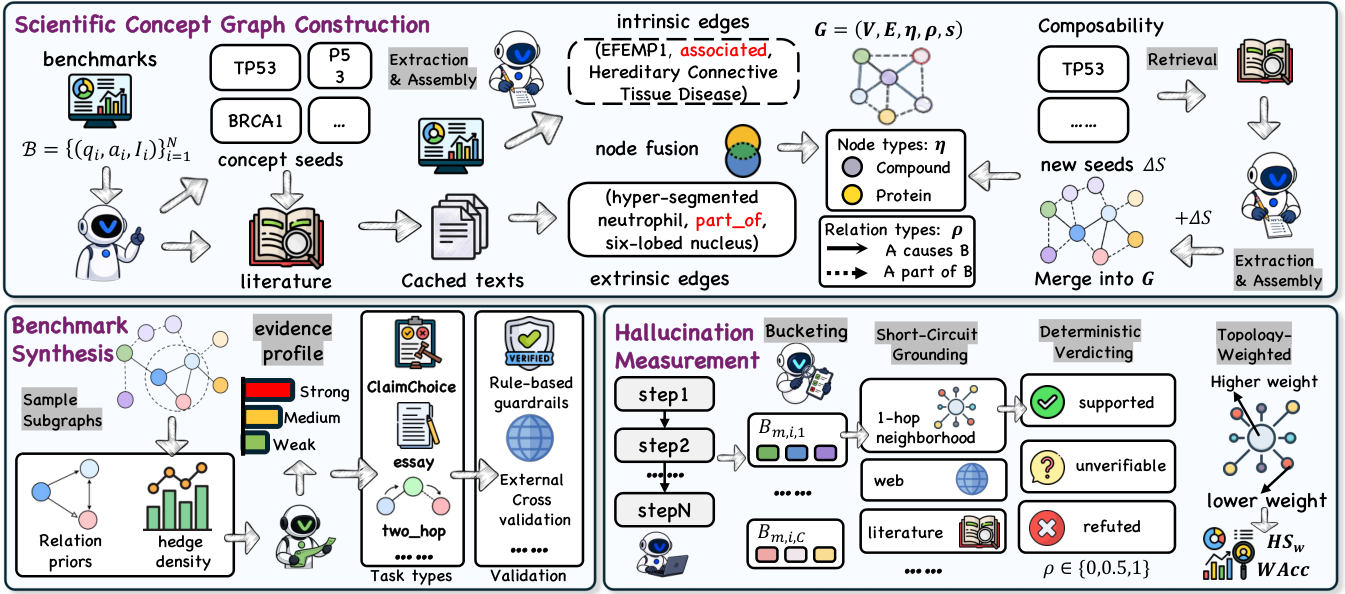
为了打破这种浮于表面的评估范式,一项新研究推出了 SCHEMA(Scientific Concept Hierarchies and Evidence-grounded Metrics for Agents)。这是首个面向科研 Agent、具备拓扑感知能力(Topology-Aware)且有明确文献证据支撑的幻觉评估与归因框架。该工作最引人注目的结论在于:终端答案的正确率与推理轨迹的真实性发生了严重解耦。许多顶尖模型之所以能做对题目,往往是依赖“捷径推理”,中间过程充斥着概念硬伤;而在拓扑结构中,幻觉并非均匀随机发生,而是高度集中在少数具有杠杆效应的核心知识枢纽周围。
机器也懂因果推断:多智能体反事实归因
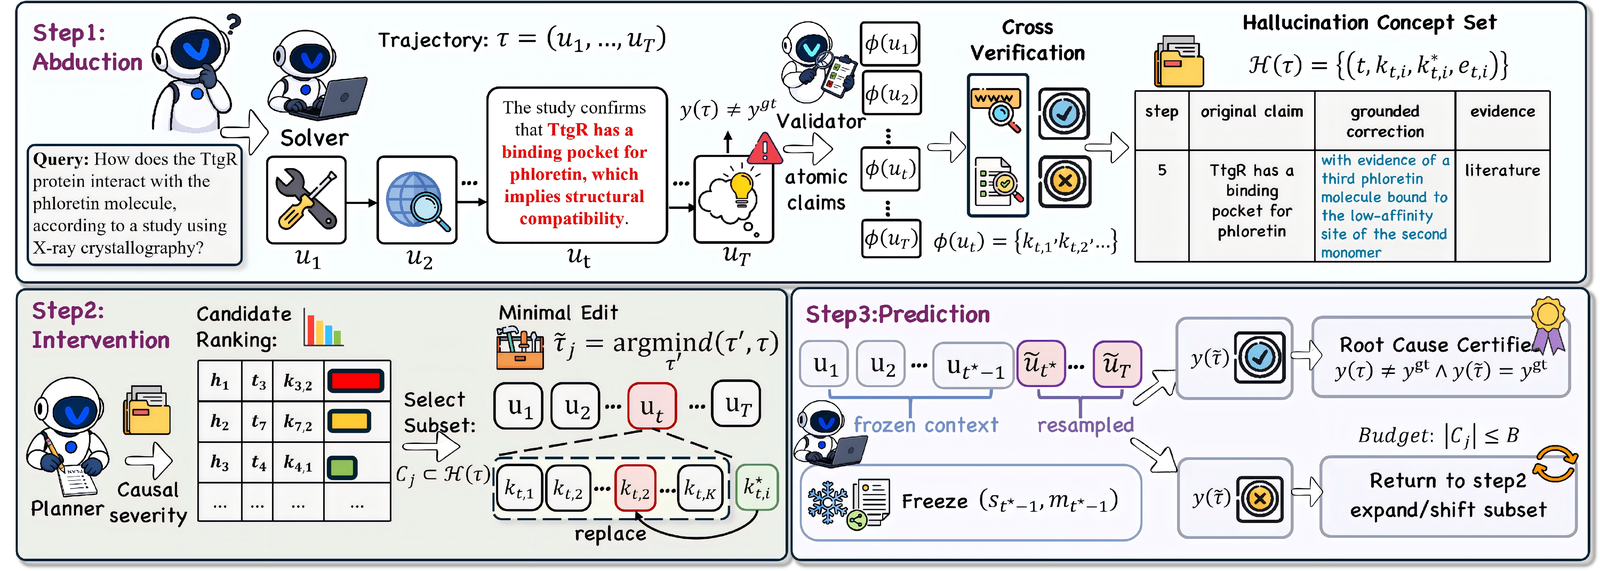
要真正弄清楚 Agent 的幻觉究竟从何而来,人工逐行审查既耗时又难以规模化。SCHEMA 创新地将 ReAct 风格的推理轨迹归因问题,转化为了一个标准的反事实干预(Counterfactual Intervention)问题:如果在步骤 $t$ 消除掉模型捏造的幻觉内容,它最终是否就能推导出正确答案?
具体而言,SCHEMA 设计了一个由三阶段构成的多智能体协同流水线:
-
溯因推导(Abduction):Agent 在执行任务时记录下完整的思考与工具调用轨迹。校验模块介入,将轨迹中每一跳的陈述与结构化文献证据进行交叉核验,列出所有存在事实性偏离的中间步骤。
-
定向干预(Intervention):针对候选的幻觉步骤 $t^{\star}$,干预模块将其中被篡改或虚构的前提,替换为受底层知识图谱严格支撑的正确陈述。
-
因果认证(Prediction):求解器从被修改的步骤 $t^{\star}$ 恢复运行。这里利用了状态重置机制,将 $t^{\star}-1$ 步之前的上下文与记忆严格“冻结”(Frozen Context),从而彻底隔绝上游采样随机性的干扰。如果这次重跑使得原本失败的轨迹严格翻转为成功($y(\tau)\neq y^{\mathrm{gt}} \wedge y(\tilde{\tau})=y^{\mathrm{gt}}$),那么该步骤就被正式认证为本次幻觉失败的“因果根因”(Root Cause)。
通过对蛋白质领域基准 ProteinLMBench 中真实失败轨迹的解剖,这项因果归因技术带来了一个颇具穿透力的发现:Agent 的错误主要分为三类,其中比例最高的并非模型无法理解工具,而是映射错误(Mapping Error)与事实错误(Fact Error)。映射错误指 Agent 成功检索出了正确的文献,但在最后一步整合时发生逻辑短路,这类错误通过干预极易被修复;而事实错误则呈现出极低的修复率——一旦 Agent 在推理起点轻信了一个虚假概念,后续的所有多步推演都会无底线地继承并放大这个偏见,直至全盘崩溃。
并非所有错误都等价:拓扑加权的严重性指标
既然错误具有级联效应,传统的“按人头算错误率”就失去了代表性。在真实的代谢网络或疾病机制中,一个涉及中心节点(如核心催化酶)的错误,其破坏力远大于某个偏门试剂名称的拼写失误。
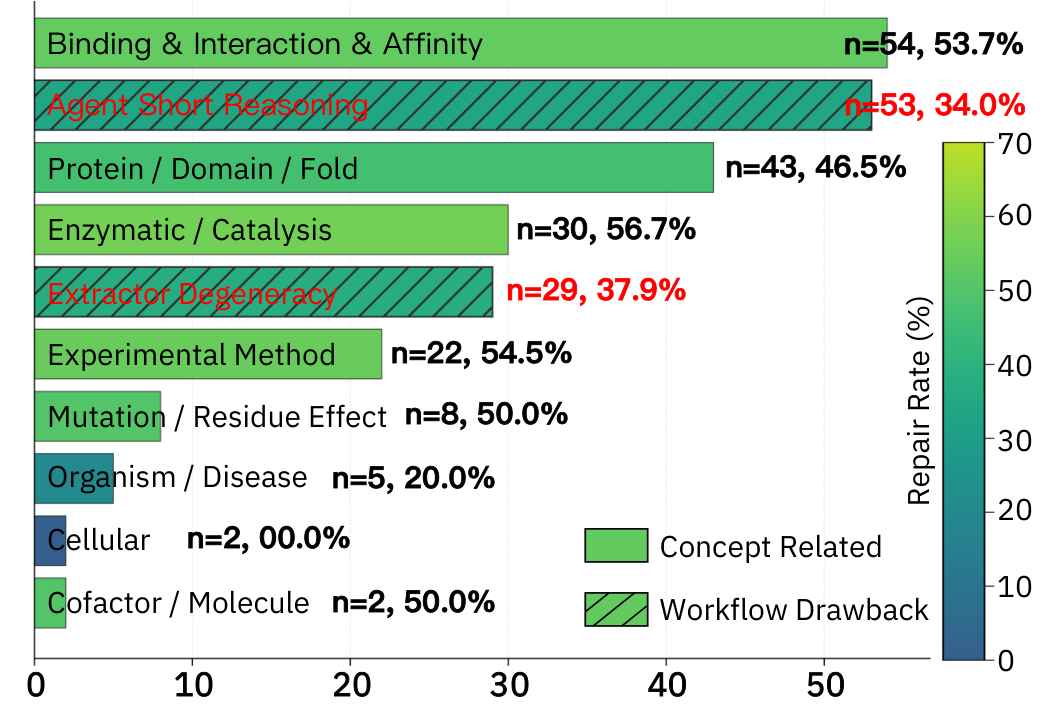
在统计 248 个真实幻觉概念的语义分布时,研究人员观察到了明显的中心化现象:高达 67% 的系统性失败直接源自领域知识缺陷,且近一半的错误疯狂扎堆在“酶与催化反应”(Enzymatic/Catalysis)这一核心主题周围,剩下的则是漫长的长尾。更残酷的是,越处于枢纽地位的通用概念,错误发生越密集,但由于关联丰富尚有抢救空间;而一旦 Agent 在长尾低度数节点上胡言乱语,其可修复率直接跌至冰点。
为了衡量每一次幻觉撬动的破坏力,SCHEMA 在全局概念图谱 $\mathcal{K}$ 上为每个中间主张赋予了一个拓扑权重 $w_g(c)$:
\[w_{g}(c) = 1 + \mathbb{1}\!\left[\eta(c)\neq\bot\right]\cdot\log\!\bigl(1+\deg_{\mathcal{K}}(\eta(c))\bigr)\]其中 $\eta(c)$ 将文本主张映射到图谱实体节点,$\deg_{\mathcal{K}}(\cdot)$ 代表该实体在无向图谱中的度数(即连接数)。对于脱离图谱的边缘陈述,权重取基础值 $1$;而越是靠近高密度调控枢纽的概念,随着对数缩放,其错误权重也越高。通过这种方式,SCHEMA 提出了拓扑加权幻觉严重性指标($\mathrm{HS}^{w}$)。
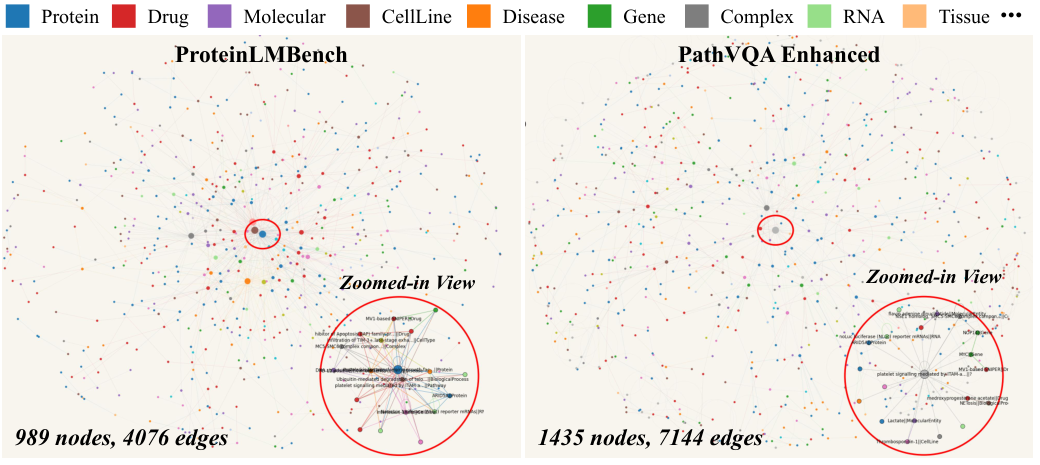
借助自动化的知识图谱构建流程,SCHEMA 涵盖了从分子机制(蛋白质域)到复杂病理交互(PathVQA-Enhanced)的不同复杂度基准,并基于图谱节点度数将概念划分为核心层(Core)、外围层(Peri.)和图外层(Off),全方位测试智能体应对多跳推理、文献验证与代码生成等高难度科研任务的能力。
测出底色:高准确率背后的“偷步”陷阱
在对 10 款主流微调与推理大模型展开实测后,SCHEMA 揭示了许多只看表面分数根本无法察觉的深层现象。
首先是准确率与轨迹诚实度的惊人解耦。在评估高风险科研任务时,人们通常默认“答对题目意味着理解了机制”,但数据无情地打破了这一假设。如图所示,模型的最终答案正确率与拓扑加权幻觉严重度($\mathrm{HS}^{w}$)之间仅呈现出极为微弱的关联。
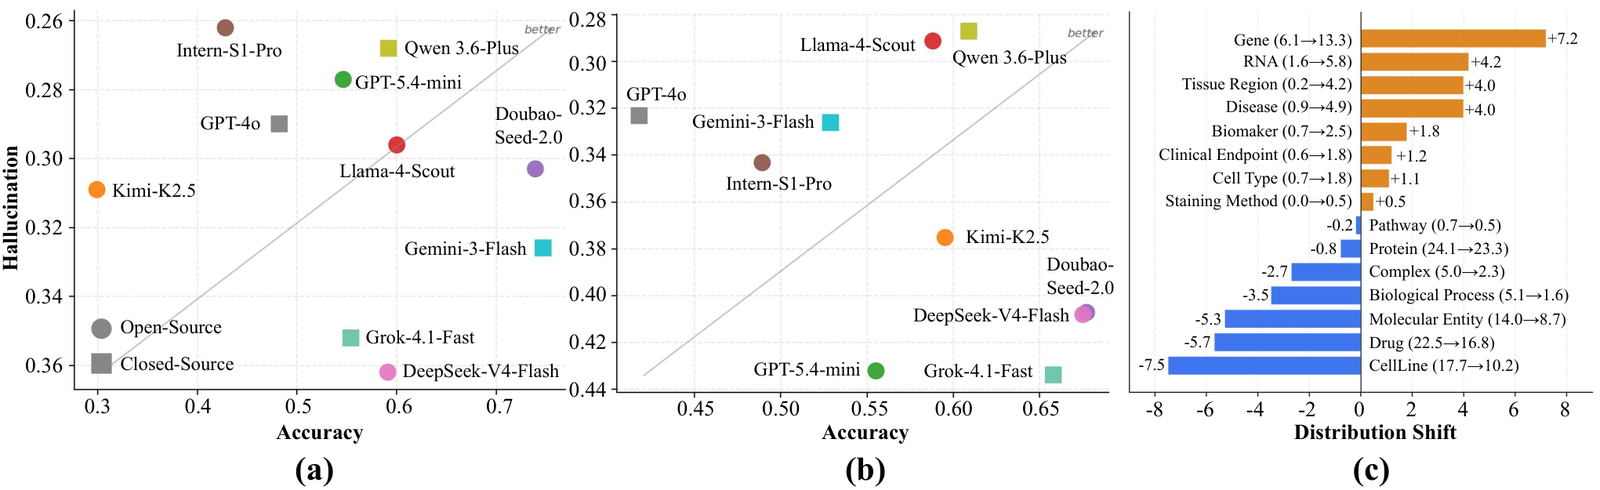
最典型的例子莫过于 DeepSeek-V4-Flash 与 GPT-5.4-mini:两者在蛋白质基准测试上的最终正确率同为 0.59,但在推导过程的纯洁性上,GPT-5.4-mini 的 $\mathrm{HS}^{w}$ 仅为 0.268,而 DeepSeek-V4-Flash 则飙升到了 0.362。类似地,Gemini-3-Flash 拿下了全场最高的端到端正确率,但中间推理轨迹中充斥着虚构概念;反观 Intern-S1-Pro,虽然受限于容量导致综合答对率不高,但其推导轨迹却维持着极高的拓扑诚实度。这种“误打误撞拿高分”的捷径推理,对于基础科研而言无异于埋下一颗隐形炸弹。
而在拓扑鲁棒性方面,闭源顶尖模型(如 GPT-5.4-mini)表现出了对核心枢纽概念极强的定力,即便犯错也大多局限在不痛不痒的外围概念上;部分开源模型虽然原始的幻觉发生频率(HR)不高,但一旦翻车往往直接挑中关键枢纽,导致加权严重度 $\mathrm{HS}^{w}$ 奇高不下。
复杂机制的验证成本与“不完全锚定”怪圈
随着评测层面的深入,研究团队还捕捉到了两个颠覆直觉的现象。
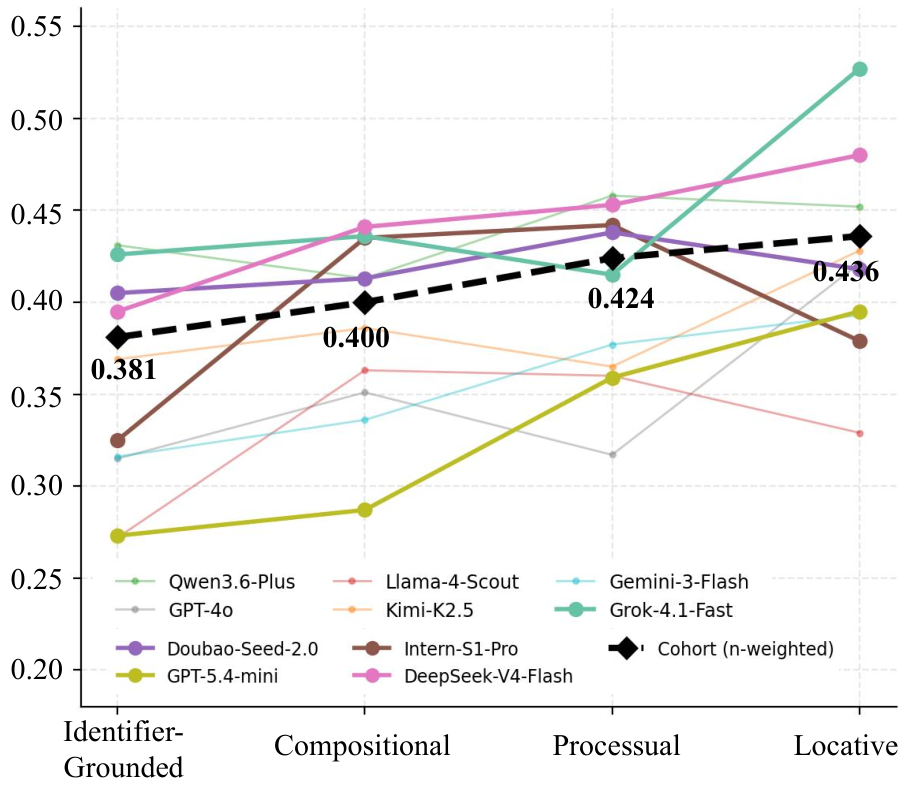
其一,概念的反驳难度与幻觉严重性呈正相关。如果将科学实体按照证伪的认知成本划分为:基础标识(数据库一查便知)、成分匹配、过程因果推导以及原位方法验证,会发现加权严重度 $\mathrm{HS}^{w}$ 沿着这条轴线单调递增。Agent 在面对简单的 ID 和命名时经常信口开河(错误频率高,但容易被纠错工具拦截);而在面对复杂的动态生化过程与定位方法时,它们虽然很少轻易下断言,但只要一旦产生虚构,往往具有极强的误导性和毁灭性。
其二,“半懂不懂”的图谱上下文比“完全盲猜”更有毒害性。直觉上,给模型提供越多相关的图谱先验,表现应当越好。但细分数据呈现出了反常的下凹形态:在“强锚定”(Strong Anchoring)和“完全未锚定”(Unanchored)的情况下,模型的准确率反而较高;而在“弱锚定”(Weak Anchoring,即提供了相关但不完整的图谱线索)环境下,包括 Gemini-3-Flash、GPT-4o、Kimi-K2.5 在内的多款顶级模型均跌入性能低谷。
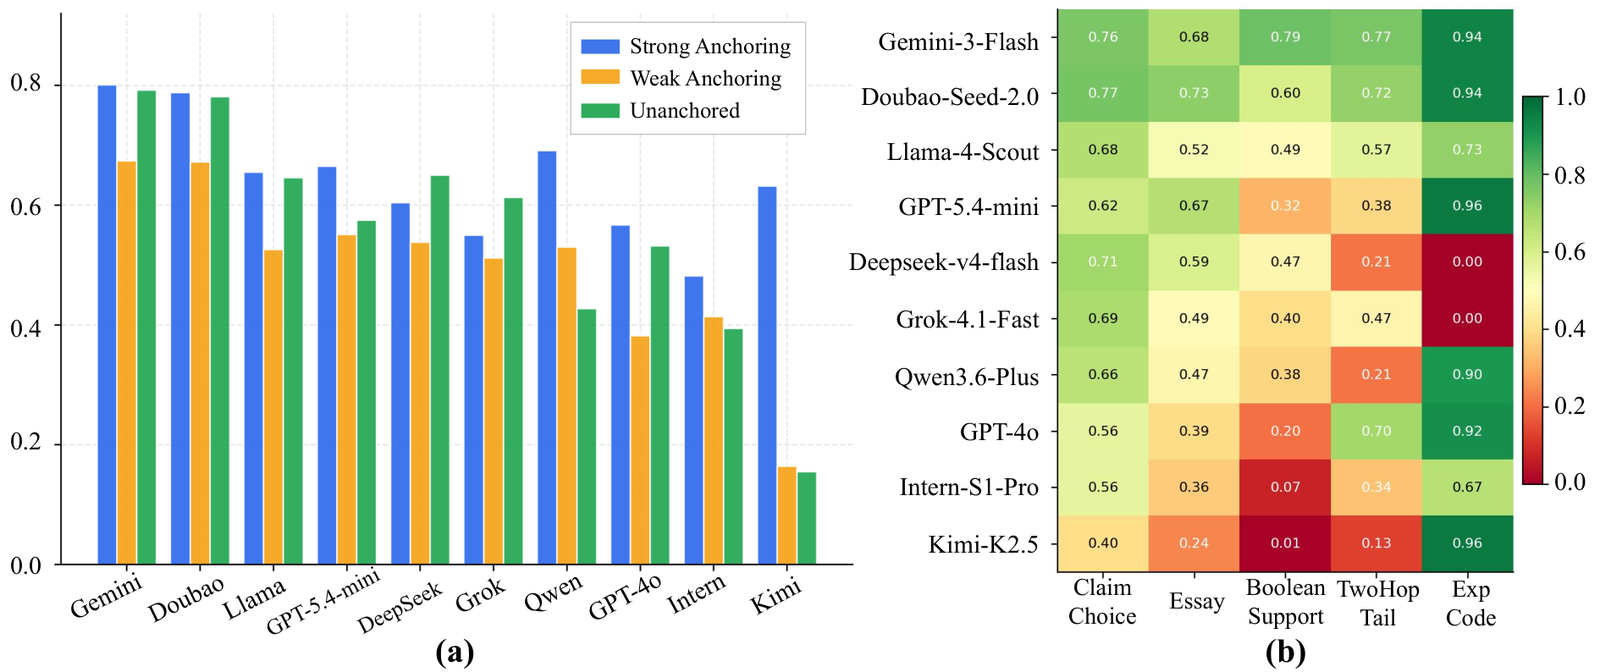
究其原因,完全缺乏外部线索时,Agent 会倾向于保守调用参数化记忆或执行全域泛化检索;而一旦被投喂了碎片化、结构残缺的信息,模型容易陷入“过度自信”的幻觉陷阱,基于畸形的局部拓扑煞有介事地拼凑伪逻辑。其中 Kimi-K2.5 在强锚定下可取得 0.63 的成绩,在弱锚定下却暴跌至 0.16,断崖式的滑坡揭示出科研智能体在应对复杂检索上下文时的脆弱性。
走向机理级的智能体评测
从孤立的事实匹配,到基于拓扑网络的轨迹追踪;从单纯看最终对错,到用反事实干预拆解因果链路,SCHEMA 为科学计算与 AI for Science 领域的可靠性评测立下了一个崭新的标杆。
这项研究给整个 AI 社区带来的启示十分鲜明:在容错率极低的科研场景中,单纯追求排行榜上的终局准确率已经毫无意义。一个合格的科研 Agent,不仅需要能够给出正确的结论,更需要在知识网络的纵横交织中,守住推演过程的每一步逻辑底线。未来科研智能体的演进,必须从“表面对齐”彻底转向“机理可信”,而感知知识拓扑与中间推理审计,正是通往这一目标的必由之路。