ActFovea:无需重训VLA!视动一致性守卫让受扰成功率从49%回弹至90%
ActFovea: Runtime Safeguarding for VLA Policies via Spatiotemporal Visual-Action Consistency
在具身智能领域,基于视觉-语言-动作(Vision-Language-Action, VLA)的大模型正成为通用机器人操控的核心方案。从 RT-2、OpenVLA 到采用流匹配(Flow Matching)的 $\pi_0$,策略模型直接根据环境图像与自然语言指令输出连续控制指令。为了平滑运动并分摊推理开销,目前前沿的 VLA 模型普遍采用“动作分块”(Action Chunking)机制,即单次前向推理预测一段未来动作序列。这种设计虽然带来了连贯的操控轨迹,却也引入了一个致命隐患:机器人必须假设在这段开环执行的时间窗口内,视觉感知、本体感知状态和执行的动作始终处于精确对齐的物理演化过程中。
ArXiv URL:https://arxiv.org/abs/2607.29169
一旦这种物理世界的时空对齐被打破——无论是相机受到局部污损、传感器传输产生延迟、电机轨迹发生细微漂移,还是视频流意外冻结重放,依赖动作分块的 VLA 策略就会在瞬间“失明”或“脱轨”,持续在错误的状态假设下执行动作,导致严重的操控碰撞或任务崩溃。以往的研究要么尝试通过对抗训练重新训练庞大的 VLA 模型,要么依靠外挂简单的控制屏障或滤波算法。前者计算开销巨大且难以穷尽未知干扰,后者则因过于保守而大幅削弱机器人正常状态下的灵活性。
针对这一核心瓶颈,最新研究提出了 ActFovea。这是一个完全即插即用(Plug-and-play)、无需重新训练或微调底层 VLA 模型的运行时安全守卫框架。ActFovea 抓住了物理交互的核心物理规律——时空视-动一致性(Spatiotemporal Visual-Action Consistency),将机器人运动学、本体状态与动作历史结合,动态构建以交互为中心的“动作条件中央凹”,并判定扰动是否具备可恢复性。在基于 $\pi_0$ 的 40 项 LIBERO 基准任务评估中,ActFovea 在局部视觉遮挡干扰下的操控成功率从 49.3% 大幅恢复至 90.3%,弥补了 93.7% 的性能缺口;在画面冻结重放极端情况下,实现了 100% 的及时安全停机。这项工作为大模型操控走向高可靠物理部署提供了一条极具启发性的技术路线。
破坏控制闭环的四种隐形杀手
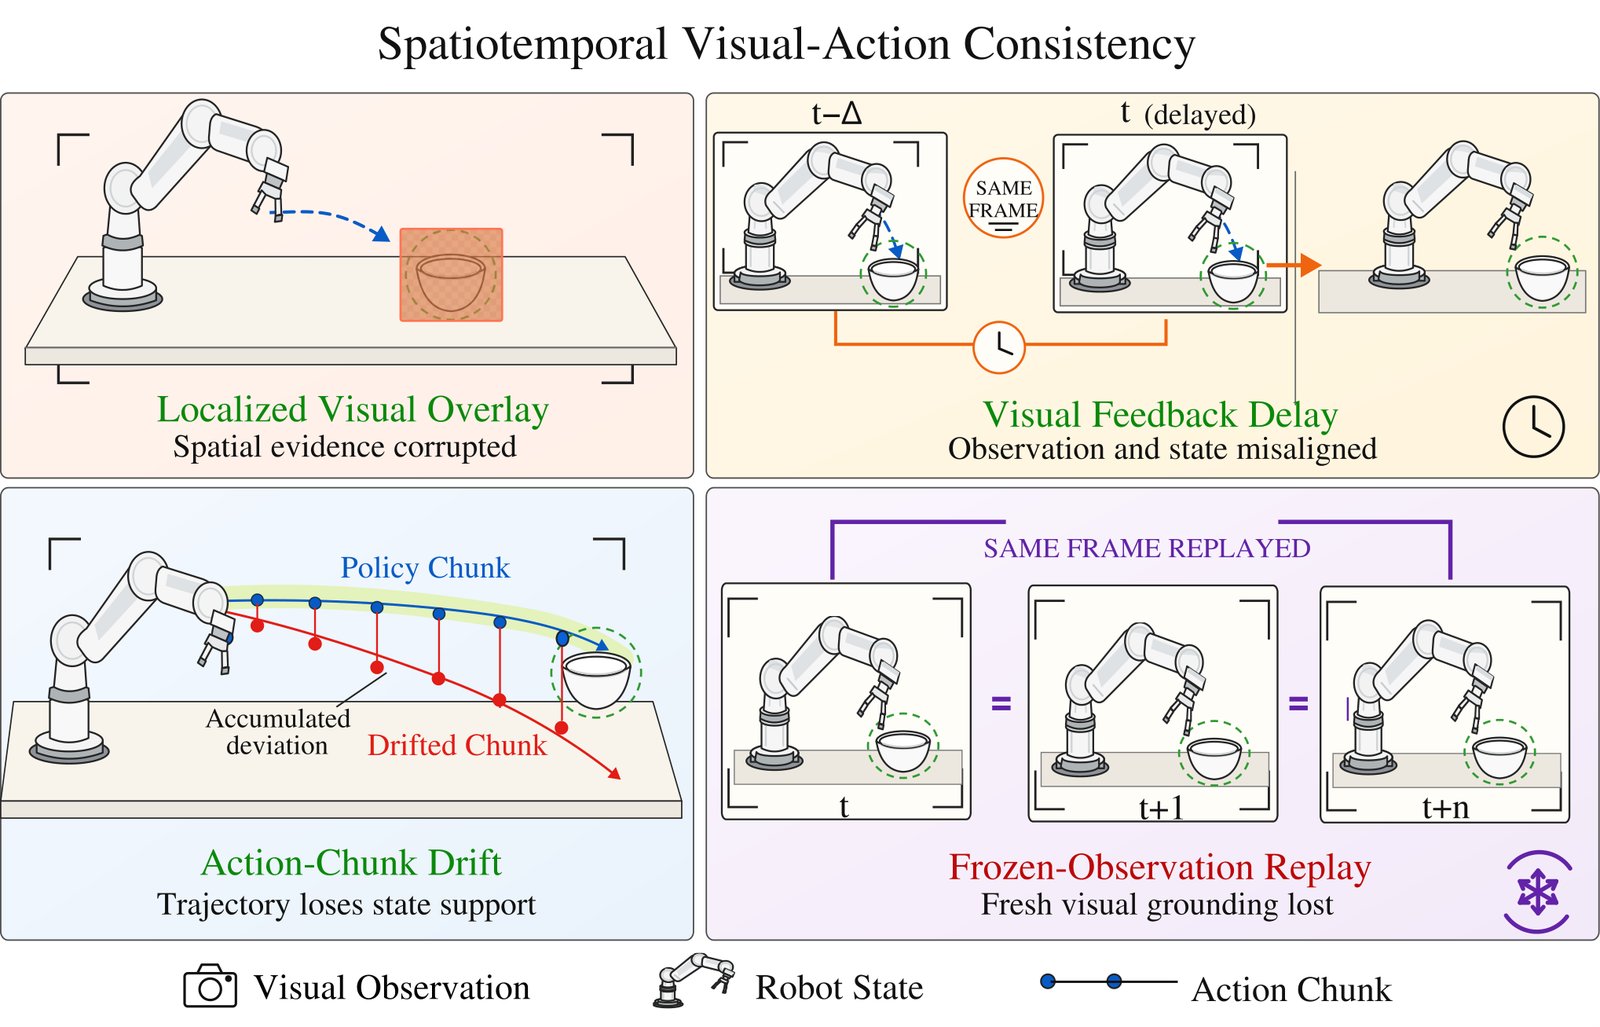
要理解 ActFovea 的精妙之处,首先需要看清 VLA 在现实运行环境中到底面临怎样的危机。如图 1 所示,现实部署中的异常并不总是显眼的物理碰撞,而是一系列破坏感知-执行闭环的细微扰动:
第一类是局部视觉遮挡(Localized Overlays)。机械臂镜头上的污渍、光斑或环境中的突发遮挡,会破坏关键物体的空间几何线索。这类干扰通常只发生在视野局部,背景与全局运动依然存在,但足以让端到端视觉编码器产生灾难性的特征漂移。
第二类是视觉反馈延迟(Visual-Feedback Delay)。在边缘计算设备上,图像采集、压缩传输与推理管道的拥堵常常导致数个时间步的时滞。此时机器人收到的图像其实来自数步之前,若策略直接根据陈旧画面输出控制,必然出现执行超前、控制超调或剧烈震荡。
第三类是平滑动作漂移(Smooth Action-Chunk Drift)。近期安全研究(如 SilentDrift)指出,动作分块内部微小且连续的累积偏差,虽然在单步执行中看起来十分平滑,却会使整条运动轨迹悄然失去真实状态的支持,最终导致机械手完全抓空或错位。
第四类是冻结观测重放(Frozen-Observation Replay)。图像传感器由于死机或恶意干扰持续输出同一帧画面(如 FreezeVLA 攻击),彻底切断了新鲜视觉反馈与机器人实际运动的关联。如果系统无法识别这种状态,机器人便会陷入无休止的无效执行甚至盲目冲撞。
以往的防护机制往往针对单一扰动类型设计。例如,控制屏障函数(CBF)专注于几何避障,动作裁剪平滑法(Action Clipping)只能粗暴限制位移幅度,而单纯依赖时间戳的守卫规则只要遇到连续延迟就会彻底瘫痪。更严重的问题在于,盲目保守的停止策略会扼杀有效操作,而把所有异常都当成可修复错误又会在失去感知基准后盲目执行。ActFovea 的立足点正是破除这种碎片化防御,在统一的理论框架下判定一致性与可恢复性。
动作条件中央凹:让感知视线追随物理交互
ActFovea 的第一大核心创新,在于颠覆了传统计算机视觉中“以图像为中心”的注意力机制,构建了动作条件中央凹(Action-Conditioned Foveation)。
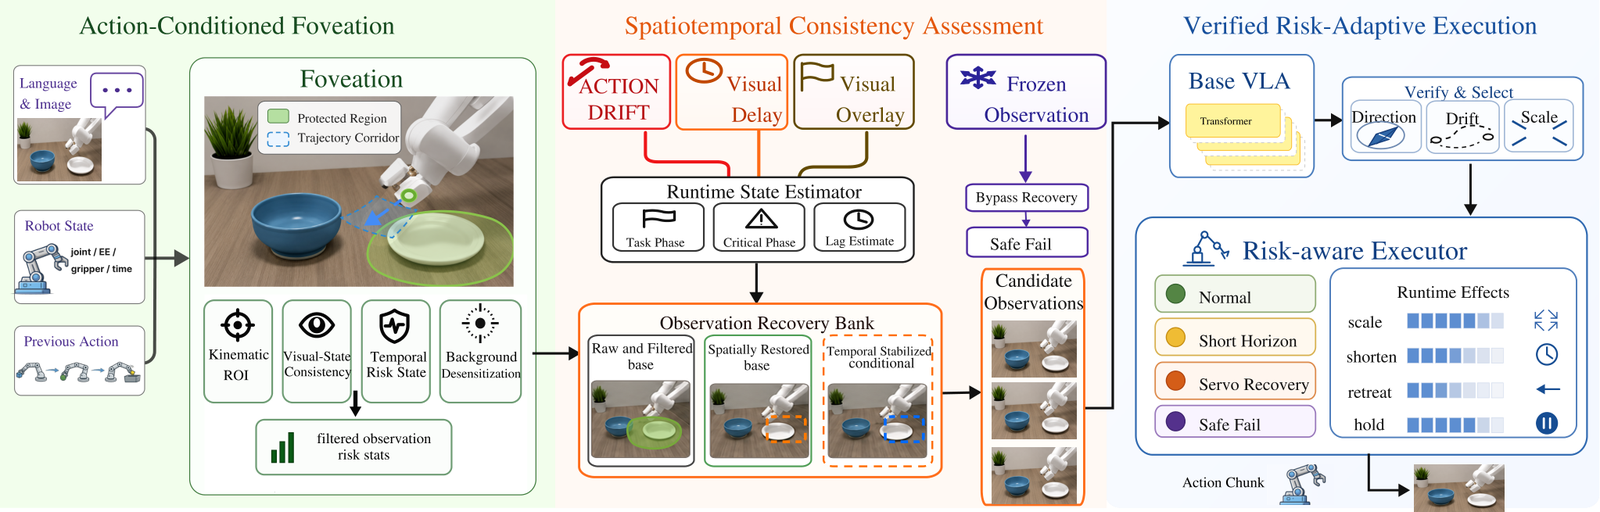
人类在执行精细操作时,视线焦点绝不会停留在视野中心,而是紧密跟随机械手末端执行器以及预计发生接触的交互区域。ActFovea 借鉴了这一神经生物学机制,直接利用机器人前向运动学(Kinematics)、关节/本体状态以及最近执行的动作历史,预测当前时间步的关键接触区域和未来运动走廊(Predicted Motion Corridor)。
形式化地,ActFovea 在当前时间步 $t$ 的多视角图像空间中,计算接触投影掩码 $M_{c,t}^v$ 与轨迹运动掩码 $M_{\Gamma,t}^v$ 的并集,并通过形态学膨胀操作生成动态保护区域:
\[M_{t}^{v}=\operatorname{Dilate}(M_{c,t}^{v}\lor M_{\Gamma,t}^{v},r_{m})\]基于该掩码,输入图像被重构为:
\[\widetilde{I}_{t}^{v}=(1-\alpha\bar{B}_{t}^{v})\odot I_{t}^{v}+\alpha\bar{B}_{t}^{v}\odot\mathcal{E}(I_{t}^{v})\]其中 $\bar{B}_{t}^{v}$ 抑制了与任务无关的背景区域或存在异常的高频噪声,而核心交互走廊内的视觉证据则被高保真保留。这一设计的精妙之处在于,中央凹不是固定在屏幕坐标轴上,而是随任务阶段和机器人动作动态延伸。
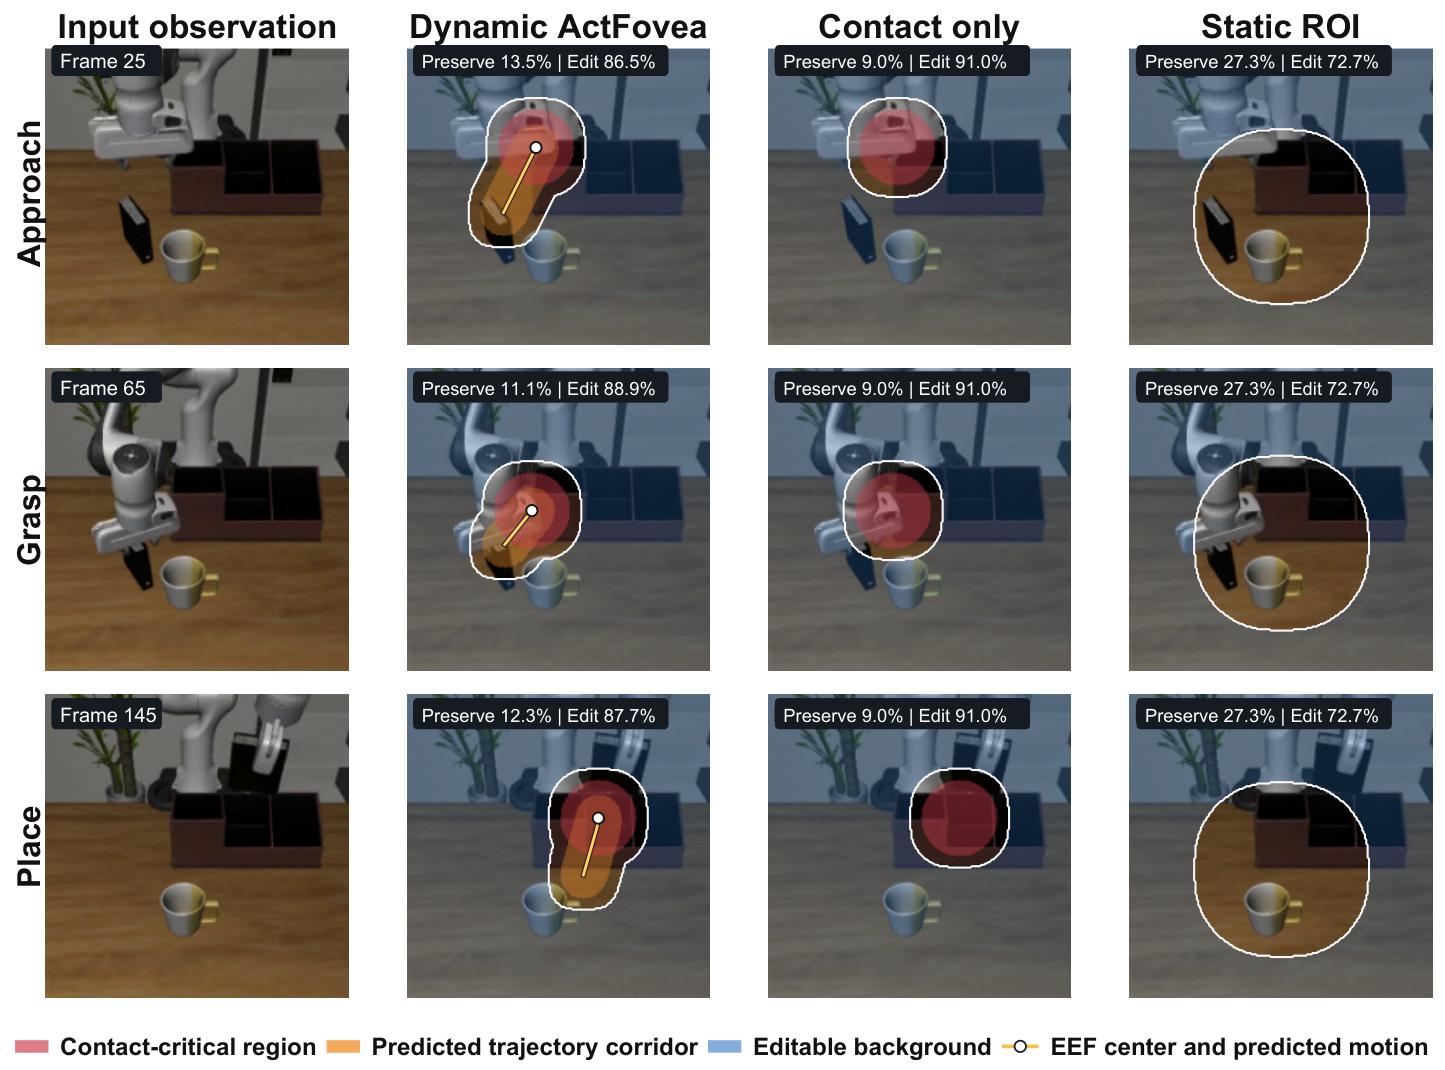
图 4 直观对比了不同中央凹策略的差异。在“接近”、“抓取”到“放置”的全流程中,静态中央凹无法适应末端执行器的移动;纯接触区域中央凹虽然锁定了夹爪,却丢失了前方即将穿过的运动走廊;只有 ActFovea 的动态动作条件中央凹,既完整包裹了接触点,又沿着动作序列的未来轨迹提前铺设了视觉注意力支持区,从而从根本上过滤掉了无关区域的虚假扰动。
视-动一致性监控与动作块验证
拥有了聚焦后的感知区域后,ActFovea 如何实时判断系统是否安全?系统通过一个轻量级的一致性监控器(Consistency Monitor),评估视觉变化是否符合运动学与动作转换逻辑。
系统综合考量像素残差、相机运动估计、时序延迟惩罚与标定误差,综合评估运行时风险指数 $R_t$:
\[R_{t}=\operatorname{clip}\bigl(\beta\bar{r}_{t}+(1-\beta)r_{t}+p_{t}^{\mathrm{cam}}+p_{t}^{\mathrm{lag}}+p_{t}^{\mathrm{cal}},0,1\bigr)\]根据 $R_t$ 及特征统计量,一个确定性路由模块将当前状态划分为“可恢复扰动”或“不可恢复状态”。这种设计彻底摆脱了对外部仿真器状态、特权标注或人工扰动标签的依赖,完全建立在可观测的时空物理规律之上:
- 针对可恢复扰动(如局部遮挡、有限时滞、轨迹轻度漂移):ActFovea 激活扰动自适应候选生成器。对于局部遮挡,利用中央凹滤波重建干净观测;对于有限视觉延迟,利用本体运动学参考量对图像进行反向刚体平移对齐。然而,模型并不盲信这些修复图像,而是将原始图像与各修复候选图像同时送入冻结的 VLA 策略,生成备选动作块,并通过动作验证器(Action Verifier)进行打分校验:
只有通过几何连续性、动力学可行性验证的最优动作块,才会被允许下发执行。
- 自适应两阶段仲裁执行:在下发底层控制器前,监控器与验证器分别计算速度缩放系数与执行视界长度,取保守交集执行:
若系统处于边际风险状态,系统会自动缩短动作块的开环执行步数(从长 Horizon 动态切为短 Horizon),通过更密集的重新规划抵抗潜在偏差。
- 针对不可恢复扰动(如画面完全冻结重放):当监控器检测到图像像素长时间高度静止,而机械臂关节状态却在持续变化时,视-动一致性被彻底证伪。此时任何基于幻觉图像的“修复”尝试都是极度危险的。ActFovea 会果断切断动作执行,触发有界安全失效(Bounded Safe Failure)协议:在安全阈值内下发反向回退或制动锁死指令,让机器人平稳悬停,彻底杜绝失控破坏。
40 项操作任务全面实测:守卫成效几何?
为了严谨验证 ActFovea 的有效性,研究团队采用了具身智能领域极具说服力的基准设置:使用完全冻结的 $\pi_0$ 策略检查点,在 LIBERO 模拟平台的四大套件(LIBERO-Spatial、LIBERO-Object、LIBERO-Goal、LIBERO-10)共计 40 项连续操控任务上展开闭环评测。每个配置运行 50 个 Episode,全套对比累计覆盖数千次完整闭环交互。
评测围绕前述四种真实扰动展开,衡量指标包括任务成功率(Success Rate, SR)、绝对防御收益(Gain, 百分点)以及归一化恢复率(Normalized Recovery Rate, NRR)。核心评测结果提炼如下:
-
局部视觉遮挡的强力反弹:在注入固定的棋盘格局部视觉干扰后,原始 $\pi_0$ 基线策略的平均成功率由干净环境下的 93.0% 暴跌至 49.3%。引入 ActFovea 后,策略成功率强势回升至 90.3%,绝对增益达到 +41.0 个百分点,恢复了 93.7% 因干扰造成的性能损失(NRR=93.7%)。
-
多视角反馈延迟下的稳定性提升:当外部相机与腕部相机被强制滞后当前本体状态 3 帧时,原始基线成功率受挫,ActFovea 成功实现 +9.8 个百分点 的绝对增长。
-
抵抗平滑动作轨迹漂移:在动作块受到平滑相位扰动时,ActFovea 依靠自适应动作验证与视界截断,实现了 +7.0 个百分点 的性能提升,将整体成功率拉升至 90.1%。
-
零代价保护基准性能:尤为难得的是,在完全没有扰动的纯净(Clean)环境下,ActFovea 几乎不产生误报,基础操控成功率稳定保持在 93.0%,完全克服了传统守卫策略“牺牲正常操作性能换取安全性”的通病。
为了进一步厘清 ActFovea 的优势来源,研究人员还对比了目前工业界和学术界常用的免训练运行时防护方案:
-
固定短视界策略(Fixed Short Horizon):通过每次只执行动作块的前几个步长来强制频繁重规划。实验显示,该方法在动作漂移场景下表现不错(89.9%),但在面对局部遮挡时成功率骤降至 32.4%,面对视觉延迟时仅为 70.7%。单一的控制截断无法解决感知层面的根本扭曲。
-
动作裁剪与平滑(Action Clip/Smoothing):粗暴限制动作幅度不仅未能抵御复杂扰动,反而将干净环境下的基准成功率拉低到 82.2%。
-
纯时间戳阻断(Timestamp-Only Hold):当遇到连续的相机丢帧或延迟时,该机制会因过于敏感而陷入死锁,在视觉延迟测试中的操控成功率直接降为零。而在面对冻结重放时,它虽有 96.55% 的时间处于等待状态,却因缺乏终端安全退出机制,永远无法转化为安全停机,最终导致超时失败。
相比之下,ActFovea 在面对冻结重放(Frozen Replay)时展现出无可比拟的鲁棒性:在所有测试轮次中,100% 触发了及时的有界安全失效,未保护失败(Unprotected Failure)发生率为 0%。
消融实验进一步印证了模块协同的必要性:若去掉动作条件中央凹与观测恢复模块,局部遮挡下的防御增益直接由 +41.0% 跌落至负值;而若去掉动作块验证模块,系统在应对动作漂移与时间延迟时的增益也将大幅缩水。空间层面的感知重建与时序层面的动作校验,共同构成了不可分割的防御双翼。
结语与具身智能落地启示
ActFovea 的提出,为大模型时代机器人控制系统的安全落地提供了极具价值的新思路。它明确了一件事:增强通用具身策略的鲁棒性,并不一定非要卷入无限扩大模型参数、采集庞大攻击数据集重训的消耗战。
物理世界本身蕴含着严谨的时空与运动学法则。视觉观察到的图像流动,必须与机械臂本身的编码器读数、动力学约束在时间上严密咬合。将经典机器人学的运动学先验、前向几何投影,与端到端深度 VLA 策略通过轻量级接口有机结合,正是“经典控制理论”与“前沿生成式模型”相辅相成的典型范例。对于正在探索工厂流水线、仓储物流及家庭服务机器人落地部署的团队而言,这种免重训、轻量且可解释的运行时守卫框架,无疑展现了强大的工程实用性与落地潜力。