ST-WAM:攻克视频世界模型的幻觉缺陷,真机抗干扰成功率翻倍
ST-WAM: Semantic-Temporal World Action Model for Robust Manipulation under Visual Distribution Shifts
让机器人学会“预见未来”,是具身智能领域最具吸引力的探索方向之一。世界动作模型(World Action Models,简称 WAM)通过联合建模未来视觉画面的演变和机器人的动作序列,试图把大规模视频生成模型的物理先验直接迁移到具身控制中。然而,这种建立在像素或视频变分自编码器(VAE)潜空间预测上的架构,在真实世界中遇到了隐蔽却致命的脆弱性。
ArXiv URL:https://arxiv.org/abs/2607.28993
当环境的光照、背景纹理或相机视角发生微小改变时,那些在标准基准上近乎完美的视频生成模型,并不会老老实实预测新环境下的真实画面,反而会顽固地“脑补”回训练集里的旧场景。
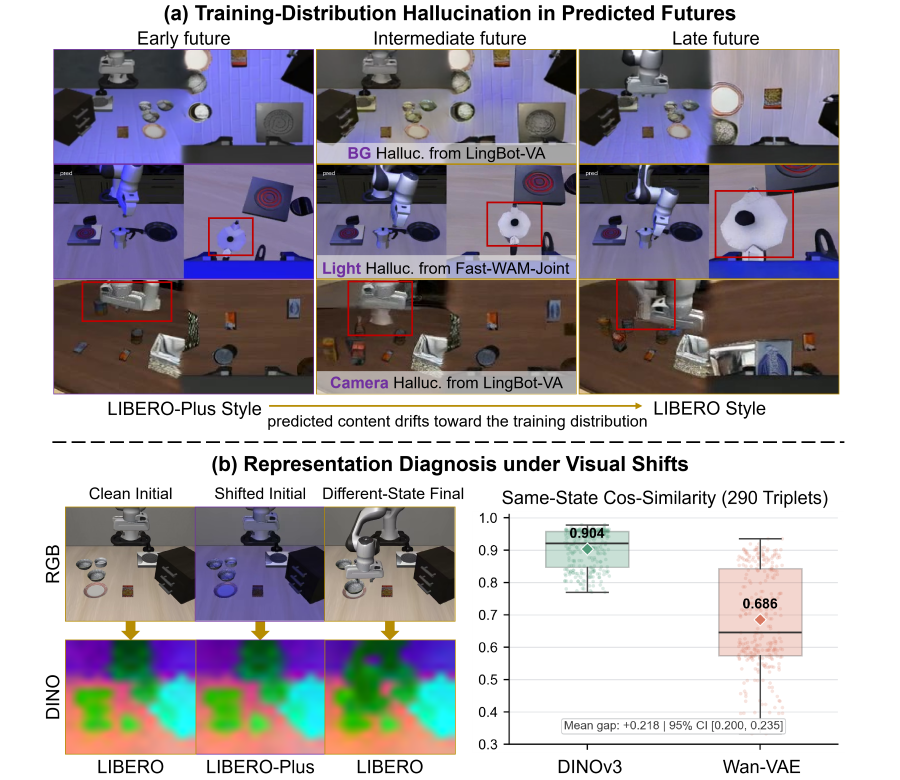
最新研究指出了这一关键现象:训练分布幻觉(Training-Distribution Hallucination)。在视觉分布偏移下,传统视频动作模型生成的未来视频有高达 70.6% 明显漂移回训练集风格,直接导致下游动作崩溃。为了解决该问题,研究团队提出了 ST-WAM(Semantic-Temporal WAM)。该方法不纠结于费时费力地“修补”未来像素画面,而是引入自监督视觉基础模型 DINOv3 建立双向语义-时间建模:向前预测鲁棒的语义状态演化,向后检索与当前意图相关的历史动作依据。
在无需额外具身数据预训练的前提下,ST-WAM 在 LIBERO-Plus 零样本泛化测试中相比 Fast-WAM 提升了 21.3 个百分点;在真实机械臂评测中,视觉分布偏移下的操作成功率直接从 25.8% 翻倍至 61.5%,推理耗时仅 756 毫秒。
像素生成的软肋:顽固的“训练分布幻觉”
现有基于视频生成的 WAM(如 LingBot-VA、Fast-WAM)高度依赖 VAE 潜空间来重构未来画面。VAE 的目标是尽可能还原每一个像素细节,这种优化目标导致与操作直接相关的关键状态变化(例如夹爪是否闭合、物体位移)与任务无关的环境低级特征(桌面木纹、环境光泽)紧紧交织在了一起。
当研究人员将仅在 LIBERO 干净场景下训练的模型放到带有干扰的 LIBERO-Plus 进行零样本评测时,问题暴露无遗。无论当前输入的真实画面是强光照射还是换了新桌面,模型预测出的未来视频序列都会随着时间步推进,自发演变回 LIBERO 原有的柔和灯光与默认桌面。经过人工对背景、光照、视角三类视觉扰动下的 180 组预测视频进行审计,这类“训练分布幻觉”的出现比例达到了 70.6%。这解释了为何 Fast-WAM 在原版 LIBERO 上能拿到 97.6% 的高分,转移到 LIBERO-Plus 后却暴跌至 51.5%。
为了从表征根源上探究差异,作者设计了控制变量的“三帧诊断实验”(Frame-Triplet Diagnosis)。研究人员采样了 290 组三帧数据:两帧是来自相同任务、机器人与物体物理状态完全相同但带有视觉干扰的初始帧,另一帧则是来自同一任务但在操作完成后的终止帧。
测试结果显示,DINOv3 在相同物理状态但带有视觉扰动的两帧之间,余弦相似度均值高达 0.904,而 Wan-VAE 潜空间仅为 0.686。更为关键的是,在判断“哪两帧属于同一操作状态”时,DINOv3 在 95.2% 的情况下都能正确给出更高相似度,而 Wan-VAE 的准确率仅有 60.0%。这表明以 DINOv3 为代表的自监督语义表征,天生具备对低级视觉噪声的免疫力,能够纯粹提取与任务状态本质强相关的几何语义信息。
双向时序建模:前向语义专家与后向意图检索
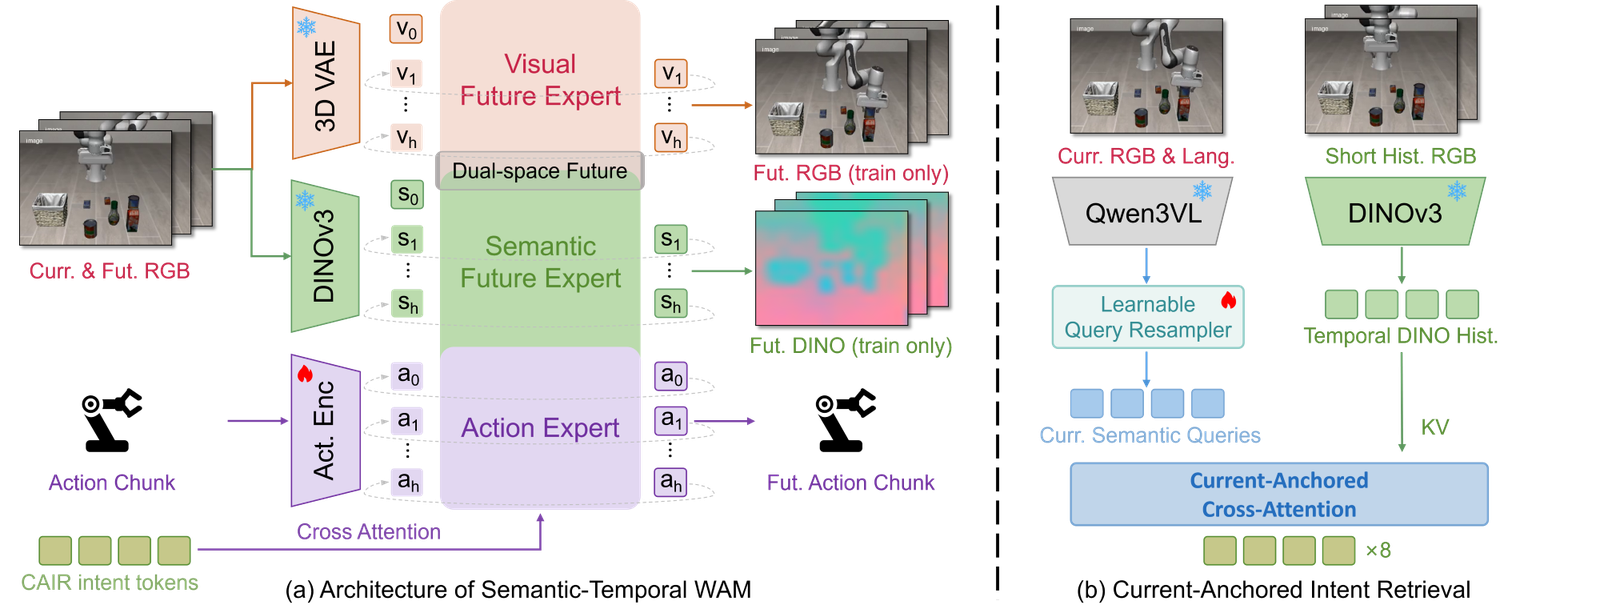
既然 VAE 潜空间擅长刻画连续细腻的物理接触细节,而 DINOv3 擅长捕捉抗干扰的高层语义状态,ST-WAM 的核心设计便是将二者有机结合,构建向前预测与向后追溯的双向语义系统。
双空间未来专家(DSFE)
在面向未来的预测方向上,ST-WAM 提出了双空间未来专家(Dual-Space Future Experts,DSFE)。模型并不废除原有的视频生成先验,而是采用包含三个分支的混合 Transformer 架构(Mixture-of-Transformers):
-
视觉未来分支:基于冻结的 Wan2.2-TI2V-5B 视频 DiT,持续预测未来几步的 VAE 潜变量,保留大规模视频预训练带来的精细连续物理交互规律;
-
语义未来分支:采用 1B 规模的 DiT,专门预测对应未来时间步的 DINOv3 特征,提供抗干扰、任务驱动的语义演变目标;
-
动作分支:独立的 1B DiT,负责最终机器人动作块(Action Chunk)的流匹配生成。
为了保证计算效率和信息流向的规范,ST-WAM 引入了精巧的非对称交叉注意力掩码结构。
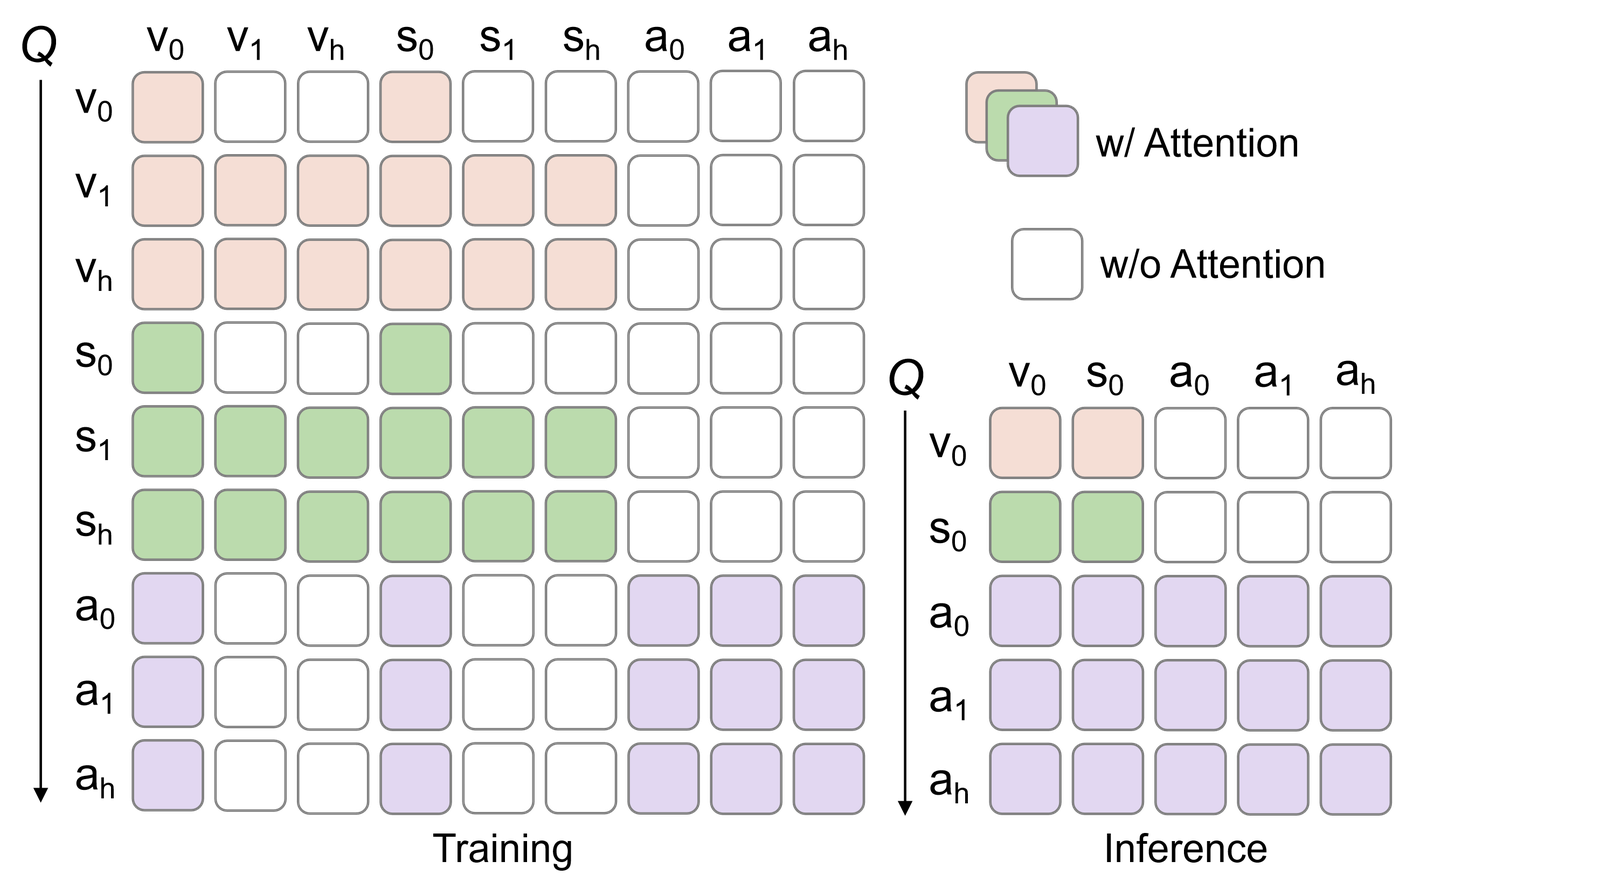
在训练时,当前的 VAE 和 DINO 观察作为不可篡改的锚点,供所有未来流和动作流读取。两个未来预测专家之间允许互相交互、对齐预测,但动作分支绝不能直接偷看未来的真实标签,防止信息泄漏。这种隔离带来了一个工程上的关键优势:在实际机器人部署推理时,完全无需生成未来的视频帧或语义特征。未来的两个专家只在训练阶段充当高级辅助监督目标,推理时模型直接退化为一个轻量高效的动作预测器。
基于当前锚点的意图检索(CAIR)
面对严重的视觉扰动,机器人仅凭当前这一帧画面往往难以明确自身的任务进度。ST-WAM 设计了当前锚定意图检索模块(Current-Anchored Intent Retrieval,CAIR)。
以往直接利用可学习 Query 压缩历史轨迹的做法容易引入无关噪声。CAIR 首先调用冻结的视觉语言大模型 Qwen3-VL-4B,将当前这一帧的观察和语言指令融合为多模态语义锚点。接着,利用这个包含当前意图的锚点作为 Query,去自适应检索过去 $M$ 个时间步中的 DINOv3 历史特征。如此一来,机器人便能在混杂的感知输入中,清晰回忆起“自己刚刚完成了哪一步、接下来的意图是什么”,进而为动作专家提供明确的上下文条件。
三分支系统在训练阶段采用统一的 Flow Matching 目标联合优化,分别计算 VAE 速度场、DINO 速度场以及动作流的损失函数,端到端完成参数学习。
仿真基准评测:零样本鲁棒性的跨越
研究团队在多个标准模拟器上对 ST-WAM 进行了严苛测试。在四个 LIBERO 标准套件(Spatial、Object、Goal、Long 共 40 个任务)中,ST-WAM 达到了 98.7% 的平均成功率,不仅超过了基于相同基底架构的 Fast-WAM(97.6%),也高于 Motus(97.7%)和 LingBot-VA(98.5%),刷新了该基准的表现。在双臂协作基准 RoboTwin 2.0 上,即便面对高强度随机化环境,ST-WAM 仍以 92.8% 的总成功率稳居首位。
真正的分水岭出现在没有针对性微调的 LIBERO-Plus 零样本泛化测试中。该评测覆盖了相机视角、光照强度、桌面纹理、传感器噪声等 7 个维度的扰动:
-
同样不采用额外具身预训练,Fast-WAM 最终得分仅为 51.5%,而 ST-WAM 拿下了 72.8%,整整高出 21.3 个百分点;
-
在相机位姿变动和传感器噪声两项极具挑战的测试中,ST-WAM 的提升幅度分别达到了惊人的 39.0 和 41.8 个百分点;
-
该成绩甚至超越了 OpenVLA-OFT(69.6%)和 X-VLA(71.4%)这类历经海量具身轨迹预训练的专用大模型。
更难得的是推理性能。在单块 NVIDIA A100-80GB GPU 上,采用 10 步流积分算法生成包含 32 步的动作块,ST-WAM 整体端到端推理时间仅需 756 毫秒(Fast-WAM 为 609 毫秒)。这意味着兼顾双向语义增强与高鲁棒性的同时,模型依然保持了极佳的实时控制响应能力。
真实机器人评测:视觉干扰下成功率翻倍
在具身智能领域,仿真环境的表现往往会因为感知鸿沟而在实机上折戟。团队选用 Agilex Piper 6 自由度单臂机器人,设定了插花、抽屉收纳、舀豆子、水果摆放和悬挂杯子 5 项动作轨迹与几何接触要求各异的真实任务。
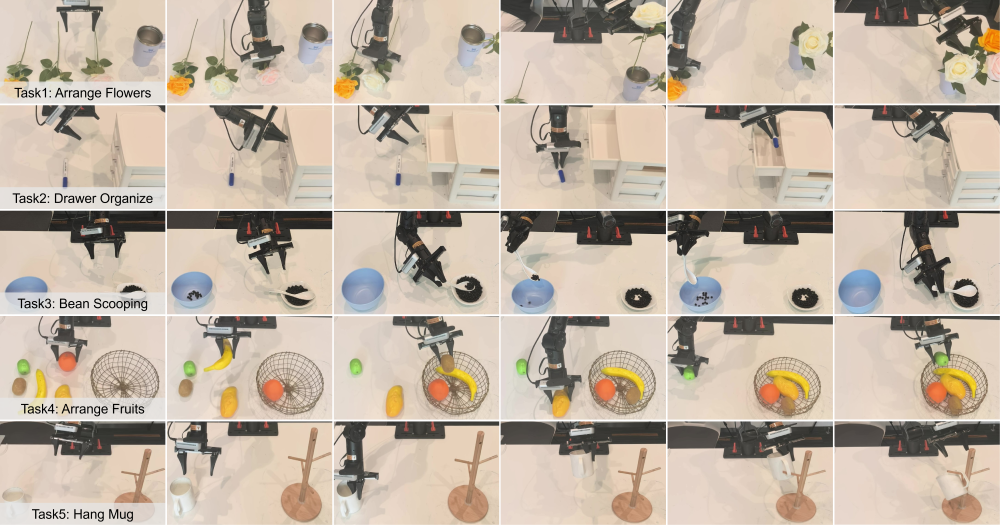
每个任务仅使用在固定干净环境下采集的 50 条演示数据进行后训练。随后,在不进行任何微调的前提下,将机器人置于四种视觉变动场景中:更换从未见过的桌面纹理布、剧烈改变环境光照、替换同功能但颜色或款式不同的操作对象,以及三者叠加的复合扰动(Compound)。
评测结果给出了鲜明的对比:
-
在默认干净环境下,ST-WAM 取得了 79.3% 的操作成功率,大幅领先于 $\pi_{0}$ 的 47.3% 和 Fast-WAM 的 64.7%;
-
在各类视觉变动环境下,Fast-WAM 的成功率断崖式下跌至 25.8%(降幅达 38.9 个百分点),复合扰动下仅剩 15.3%;
-
相反,ST-WAM 在变动环境下的整体平均成功率依然稳定在 61.5%(仅下降 17.8 个百分点),在严苛的复合扰动下仍保持 48.0% 的成功率。
这一对比直观印证了纯像素驱动模型在遇到真实环境干扰时的致命软肋,同时也证明了引入 DINOv3 语义约束后策略的抗干扰韧性。
消融分析:关键设计为何生效?
为了明确收益的具体来源,作者展开了详尽的消融对比。
如果移除双空间未来专家中的语义未来分支,仅保留 VAE 预测,LIBERO-Plus 的成绩便从 72.8% 下滑至 65.1%;在真机变动环境下的成功率也从 61.5% 跌落至 41.0%。这表明单靠 VAE 的像素动态先验不足以抵抗视觉迁移带来的分布漂移,语义流对动作头起到了至关重要的状态矫正作用。
针对历史检索机制 CAIR 的消融更揭示了认知机制的深层规律:
-
朴素历史检索(Naive History Retrieval):不使用当前视听语言上下文做引导,仅用无锚点的可学习 Query 粗暴压缩 DINO 历史特征,性能直接骤降至 56.5%;
-
仅保留当前 VLM 语义(Qwen Current Only):不调取任何历史帧,即便有大模型的多模态理解,成功率也仅有 62.3%;
-
用 VAE 替换 DINO 进行检索(CAIR with VAE History):同样由当前帧引导,但检索对象换成 Wan-VAE 潜变量,表现仅为 64.7%。
这三组对照实验证明,不恰当的上下文检索甚至会成为模型的干扰源(其成绩均低于完全不使用历史信息的 66.4% 对照组)。唯有“当前视听语言锚点 + 高度稳定的 DINO 历史特征”协同作用,才能准确抽取出对控制有价值的真实意图。
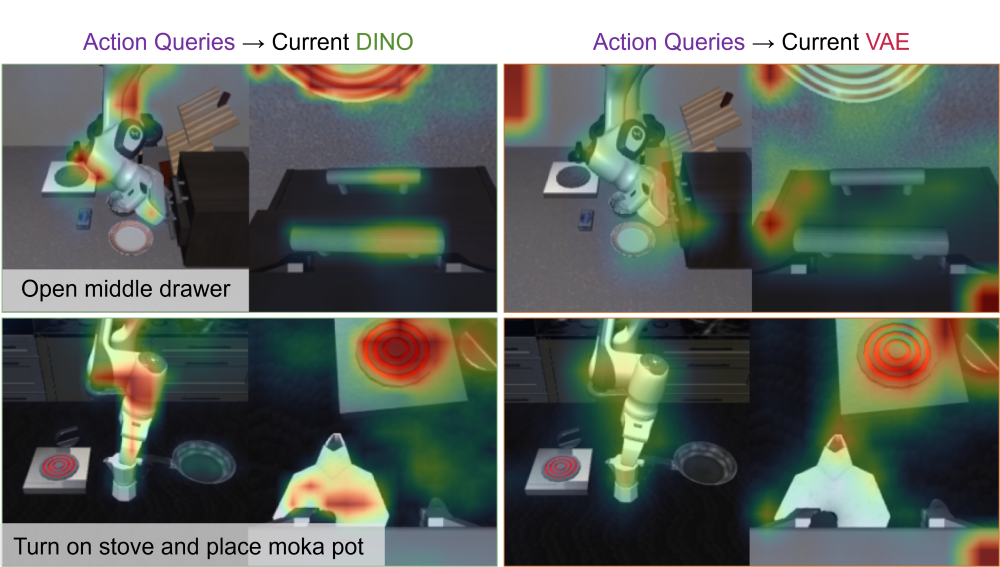
注意力热力图的可视化进一步从微观层面解释了这一机制:在 MoT 混合自注意力层中,动作 Query 对 DINO 特征的注意力显著聚集在被操作的特定目标及末端夹爪交互区,具备高度的空间聚焦性;而动作 Query 对 VAE 特征的注意力则较为弥散地分布在整个场景背景中。这不仅证实了两者分工的有效互补,也直观展现了语义特征是如何帮助机器人过滤视觉背景噪声的。
总结与展望
ST-WAM 的提出切中了当下具身世界动作模型的一个认知盲区:单纯追求像素级别的重构逼真度,并不等同于能够提供高质量的控制物理先验。相反,过度依赖像素生成往往会让模型在面临视觉扰动时陷入固守训练分布的幻觉困境。
通过将自监督视觉表征 DINOv3 同时用于前向语义演变预测和后向意图证据检索,ST-WAM 证明了在保持数百毫秒级别高效推理、且无需额外数万小时具身预训练的前提下,机器人完全可以学会在复杂变动的视觉环境中保持清醒的操作定力。未来,这种将高维语义与低级连续动力学解耦并协同建模的思路,有望从当前的视觉扰动场景,进一步推广至非均匀物理接触、机械动力学变化乃至不同构型机器人本体的跨域控制中。