别怪缓存!加速VLA闭环崩溃根源在门控:利用动作空闲期成功率重回0.98
The Gate, Not the Cache: Gate Provenance Bounds the Closed-Loop Reliability of Training-Free VLA Token Skipping
把大型视觉-语言-动作模型(Vision–Language–Action,简称 VLA)部署在机械臂上时,推理速度常常是横在具身智能落地面前的一道坎。以典型的 7B 参数模型 OpenVLA 为例,机械臂每走一小步,模型就要对输入的数百个视觉 Token 进行一次庞大的 Transformer 前向计算。为了降低端到端延迟,社区近期涌现了大量“训练免调优 Token 跳步”(Training-free Token Skipping)方案。这类方法的核心假设非常朴素:机器人相邻两帧摄像头画面里的静态背景和次要区域变化极小,完全可以通过门控机制跳过 70% 到 90% 的视觉 Token,要么复用上一帧的 KV 缓存,要么直接将其剪枝丢弃,从而在单步基准上宣称实现无损甚至几乎无损的加速。
ArXiv URL:https://arxiv.org/abs/2608.00391
然而,这套在静态评测中看似完美的加速方案,一旦被真正放到闭环控制(Closed-loop Control)系统里,往往会遭遇灾难性的静默崩溃。在一篇题为 The Gate, Not the Cache: Gate Provenance Bounds the Closed-Loop Reliability of Training-Free VLA Token Skipping 的论文中,研究者揭示了一个残酷的事实:在基准测试 LIBERO-Object 上,当 Token 跳步比例达到 0.9(即 10 个视觉 Token 中跳过 9 个)时,密集模型(Dense Serving)原本 100% 的成功率,在直接复用缓存时暴跌至 68%,在直接剪枝删除时更是崩塌至 31%。更可怕的是,这种崩溃在动作层面的监控指标上毫无征兆,单步动作偏差极小,常规的分布偏移检测器几乎全部失效。
这项研究最核心的洞察在于:导致闭环崩溃的罪魁祸首既不是“KV 缓存复用”也不是“Token 剪枝”这些具体的跳步机制,而是门控信号的来源(Gate Provenance)。 传统加速方案在每一步生成的门控信号来自上一步已经被稀疏化、被阉割过的前向传播(即自收割门控,Self-harvested Gate),这导致被跳过的区域在后续门控眼里彻底沦为“盲区”,误差在闭环环境与视觉输入的反馈链条中不断滚雪球。针对这一病灶,本文提出了一种极具工程巧思的解法——动作松弛期刷新(Actuation-Slack Refresh):利用机械臂执行动作块时 GPU 闲置的几百毫秒“物理死区”,在推理关键路径之外无条件执行一次完整的密集前向,给下一步递交一份“干净”的门控信号与基底缓存。在几乎不增加任何关键路径时延的前提下,这一方案在仿真和真实机械臂上将崩溃的成功率拉回 0.98,同时端到端服务延迟相比未加速的密集模型降低了 18% 至 22%。
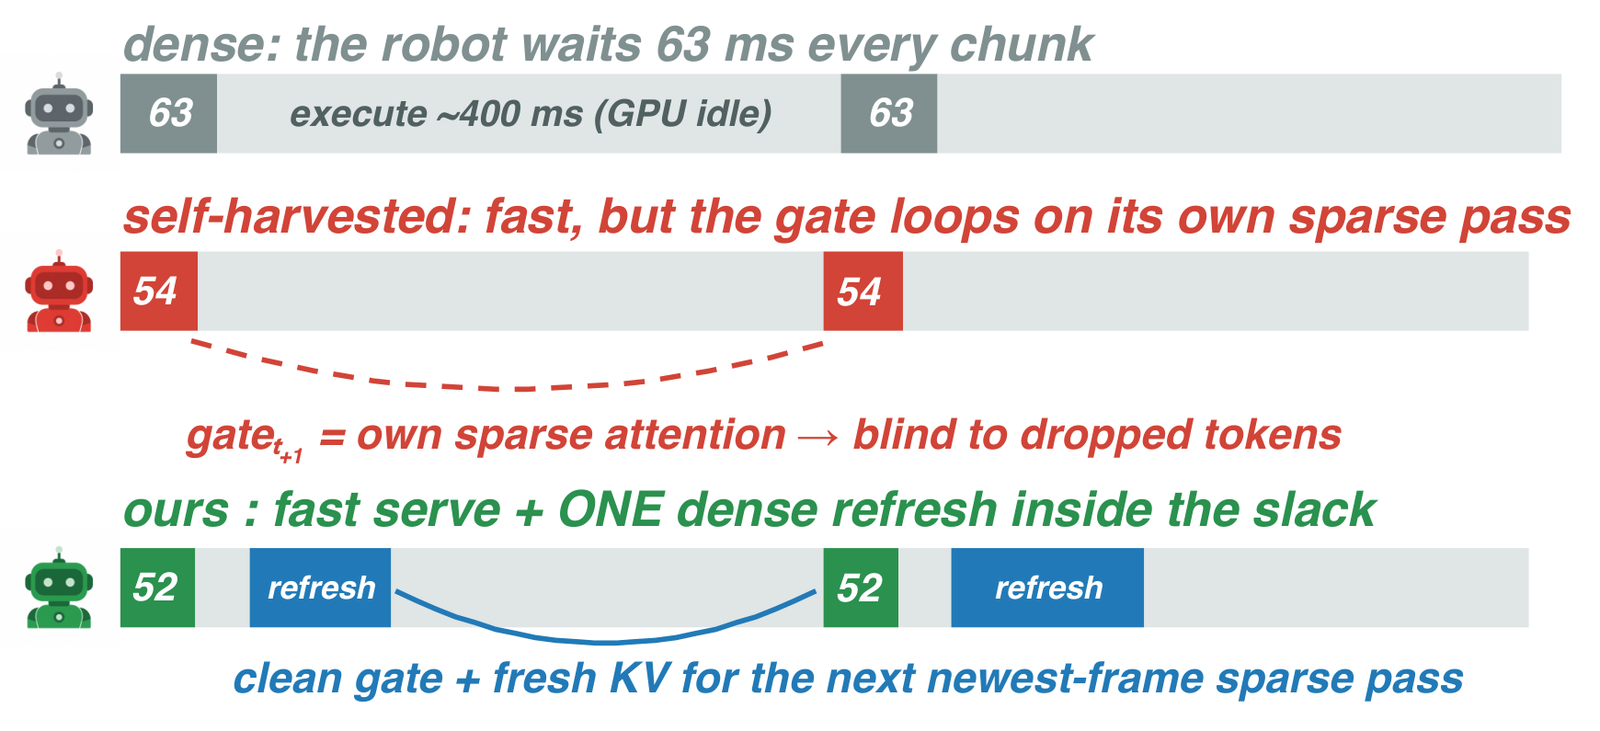
闭环控制下的致命循环:为什么加速模型总在静默崩溃?
要理解闭环加速为什么会失效,首先得看清具身控制与常规视觉语言模型在推理链条上的本质差异。在传统的长文本或视频推理中,模型的输出至多影响后续的上下文生成,属于相对开放的数据流。但具身 VLA 的核心在于“闭环”:模型吃进当前帧画面,输出一段动作块(Action Chunk);机械臂在物理世界执行这组动作;机械臂的位移和夹爪动作直接改变了摄像头视野;紧接着,改变后的视野又变成了模型下一步的输入。
在这个死循环中,加速方案通常依赖一个“门控”(Gate)。门控的作用是针对每个图像分块(Patch)打分,决定哪些 Token 值得重新计算,哪些可以直接从上一轮的 KV Cache 继承(Reuse 路线,如 VLA-Cache),或者干脆直接从输入序列中剔除(Deletion 路线,如 VLA-Pruner)。当跳步比设定为 0.9 时,模型前向传播中只剩下 10% 的视觉 Token。
问题就出在这里:下一轮的门控信号,究竟是从哪里计算出来的?
现有的大多数免训练加速方法,为了极致压缩延迟,直接在刚刚跑完的那次 10% 稀疏前向中顺带提取特征,作为下一帧决定跳过哪些 Token 的依据。论文将这种模式定义为“自收割门控”(Self-harvested Gate)。当这一过程在控制链条中连续迭代时,灾难降临了:
在第 $t$ 步被跳过的 Token,由于没有参与深层网络的完整表征更新,它们在特征空间中已经处于陈旧或缺失状态;
到了第 $t+1$ 步,门控算法基于这组残缺的表征来挑选重点,天然倾向于继续忽略这些原本就被跳过的区域;
如果机械臂在这个过程中恰好推开了一个物体,或者物体的局部姿态发生了微妙位移,这些发生剧变的区域恰好处于模型的视觉“盲区”内;
由于感知不到变化,模型输出错误的动作;错误的动作将机械臂推向更离谱的物理状态;下一帧的视野变化更加超出盲区的捕捉能力。
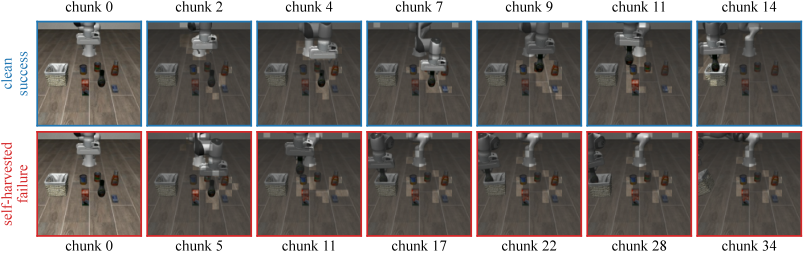
上图直观展现了这种“自我致盲”过程。在 0.9 的高跳步比下,上方的干净门控能够精准追踪任务关键区域(明亮高光块为重新计算的 Token,暗色块为丢弃的 Token),视觉注意力始终牢牢锁住夹爪与操作目标;而下方的自收割门控经过几轮迭代后,保留的 Token 支离破碎,甚至完全游离在操作目标之外。
更要命的是这种失败的隐蔽性。作者评测了多组动作层面的实时异常检测器,发现单步输出的动作数值偏移非常微弱,检测器的打分几乎等同于随机瞎猜。在任务最终失败之前,整个系统看起来都在“正常”运转,没有任何警告,直到机械臂彻底抓空或撞翻工作台。
析因实验:是缓存的锅,还是门控的罪?
长期以来,社区在讨论 Token 跳步加速的可靠性时,争议往往集中在“跳步机制”本身:有人认为 KV 复用会导致注意力偏差层层累加,有人则认为直接删除 Token 破坏了 Transformer 的全局空间完整性。为了彻底理清崩溃的根源,研究团队设计了一组严格受控的四格双因素析因实验(Factorial Design)。
实验固定在相同的 91 个初始评测状态(LIBERO-Object)上运行,并将跳步比例严格限制在 0.9。研究者将两个变量完全解耦:
-
跳步机制:分为“KV 缓存复用(Reuse)”和“Token 剪枝丢弃(Deletion)”;
-
门控信号来源(Provenance):分为来自上一步稀疏前向的“自收割门控”,以及来自独立运行且未跳过任何 Token 的密集前向的“干净门控(Clean Gate)”。
为了排除递归累积误差对复用机制的干扰,研究者在复用组中统一使用仅隔一步的基底缓存,控制变量后的对比结果极为震撼:
在自收割门控下,即便排除了长程缓存累积,复用模式的成功率依然只有 0.68,而剪枝模式更是跌穿至 0.31(基准密集模型为 1.00)。
然而,一旦将门控信号换成“干净门控”,哪怕依然跳过 90% 的视觉 Token,复用模式和剪枝模式的成功率全部奇迹般地复原到了 0.98 左右,几乎追平未跳步的密集模型。
更有说服力的对比在于:如果让系统保持完全累加的陈旧 KV 缓存基底,仅仅把门控信号换成干净门控,成功率就能从 0.43 暴增至 0.96;反过来,如果每一步都强行刷新整套 KV 缓存基底,但依然使用自收割门控,成功率仅仅从 0.43 勉强爬升到 0.68。
这组坚实的控制变量实验给出了决定性结论:决定闭环加速可靠性的上限并不是如何跳过 Token(复用还是剪枝),而是门控信号到底从何而来。 只要门控本身是清醒的,哪怕语言模型在深层只计算 10% 的 Token,它也能把注意力精准投射在最致命的交互点上;而一旦门控被上一步的稀疏表征致盲,底层缓存再新鲜,也无法阻止闭环控制走向崩溃。
破局之道:把密集计算藏进“动作松弛期”
既然干净的门控信号是维持闭环稳定性的生命线,那该如何获取它?如果为了生成干净门控而在每次推理时都跑一遍完整的密集前向,那 Token 跳步带来的加速收益岂不是荡然无存?
作者在具身系统的物理运行规律中找到了突破口:物理世界是有惯性的,机械臂的动作执行需要时间。
在典型的分块控制(Chunked Control)范式下,VLA 并不是每隔 10 毫秒生成一个瞬时控制量,而是一次性吐出未来一段时间的动作轨迹(Action Chunk,例如 8 到 16 个时间步的轨迹)。在 GPU 上,跑一次 7B 模型的密集前向大约耗时 63 毫秒,稀疏加速前向大约耗时 54 毫秒。然而,机械臂硬件在物理世界中执行完这组动作轨迹,往往需要 400 毫秒(仿真环境常用设定)乃至 800 毫秒(真实低频机械臂)。
这意味着,在传统的密集部署模式下,GPU 计算 63 毫秒之后,剩下的 300 多毫秒完全处于无所事事的挂起等待状态,这就是所谓的动作松弛期(Actuation Slack)。
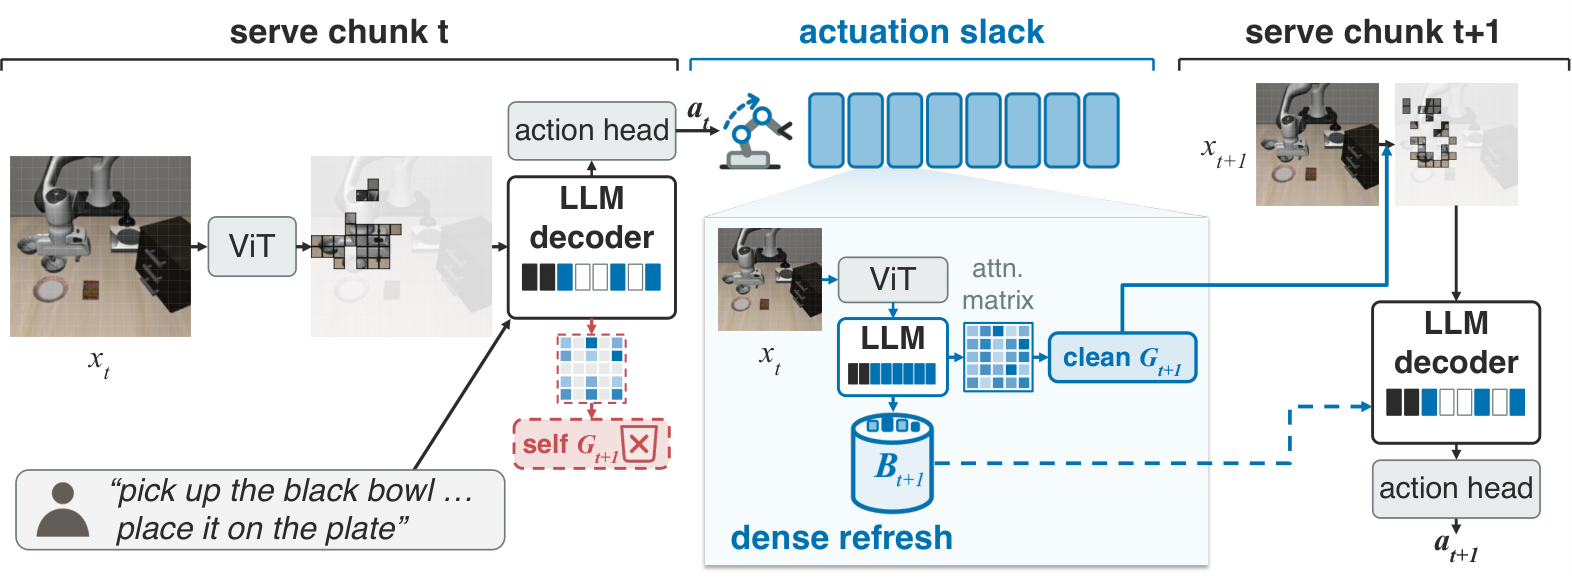
基于这一观察,本文提出了极其优雅的系统流水线——Actuation-Slack Refresh(动作松弛期刷新)。如上图所示,整个控制循环被拆解为两个阶段:
-
关键路径(Critical Path,在线服务):当新的控制步到达时,模型利用上一步准备好的干净门控和新鲜基底,执行极速的稀疏前向(Sparse Serve),仅花费约 50 毫秒就计算出动作块并立刻下发给机器人控制器。机械臂收到指令后,立即启动物理执行。
-
非关键路径(Off Critical Path,后台刷新):机械臂一旦开始动起来,GPU 就不再等待。它立刻在后台对同一帧图像执行一次完整的密集前向计算(Dense Refresh)。这次密集计算的目的绝不是为了生成动作(其输出动作直接丢弃),而是为了纯粹的“状态洗白”:它在完整的 Token 集合上提取准确的视觉表征,生成下一轮决策所必需的干净门控信号 $G_{t+1}$,并为 KV 复用机制准备好未经污染的基底张量 $B_{t+1}$。
由于后台密集前向的耗时(60~120 毫秒)远远小于机械臂物理运动的窗口期(400~800 毫秒),它完全能够神不知鬼不觉地在机械臂执行完毕前收工。当机械臂跑完动作、准备接收下一批轨迹时,GPU 已经备齐了一份毫无瑕疵的干净门控。这种设计巧妙地将“密集的计算量”留在了后台,而将“稀疏的极速响应”留给了关键路径。
为什么必须无条件刷新?动态触发器的幻觉
看到这里,很多系统工程师的第一反应可能是:每一轮动作都跑一次后台密集前向,算力消耗是不是有点浪费?能不能设计一个“监控触发器”(Trigger),平时只跑纯稀疏,只有当检测到画面发生剧烈变化或特征发生偏移时,再触发后台刷新?
这正是现有前沿方法 SAFE-Pruner 所采取的路线。SAFE-Pruner 维护了一个一致性评分 $\kappa_t$(预测显著性与观测显著性之间的余弦相似度),当该指标跌破阈值时才激活刷新。
然而,论文对这种“按需触发”的设想泼了一盆冷水:动态触发器本身也是基于稀疏前向的特征去计算的,它同样逃不过自收割致盲的宿命。
实验给出了极为讽刺的数据:在 LIBERO-Object 任务的 3222 次编码测试中,系统的成功率已经一路暴跌到了 0.19(对比密集模型的 1.00),但 SAFE-Pruner 设定的动态触发器整整全程只触发了区区 3 次!
原因在于,门控失效的致命偏移恰恰隐藏在那些被剪掉的 Token 之中。既然被监控的特征本身就已经残缺不全,余弦相似度在幸存的 Token 上计算出来依然高达 0.98 到 0.99,触发器误以为天下太平,完全意识不到盲区里正在酝酿系统崩溃。
研究人员进一步进行了详尽的阈值扫描实验。如果强行把触发阈值调得极高(例如 0.995)来逼迫系统多刷新,触发器在 90.4% 的步数里都会报警,成功率虽然回到了 1.00,但由于频繁在主路径上抢占计算资源,端到端延迟直接飙升到了密集模型的两倍以上;而如果调低阈值,无论怎么选,都无法在兼顾稀疏低延迟的同时达到密集模型的成功率。
结论非常明确:在缺乏外部先验的情况下,依赖自收割信号构建的触发器是不可靠的。既然机械臂物理执行提供了充裕的几百毫秒无风险空闲时间,无条件(Unconditional)在每一个动作块的松弛期执行一次密集刷新,不仅从逻辑上斩断了错误积累的根源,更在工程上提供了一种确定性的低时延保障。
严苛评测:横扫双模型、八大多样化基准
为了验证该机制的普适性,研究团队不仅在 OpenVLA-OFT 上进行了全量测试,还将方案移植到了基于扩散 Transformer(Diffusion Policy)动作头的 CogACT 模型上;测试场景覆盖了 LIBERO 体系下的 4 个套件(Spatial、Object、Goal、Long),以及 SIMPLER 仿真平台中的 4 个复杂真实感任务(涵盖夹取可乐罐、移动目标、开抽屉等)。
同时,研究者将动作松弛期刷新方案直接集成到了当前最顶级的两种开源跳步框架中:基于 KV 复用的 VLA-Cache 和基于 Token 剪枝的 VLA-Pruner。
在极其严苛的 0.9 高跳步比测试下,实验呈现出高度一致的规律:
在没有刷新机制介入时,原生的 VLA-Cache 和 VLA-Pruner 在长任务和复杂物体交互中全面亮起红灯。特别是在需要细粒度视觉反馈的 Object 和 Long 套件中,任务成功率大幅滑坡。
而一旦挂载了动作松弛期刷新(+Refresh),所有因自收割门控诱发的静默崩溃全部被完美修复。VLA-Cache 在各个任务上的表现被全线拉升,原本跌至 0.6 甚至更低的成功率全部重回 0.95~0.98 的顶级水准,几乎抹平了跳步加速与全量密集推理之间的性能鸿沟。
除了极限性能修复,研究人员还对比了 VLA-Cache 原生携带的“浅层重计算”(Shallow Recompute)策略。原生 VLA-Cache 为了缓解误差,选择在每一帧强制重算第 0 和第 1 层的全部 Token,深层再走复用。但数据表明,这种在网络入口处的“修修补补”根本无法替代真正的全层密集刷新:在 LIBERO-Object 上,浅层重算只能把成功率从 0.66 抬回 0.81,而动作松弛期刷新则一举跃升到了 0.96。
在真实物理机械臂(AgileX Piper 协作臂搭载 Intel RealSense 双相机)的落地部署中,系统的优势得到了进一步确证。真实硬件运行在 10Hz 控制频率下,每个动作块包含 8 个动作,物理执行窗口扩展到了足足 800 毫秒,为后台刷新留出了极具冗余的安全边际。在 RTX 5880 Ada GPU 上实测显示,密集推理的单步关键路径延迟为 125.6 毫秒,而挂载刷新机制后的稀疏推理仅仅耗时 98.1 毫秒,服务延迟净降 21.9%,且无一次超时掉帧。
具身智能推理优化的范式转变
这项研究的价值,不仅在于提出了一套即插即用的无损加速方案,更在于它给具身智能与大模型推理优化敲响了一记警钟:静态视角下的优化直觉,在闭环动力学系统中往往是行不通的。
在传统深度学习优化思维里,模型是一个孤立的黑盒函数,评测一个剪枝或量化方案好不好,通常只看单样本的误差变化(Per-step Action Error)或离线轨迹的回放精度。但具身智能的精髓恰恰在于“感知-决策-行动-环境反馈”的实时闭环。在这个闭环中,微小的表征退化会通过机械臂的实际位移演变成环境状态的不可逆剧变;而模型内部被阉割的注意力门控,又恰好剥夺了系统感知这一剧变的能力。
这项工作给出了两个关键的行业启示:
-
区分计算路径与信令路径(Signaling Path):在设计模型压缩与跳步算法时,千万不要把决定“跳过什么”的控制信号,完全托付给已经被跳过的信息流。门控不仅是一个开关,它本身就是一种特殊的感知。保持门控信令的纯粹与干净,比底层网络如何偷懒算力要重要得多。
-
充分榨取物理系统的具身特性:与数据中心里追求吞吐量的纯文本 LLM 服务不同,具身 AI 始终受制于现实物理世界的运动节律。机械臂从点 A 移动到点 B 无论如何都需要数百毫秒,盲目追求毫秒级的极限算力节约而牺牲鲁棒性毫无意义。像本文这样将昂贵的校验计算“隐写”进机械臂的动作松弛期,利用物理时间掩盖计算时延,才是具身智能推理架构走向成熟的标志。
天下没有免费的午餐。该方案的代价在于,由于后台周期性追加了一次完整的密集计算,GPU 的总能耗上升了约 18%,整体浮点运算量(FLOPs)达到了原本密集推理的 1.6 倍。但在高可靠性压倒一切的工业与商业服务场景中,用一点点能耗的边际成本,换取高达 20% 的硬时延缩减与 100% 级别的控制成功率,这笔账无论怎么算都极其划算。在具身大模型加速这条道阻且长的路上,“看清大门(Gate),而不是纠结缓存(Cache)”,或许正是整个领域必须补上的关键一课。