ACE-Data-0:把家变成多模态影棚,1700万帧全感官数据打通具身长程交互
ACE-Data-0: Human-Centric Ambient Capture as Embodied Data Engine
大语言模型与多模态视觉模型之所以能在过去数年势如破竹,很大程度上归功于它们继承了人类在互联网上积累数十年的浩瀚文本与图像资产。然而,具身智能(Embodied Intelligence)的探索者们刚一踏入真实物理世界,就迎头撞上一堵坚不可摧的“数据之墙”:人类最基本、最娴熟的物理技能从来不曾被白纸黑字地记录下来。我们在厨房里如何自然地调整手指抓握力度去拿起一只湿滑的玻璃杯,在端着满溢的热水穿越走廊时如何配合脚步维持身体平衡,在遭遇抽屉卡顿时如何下意识地卸力并换个角度拉扯——这些身体内化的物理常识,从未以结构化数据的形式存在于任何服务器中。
ArXiv URL:https://arxiv.org/abs/2607.28625
要让机器人学会像人一样在现实环境中生活与劳作,数据不能靠“捡”,必须靠“造”。以往的具身感知数据大多呈现出严重的撕裂状态:大规模第一人称视频(如 Ego4D 系列)虽然捕捉了丰富的生活化场景,却缺失人体运动学、物体绝对位姿与触觉等底层物理真值;高精度的动作捕捉数据集(如 GRAB、ARCTIC 等)虽然拥有毫米级的骨骼与物体轨迹,却往往被禁锢在空旷无物的洁净实验室里,记录着几秒钟的离散机械动作,既缺少主观视角的观察,也剥离了日常家居中的视线遮挡与杂乱感。
针对全维度物理交互数据的长期匮乏,最新提出的环境感知数据采集引擎 ACE(Ambient Capture Engine)及其衍生的大规模数据集 ACE-Data-0 尝试给出一套系统性的破局方案。该研究将真实生活的起居室、厨房等居住空间改造成完全空间标定、毫秒级时间同步的“多模态数据影棚”,并在此基础上构建起包含 150 小时、1700 万帧视频、50 位受试者以及 75,000 个交互片段的具身数据基底。通过在真实家居场景中同步捕获全向第一视角、多视角第三视角、全身动捕、指尖灵巧运动、物体 6-DoF 轨迹、空间音频与全掌触觉,这项工作为具身模型提供了一条从低层物理接触跨越至长程任务规划的完整监督链路。
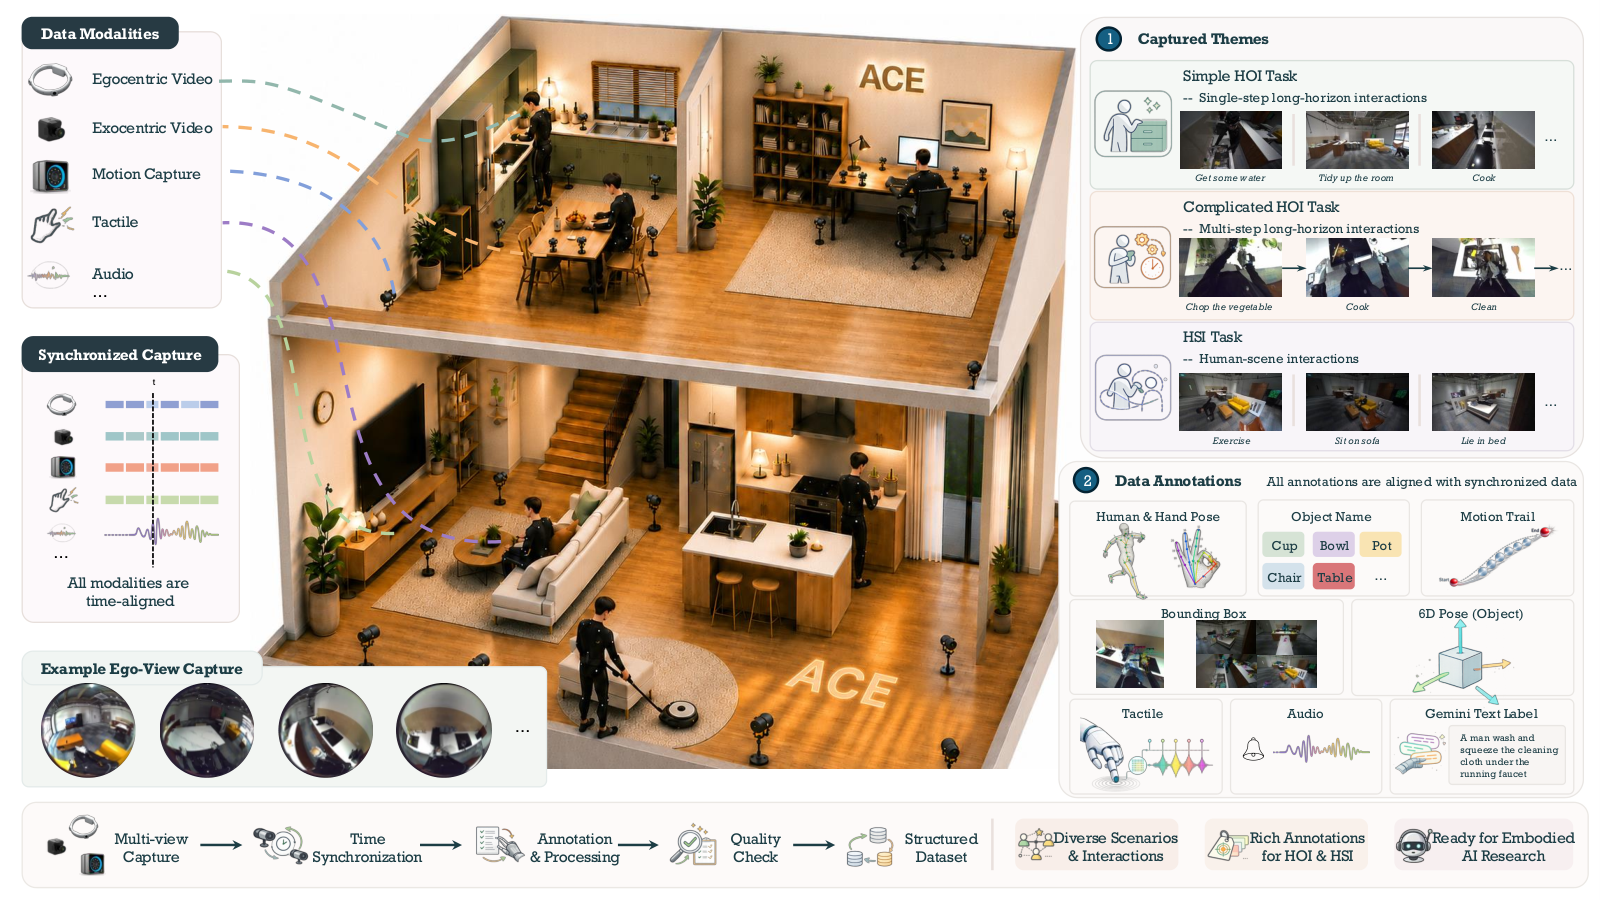
双尺度引擎:化解局部微操作与大范围移动的感知冲突
在构建具身智能采集系统时,研究人员历来面临一个两难的工程折中:为了看清并测准手指捏合、工具使用等毫米级的精细接触,传感器必须靠得足够近、密度足够大;但要理解机器人在整个居室中的导航巡检、跨房间搬运等宏观行为,又需要传感器具备超大视场角与远距离覆盖能力。以往的研究大多退守其中一端,导致模型要么只会“坐在桌子前摆弄积木”,要么“在房间里走动却看不清双手”。
ACE 的破局思路在于承认这种物理尺度的天然分歧,并将系统解耦为两种互补的空间配置:桌面级(table-scale) 与 房间级(room-scale)。
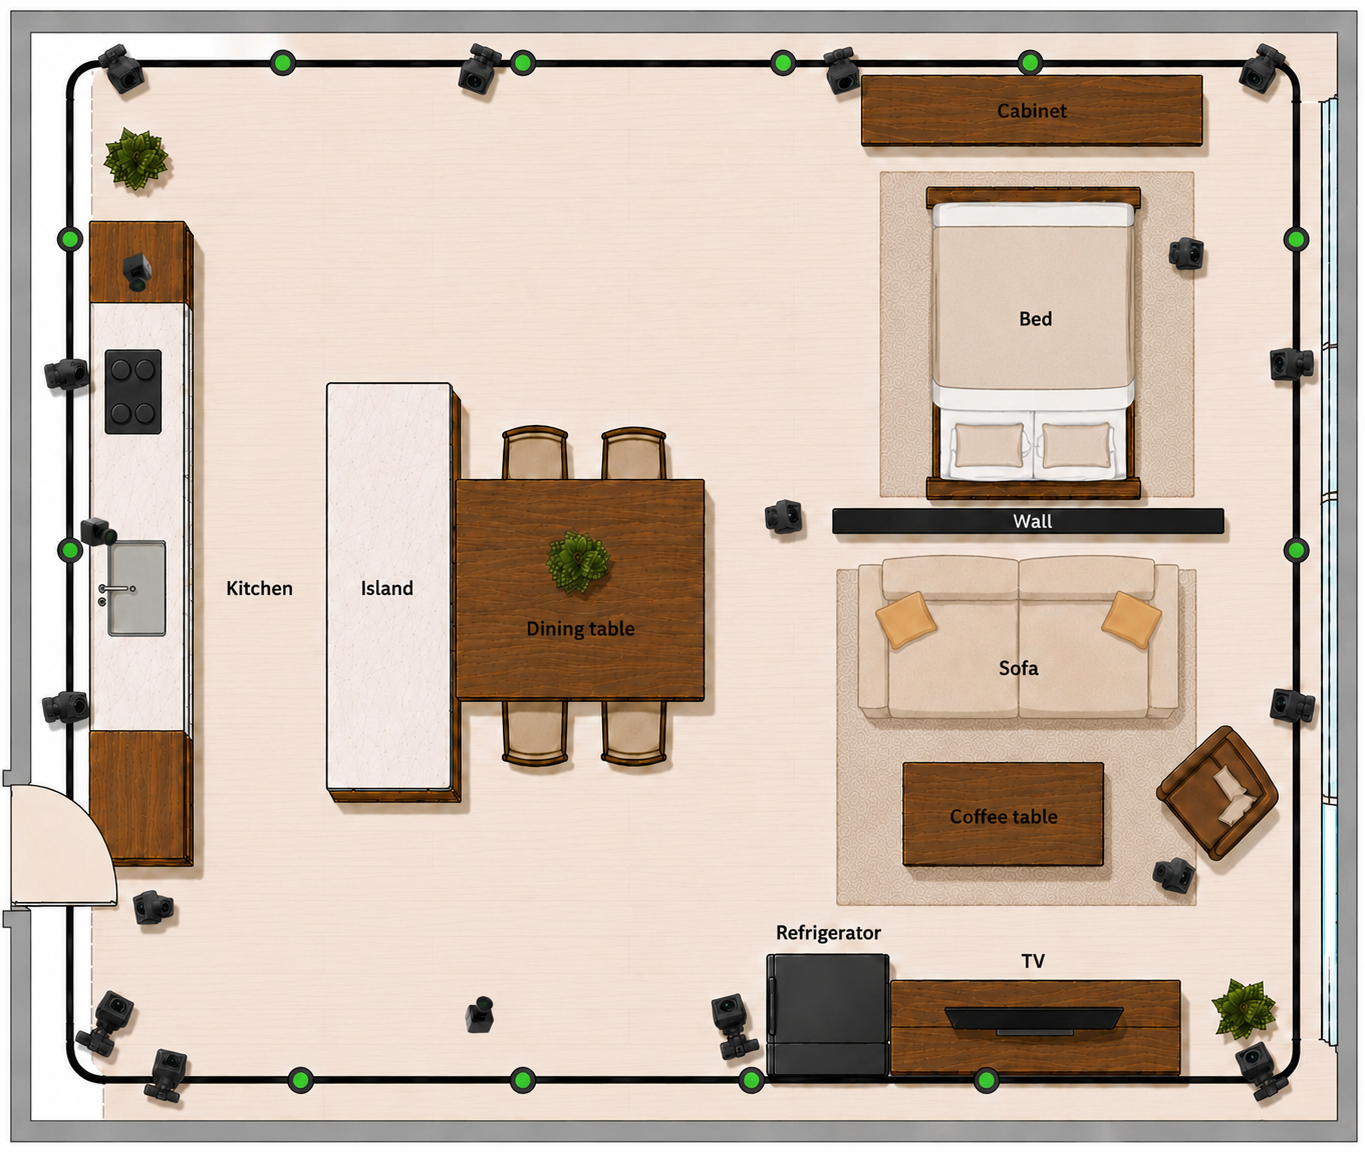
桌面级系统聚焦于 30 平方米的工作台区域,配备了 25 种以上涵盖刀具、碗碟、食品容器的常用器皿。为了捕捉微操作的极限细节,系统在工作台周围 0.3 至 0.5 米的极近距离固定了 8 台同步 RGB 高清相机,配合上方桁架上的 16 台 OptiTrack 高速红外动捕相机,建立起亚毫米级有效分辨率的近景空间。与此同时,受试者佩戴高密度触觉手套,将每一次抓取时的受力面积、指尖压力分布同步记录下来。
与此互补的房间级系统则直接铺设于一间约 200 平方米的真实住宅公寓内。该公寓保留了完整的厨房岛台、餐厅、客厅及卧室布局,绝不人为剔除家具杂物和天然遮挡。研究团队在公寓天花板下方架设了贯穿全屋的轻型悬吊桁架,均匀布置了 8 台带可调节伸缩杆的广角 RGB 相机和 12 台红外动捕相机。其高度和俯仰角度经过反复验算,确保房间内任何核心交互热点即便在家具阻隔下,也能同时被至少 4 个不同角度的第三人称视角覆盖,且整套公寓被完整纳入同一个光学跟踪坐标系中。
通过这种桌面局部与全屋空间的无缝拼板,ACE 既没有为了“可测”而牺牲家庭生活场景的原生混乱度,也没有为了“自然”而放弃严谨的度量级真值标定。
严苛的时空共振:六类模态如何拧成一股绳
许多号称多模态的具身数据集,在实际训练机器人策略时往往让研究者大失所望,其根源通常在于看似微小的时空错位。如果时间不同步,视频里手掌触碰到水杯的画面可能比触觉手套记录到受力峰值滞后数个采样周期;如果空间未注册,从第一人称视角估算的手部 3D 轨迹就无法直接映射到全局环境坐标系中。对物理交互而言,数毫秒的漂移就足以让因果推理崩塌。
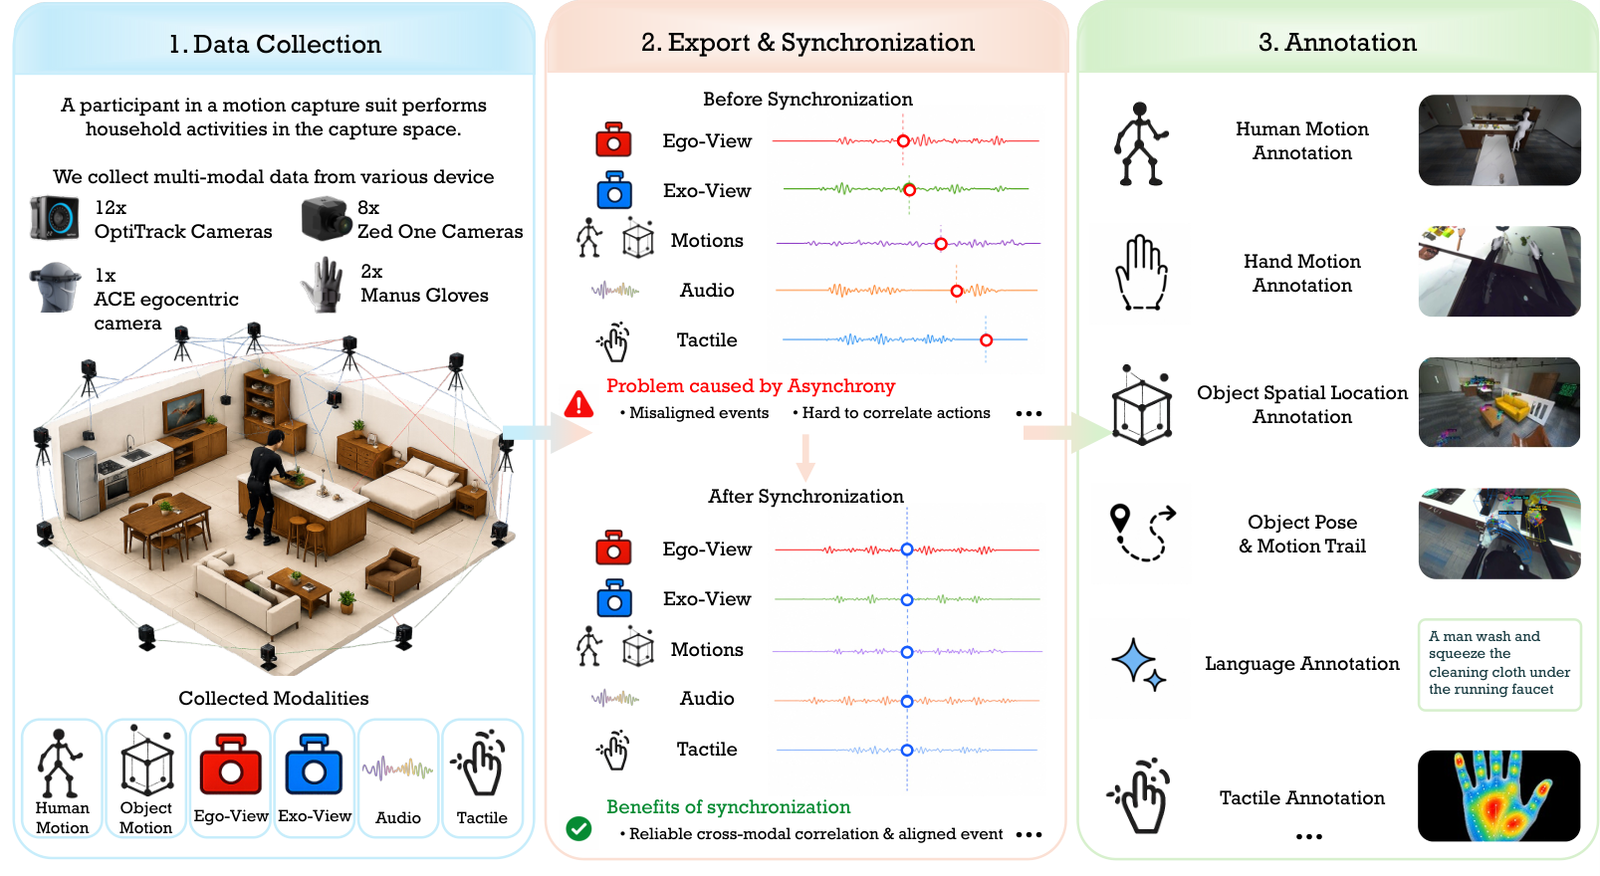
ACE 将时空一致性视作整个数据引擎的生命线。在硬件层面,系统统一以 OptiTrack 动捕主控时钟发出的 60 Hz 脉冲作为最高时序基准。房间级的广角相机集群通过 GMSL2 接口挂载在专用的边缘计算工作站上,依靠底层的硬件帧触发信号实现原生硬同步;外围的音频设备与手戴式触觉阵列则在软件链路中通过统一的网络时钟守护进程进行毫秒级时间戳校准。
第一人称视角的捕获同样充满工程巧思。参与者头戴自研的轻量化全向采集头显(搭载 4 颗鱼眼相机,以 20 FPS 记录前左、前右、后左、后右全景画面),其外壳上固联了 5 枚微型红外反光标记点。这一设计使得头显自身在全屋坐标系中的 6-DoF 运动轨迹被外围动捕系统持续解算。受试者看向哪里、头部如何晃动,都能在同一空间坐标下被精准反推。
在被操作物体的一侧,研究团队预先对涉及的各类日用品进行了高精度 3D 几何扫描与三维高斯泼溅(3D Gaussian Splatting)建模,并为每个物体绑定专属的反光标记群。系统运行期间,物体的空间位姿、受试者身上 41 处全身骨骼节点、指关节的精细屈伸、全掌触觉阵列压力、多路麦克风采集的碰撞杂音,全部实时投射并锁定在同一个物理时钟与三维坐标系下。
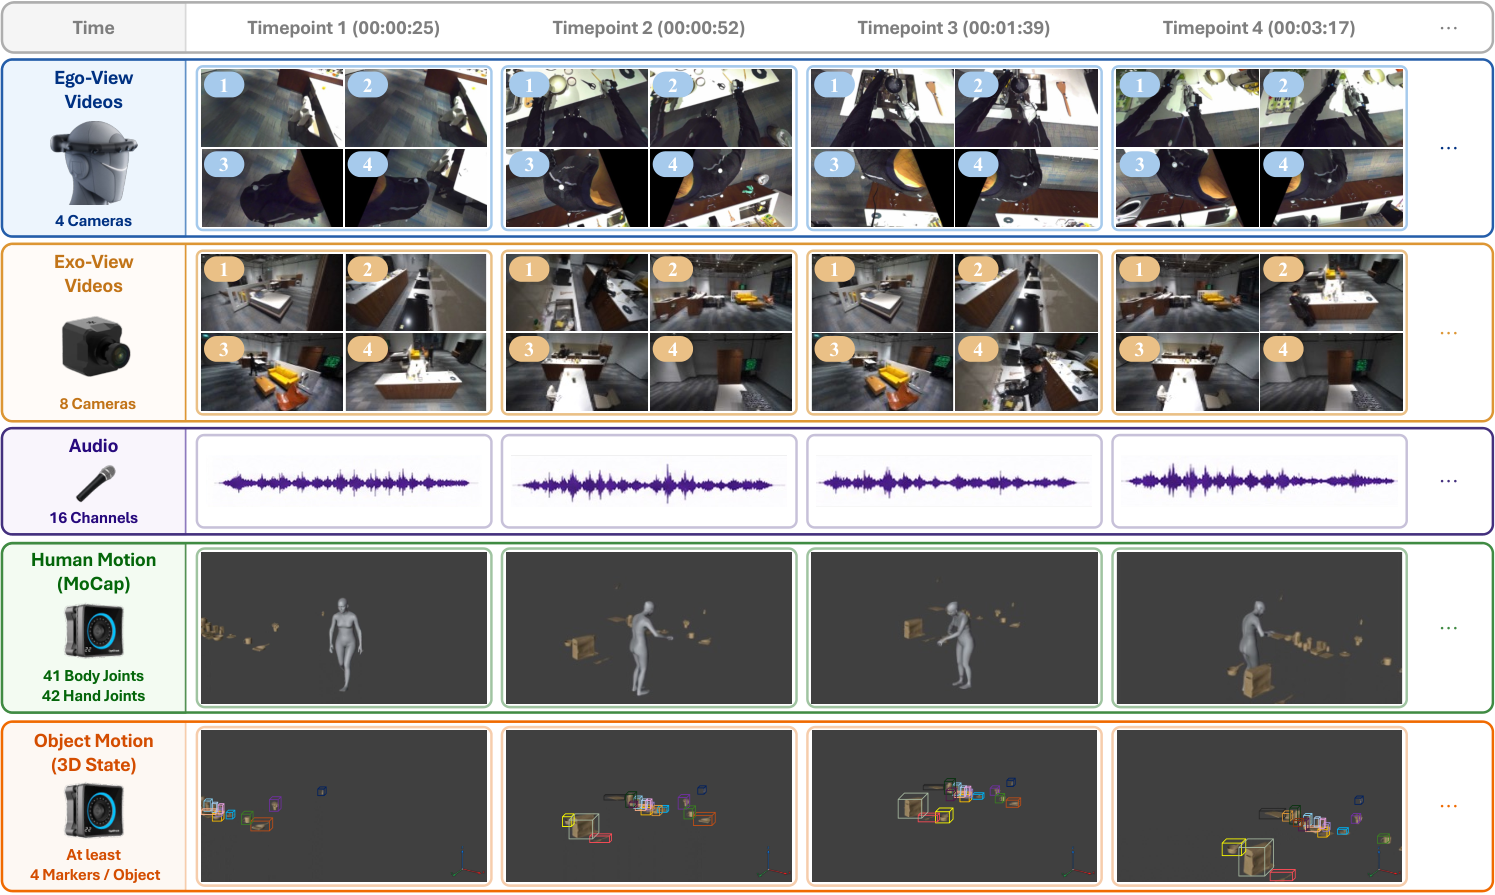
这种极致对齐带来的红利不仅体现在数据质量上,更大幅解放了后期的数据标注成本。诸如 2D 骨骼重投影、物体外接 3D 包围盒、第一视角遮挡掩码等大量耗费人工的标签,都能直接通过空间几何变换自动、高精度地投射生成,摆脱了以往利用启发式视觉算法进行伪标签估计时的累积误差。
告别刻板脚本:保留长程生活行为的随机与迟疑
训练通用具身大模型所面临的另一个深层挑战是行为的多样性。过去许多研究为了方便动作切分与姿态捕获,往往给受试者下达极其僵化的“原子级指令”,例如“迈步走到桌前、右手向前平伸、握住杯把、抬起 10 厘米”。由此记录下来的行为不仅轨迹机械,更剥离了人类行为中最有价值的长程因果结构。
真实世界的家务活动是目标导向(goal-directed)而非指令导向的。人在煮咖啡、打扫客厅或准备简餐时,任务链条往往跨越数分钟乃至数十分钟。在此过程中,人们会不断规划子任务,中途可能会因为找不到工具而停顿,会因为手滑而临时调整姿态,会在不同房间之间往返拿取物品。
在 ACE-Data-0 的采集过程中,受试者接收到的全部是宏观目标级(goal-level)指令,例如“将餐桌清理干净并摆放两人份餐具”或“准备一壶柠檬水”。受试者被明确告知以自己平时的生活习惯行事,允许犹豫、试错、打翻后清理以及自主规划路径。
数据统计表明,ACE-Data-0 涵盖的 200 个日常任务类型中,绝大多数呈现出高度交织的多物体、长时序特征。75,000 个交互片段并非孤立割裂的动作切片,而是串联在连续的目标链条之中。这使得 ACE-Data-0 成为目前少数能够同时支撑宏观任务规划(Task and Motion Planning)与微观反应式控制(Reactive Control)的具身交互数据集。
三层基准测试:前沿感知算法在真实物理面前的断层
为了验证这套数据集的成色,并全面摸清当前机器人在物理交互理解上的实际水位,研究团队依托 ACE-Data-0 搭建了一套分层评测基准。该基准摒弃了单一维度的打榜思路,由低至高分为三个阶梯,精确映射了具身智能体感知物理世界所必须串联起的核心能力:
-
信号层(Signals):考察基于视觉外观推断指尖物理受力的跨模态泛化能力。
-
组件层(Components):考察在长程交互、复杂运动中对人体自身骨骼与双手姿态的恢复精度。
-
交互层(Interactions):在第一人称与第三人称视角下,同时评估人-物接触瞬间的手部运动重建与接触状态判定。
利用该基准对当前 30 余种前沿算法(涵盖单目姿态估计、手眼协同网络、视频物理推理模型等)进行广泛压测后,评估结果揭示了现有模型在真实居家环境下的多重系统性失效。
在基础的人体姿态估计方面,主流模型在标准评测集上的漂亮指标在 ACE-Data-0 面前遭遇滑铁卢。当受试者弯腰打开厨柜底层,或者在搬运大件杂物穿过走廊时,严重的自遮挡与物体遮挡导致现有模型的 3D 关节位置误差急剧放大。
在微观交互层面,双手与物体的接触瞬间更是现有视觉算法的“灾难区”。大多数视觉重建模型倾向于输出平滑但虚假的无干涉姿态,当真实指尖因施加压力而发生肉眼可见的软组织形变时,纯视觉算法既无法感知接触力的大小,也难以在严重的视线遮挡下维持手部关节的拓扑稳定性。
尤其值得注意的是第一人称视角与第三人称视角的表现分化。在纯自感知视角下,虽然摄像头能够极近距离观察手指与操作对象的相对几何,但高频且不可预测的头部运动(egomotion)带来了严重的运动模糊与视场剧烈抖动,使得习惯了平稳视角的模型在追踪手部运动时频繁丢失目标。
这些严苛的评测结果充分证实,学术界此前在洁净实验室和离散短序列上刷出的高分模型,距离在混乱多变的真实家庭中实现稳健感知仍存在巨大鸿沟。
从静态感知走向世界模型与通用机器人策略
从具身 AI 的技术演进轨迹来看,ACE-Data-0 的落脚点绝不仅仅是提供一个难度更高、更难刷分的 Benchmark,它的核心价值在于为具身大模型与世界模型(World Models)的训练提供高物理保真度的动力学基底。
当前以 RT-2、OpenVLA 为代表的视觉-语言-动作(Vision-Language-Action, VLA)模型,受限于训练数据大多来自特定机械臂在有限工位上的遥操作录像,泛化能力始终受困于本体构型与场景多样性。而人类在日常生活中展示出的多模态轨迹,恰恰蕴含了应对复杂接触与长程规划的最高阶先验。ACE-Data-0 中严格对齐的第一视角、多视场上下文、精确手部运动学与接触力分布,为大规模跨本体模仿学习(Cross-embodiment Imitation Learning)架起了一座高质量的跨模态桥梁。
与此同时,近期蓬勃发展的具身世界模型高度依赖能够精确预测动作后效的连续数据。要让世界模型学会“推翻杯子水会洒出来”、“抽屉推到尽头会受阻反弹”等物理直觉,就必须在训练中输入动作执行与物体状态演化在毫秒级上高度咬合的连续序列。ACE 系统采集的 6-DoF 物体位姿演进与音视频反馈,正是训练此类生成式动力学模拟器的理想土壤。
具身智能的竞赛正在从纯粹的算法结构创新,快速转向高维度物理交互数据的工程化突破。ACE-Data-0 的落地表明,把人类日常生活的真实居住空间转化为可度量、可计算的多模态感知场,或许正是填补数字世界与物理世界之间具身数据断层的关键一步。