快手A/B Agent:分层经验树闭环调优,实测线上GMV提升4.829%
A/B Agent: A Self-Evolving Agent for Strategy Iteration in Industrial A/B Testing
在工业级推荐系统和电商业务中,算法团队最日常也最耗费精力的工作,莫过于在错综复杂的 A/B 测试平台里“盯盘调参”。推荐系统从来不是只追求单一点击率或成交额的简单模型,而是一个由粗排、精排、重排与混排构成的庞大流水线。当工程师尝试调整某个业务场景的分流策略或排序权重时,常常陷入按下葫芦浮起瓢的困境:成交总额(GMV)上去了,用户人均停留时长却发生崩塌;短视频点击率被拉满,生态大盘的直播引流指标却一路飘红。
ArXiv URL:https://arxiv.org/abs/2608.04625v1
传统工业界应对这一难题,几乎完全依赖算法专家的个人经验。面对互相关联甚至存在冲突的多维度核心指标与护栏指标(Guardrail Metrics),工程师往往需要花费数小时比对日志、排查显著性,并在数十个超参数中盲猜下一轮配置。快手联合西南交通大学、香港理工大学与电子科技大学的研究团队,给出了一个极具工程实战价值的解法:推出业内首个面向工业级推荐策略迭代的自演化智能体系统——A/B Agent。
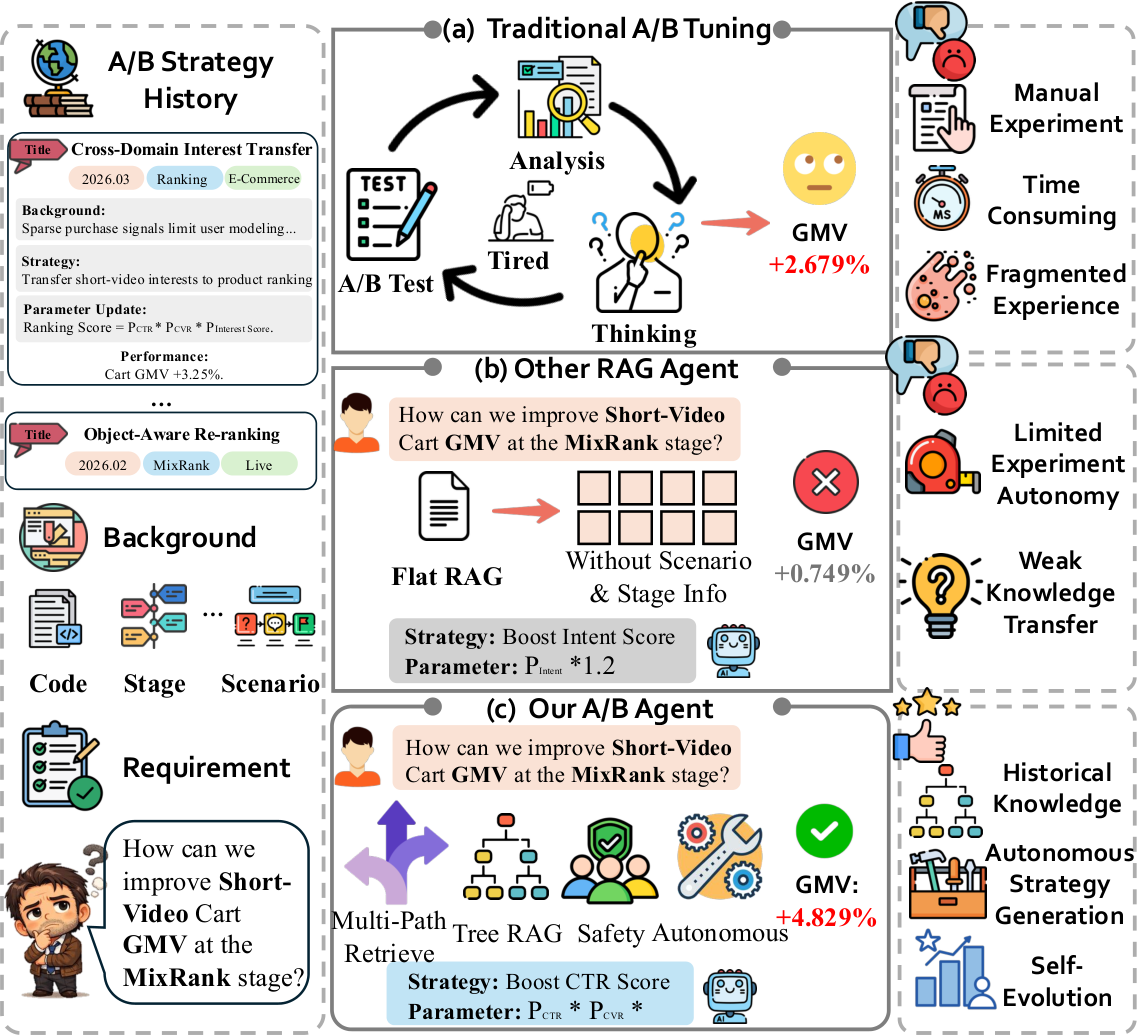
该方案彻底改变了传统推荐调优过度依赖人工试错的模式。在快手真实的短视频电商推荐场景上线运行后,A/B Agent 在经过五轮自治闭环演化后,不仅实现了购物车 GMV 提升 4.829%、千次曝光成交额(GPM)提升 4.677% 的显著业务增益,而且使所有受监控的护栏指标全部翻正,最终战胜了有着丰富一线经验的算法专家方案。
为什么常规 RAG 智能体无法解决 A/B 调优?
在大语言模型与检索增强生成(RAG)技术爆发后,许多团队曾尝试用大模型充当“策略助手”,把历史上的 A/B 测试报告切块存入向量数据库,让智能体检索相似实验来给出建议。然而,这类“扁平化 RAG”(Flat RAG)方案在真实业务中屡屡折戟。
根本原因在于,工业推荐系统的经验具有极强的场景纵深与上下文强依赖。一段历史记录里记录的“提升相关性惩罚因子带来时长增长”,脱离了其所在的特定流量域、特定推荐阶段(例如是重排层还是精排层)以及特定的基线流量分布,往往毫无参考价值,甚至会变成灾难性的误导。纯粹基于文本语义向量相似度的扁平检索,根本无法感知工业系统的垂直层级:它可能因为文本措辞相似,把一个适用于双列信息流精排阶段的冷启动策略,生硬推荐给单列沉浸式视频流的混排规则;也无法区分在不同业务约束下,某些超参数可探索的安全边界。
此外,现有的大模型策略系统大多停留在“单次提问-单次回复”的开环状态。真实的工业推荐迭代是一个长程实验反馈闭环:第一版策略上线后,如果核心指标上涨但护栏指标下跌,算法系统下一步必须能够准确归因、理解指标波动的统计置信度,并在受限空间内自主决策是该微调参数,还是应当推倒当前机制重新换路探索。现有的扁平 RAG 智能体既没有组织结构化业务经验的骨架,也没有围绕 A/B 反馈持续进化的闭环驱动机制。
分层经验树:让零散实验变成可迁移的“结构化知识”
A/B Agent 的首要突破,在于打破了以往将 A/B 测试报告作为独立文档进行索引的粗暴做法,构建了一套分层策略经验树(Hierarchical Strategy Experience Tree)。
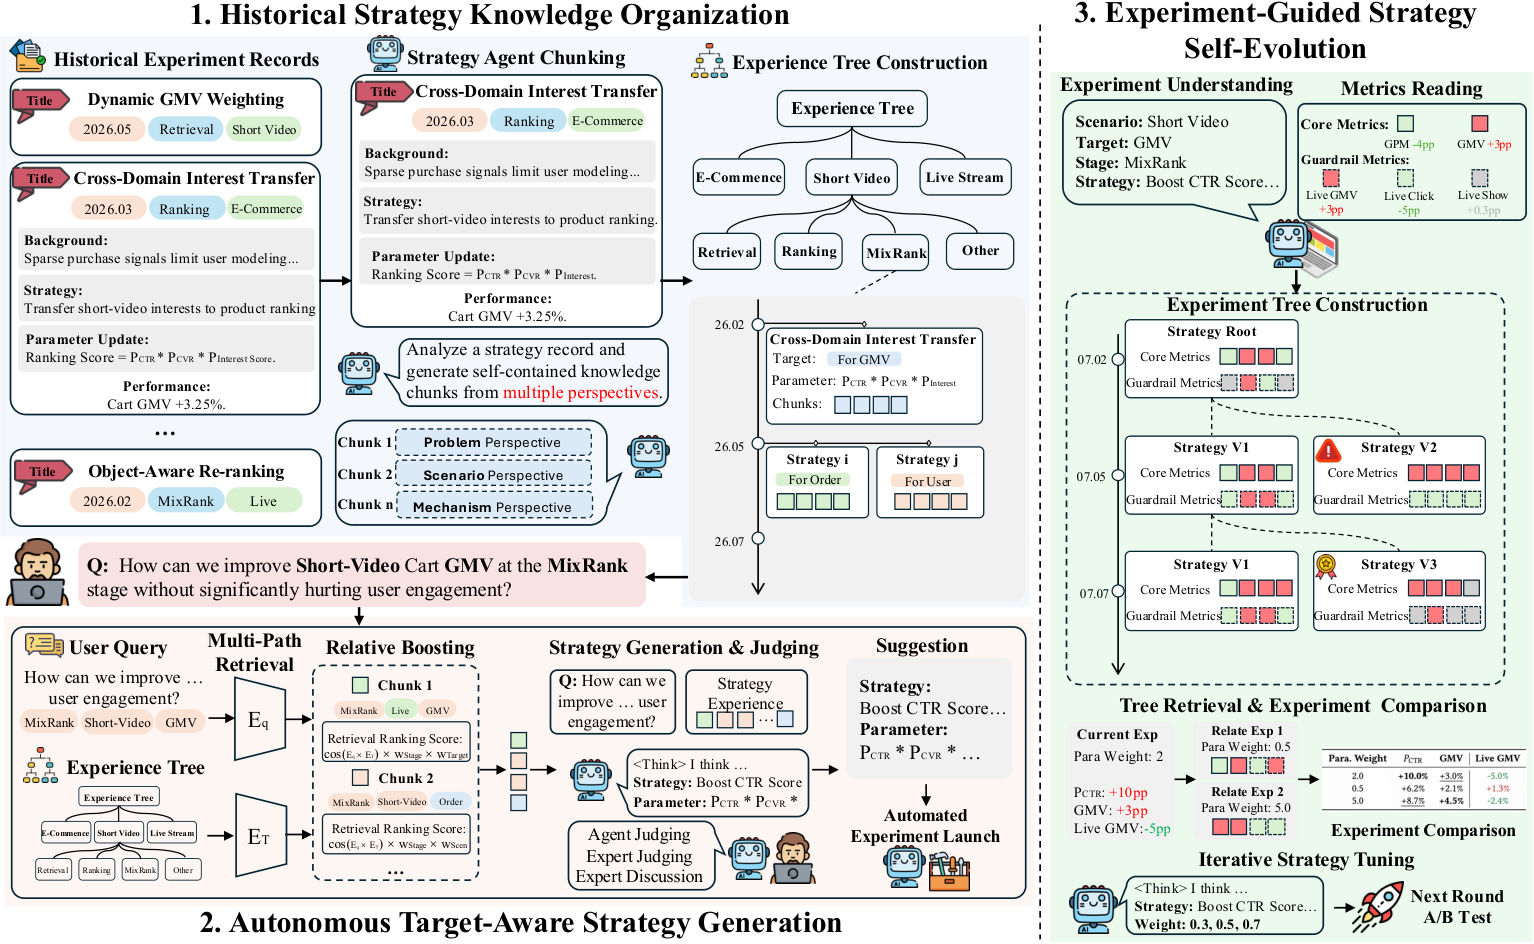
在工业系统中,一份历史实验报告往往混杂着多次策略变动、中间失败的调参参数和复杂的综合指标,信息噪声极大。A/B Agent 首先通过专用的解析智能体对历史报告进行原子化解构,提炼出包含业务动机、执行机制、具体参数配置、适用约束边界、最终正负收益以及生态潜在风险的独立策略块(Strategy Chunks)。每一个策略块都通过四元组进行系统性锚定:业务域 $d_c$、具体业务场景 $s_c$、所处的推荐流水线阶段 $l_c$、以及所优化的核心目标 $o_c$。
在此基础上,系统构建起一张拓扑树 $\mathcal{T}_E = (\mathcal{V}_E, \mathcal{E}_E)$。当系统收到一个新的优化请求 $q$ 时,并非盲目在全局向量库中做暴力相似度匹配,而是先将请求映射到经验树的特定语义路径中。
系统在检索阶段采用稀疏与稠密并行的 Tree-RAG 机制。稀疏检索负责精准锚定业务专业术语、关键特征名与配置项参数,稠密检索则利用表征向量挖掘具有相似机理但措辞不同的策略方案。为了彻底杜绝扁平检索带来的跨阶段“张冠李戴”,A/B Agent 引入了基于树结构的上下文相关性加权算子:
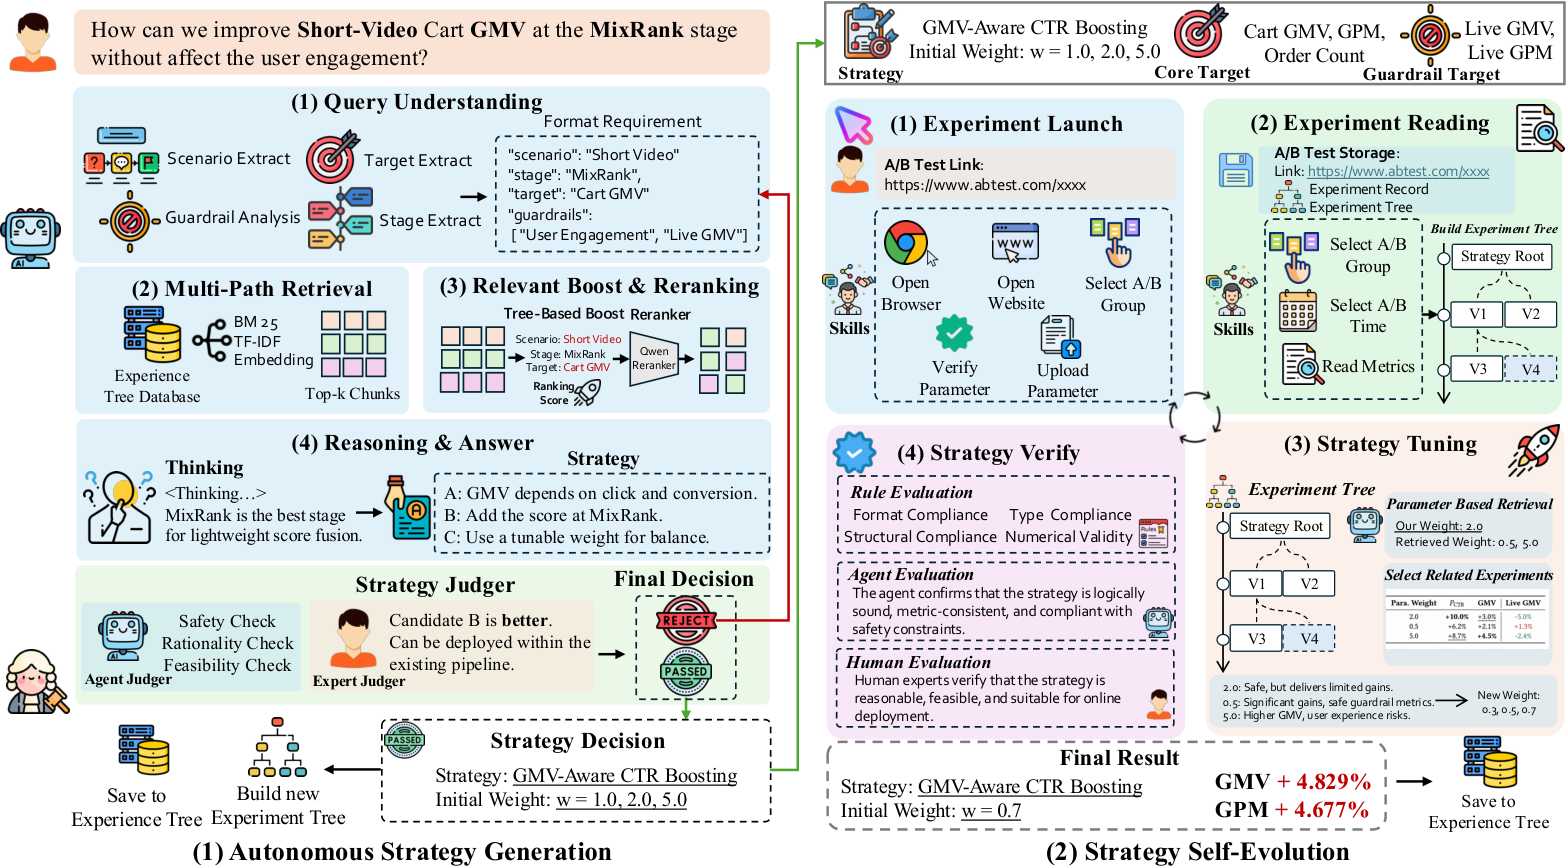
\[B_{\mathrm{tree}}(c,q) = \sum_{l} \beta_{l} \exp\left(-\gamma_{l} d_{\mathcal{T}}\left(v_{c}^{l}, v_{q}^{l}\right)\right)\]其中 $d_{\mathcal{T}}$ 代表候选节点与查询目标在经验树特定层级上的最短路径距离。层级重合度越高,衰减后的增强权重越大;而相邻分支保留较小权重,为跨相近业务场景的合理经验迁移提供窗口。在粗排筛选后,系统结合 Qwen-Reranker 进行面向可行性与风险视角的重排,再由内部评判模型进行逻辑一致性核验,最终产出具备高度工程可落地性的初始策略方案。
实验树驱动的自演化:如何把线上波动转化为调优方向?
一旦初始策略推向线上 A/B 测试平台,A/B Agent 的核心驱动力便切换为实验引导的自演化模块。传统开发中,工程师需要盯盘看指标、算置信度,而 A/B Agent 则将整个调优过程建模为动态生长的 A/B 实验树(A/B Experiment Tree)$\mathcal{T}_A = (\mathcal{V}_A, \mathcal{E}_A)$。
实验树的每个节点不仅存储当前策略机制与具体的超参数配置 $\boldsymbol{\theta}_t$,还绑定了带有统计置信度加权的真实在线指标变化量 $\widetilde{\Delta y}_j = \rho_j \Delta y_j$。在这里,系统摒弃了单一指标取向,而是构建了一个显式兼顾业务收益与系统安全底线的效用评估函数:
\[U(v) = \sum_{j \in \mathcal{M}_{\mathrm{core}}} w_j \widetilde{\Delta y}_j - \lambda \sum_{k \in \mathcal{M}_{\mathrm{guard}}} w_k \max\left(0, -\widetilde{\Delta y}_k\right)\]这一公式清晰地展示了其设计哲学:所有核心指标的提升都会根据业务权重直接转化为正向效用,而对于任何一个护栏指标的负向折损,系统施加了超参数 $\lambda$ 控制的重度惩罚截断。只要任何护栏指标跌破基线,该配置的整体效用就会遭到严厉扣减。
在实验树的推进过程中,智能体会自主执行两套关键动作:
-
父子节点对比(Parent-Child Comparison):精准隔离单一参数或局部逻辑修改带来的边际效应,准确完成指标波动归因;
-
兄弟节点对比(Sibling Comparison):在由同一个基线派生出的多条可行路径中,横向评估哪一个分支在护栏约束下具有更好的演进潜力。
当某条探索分支在满足护栏安全的前提下持续带来核心指标增长,智能体会沿该方向进入“局部参数搜索”状态,进行细颗粒度的网格逼近;一旦当前分支的核心收益达到平台期(收益饱和),或者无论如何微调参数都无法消除对护栏指标的严重侵蚀,智能体便判定当前机制已触及上限,随即触发“机制级切换”——回到分层经验树中检索替代思路,并在实验树上拉出一条全新的分支重新开辟航线。
真实短视频电商突围:从“拆东墙补西墙”到帕累托最优
在快手短视频电商环境的实战部署中,A/B Agent 展现出令人信服的决策逻辑。
在长达数轮的实际在线测试中,智能体完整演示了由粗犷试探向精细化约束收敛的演进轨迹。初始版本的 Strategy 1 虽使核心 GMV 提升了 1.123%,但四项护栏指标全部下滑,人均观看时长、直播电商 GMV 均受到抑制;智能体在 Strategy 2 中激进调整目标权重,GMV 涨幅迅速冲至 2.984%,点击率也录得最高值,然而护栏指标平均降幅依然为负。这说明短期高压式的转化策略严重透支了生态体验。
关键的转折发生在 Strategy 3 与 Strategy 4。A/B Agent 依据效用函数施加的护栏惩罚,主动舍弃了部分单纯博取点击的激进配置,转向约束优化。到 Strategy 4 时,不仅主要业务指标维持高位,而且全部护栏指标历史上首次全线翻正。最终生成的 Strategy 5 达成了全局最优解:GMV 净增 4.829%,千次曝光成交额(GPM)增长 4.677%,而在大盘护栏层面,观看时长与直播 GMV 不降反升,分别取得了正向改善。
相比资深算法工程师耗费多日手工打磨的专家策略,A/B Agent 最终方案的 GMV 和 GPM 增益分别高出人工基线 2.150 和 2.941 个百分点。尤为关键的是,人工方案为了拉升电商主指标,往往不得不牺牲观看时长和直播指标(两者均为负数);而 A/B Agent 借助其细密的局部参数空间遍历与效用截断,成功找到了专家肉眼难以捕捉的帕累托最优配置点,在避免伤及基础盘的前提下完成了核心业务爆发。
评测对比与消融启示
在涵盖三类异构工业电商推荐场景的离线基准测试中,A/B Agent 取得了 7.244 的综合评分,击败了包括 Claude-Sonnet-4.6 与 GPT-5.5 在内的所有独立基础模型底座。
评测显示出一个耐人寻味的现象:单纯接入传统 RAG(如 Vanilla RAG 或 HyDE)的方案,整体表现甚至不如裸跑的顶尖闭源大模型。Vanilla RAG 的平均得分仅为 5.692,比单纯依靠大模型记忆推理的方案落后明显。这印证了前文的论断:缺乏结构化层级过滤的平面检索,引入的大量语义相似但工程上下文冲突的“脏知识”,反而对大模型的策略推理形成了噪声干扰。相较于各个场景下表现最好的传统 RAG 基准,A/B Agent 的综合评分分别实现了 25.0%、31.7% 和 23.5% 的断代式跨越。
消融实验进一步证实了核心模块的互补性。当移除底层策略知识库时,系统的策略正确性直接暴跌 3.3%;而一旦拿掉树状重排与层级感知模块,系统的跨场景策略迁移能力便出现断崖式衰减。这表明,在大模型已经具备基础推理能力的今天,决定工业智能体天花板的,不再是底层模型本身的参数量,而是外部注入工业知识时的组织拓扑与约束建模精度。
走向策略级自治的下一代推荐系统
快手 A/B Agent 的成功实践,向算法工程界展示了一个超越常规“代码补全”或“数据分析看板”的全新范式。在以往的工业生产体系里,AI 系统主要承担下游的模式识别与内容召回排序,而最顶层的“系统如何调优、参数走向何方”等高阶决策权,始终牢牢绑在人类专家身上。
A/B Agent 将推荐系统工程调优提升到了以业务目标为锚点、以全自动化闭环为手段的自主进化阶段。它证明了大模型不仅仅可以用于感知用户的兴趣点击,更可以化身严谨的运筹中枢,把零散的工程教训凝练为永不磨灭的经验资产,并以超越人类精力极限的细致度,在数以百计的业务冲突边界中寻得最优解。对于整个工业互联网领域的算法迭代与工程自动化而言,这种将分层知识组织与线上反馈紧密耦合的闭环架构,无疑具有极强的启示意义。