Active-SWE:摆脱Issue提示!大模型主动找Bug最高解决率仅20%
Active-SWE: Benchmarking Coding Agents for Proactive Bug Fixing without Issue Reports
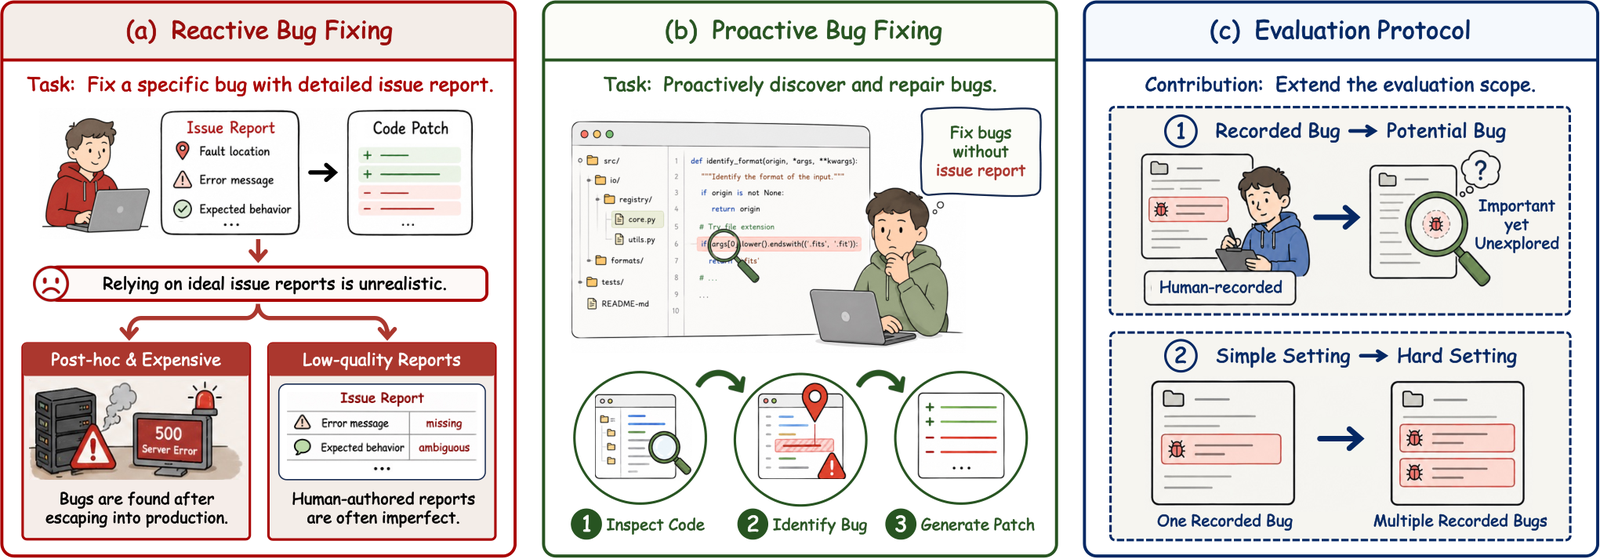
在软件工程领域,基于大语言模型(LLM)驱动的 Coding Agent 正在迅速从玩具走向实际生产力工具。从修复小型脚本到在复杂代码仓库中解决具体问题,现有的代表性评测基准(如 SWE-bench Verified 和 SWE-bench Pro)几乎都依赖一个极其理想化的假设:开发者已经提交了一份高质量的 GitHub Issue 报告,其中详尽列出了错误现象、触发堆栈甚至复现路径。模型所要做的,本质上是“照方抓药”式的被动修复(Reactive Bug Fixing)。
ArXiv URL:https://arxiv.org/abs/2608.04682v1
然而在真实的工业界开发中,高质量的 Issue 报告本身就是昂贵的稀缺品。很多隐蔽的代码缺陷在引发服务雪崩或造成数十亿美元经济损失之前,根本没有任何人类报告提示;即便是日常由非专业用户提交的反馈,也往往充斥着模糊、残缺或充满误导的描述。当剥离掉“人类喂到嘴边”的上下文线索,让 Agent 独自审视代码仓库时,它们还能像宣传中那样自主排查并消除系统缺陷吗?
来自四川大学、电子科技大学等机构的研究团队提出了 Active-SWE,这是首个系统评测 Coding Agent 在脱离 Issue 报告前提下进行“主动找 Bug 并修复”(Proactive Bug Fixing)的基准平台。基准覆盖了 1,663 个任务、6 大核心 Bug 分类以及 8 种主流编程语言。实验结果令人警醒:在失去 Issue 的保姆式引导后,当前处于顶尖梯队的基准大模型表现遭遇断崖式下跌,最高解决率仅能达到 20.0%。这表明现存的各种 Coding Agent 在代码自主审计与多 Bug 并发定位上,依然存在巨大的能力鸿沟。
从被动定位到主动排障:现有评测基准的盲区
过去两年里,评估代码大模型解决真实工程问题的主流方式高度同质化。评测流程通常是提取 GitHub 历史中已关闭的 Issue 及其对应的合并 PR(Pull Request),将 Issue 的文字描述作为 Prompt 输入给 Agent,再将 PR 中的测试用例作为检验修复成功与否的依据。
这种设定虽然易于标准化,却无形中规避了软件工程中最核心也最困难的环节:自主缺陷发现。首先,真实的缺陷识别往往是滞后的。许多致命隐患(例如曾导致全球大规模蓝屏死机的底层驱动内存越界访问)往往在没有显式报错的情况下长期潜伏,等用户报告时系统早已崩溃。其次,OpenAI 近期对 SWE-bench 系列数据集的审计也表明,即使经过多轮人工清洗,基准库中仍存在相当比例信息缺失或难以解析的 Issue 描述,导致 Agent 的失败很大程度上归咎于文本理解与对齐成本,而非纯粹的工程审计能力。
Active-SWE 彻底重构了任务范式。在给定的代码库切片与指定审查范围内,Agent 面临的是一个纯净的代码快照,没有任何人类提示告知它哪里坏了、会有何种异常。Agent 必须像资深架构师进行 Code Review 一样,自主通读关联代码,构建控制流与数据流的认知模型,主动发现代码中存在的单个或多个缺陷,并直接输出可落地的修复补丁。
这一范式转换不仅对 Agent 的代码空间检索提出了更高的推理要求,更直接把评测范畴推向了此前基准未曾触及的两个深水区:其一是多 Bug 协同排查场景,测试 Agent 是否具备一次性发现并解决多处耦合缺陷的能力;其二是潜在未记录 Bug(Potential Bug)的发现场景,考察 Agent 是否能在修复历史已知缺陷的同时,洞察代码库中未被官方 PR 捕捉的隐蔽隐患。
Active-SWE 的构建逻辑:时序融合与双轨验证
为了保证无 Issue 设定下的主动排障评测既严谨可复现,又具有足够的工程挑战,研究团队设计了一套兼具分类学引导与难度感知的构建管线,核心包含任务合成与双轨验证机制。
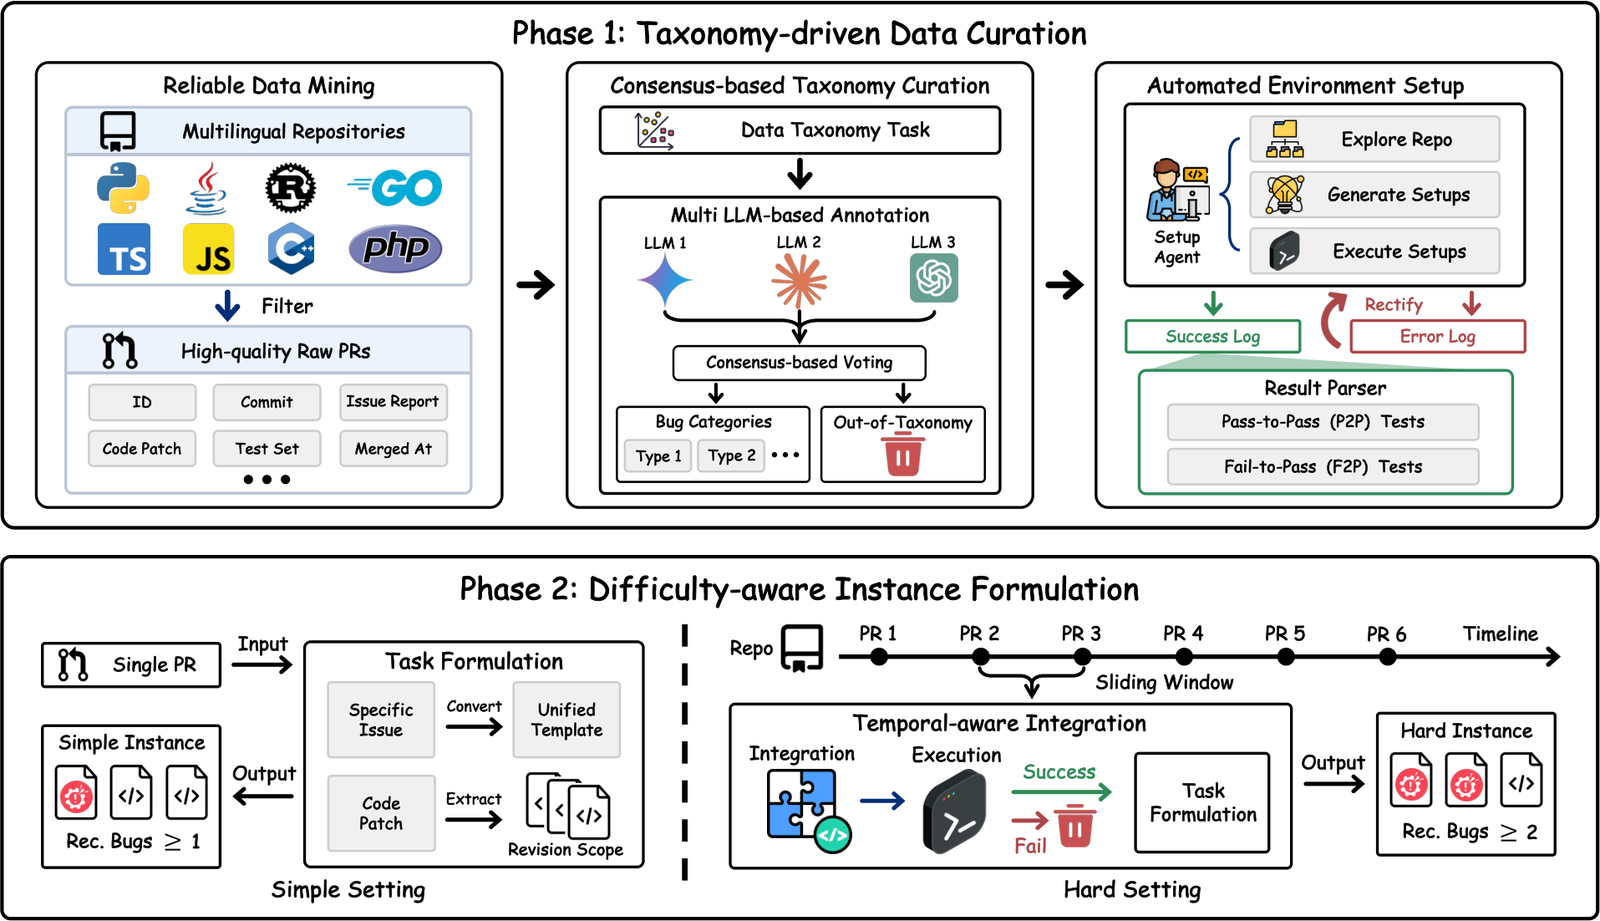
在数据清洗与环境搭建阶段,Active-SWE 从海量跨语言开源项目中筛选出具备明确修复行为且测试环境可闭环的 PR。为了确保基准覆盖代码语义的多样性,所有 PR 均依托多模型共识机制严格划分进六大 Bug 类别:逻辑与计算错误(Logic & Computation)、引用与数据流(Reference & Data Flow)、数据处理与类型转换(Data Processing & Type)、特定领域工作流(Domain-specific Workflow)、异常安全(Exception Safety)以及状态与生命周期(State & Lifecycle)。同时,框架调用专门的 Setup Agent 借助 ReAct 交互模式全自动搭建 Docker 镜像并生成粒度精细的测试执行脚本,将原本模糊的测试集严格拆分为 Fail-to-Pass(用于验证缺陷已被精准修复)与 Pass-to-Pass(用于验证原有功能未被破坏)。
在此基础上,构建流程针对工程难度引入了时序感知任务构建机制。常规的简单实例(Simple Tasks)直接派生自单一 PR,Agent 需要在指定的审查范围文件内独立找出这一处历史记录缺陷。而为了构建更符合复杂现实环境的高难实例(Hard Tasks),框架通过时间滑动窗口机制,将同一代码仓库在时间线上相邻的多个独立修复 PR 进行语义和代码级融合。这意味着在一个高难任务切片中,同时存在多处相互交织的历史 Bug。只有当合成补丁能够精准触发并使所有子 PR 的 Fail-to-Pass 测试全部转绿,该高难实例才被认定为有效。这种设计从物理机制上打破了传统基准“一个提示对应一个 Bug”的线性解题习惯。
更关键的技术突破在于双轨评估体系(Dual-Track Evaluation Framework)的设计。在没有标准 Issue 规范产出的前提下,如何客观判断 Agent 给出的补丁是否真正有效?
第一轨针对历史已记录缺陷(Recorded Bugs)。Active-SWE 创新性地提出了将定位与修复解耦的度量方式。通过比对 Agent 修改的代码区域与人类标准补丁之间的重合程度,引入定位召回率(Localization Recall, LR)与定位精确率(Localization Precision, LP),并将测试套件的全部通过判定为最终解决(Resolved)。这种解耦使研究人员能清晰观察到:模型究竟是“根本找不到位置”,还是“找到了位置却写错了修复逻辑”。
第二轨针对潜在新缺陷(Potential Bugs)。如果 Agent 在审查过程中修改了参考标准之外的代码逻辑,往往很难单纯通过历史测试来判定它是提出了创新性的预防性修复,还是引发了幻觉式的代码破坏。Active-SWE 摈弃了人工主观打分,提出了一套严密的可信测试驱动验证机制:评测框架要求 Agent 在给出修改补丁的同时,必须基于目标代码库自主生成一套针对该潜在缺陷的重现测试用例。框架利用判定代理验证测试与缺陷的对应关系,并在未应用补丁时运行测试使其必然失败、应用补丁后全部转为成功,唯有严格满足该条件的潜在发现,才会被最终判定为有效的 Revelead 缺陷。
核心实验发现:定位是硬前提,并发缺陷成死穴
基于包含 400 个代表性高质量任务的核心子集(涵盖 300 个简单实例与 100 个高难多缺陷实例),团队对业内主流的顶级模型进行了全面评测,涵盖 Claude Opus 4.8、GPT-5.4、Gemini-3.1-Pro、GLM-5.2 以及 Qwen3.5 全系列代码 Agent。
实验数据揭示了一个残酷的事实:在失去 Issue 提示的被动支撑后,大模型修复代码的胜率急剧下跌。在已记录缺陷的最终解决率(Resolved)指标上,表现最优的模型也仅能交出 20.0% 的及格边缘成绩,绝大多数模型的解决率徘徊在 10% 上下甚至更低。
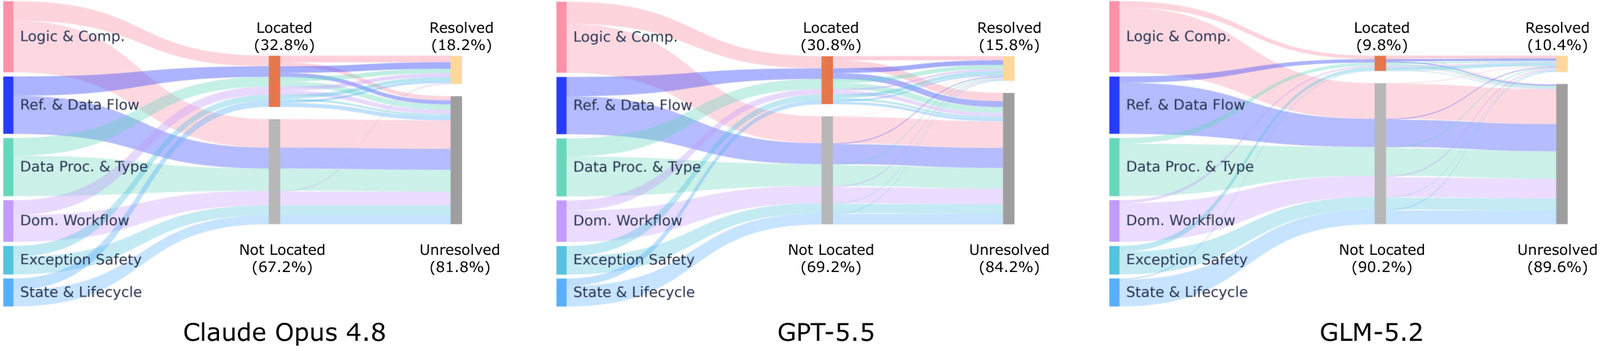
深入解剖定位指标与修复率的关联可以发现,代码缺陷定位能力是决定主动修复成败的决定性前置条件。在被动修复基准中,Issue 通常直接附带了堆栈追踪(Stack Trace)甚至是出错函数的行号,Agent 实际上在做局域代码生成;而在 Active-SWE 中,定位召回率(LR)和定位精确率(LP)普遍呈现出较低水平。许多模型在庞大的审查文件集中如同无头苍蝇,修改了大量无关代码(导致极低的 LP),却根本没有触碰到诱发异常的核心语句块。凡是在定位召回率上落后的模型,其最终的 Resolved 指标无一例外跌入谷底;反之,只有那些具备较高代码静态感知能力的 Agent,才能保底获得后续执行测试用例并正确修复的机会。
当场景切换到包含多个并发缺陷的高难多 Bug 任务时,模型的溃败更为彻底。在多 Bug 融合的任务切片中,各主流模型的解决率普遍发生雪崩。这表明现有的 Agent 框架大多建立在“单次交互单目标优化”的脆弱假设上,一旦需要在一次推理或多轮交互中同时维持多条追踪逻辑,模型注意力便会迅速发散,产生遗漏或者引发不同修复补丁之间的语义冲突。
而在潜在新缺陷(Potential Bugs)的发现维度上,评测展现出了更为有趣的现象。许多模型声称自己找到了数十处潜在缺陷,并输出了海量的测试用例(Count 极高),然而在经过测试有效性(TV)以及真实重现率(Revealed)的双重卡尺过滤后,有效转化率极低。这证明在缺乏外部约束时,模型极度倾向于生成表面合规但实际上无法稳定断言失败状态的无效测试。在整个测试池中,唯有极少数顶级模型能够在确保不误报的前提下,通过可复现的自动化测试切实验证其发现的代码隐患。
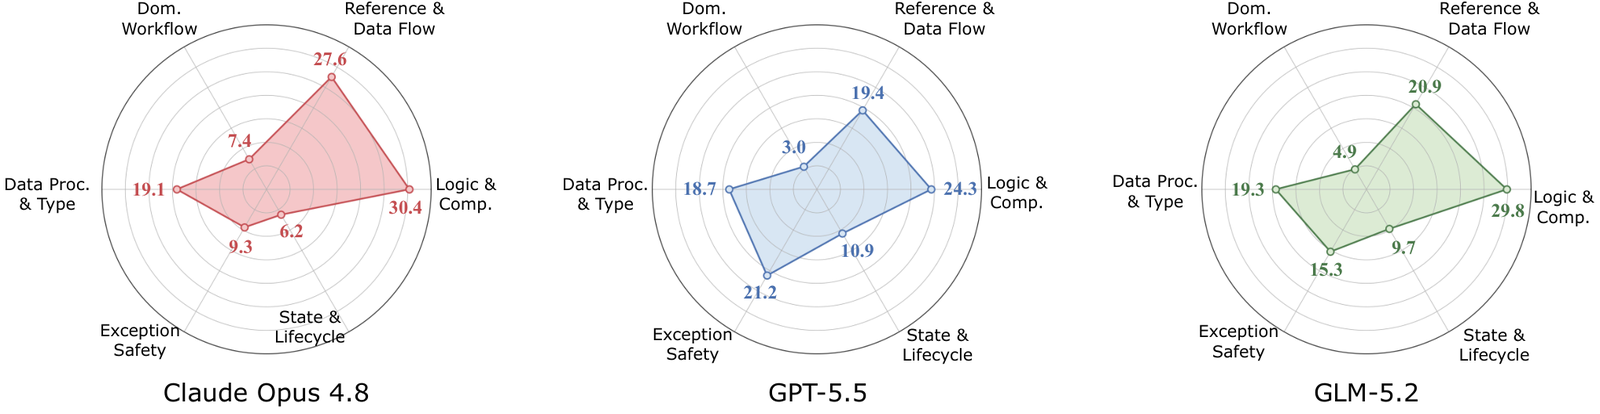
缺陷类型与推理行为的深层差异
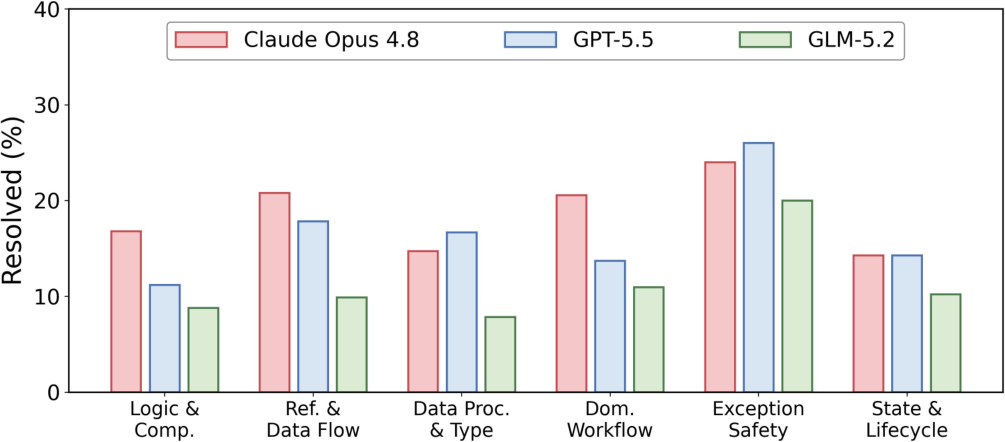
除了全局指标的落后,不同模型在不同代码语义范畴内的表现也展现出了显著的极化现象。
从 Bug 的分类学特征来看,模型解决异常安全(Exception Safety)相关缺陷的成功率显著高于其他类型。这类问题通常伴随着显式的语法结构(如缺少 try-catch、空指针未解包、未处理的边界返回值等),代码局部特征明显,模型通过局域模式匹配较容易识别。然而,一旦面对状态与生命周期(State & Lifecycle)以及复杂的领域工作流(Domain-specific Workflow)缺陷,模型的解决能力便会骤降。这类缺陷往往不包含任何表面上的语法违规,代码完全符合类型系统定义,故障的诱发深植于多模块之间的调用时序、资源释放顺序以及异步事件循环中。大模型在没有 Issue 提示调用链路的情况下,极难单纯依靠上下文窗口在脑海中完成这种复杂的跨周期状态机推演。
分析各 Agent 在多轮交互轨迹中的行为演化,同样可以发现明显的范式差异。
在面对无 Issue 报告的主动排障任务时,成熟的 Agent 会展现出明确的两阶段推理模式。在交互初期,Agent 会把大量步数(Turns)投放在代码审查(Code Inspection)工具的调用上,大范围通读关联文件并构建模块映射;随着审查推进,交互轨迹才逐步切换到搜索(Search)与测试执行(Execution)。然而,不同技术路线的底层模型展现出了截然不同的推理深度:部分开源衍生模型倾向于通过密集的短轮次高频尝试修改代码并盲跑测试,陷入低效的试错循环;而诸如 Claude Opus 4.8 等模型则展现出更高的单步推理信息密度,前置审查极其审慎,以更短、更具确定性的交互轨迹完成缺陷锁定与修复。
走向真正自主的 AI 软件工程师
Active-SWE 所揭示的困境,为当下火热的代码智能体研究浇了一盆清醒的冷水。长期以来,学术界与工业界过分依赖于类似 SWE-bench 这种以 Issue 为中心的评测轨道,在不断刷榜的同时,掩盖了模型在“自主代码审计”这一核心工程能力上的短板。
要填补这 20.0% 到实际可用之间的巨大落差,未来的 Coding Agent 需要经历两个维度的技术升级:
-
从反应式单点修补转向全局架构感知:Agent 不能仅仅作为代码补全工具的套壳,而必须集成更强大的静态分析中间表示(如代码属性图、程序依赖图),在推理前置阶段具备系统性的跨文件状态追踪能力,而非单纯依赖文本模糊匹配去猜 Bug。
-
构建内生性的双向验证闭环:在没有人类告知“哪一行代码逻辑不对”的现实环境中,生成反事实测试用例(Counterfactual Test Generation)的能力与代码修改能力必须同等进化。Agent 必须学会自己给自己写测试、自己重现自己的猜想,才能彻底摆脱对外部 Issue 提示的病态依赖。
Active-SWE 的开源,不仅为社区提供了一个不再容易被“Prompt 提示词工程”取巧破解的硬核评测标尺,也为下一代真正能够独立巡检大型代码库、在黑天鹅事故发生前自主消除系统死穴的 AI 软件工程师确立了清晰的演进方向。