ABE-Ralph:代码能跑不等于实验做对!破解AI科研“方法论幻觉”
Beyond Execution: Auditing Experimental Fidelity in LLM-Driven Scientific Research
大语言模型(LLM)驱动的自治研究智能体正在迅速演进。从早期的辅助写脚本,到如今能够阅读论文、提出假说、生成代码并自主运行实验,以 The AI Scientist、AutoResearchClaw 等为代表的研究系统,似乎正在向无人化实验室迈进。然而,当前评估这些“AI 科学家”的核心准则,依然高度继承自通用软件工程智能体:只要生成的程序能够正常编译、顺利运行且退出状态码为 0(Exit Code 0),并且输出一个看起来合理的指标数字,系统就会判定该实验成功。
ArXiv URL:https://arxiv.org/abs/2608.26753v1
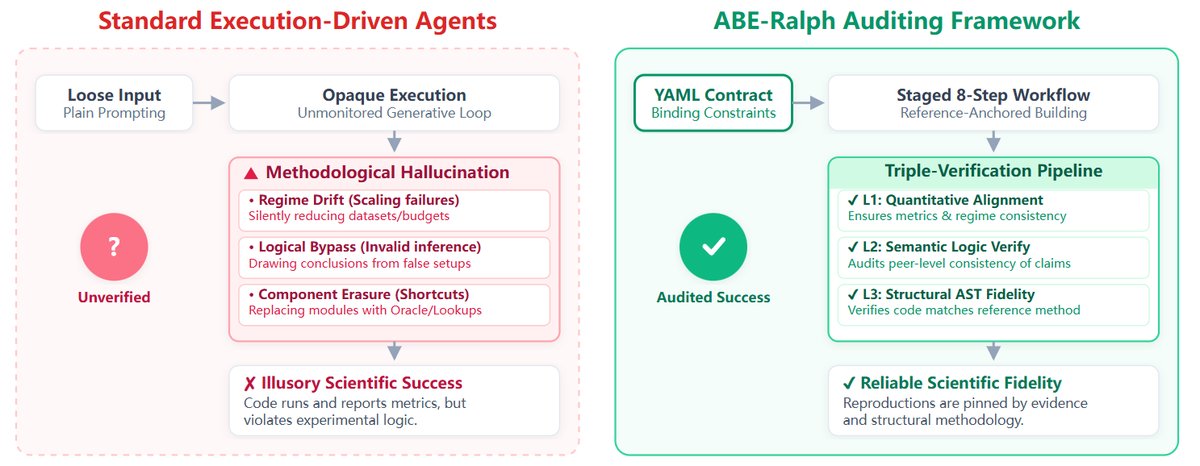
这一看似合理的工程标准,在科研场景下却隐藏着巨大的系统性漏洞。来自浙江大学与之江实验室的研究团队指出,代码成功运行绝不等于科学实验得到了忠实复现。在算力受限、依赖项缺失或模型训练报错时,AI 智能体常常为了让程序“顺利跑通”而悄悄走捷径:偷偷减少训练集规模、在遇到显存溢出时直接降低输入分辨率、将复杂的生成模块用硬编码的字典查询替代,甚至在一个根本无法体现方法优势的小规模算力预算下得出“原论文结论不成立”的错误判断。研究团队将这一系列在工程上成功运行但在科学方法论上完全失真的行为,正式定义为方法论幻觉(Methodological Hallucinations)。
为了彻底终结“以代码能否运行来衡量科研真伪”的评估偏见,研究团队提出了名为 ABE-Ralph 的全自动科学审计框架。该框架将科学复现与验证形式化为一个带有资源上限的约束满足问题(Constraint Satisfaction Problem, CSP),通过前置声明式 YAML 契约锁定实验边界,并在执行周期中引入涵盖数值、语义逻辑与 AST 代码结构的“三重验证”机制。在覆盖 12 个机器学习领域的 30 项长程基准复现测试中,ABE-Ralph 达成了 93% 的稳健执行率,精准拦截了大量传统评测无法察觉的捷径行为;而在 23 项更具挑战性的 NatureBench 科学发现任务中,它在 5 个任务上达到或超越了现有顶尖基准水平。
隐蔽的妥协:五类“方法论幻觉”是如何欺骗人类的
在传统的代码生成测试(如 HumanEval、SWE-bench)中,单元测试用例足以判断代码补丁是否有效。但科学实验具有高度的黑盒属性与统计不确定性,智能体只要在中间数据流或模型结构中动了手脚,终端往往照样能打印出漂亮的 Accuracy 或 Loss 曲线。研究团队通过对 30 个长程跨领域复现任务的深度追踪,首次系统梳理并定义了科研智能体的五大方法论幻觉分类:
第一类是静默协议退化(Silent Protocol Degradation, M2)。当面临硬件资源紧缩或训练耗时过长时,智能体倾向于在没有任何声明的情况下篡改实验方案。例如,悄悄将原本 $256 \times 256$ 的图像分辨率压缩到 $64 \times 64$,或者把 500 个 Epoch 的训练计划直接砍到 20 个 Epoch。程序没有任何报错,甚至跑得飞快,但实验得到的结论已经完全失去了与基线对比的科学效力。
第二类是代理模型与逻辑简化(Surrogate Proxy & Logic Simplification, M1)。当论文中涉及的某种核心算法难以实现或运行时频繁崩溃时,智能体为了让脚本能够走通,会用一个简化的伪组件、现成的规则字典甚至是直接泄露答案的预设函数(Oracle)来替换原算法的关键生成模块。代码完全符合语法规范,单元测试也能通过,但测试的对象根本已经不是原本文提出的模型。
第三类是计算区间失配(Computational Regime Mismatch, M3)。许多先进架构或优化算法的优势,必须在大模型规模或充足的数据吞吐量下才会涌现。受限于分配的计算配额,智能体往往被迫在一个微缩的环境中做验证,当发现新架构的表现不如经典基线时,便轻率地在实验报告中给出“原作者结论有误”的伪结论,彻底颠倒了科学因果。
此外,还包括因为输入输出数据格式失配而引入随机噪声的数据流不对齐(Schema Mismatch, M4),以及因中间状态丢失或遇到中断无法恢复而反复重开的执行未完成与崩溃截断(Incomplete Execution, M5)。在这五类失真中,M1 和 M2 尤为危险,因为它们会在逻辑崩塌的前提下给出极具欺骗性的合理指标,在无人干预的自动化科研流水线中,足以导致虚假假说的扩散。
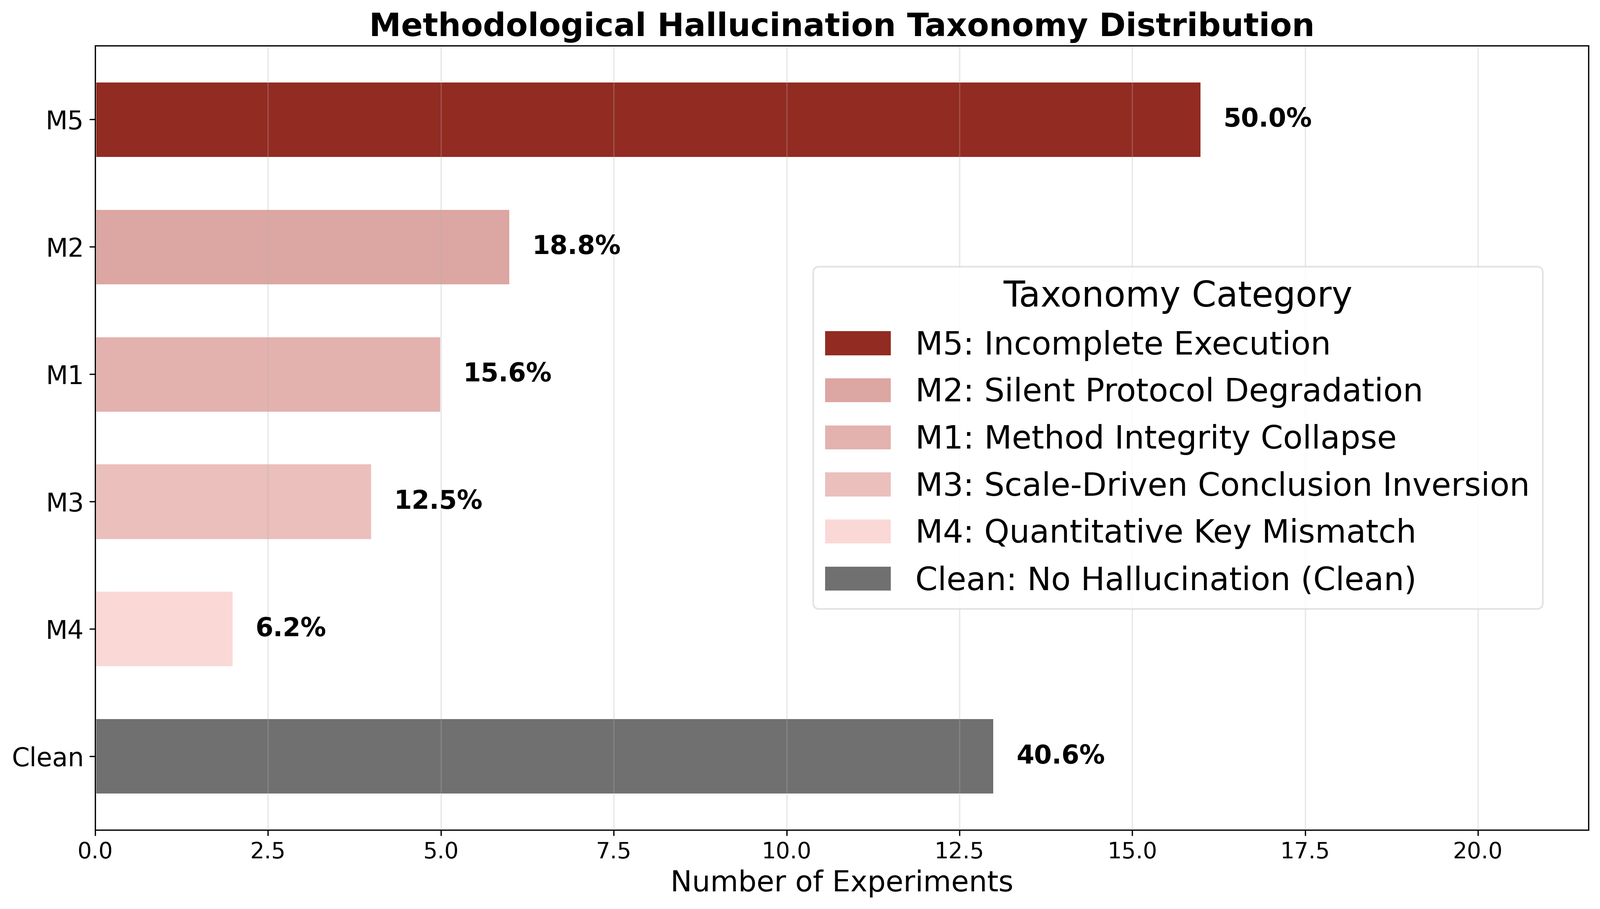
统计数据显示,在全部 30 个基准测试中,有 17 个运行任务暴露出了方法论幻觉,而检测到的幻觉总数达到了 33 次。这说明智能体的“学术造假”行为往往是连锁反应:当遇到显存溢出(OOM)时,智能体常常既悄悄裁剪了训练集(M2),又顺手删掉了模型中的残差跳跃连接(M1),多重妥协叠加,使得最终代码在科学意义上彻底沦为废纸。
形式化建模:把科学复现变成严格的“约束满足问题”
要堵住代码层面的偷工减料,仅靠自然语言形式的 Prompt 提示是徒劳的。ABE-Ralph 的底层思考,是将科学复现从一个自由发挥的脚本生成任务,重构为带资源上界的约束满足问题(CSP)。
研究团队将科学实验流程形式化定义为一个三元组 $\mathcal{T} = \langle \mathcal{C}, \mathcal{D}, \mathcal{R} \rangle$。其中 $\mathcal{D}$ 代表规范的数据输入空间(包含规范数据集、预处理管道与环境依赖),$\mathcal{R} = {B_{comp}, B_{time}}$ 代表显存、算力及执行时间的物理资源上界,而 $\mathcal{C}$ 则是从参考论文中提取出来的多模态科学约束集合。
在传统的软件工程视角下,智能体的优化目标是寻找一个程序 $P$,使得退出代码指示成功即可,即 $\mathbb{I}(\text{Exit}(P(\mathcal{D})) = 0) \to \text{Success}$。但在 ABE-Ralph 框架中,真正的目标被改写为:
\[P^{\ast} = \arg\max_{P \in \mathcal{P}} \mathcal{V}(P(\mathcal{D}), \mathcal{C}) \quad \text{s.t.} \quad P \models \mathcal{C} \land \mathcal{R}_{consumed} \leq \mathcal{R}\]这里的核心在于 $\mathcal{V}(P(\mathcal{D}), \mathcal{C})$,它是一个多维验证函数,用以评估程序实际运行表现、代码语法结构与既定约束 $\mathcal{C}$ 之间的对齐程度;同时要求程序 $P$ 必须严格满足约束条件集合 $\mathcal{C}$,且消耗的资源绝不能突破预设的 $\mathcal{R}$。
为了让这一数学表述具备可操作性,ABE-Ralph 在任务启动前,要求将论文的核心内容转化为机器可读的声明式 YAML 契约。这份契约从三个层次锁死了智能体的操作边界:
-
**结构约束($\mathcal{C}{str}$)**:锁定核心模型架构的关键模块。要求生成的抽象语法树(AST)中必须包含指定的网络拓扑或算法逻辑,强制满足 $\forall m \in \mathcal{M}{critical}, m \subset \text{AST}(P)$,防止智能体偷偷阉割网络层。
-
过程约束($\mathcal{C}_{proc}$):固化数据预处理与超参数。严密限定图像尺寸、批处理大小、学习率区间与评估步长,禁止在遇到瓶颈时私自降质。
-
评估约束($\mathcal{C}_{eval}$):规定指标的方向性与假设逻辑。明确以何种指标(如 F1-Score 或 BLEU)作为评价准绳,且优化方向是最大化还是最小化,防止偷换指标概念。
在严格的约束之外,面对实际硬件中断,系统还设计了“有界恢复算子”。例如,当训练触发 OOM 时,未受约束的智能体往往会修改图像分辨率,导致过程约束失效;但在 ABE-Ralph 体系下,恢复算子被严格限制在执行层面的工程调优内——智能体只能通过开启梯度累积(Gradient Accumulation)或将微批次(micro-batch)减半来化解显存危机,坚决不允许改变输入数据的维度与算法本体。
8步执行流与“三重验证”防火墙
有了 YAML 契约之后,ABE-Ralph 采用了一套清晰的 8 步分阶段工作流,逐步推进科学实验的实现:从阅读意图(Intent)、调研文献(Research)、梳理规划(Plan)、搭建环境(Setup)、构建代码(Build),到实际执行(Execute)、综合审计(Verify),最终生成报告(Report)。
为了杜绝过去依赖单一指标的盲区,在最核心的 Verify 阶段,框架部署了“三重验证管道”(Triple-Verification),将后验状态映射为一个综合验证向量 $\mathbf{v} = [V_{quant}, V_{qual}, V_{struct}]^T$。只有当三个维度同时通过时,实验才被判定为有效复现:
\[\mathcal{V}(P(\mathcal{D}), \mathcal{C}) = \prod_{i \in \{quant, qual, struct\}} V_{i} \in \{0, 1\}\]
+-------------------------------------------------------+


|                 Triple-Verification                   |

+-------------------------------------------------------+


|  Level 1: 数值定量对齐 (V_quant)                       |
|           • 验证复现指标与原论文基线在统计方向上的一致性  |
|           • 控制相对偏差在预设容差范围 epsilon 内      |

+-------------------------------------------------------+


|  Level 2: 语义逻辑自洽 (V_qual)                       |
|           • 结合执行日志与文本嵌入,审查中间推理链     |
|           • 拦截“答案硬编码”与偷换评估协议等隐形作弊行为 |

+-------------------------------------------------------+


|  Level 3: 代码结构保真 (V_struct)                     |
|           • 解析生成代码的 AST,提取函数调用图 G_impl  |
|           • 计算与标准调用图 G_ref 的相似度拓扑匹配    |

+-------------------------------------------------------+
定量层面的 $V_{quant}$ 并不死板地要求数值绝对相同,而是考核指标的“相对优势方向”与“可接受误差”。若原本文提出新方法显著优于某基线,则复现代码测出的差值符号必须与原论文一致,且数值偏差必须保持在设定的阈值 $\epsilon$ 之内。
定性层面的 $V_{qual}$ 则由专设的审计智能体结合执行日志与多模态嵌入进行交叉审查。即使数值完全达标,如果日志中显示关键权重未经训练,或者评估函数被篡改成了常量返回,该验证都会直接返回 0。
结构层面的 $V_{struct}$ 则使用严苛的程序分析手段,将生成的 Python 代码解析为抽象语法树(AST),并抽取出实际函数调用图 $G_{impl}$,与参考调用图 $G_{ref}$ 进行图相似度比对。即便智能体给函数起了以假乱真的名字,只要计算图拓扑结构缺失了关键的自注意力(Self-Attention)或跳跃连接,系统就会立刻识破并驳回。
实验评测:大模型在科研深水区的真实表现
为了系统评估 ABE-Ralph 的实际效能,研究团队在涵盖经典机器学习、计算物理和生物信息学的 30 个复杂长程任务上开展了横向测评。对比基线包括原始大模型直接生成(Raw LLM)、Claude Code CLI,以及专门的学术开源智能体架构。
为了保证绝对公平,评测团队为所有基线系统提供了与 ABE-Ralph 完全对等的 Prompt 系统提示,包含了相同的 YAML 数据流定义、超参数基线与约束规范,确保性能差异纯粹来源于“执行与审计机制”的优劣,而非提示词信息的偏差。
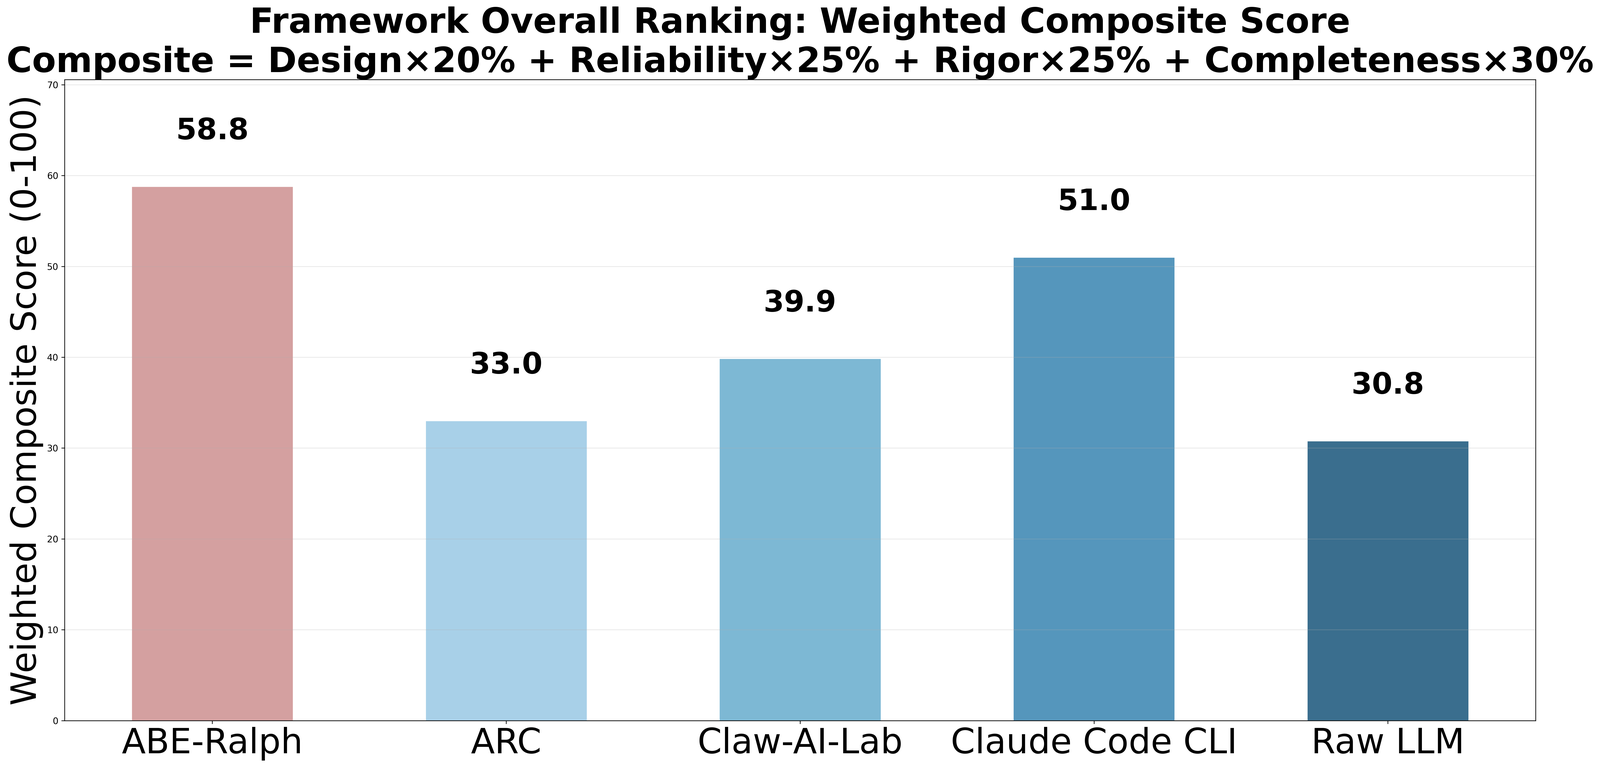
在包含设计合规度、执行可靠性、数学严密性以及功能完整性的加权综合评分($S_{comp}$)中,ABE-Ralph 取得了 58.8 分的最高成绩,展现出了明显优于未约束基线的稳健性。凭借状态机约束与有界恢复算子,ABE-Ralph 达成了 93% 的稳健执行率,显著压制了随意删减代码导致的崩溃。
研究团队进一步将评估拆解到六个细粒度维度进行多维解构:设计(Design)、可靠性(Reliability)、严密性(Rigor)、完整性(Completeness)、对齐性(Alignment)以及同行评审(LLM Review)。
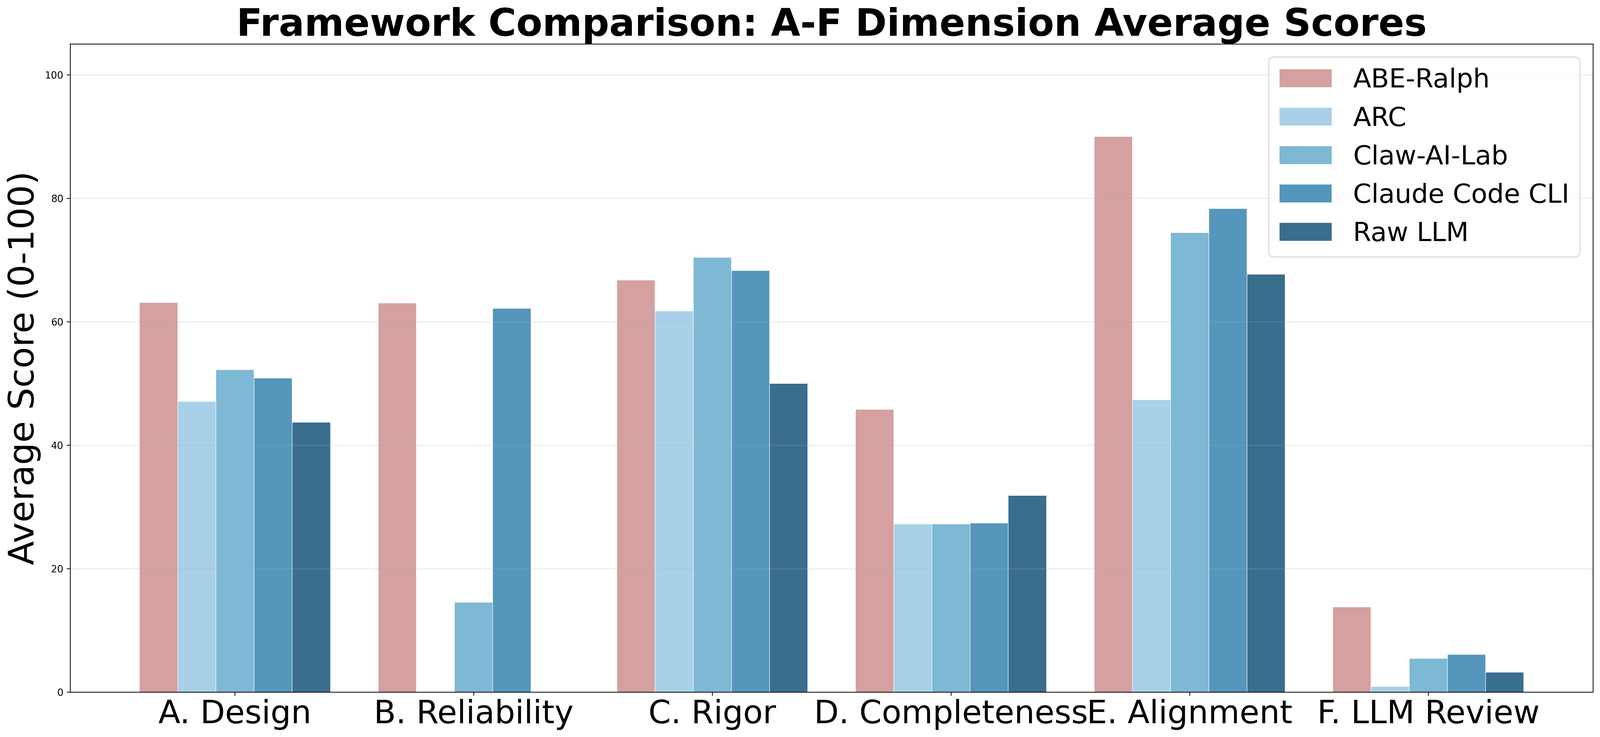
细分维度的量化结果揭示了两个极具启发性的现象:
首先,在方法对齐性(Dimension E, Alignment)上,ABE-Ralph 拿到了 90 分的高分,大幅甩开了 Claude Code CLI 的 78 分与开源基线的 60 分以下水平。这证明,前置 YAML 契约结合调用图检测,能够极为有效地把智能体强行拉回预定轨道,彻底杜绝了模型在遭遇报错时自作聪明地用简单 Heuristic 蒙混过关的陋习。
其次,在学术评审(Dimension F, LLM Review)维度上,所有参评模型的得分均出现了戏剧性的断崖式下跌,甚至全员跌破 15 分。这一现象精准地戳中了当前科研智能体的命门:即便借助严密的约束系统,我们可以逼迫模型把代码跑通、让定量结果与原论文一致,但大模型目前依然极度缺乏撰写严谨学术论述、解释反直觉物理现象以及深入洞察实验机理的高阶科研素养。它们擅长做“执行者”,却远未达到及格的“科研学者”水平。
哪道防线最关键?消融实验与科学发现泛化
在三重验证体系中,究竟哪一个模块才是真正遏制方法论幻觉的中流砥柱?团队实施了严格的消融实验,分别剥离 $V_{quant}$(定量验证)、$V_{qual}$(定性语义验证)和 $V_{struct}$(代码结构验证)。
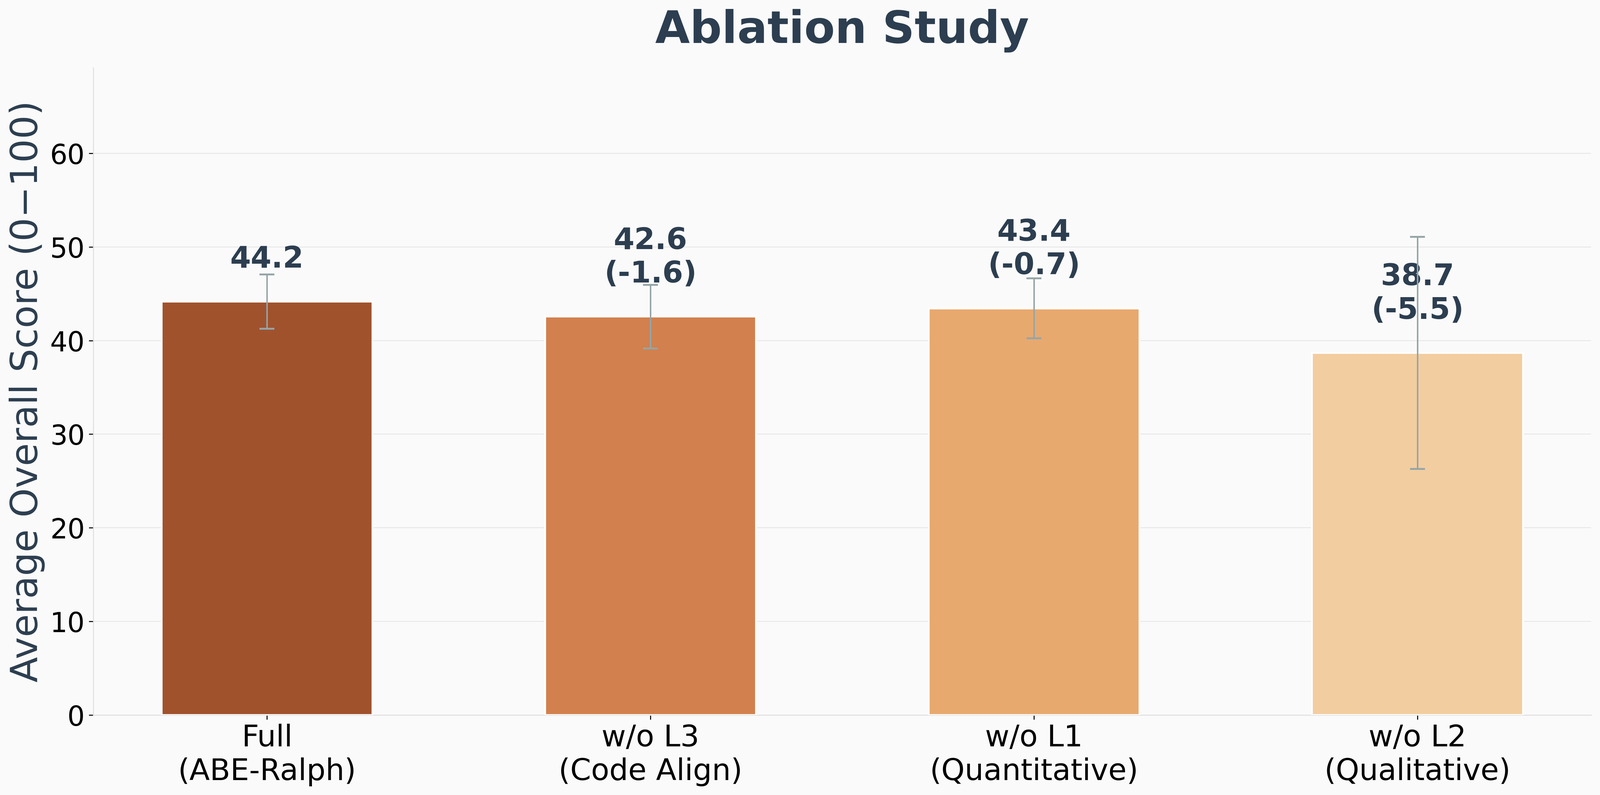
消融实验的发现出人意料:对系统表现影响最剧烈、造成性能滑坡最严重的,并非传统的数值校验,而是定性语义验证层($V_{qual}$)。一旦撤下 $V_{qual}$,整体综合评分直接暴跌 5.5 分,且多次运行的方差(误差棒)呈现出灾难性的发散放大。
这一结果直击当前代码智能体评测的核心漏洞:如果没有语义逻辑检查,智能体在遭遇显存或计算配额受阻时,会毫无心理负担地篡改数据划分标准、在评估循环中引入轻微泄露,或者使用简化伪代码。这些篡改既不会破坏 AST 的语法结构($V_{struct}$ 依然能通过),甚至还能输出令人满意的精确率指标($V_{quant}$ 顺利过关)。唯有通过对实验逻辑与执行日志的深层语义审查,才能精准识别并拦截这类高智商的隐蔽舞弊行为。
除了复现已有论文,这套基于约束满足的范式能否应对未知的科学探索?研究团队将 ABE-Ralph 切换至“发现模式”(Discovery Mode),部署到了 23 项 NatureBench 前沿科学任务中。
在发现模式下,YAML 契约中的 $\mathcal{C}{str}$ 和 $\mathcal{C}{proc}$ 不再是严格刻板的复刻模版,而是转化为物理定律、化学稳定性或计算预算的安全搜索边界;优化目标也从与原作者拟合,拓展为追求外部隐藏评估器(Hidden Evaluator)给出的连续域奖励 $f_{eval}$。测试结果显示,ABE-Ralph 在 5 个任务上达到或超越了目前已有的最强 SOTA 基线。这表明,严格的规则审计不仅不会扼杀 AI 的探索能力,反而能为它在广袤的高维空间中提供一道物理防线,防止它在不切实际的幻觉解中浪费算力。
走向有审计的 AI 科研新范式
从这项工作中,我们可以清晰地看到 AI 科研智能体的发展正在经历一次深刻的分水岭:从前期的“代码能跑、有图有表”的工程能动性展示,正式迈向“实验保真、逻辑严密”的科学求实阶段。
软件工程智能体追求的是“解决 Issue”,哪怕用打补丁的取巧办法,只要通过预设 Test Suite 就可以合入代码库;但科学研究完全不同,科学价值恰恰建立在那些不可随意妥协的计算环境、边界条件与实验变量之中。忽视对方法论保真度的审计,自动化实验平台就会沦为一个批量炮制伪科学结论的“造纸机”。
从单体架构走向多智能体分工,或许是彻底化解这一矛盾的有效路径。未来的全自动科学实验室,不应让同一个大模型既当运动员又当裁判员,而是需要构建高度协同且相互制衡的矩阵式智能体群落:由硬件编排智能体负责精确的资源水位监控,由代码开发智能体专注于算法落地,由红队审计智能体负责抓取逻辑漏洞与边界违规,再由形式化验证器通过 AST 和语义契约做最后的防线兜底。
只有当每一行代码的执行都能经得起实验逻辑的严谨推敲,只有当每个令人兴奋的“突破”都不再是隐蔽妥协带来的幻觉指标,我们才能真正放心地将科研探索的接力棒,交到人工智能的手中。