Ant International提出ARC:解耦交互策略,让开放式Agent强化学习回归“公平比较”
ARC: Fair Relative Advantage Comparison in Open-Ended Real-World Interaction
在开放式的人机交互场景中,面对用户的同一个提问,智能体(Agent)往往存在多种合理的响应方式。例如,在用户给出一个模糊的转账或查询需求时,Agent 可以选择直接猜测意图并给出回答,也可以选择在调用外部工具前向用户澄清细节,或者在耗时较长的工具执行过程中主动输出进度更新(Progress Update),亦或是在执行不可逆的高风险操作前要求用户确认。
ArXiv URL:https://arxiv.org/abs/2608.13622v1
这种“同一种情境下允许多种正确交互策略”的开放特性,在带给用户良好体验的同时,却在底层悄然击碎了当前大模型强化学习(尤其是以 GRPO 为代表的组内相对优势强化学习)的核心数学假设。
来自 Ant International(蚂蚁国际)的研究团队在最新论文中指出了这一被长期忽视的痛点:传统组内强化学习(Group-based RL)默认在同一个输入下采样的多个 Rollout 是局部可比的,减去组内均值得到的相对优势主要反映解题质量的高低。但在真实人机交互中,当一个组内的各个 Rollout 分别采纳了“直接回答”、“追问澄清”或“过程汇报”等完全不同的交互策略时,奖励模型(Reward Model)对交互风格、输出长度的固有偏好就会发生介入。这种风格层面的系统性偏差会直接污染组内优势估计,导致算法优化偏向奖励模型主观喜好的交互形式,而非当前上下文真正适宜的交互行为。
作者将这一现象形式化为奖励公平性问题(Reward Fairness Problem),并提出了系统性的解决方案 ARC(Advantage Regularization via Conditioning)。搭配全新设计的流式交互架构 INTER3 以及 86K 级别的策略标注数据集 INTER3-86K,该研究在强化学习层面实现了策略解耦的公平比较,显著提升了 Agent 在 $\tau$-bench 与 $\tau^2$-bench 上的工具调用能力,同时将首字延迟(TTFT)从 4.91 秒大幅降至 1.27 秒。
组内比较为何在开放交互中失效?
在标准 GRPO(Group Relative Policy Optimization)等方法中,模型针对同一个 Prompt $x$ 采样 $N$ 个输出 ${y_1, \ldots, y_N}$,计算其奖励 $r_i$ 并通过中心化处理得到相对优势 $\hat{A}_i = r_i - \bar{r}$。这一机制在数学可验证任务(如代码执行或数学证明)中运转良好,因为最终答案的对错具有极强的确定性。
然而,一旦进入真实交互,奖励模型往往充斥着暴露偏差、长度偏差与风格偏好。本文给出了严格的定义:如果对于相同完成质量但策略不同的两个响应 $y_i, y_j$,奖励模型给出的分值差异大于某个正数 $\delta$,则该奖励模型是不公平的($\delta$-Reward Unfair)。
在数学分析上,作者对中心化优势估计器的方差进行了分解。在标准组采样下,优势估计器的方差包含两部分:
\[\mathrm{Var}[\hat{A}_i] = (\sigma^2_{\text{inter}} + \sigma^2_{\text{intra}})\left(1 - \frac{1}{N}\right)\]其中 $\sigma^2{\text{intra}}$ 代表同种策略内部的质量噪声,而 $\sigma^2{\text{inter}}$ 则是由于跨策略偏见带来的策略间方差(Inter-strategy variance)。这一项的存在意味着:无论在组内如何加大采样数量 $N$,策略间的系统性偏差都无法被消除。策略的多样性与奖励模型的偏好紧紧纠缠在一起,直接导致策略更新方向被带偏。
ARC 的破局点:基于策略条件化的组内方差消除
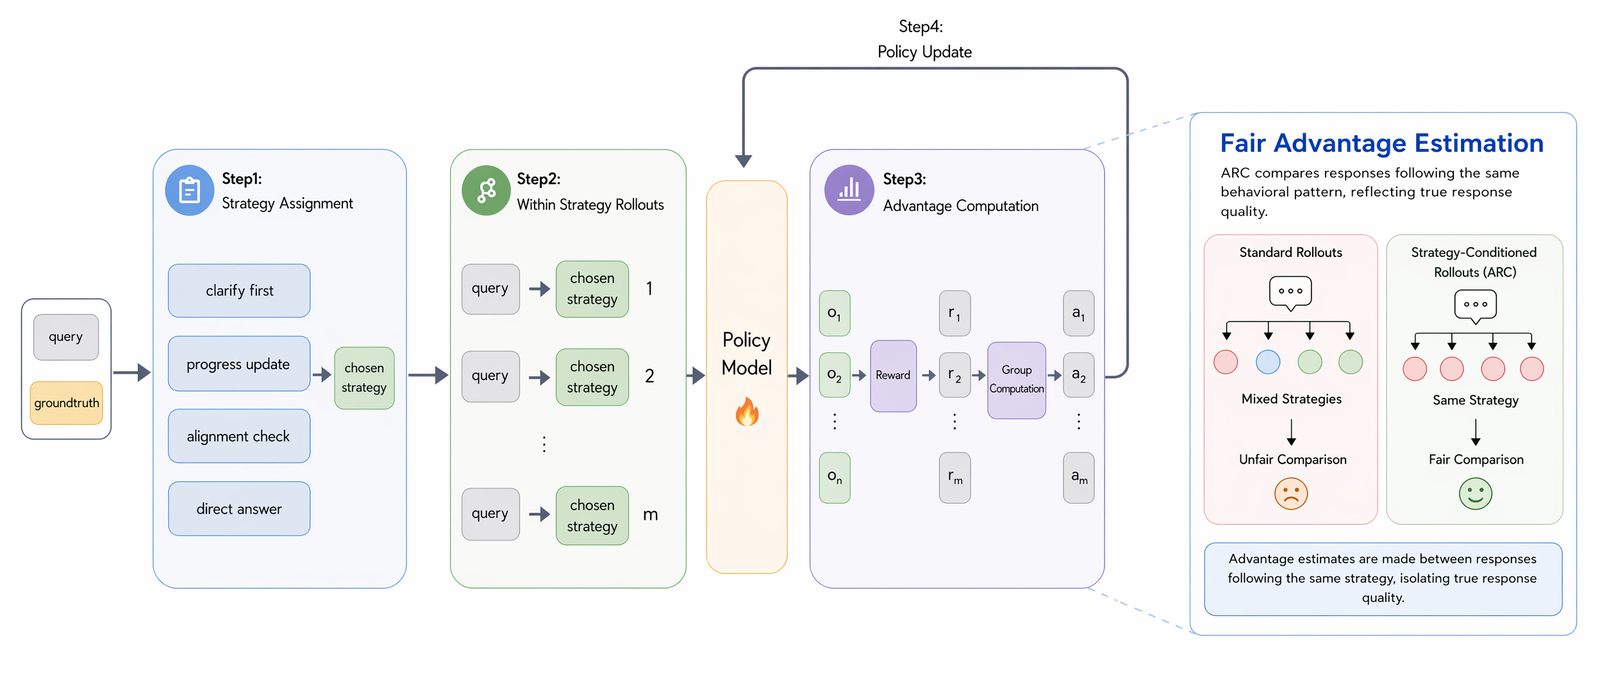
ARC 的核心机制极为精炼:在训练阶段引入策略指令(Strategy Instruction),使每个组内的采样只在同一策略族内展开。
具体而言,对于每个训练样本,ARC 从预设的交互策略分类中为其附加上一个合理的策略指令 $s^$,构建出条件化 Prompt $p^$。随后,策略网络在相同的策略约束下采样 $M$ 个 Rollout。此时,所有候选响应均属于同一策略空间,中心化优势计算便退化为纯粹的策略内部质量对比:
\[\mathrm{Var}[\hat{A}_i \mid s^*] = \sigma^2_{\text{intra}} \cdot \left(1 - \frac{1}{N}\right)\]通过强行约束比较基准,$\sigma^2{\text{inter}}$ 从方差分解中被彻底消除。不仅如此,理论推导表明,ARC 达成相同梯度估计精度 $\varepsilon$ 所需的采样量也从 $O\left(\frac{(\sigma^2{\text{intra}} + \sigma^2{\text{inter}})\log(1/\delta)}{\varepsilon^2}\right)$ 缩减为 $O\left(\frac{\sigma^2{\text{intra}}\log(1/\delta)}{\varepsilon^2}\right)$,大幅减轻了强化学习优化过程中的采样负担。
尤为重要的是,训练时注入的策略指令只是一根“辅助比较支架”。在推理部署阶段,策略指令会被完全移除,模型依靠在公平比较下学到的稳健表征,自主判断在当前上下文中应当采取何种策略。
为了适配复杂的交互生成,ARC 还针对性地引入了通道熵正则化(Entropy Regularization)。由于现代 Agent 需要协同处理隐式推理、工具调用以及面向用户的可见文本,如果缺乏熵惩罚,模型极易陷入“生成大量空洞的格式标签以骗取格式奖励”的局部坍缩。ARC 在损失函数中加入了显式的策略熵奖励项:
\[\mathcal{L}(\theta) = -\sum_{i=1}^{M}\hat{A}_{i}^{(s^*)}\cdot\log\pi_{\theta}(y_{i}^{(s^*)}\vert{}x,s^*) - \beta \cdot H\left(\pi_{\theta}(\cdot\vert{}x,s^*)\right)\]这保证了模型在隐式推理、显式沟通与工具交互的多通道上维持充分的探索活力。
INTER3:分离可见沟通与隐式执行的交互架构
只有比较机制还不够,强化学习还需要优质、真实的交互基质。传统的 Think-then-act 范式必须等待隐式推理和工具调用全部结束才向用户输出内容,首字延迟极高,且完全无法支持交互中途的干预;而传统的 ReAct 模式将思考、动作与沟通混在同一文本流内,难以对交互策略做精细化的解耦与标注。
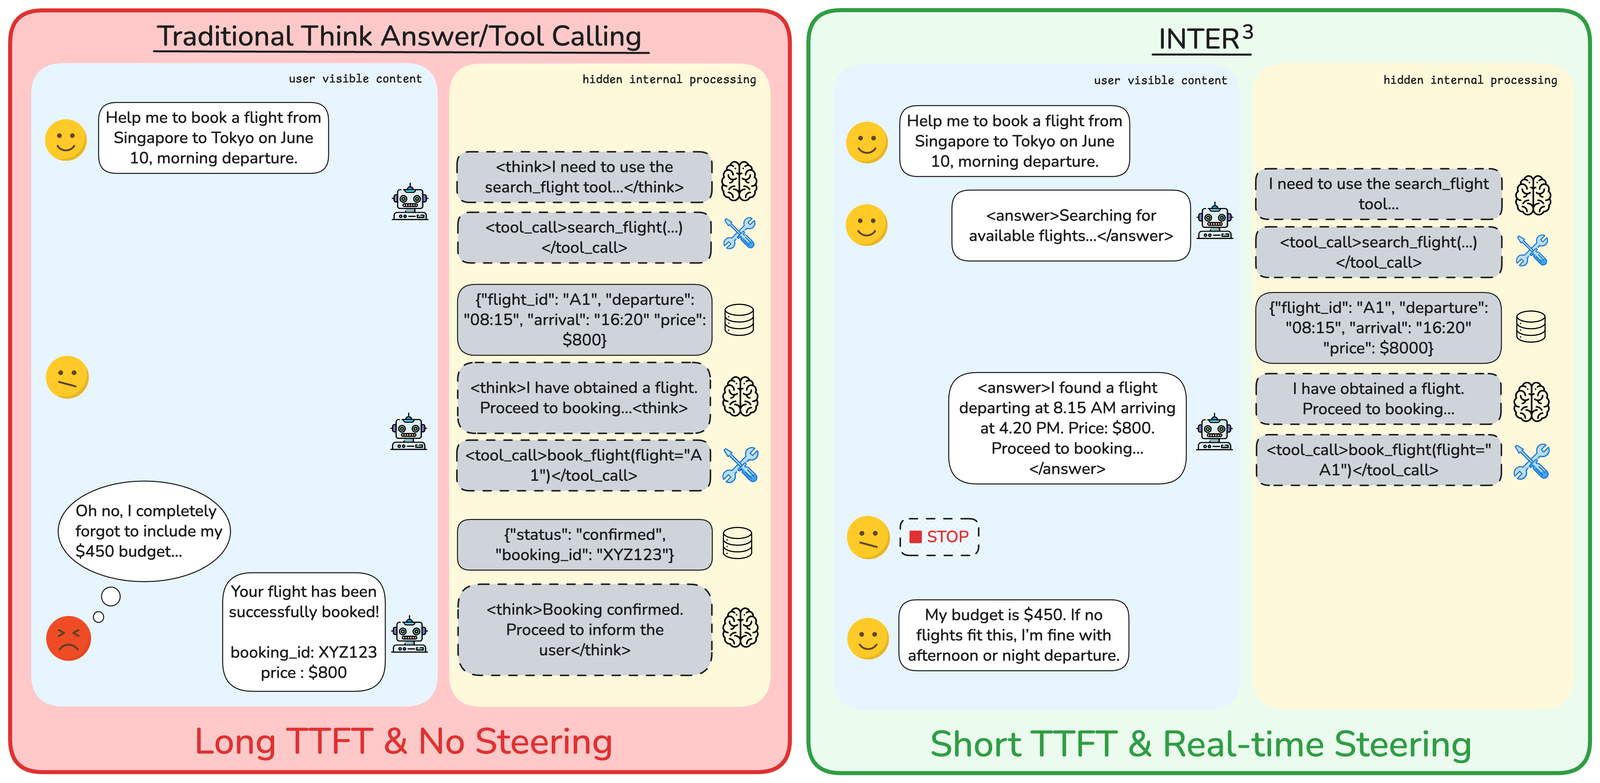
为此,作者构建了 INTER3 交互框架。其核心是将交互通道(Interaction Channel)与执行通道(Execution Channel)彻底分离:
-
标签
<answer>...</answer>之内的内容被作为流式数据直接展示给用户; -
标签之外的内容全部视为潜意识推理(Latent Reasoning);
-
外部工具调用保持结构化,其执行结果异步回传给上下文。
这一设计带来了两重飞跃:首先,在体验上,由于模型在思考与调用工具的同时可以先行向用户抛出进度反馈,首字延迟(TTFT)从原本 Think 模式下的 4.91 秒直接压缩至 1.27 秒,同时赋予了用户中途打断、调整需求的可行性;其次,在工程上,交互策略从一种不可控的文本涌现转变成了可以显式观测、隔离和标注的实体行为,为 ARC 的策略组采样提供了天然的试验场。
依托 INTER3 架构,研究团队采集了全球真实支付平台客服场景下的脱敏在线交互日志,并结合 ToolMind、Musique、KnightsAndKnaves 等公开基准与强教师模型蒸馏,构建了拥有 86.8K 样本的高质量数据集 INTER3-86K(包含 57.9K SFT 数据与 28.9K 带有策略指令标注的 RL 数据)。数据集覆盖四大顶级交互策略:进度更新(Progress Update)、优先澄清(Clarify First)、对齐确认(Alignment Check)与直接回答(Direct Answer),构筑了稳固的训练基础。
实验评测:强化学习动态与泛化表现
研究团队基于 Qwen3-8B(以 no-think 模式微调的 INTER3 SFT Checkpoint 为起点)展开强化学习实验,重点对比了标准 GRPO、PPO、DAPO 等方案。
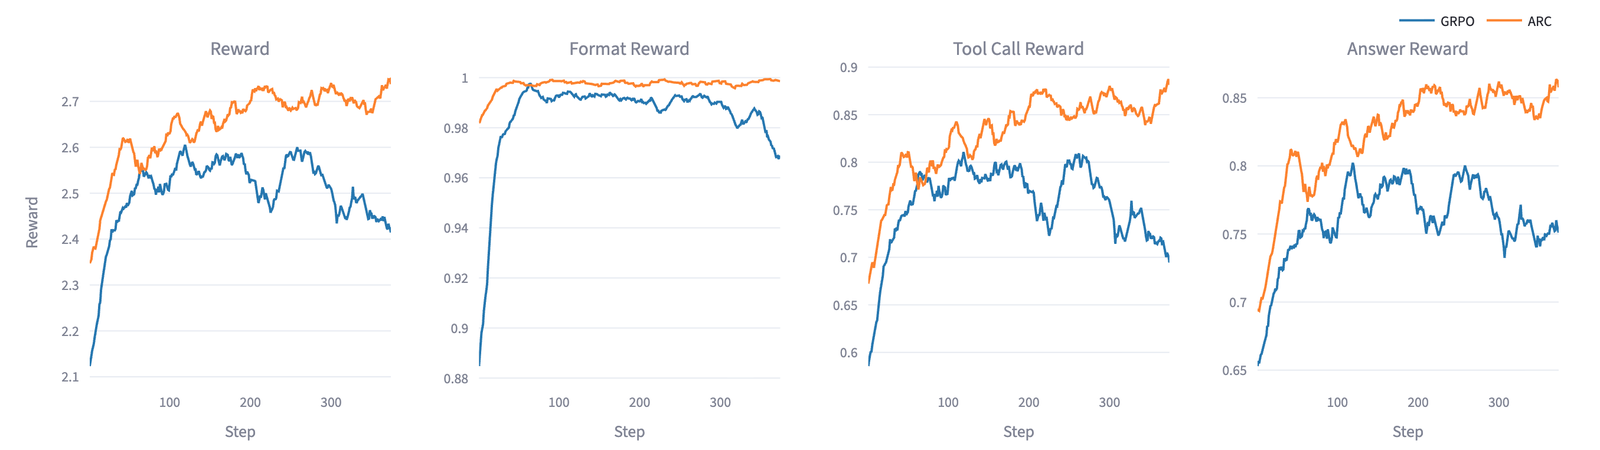
从训练动态(Training Dynamics)的奖励曲线可以看出,标准 GRPO 在训练中程出现明显的性能衰退,尤其在工具调用(Tool-call)与最终回答(Answer)的奖励维度上掉头向下。这是典型的“策略利用奖励模型 Bias 走捷径”的劣化现象。相反,ARC 依托策略内比较,切断了模型通过投机取巧切换低质高分风格的可能,训练曲线全程保持平稳上扬,表现出极强的优化稳健性。
在下游评测中,针对智能体复杂环境交互的代表性基准 $\tau$-bench 与 $\tau^2$-bench,ARC 展现出远超传统基线的鲁棒性:
-
小模型通用性:在 Qwen3-4B 上的消融实验显示,ARC 较 4B no-think 基线在 5 项工具使用任务上的综合均值提升了约 53%,证明其优势来源于强化学习比较信号的净化,而非单纯依靠大模型参数红利。
-
策略缩放效应(Scalability):当训练集从单一策略逐步扩充至包含四大策略族的完整 INTER3 策略套件时,模型跨基准综合均分提升了 36.1%,其中在 $\tau$-bench 和 $\tau^2$-bench 上的性能增幅分别高达 99% 和 71%。
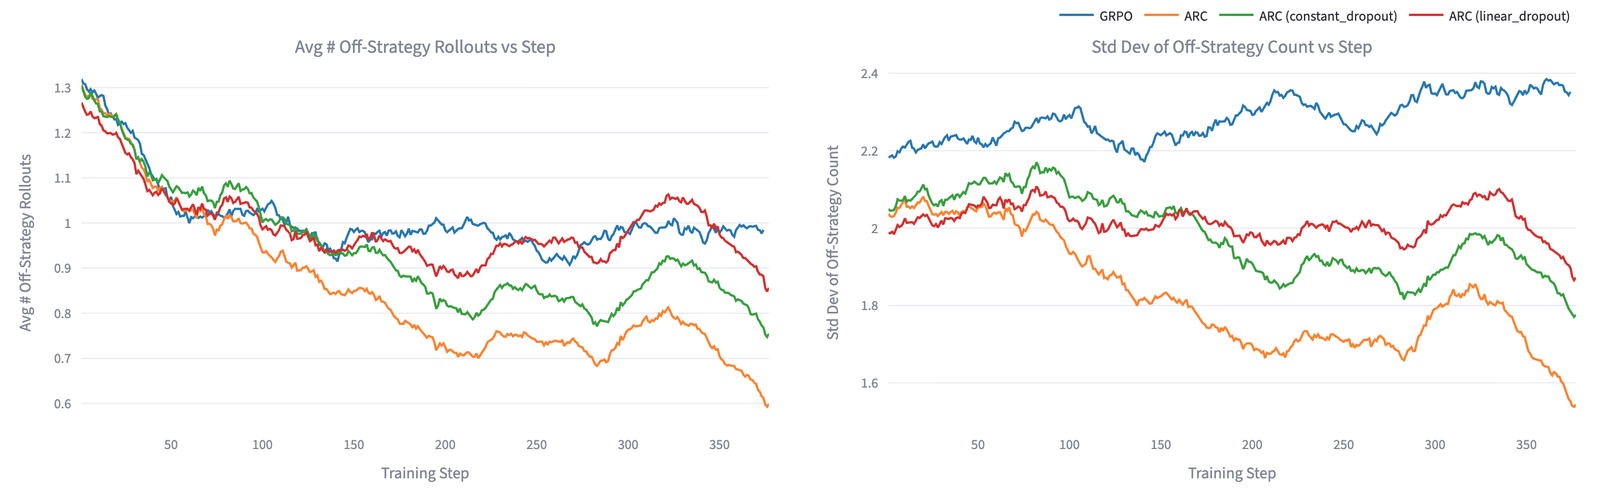
关键设计探讨:策略指令该不该在训练中途退火?
一个极为自然的直觉是:既然推理阶段没有策略指令,训练时是否应该采用课程学习(Curriculum Learning),把策略指令以 Dropout 或线性衰减的方式逐步移除?
论文对此专门做了严谨的对照消融(如上图)。结果出人意料:训练阶段恒定保留策略指令的 Default ARC,在最终推理(无指令)时取得了最佳的工具使用表现和最低的偏离策略方差。反观在训练中途逐步衰减指令(Linear Removal)或恒定丢弃指令(Constant Removal)的设定,其下游 Agent 表现均出现不同程度的下滑。
这一现象极具洞见地揭示了 ARC 的本质:策略指令在训练中扮演的从来不是告诉模型“怎么做”的解题线索(Hint),而是一把约束 Rollout 落在同一个度量衡下的“方差控制器”。过早拆除这一控制器,只会重新引入跨策略的偏见噪声,破坏组内优势的公正性。只要在训练中让模型习惯于在各种策略约束下都能给出高质量表现,部署时即便抽走指令,模型也已建立起根据上下文自主挑选恰当策略的泛化能力。
总结
长期以来,开放式 Agent 强化学习的研究焦点大多集中在如何设计更精巧的奖励函数,或是如何增强探索能力。而蚂蚁国际这项工作指出,如果底层的 Rollout 比较逻辑本身就存在因风格混杂而带来的不公,再复杂的优化器也会被偏见所带偏。
ARC 与 INTER3 的结合,为开放交互场景下的智能体训练提供了一套干净的方法论闭环:用解耦的通道使交互策略可被显式控制,用条件化分组消弭跨风格偏见对优势估计的污染。这项研究对未来 Agent 落地具有重要的参考意义:让人机沟通更加自然、更具响应性的关键,或许并不只是奖励机制的微调,而是从一开始就确保系统在以一种公平的方式审视每一次探索。