AQuA:不是给AI代码自由,而是用密封沙盒把量化夏普比推至2.50
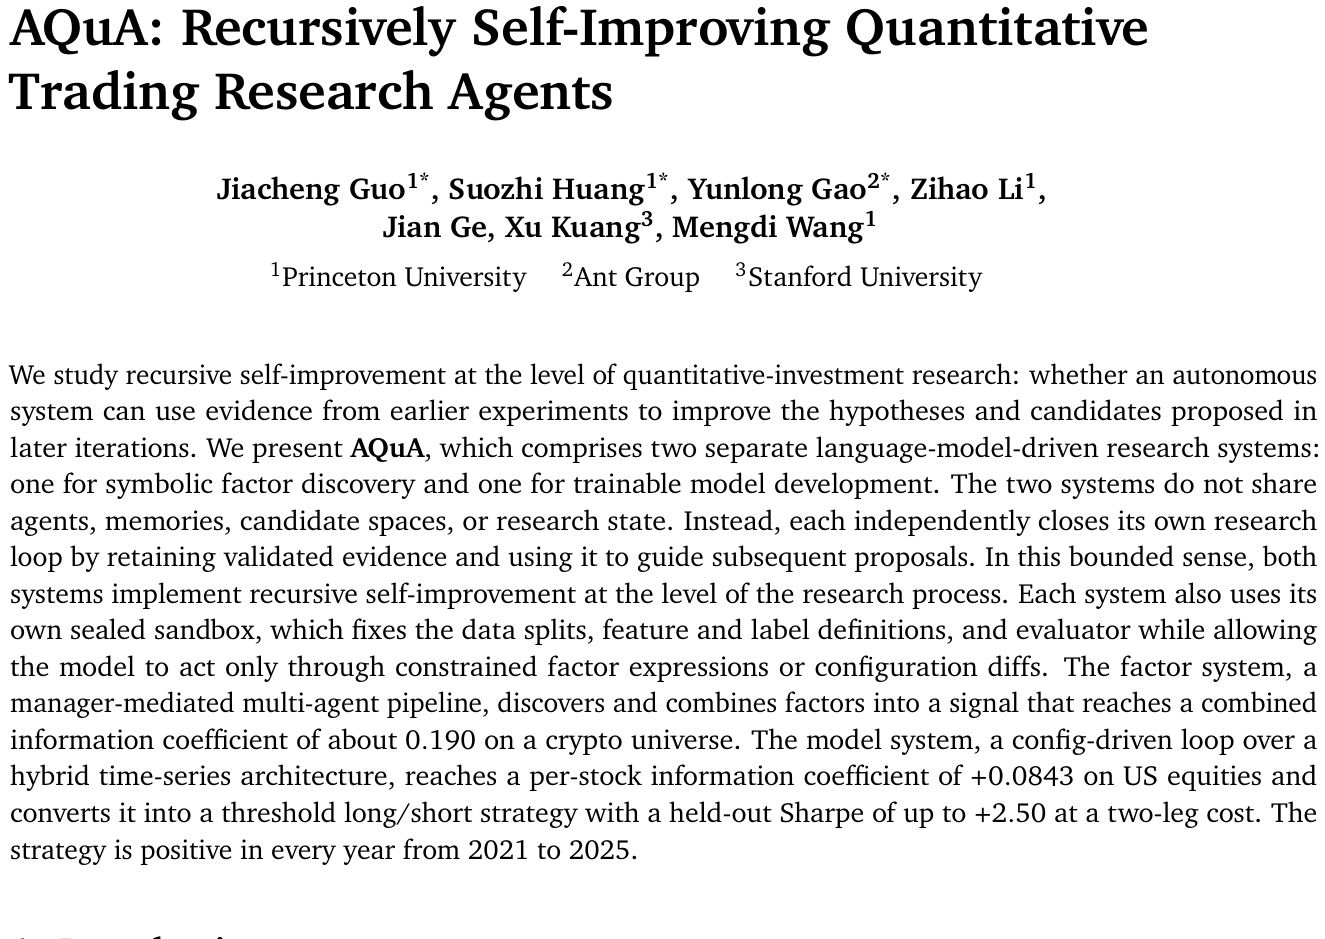
AQuA: Recursively Self-Improving Quantitative Trading Research Agents
在量化投资研究中,最令人生畏的往往不是没有新想法,而是那些在历史回测中表现惊艳、实盘上线却迅速崩溃的策略。导致这种灾难的核心元凶通常是隐蔽的前视偏差(Look-ahead Bias)或数据泄露:一个无意中向未来对齐的特征、一段在测试集上反复试探超参数的脚本,或者一种在全局范围做标准化的数据预处理,都会让回测曲线呈现出虚假的平滑上扬。
ArXiv URL:https://arxiv.org/abs/2608.12841v1
随着大语言模型(LLM)被引入科学发现与量化投研,这一风险被成倍放大。许多基于 Agent 的自动因子挖掘或模型开发框架,往往允许智能体自由编写 Python 脚本、构建特征工程并运行回测。然而,代码生成 Agent 极易写出看似合乎逻辑却带有隐性泄露的逻辑;负责代码审查的 Agent 也经常被这种表面上的语义合理性蒙蔽。更致命的是,一旦系统试图进行“递归自改进”(Recursive Self-Improvement),这种带有未来函数的高分实验就会被存入系统记忆,作为“成功经验”被后续迭代不断借鉴和强化。最终,自改进系统演化的并非真实的阿尔法发现能力,而是一套极其精巧的“偷看未来”技巧。
来自蚂蚁集团、普林斯顿大学与斯坦福大学的研究团队在最新论文中给出了截然不同的解法,他们提出了名为 AQuA(Recursively Self-Improving Quantitative Trading Research Agents)的量化投研系统。AQuA 并没有把代码编写的全部自由交给智能体,而是提出了“不对称自由”(Asymmetric Freedom)的治理架构:通过严密密封的数据流与评估沙盒,彻底剥夺智能体触碰数据切分、标签定义与评测逻辑的物理权限。在严格防泄漏的前提下,AQuA 实现了在投研逻辑层面的递归自改进,在加密资产因子挖掘中实现了约 $0.190$ 的组合信息系数(IC);在美股三十分钟频段的时序预测任务中,其研发的混合架构取得了 $+0.0843$ 的单股 IC,构建的行业中性多空策略在 2021 至 2025 年间斩获了高达 $+2.50$ 的样本外夏普比(Sharpe Ratio),且历年收益均为正。
不对称自由:为什么量化自改进必须密封沙盒?
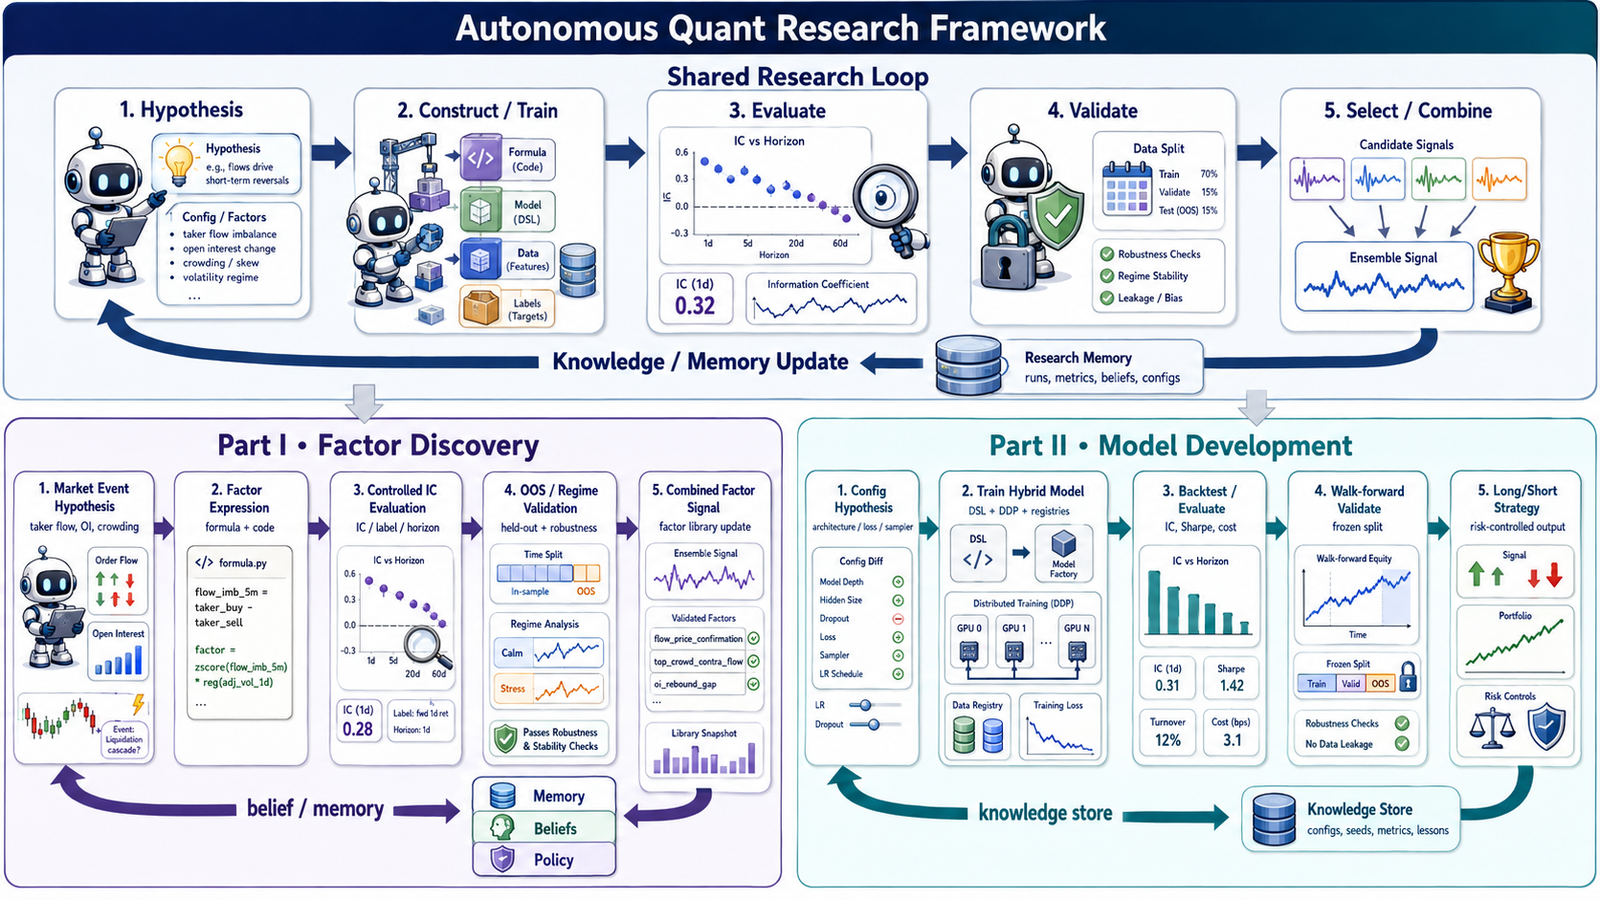
在探讨递归自改进时,人们很容易将“系统改进”与“规则漂移”混淆。如果在迭代过程中,评估指标的口径、样本的切分方式甚至数据的清洗逻辑被模型动态改动,那么所谓的分数攀升毫无学术与生产意义。AQuA 从系统设计的底层确立了一个核心原则:能够进化的只能是研究过程与候选假设,绝不能是衡量成功的标准与数据契约。
AQuA 由两个在物理与逻辑上完全独立的子系统构成:Part I 负责符号因子发现,Part II 负责深度时序模型开发。两个系统之间不共享智能体、不共享经验记忆、不共享搜索空间,也不共享任何投研状态。这种看似保守的物理切分有着极深的技术考量:如果将发现的因子实时反馈给模型进行训练,因子的样本内过拟合就会神不知鬼不觉地渗透进模型训练流程,造成交叉污染。
在每个子系统内部,研究闭环通过形式化的状态演进实现。假设在第 $t$ 轮迭代中,系统的先验知识与研究状态为 $R_t^{(p)}$,系统首先依据该状态采样出新的经济学假设 $H_{t+1}^{(p)}$ 与候选构件 $C_{t+1}^{(p)}$:
\[(H_{t+1}^{(p)}, C_{t+1}^{(p)}) \sim \mathcal{P}_p\left(\cdot \mid R_t^{(p)}\right)\]随后,候选方案被送入密封沙盒进行编译与评估,生成严格可信的实验证据 $E_{t+1}^{(p)}$。这一证据进而驱动系统状态的定向更新:
\[R_{t+1}^{(p)} = \mathcal{U}_p\left(R_t^{(p)}, H_t^{(p)}, C_t^{(p)}, E_t^{(p)}\right)\]为了防止智能体在代码中嵌入未来函数,AQuA 将评估沙盒定义为不可篡改的元组 $\mathcal{S} = (\mathcal{D}, \mathcal{F}, \mathcal{L}, \mathcal{V})$,其中 $\mathcal{D}$ 是冻结的数据划分,$\mathcal{F}$ 与 $\mathcal{L}$ 是预先严格定义的因果特征与标签,$\mathcal{V}$ 是固化的评估器。智能体在整个生命周期内无法输出任何任意的 Python 执行脚本,它所发出的动作被严格限制在一个专门设计的领域特定语言(DSL)空间 $\Theta$ 内:
\[s_k = \mathcal{V}\big(\mathcal{C}(\theta_k);\, \mathcal{S}\big),\qquad \theta_k \in \Theta\]在因子端,DSL 仅包含规范的截面算子、时间序列滚动算子和数学映射,例如 $\operatorname{rank}(\operatorname{corr}(r^{1d}, v^{1d}, 20))$;在模型端,DSL 则由配置差异(Config Diff)构成,只允许模型在预设的算子库、损失函数库和优化器注册表中组合参数。这种结构化的不对称约束,在数学和工程双重维度杜绝了一切未来信息的泄露路径。
Part I:管理机制驱动的符号因子挖掘与三层记忆演进
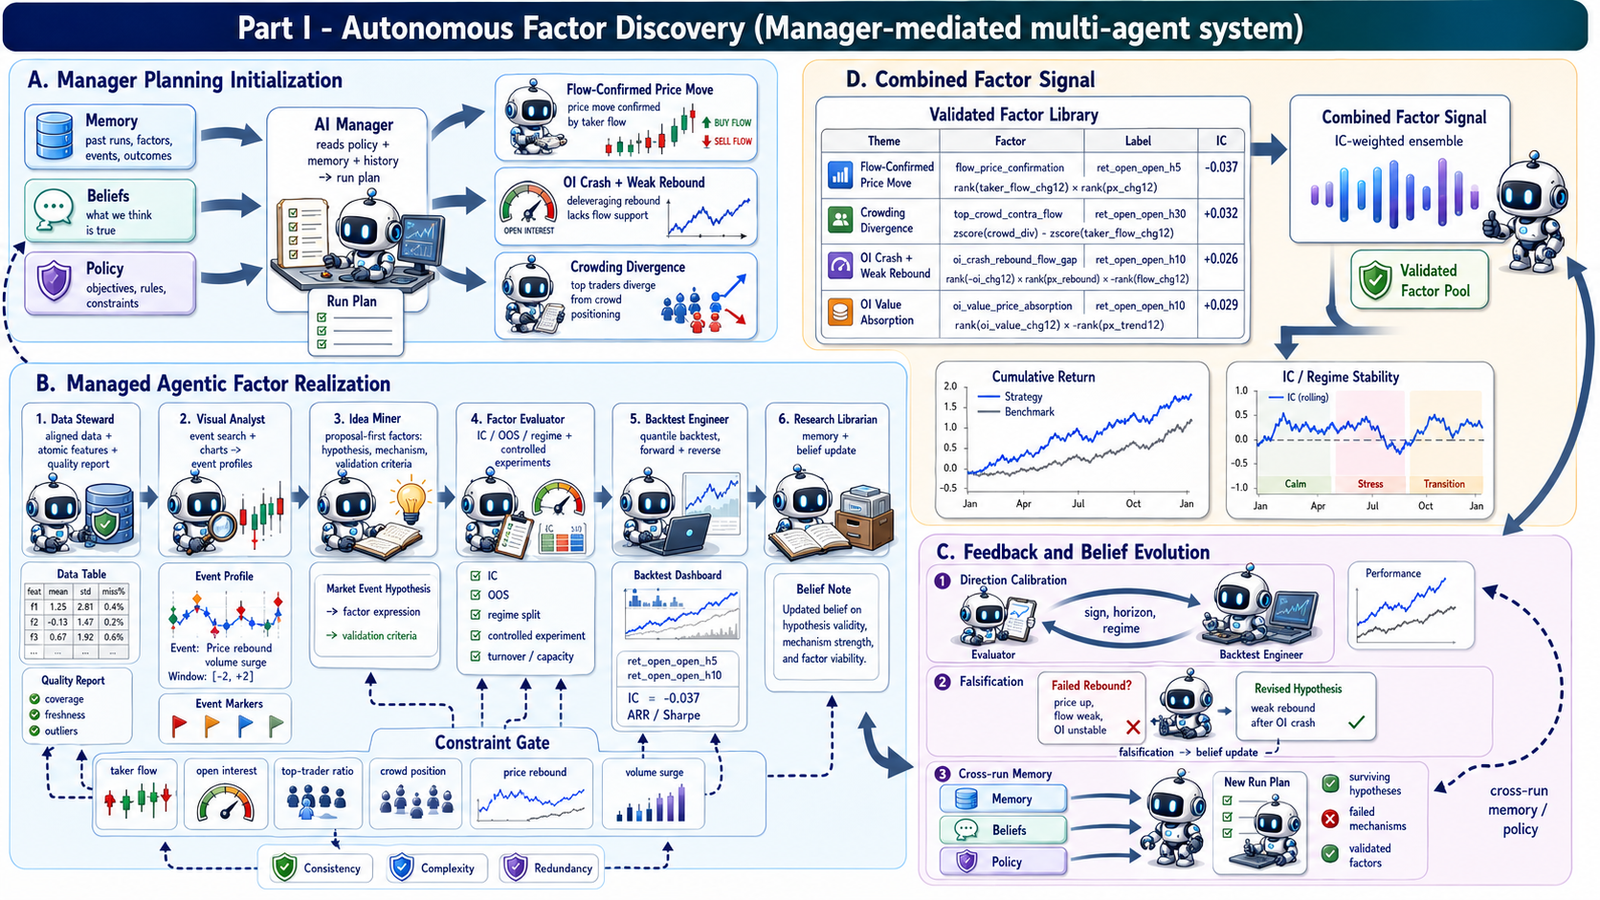
在 Part I 中,AQuA 构建了一个面向高频与日内量化因子的多智能体协同流水线。很多基于 LLM 的因子挖掘方法倾向于直接让模型“头脑风暴”生成公式,这种做法产出的算子组合极易落入无意义的数据挖掘陷阱。AQuA 采取了“先有经济学假说,后有数学表达”的逆向严密逻辑。
整个系统由一名 AI 管理者(AI Manager)作为中心枢纽进行协调,下游设立了六名职责分明的专家智能体。各个专业智能体之间严禁私下通信,所有信息交接与任务派发全部必须穿透 AI Manager,确保实验过程完全可审计、可复现。
流水线的执行展现了高度的专业分工:
-
数据管家(Data Steward):负责加载并因果对齐行情数据,产出严格的数据质量报告与基础原子特征。
-
图表/事件分析师(Visual Analyst):在历史行情序列中检索指定类型的微观市场结构事件(如持仓量断崖、极端清算、流动性瞬时枯竭),并将高维时序浓缩为事件剖面(Event Profiles)。
-
灵感挖掘者(Idea Miner):根据事件剖面提炼经济学假说,明确叙述市场微观逻辑、预期预测方向以及可被证伪的条件,随后将其翻译为受限 DSL 因子表达式。
-
因子评估器(Factor Evaluator):在密封沙盒中计算因子的单变量信息系数、自相关性与多空分位收益。
-
回测工程师(Backtest Engineer):执行方向校准,同时构建正向与反向的分位数投资组合。这一步非常关键:在现实交易中,某些公式具有极高的预测能力,但其初始假设的符号方向可能因微观博弈机制而相反,方向校准机制保留了这类有效信号。
-
研究图书管理员(Research Librarian):负责跨轮次学习的记忆沉淀。它将每一轮经过检验的有效机制、失败案例、经验信念以结构化方式归档入库。
通过这种设计,Part I 形成了三层嵌套的反馈回路:在最内层,回测工程师校准因子的交易方向;在单轮次中,未达标的因子结果会立即更新当前的信念状态,促使系统调整该特定事件的刻画维度;在跨轮次层面,AI Manager 在开启下一轮探索前,首先读取全局研究记忆,继承以往关于“哪些微观机制已被证实有效、哪些反复失败”的先验知识。
例如,在论文披露的一组真实迭代中,系统探索了“未平仓合约(Open Interest)骤降后的弱价格反弹是否预示反转”。Visual Analyst 提取了真实的踩踏去杠杆模式,Idea Miner 提出假说:如果价格反弹并未伴随积极的主动买盘(Taker Flow),说明反弹仅为流动性空洞引起的被动修复,后市大概率二次探底。该假说被编译成包含持仓量衰减与主动成交失衡的因子表达式后,在事件窗口内测得了 $0.026$ 至 $0.037$ 的单因子 IC。随着多轮迭代的记忆累积与机制融合,系统在加密资产 5 分钟级别的高频信号池中,最终将组合因子的信息系数提升至约 $0.190$。
Part II:基于配置 Diff 的混合深度时序模型研发
如果说符号因子挖掘考验的是对市场博弈直觉的形式化提炼,那么深度时序模型的开发则是对算子组合、表征学习与训练正则化策略的全面工程寻优。Part II 将这一过程同样抽象为自主递归闭环。
在模型开发闭环中,智能体不需要从零编写 PyTorch 训练代码,它的每次研究动作都是对基础配置的一份“Diff 文件”。一份配置差异只包含架构、采样器、损失函数或优化器层面的离散修改。由于底层的特征工程与训练测试划分已完全固化在密封沙盒中,配置 Diff 的设计使得任意两个模型变体之间具有绝对的可比性——性能的变动唯一来源于配置的修改,杜绝了一切由于特征泄露或随意洗牌引入的干扰。
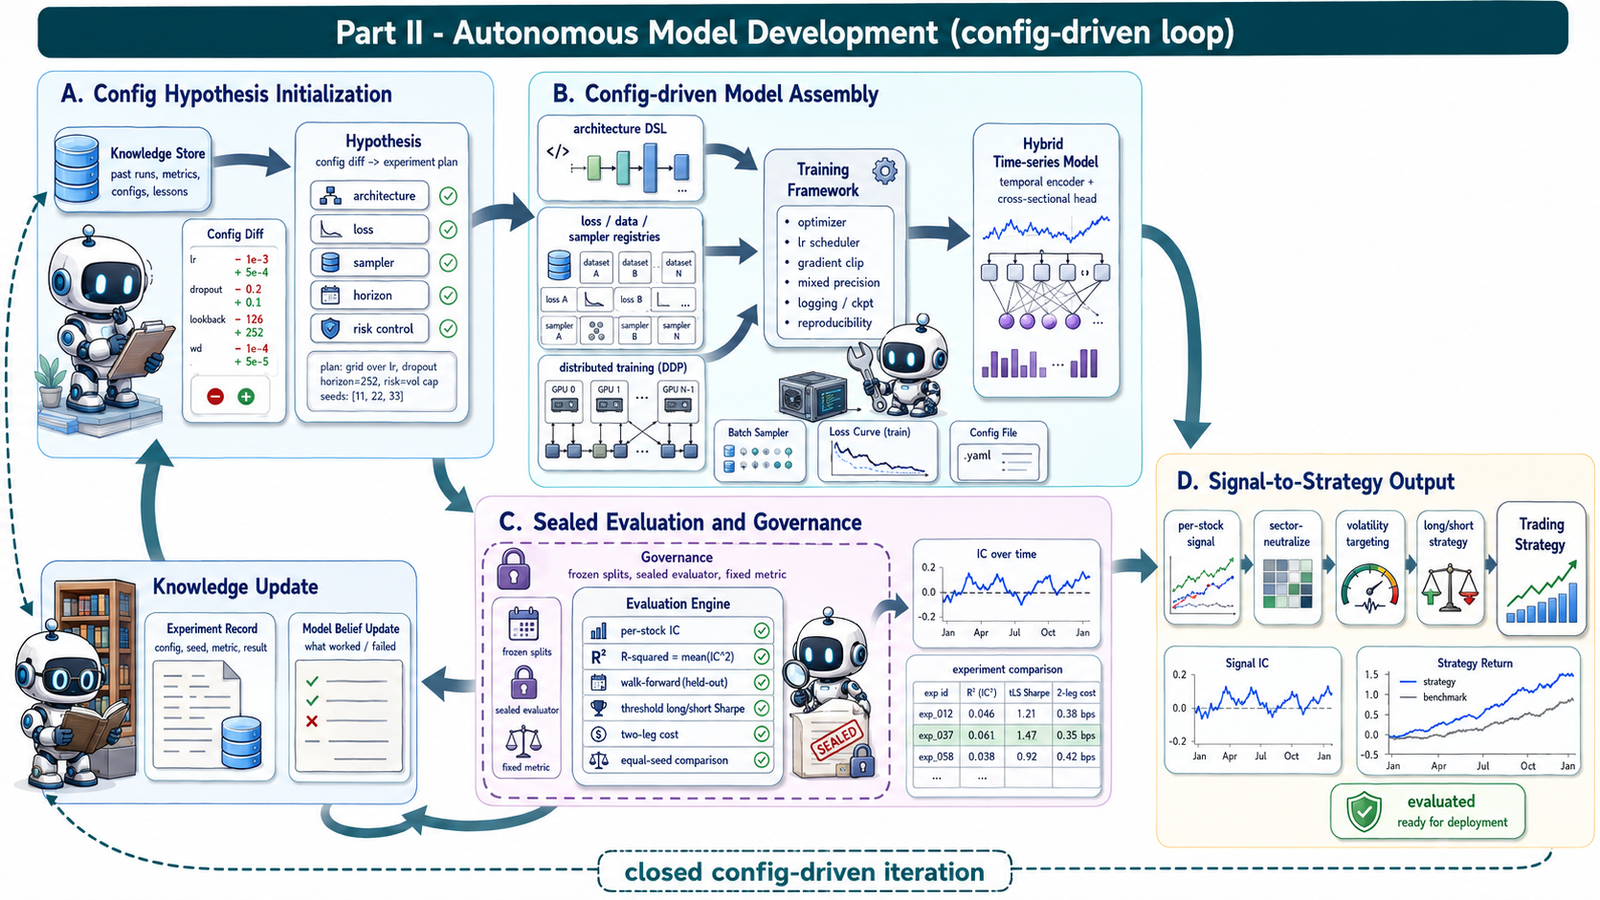
在模型架构的选择上,AQuA 设计了一套高度可扩展的混合时间序列预测架构。该架构旨在平衡高频局部微观动态的捕捉能力与长序列全局演化的建模能力,整体分为四个核心阶段:
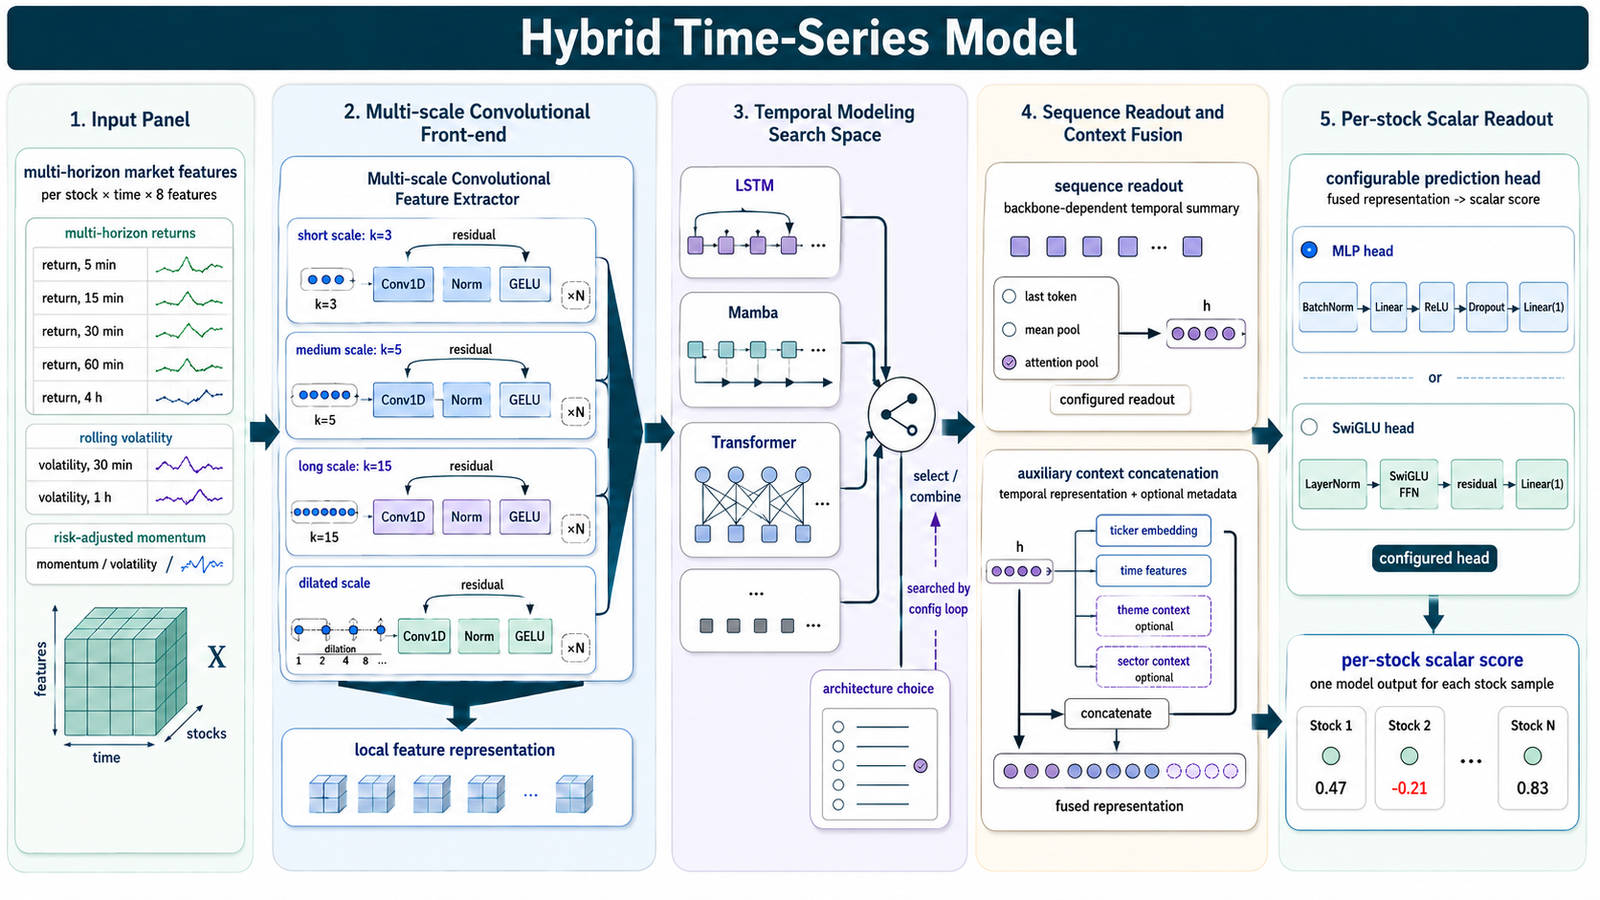
首先,多尺度卷积前端针对输入的纯价量序列(多尺度收益率、波动率、风险调整动量),利用多组不同卷积核尺寸与膨胀率(Dilation)的一维卷积模块,抽取股票在不同微观时间颗粒度上的局部价量模式。
其次,提取到的局部表征被送入可配置时序主干。在 AQuA 的注册表中,主干模型涵盖了长短期记忆网络(LSTM)、现代状态空间模型(Mamba)以及多头注意力机制(Transformer)。在本项研究的核心实验中,系统最终收敛至基于注意力机制的时序建模路径。
随后,模型在时间维度与截面维度(Cross-sectional)进行信息交叉混合,并结合门控机制(Gating Mechanism)进行自适应表征融合。最后,序列池化层将表征压缩为定维向量,并注入股票代码嵌入(Ticker Embeddings)、时间上下文等先验信息,交由 SwiGLU 或 MLP 预测头输出对个股未来 30 分钟收益率的标量预测值。
为了验证 Part II 的鲁棒性,研究团队设立了极其严苛的实证切分:模型在 2010 至 2019 年的美股日内数据上进行训练;将 2020 年全年设为完全不触碰的隔离缓冲期(Embargo Gap),防止由于极端市场波动或自相关性污染后续数据;最终的评价完全在 2021 至 2025 年的盲测窗口上执行。早停机制和超参数选择仅依据训练集末端的内部验证集,测试集自始至终未对训练过程提供任何反向信号。
实证剖析:单股 IC 与生产级多空夏普比的表现
在 2021 至 2025 年长达四年的样本外美股测试集中,AQuA 的混合时序架构展现出了优异的预测稳定性。对于高噪声的日内 30 分钟预测任务而言,横截面上的预测难度极高。
在相同的数据管线与密封评估器下,传统时序基准模型如 GRU 取得了 $+0.0613$ 的单股原始信息系数(Raw IC),而 AQuA 迭代出的混合架构将单股 IC 推升至 $+0.0843$,实现了 $+0.0230$ 的绝对增益与高达 $37.5\%$ 的相对提升。这表明多尺度卷积前端与时序注意力的融合,确实从原始量价的微观结构中抽离出了更具持久性的预测信号。
然而,在量化投资实践中,高 IC 并不自动等同于能够盈利的实盘策略。未经验证的原始预测往往充斥着共性因子暴露(如大盘风格或特定行业 beta)以及非线性的交易摩擦成本。AQuA 展现了如何将纯预测得分转化为符合机构交易规范的实际多空策略:
第一步是行业中性化(Sector Neutralization)。纯模型打分往往会系统性偏向某些高波动行业。通过在截面上剥离行业因子的共同敞口,模型强迫投资组合只依靠纯粹的个股特异性 Alpha 获取收益。这一步直接将样本外的持仓多空夏普比提振到了 $+2.15$。更为关键的是,训练集上的夏普比与样本外夏普比几乎持平,这强有力地印证了中性化步骤并没有引发任何样本外过拟合。
第二步是引入因果波动率目标化(Volatility Targeting Overlay)。在实盘运作中,市场整体波动率的剧烈起伏会放大回撤。AQuA 设计了一套纯因果的在线波动率缩放层:仅利用历史回溯窗口计算投资组合的实现波动率,动态缩放每日的总风险敞口,使策略波动率平滑地向历史扩展中位数靠拢。在计入双边 $2\,\mathrm{bps}$ 的真实滑点与手续费成本后,策略最终的样本外夏普比达到了 $+2.50$。
即使施加最为极端的防御性测试——完全因果的前向滚动步进评估(Walk-forward Evaluation),即每一个策略超参数与分位阈值只能依赖测试时间节点之前的历史数据进行拟合与冻结,策略的样本外夏普比依然坚挺在 $+2.00$。
从 2021 至 2025 年的逐年日历表现来看,策略在每一年均实现了正收益:2021 年夏普比为 $+1.7$;在标普 500 与纳斯达克遭遇重创、大量成长股大幅下挫的 2022 年大熊市中,策略斩获了高达 $+3.5$ 的年度夏普比,展现了市场中性策略在流动性枯竭行情中的防守反击能力;而在随后市场强劲反弹与风格快速轮动的 2023、2024 与 2025 年,策略夏普比分别达到 $+1.9$、$+1.8$ 与 $+2.7$。这种跨越牛熊周期的平稳收益曲线,排除了策略收益仅押注于某一种特定宏观风格的嫌疑。
结语与深层启示:AI 量化自主研究的边界在哪里?
AQuA 的工作为大语言模型与自主智能体在专业科学研究中的落地提供了极具价值的范式参考。长期以来,关于“AI 科研智能体”的探索往往走向两个极端:要么仅仅将 LLM 当作文本总结工具,要么赋予其过宽的编码权限,最终使系统在自我循环的虚假反馈中迷失方向。
AQuA 的成功揭示了一个更为成熟的系统论观点:在充满噪声与对抗性的科研探索中,智能体最擅长的是在先验知识引导下的离散假设空间探索,而最薄弱的则是对隐式科学规范(如因果律、无泄漏原则)的自律。 因此,最强大的投研系统不是放任 AI 肆意生成整套系统的“黑箱超级智能”,而是由人类架构师预先用防漏沙盒定义好因果边界、评估契约与表达空间,再让智能体在这一牢不可破的牢笼之内,以极高的效率与递归累积的记忆进行无休止的“假设—验证—演化”。
当然,AQuA 目前依然存在其边界。因子挖掘与模型研发之所以在系统中保持物理隔离,正是因为一旦将两者打通,因子选择的隐性偏差就会迅速污染时序模型的输入,如何以数学上可证明的无偏方式实现两者的端到端安全耦合,是未来值得探索的方向;此外,测试集的绝对物理隔离在工程实践中依然依赖于研发团队的组织治理纪律。
但不可否认,AQuA 证明了真正具有自改进能力的量化 Agent 是可行的。它不依靠华丽的未经约束的代码生成,而是依靠严谨的评估防线、明确的经济学因果逻辑与结构化的持续经验记忆,在最考验策略成色的金融深水区,建立起了真正经得起时间检验的超额收益发现机制。