WorldTrace:破解视频世界模型长程遗忘,免训练让场景召回提升19.5%
Addressable Memory for Video World Models
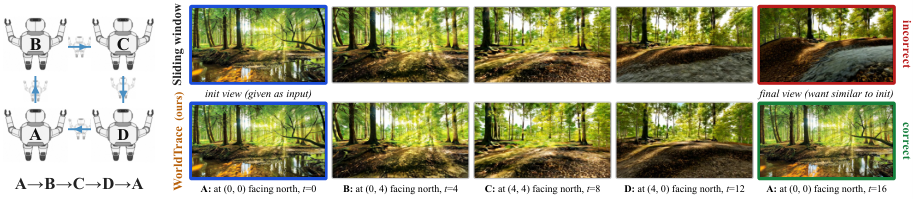
在构建交互式虚拟世界与具身智能仿真的道路上,视频世界模型(Video World Models)被寄予厚望。从生成能够实时操控的游戏画面,到为机器人提供高保真的闭环物理模拟,核心愿景都在于让智能体能够自由漫游、探索未知的视界,并在未来的某一刻重新折返。然而,当真正让模型执行长程漫游时,一个根本性的断裂迅速暴露出来:一旦智能体绕了一大圈回到原点,原本见过的房间、街道或标志性物体,往往会被重构为一个“看似合理却截然不同”的新场景。
ArXiv URL:https://arxiv.org/abs/2608.07408v1
这种现象被称为视觉持久性(Visual Persistence)的崩塌。来自 NVIDIA、普林斯顿大学、多伦多大学和 Vector Institute 的研究团队指出了这一问题的深层机制:在自回归视频世界模型中,随着生成步数超出训练上下文长度,模型的记忆瓶颈并不仅仅是“存不下历史帧”,而是存储的内容不再可寻址(Addressable),同时在压缩过程中信息遭到了不可逆的相位污染(Informativeness corrupted)。
为此,研究团队提出了完全免训练的长程记忆框架 WorldTrace,以及专门用于评估场景回访一致性的基准测试 LoopBench。在不改变原有模型权重、不增加显存峰值的前提下,WorldTrace 实现了 15.5% 的时序一致性提升,并将场景回访的情节召回率提高了 19.5%。这项研究为长期困扰生成式世界模型的时空一致性问题提供了一条低成本、高通用性的工程与理论突破口。
为什么世界模型会“转头就忘”?
现代自回归视频生成架构主要依靠 Key-Value(KV)缓存来传递上下文信息。每一组新生成的视频块(Chunk),都需要跨越缓存中的历史帧进行因果注意力计算。最理想的状态是保留自探索开始以来的每一个历史 Token,但这会导致 KV 缓存随时间线性膨胀,迅速撑爆 GPU 显存。
直觉上的妥协方案是引入滑动窗口(Sliding Window)或者进行缓存压缩,将无限增长的历史压缩进固定容量的记忆槽位中。然而,实验表明哪怕为模型保留了过去的内容,一旦滚动的时序步数越过了模型在预训练时见过的最大上下文长度 $\Delta t_{\mathrm{train}}$,模型依然会迅速发生记忆解构。
这一崩溃背后存在两个环环相扣的根本症结:
其一是相对位置编码的分布外失效。主流视频生成模型普遍依赖旋转位置编码(Rotary Positional Embeddings, RoPE)来注入时间步信息。在注意力机制中,当前 Query 与历史 Key 之间的交互强度高度依赖于两者的时序索引差值 $\delta_{q,k} = q - k$。当生成任务持续进行,远期历史帧与当前帧的时间跨度不可避免地突破了 $\Delta t_{\mathrm{train}}$。此时,查询向量所面对的时间偏差完全处于预训练分布之外(Out-of-Distribution, OOD)。注意力机制不再能够准确聚焦于这些远距离 Token,即便历史信息完好地躺在显存里,模型在数学层面上也已经“无法寻址”这些内容。
其二是频域空间内的相位抵消。在常规处理中,研究者常常尝试对旧的 Key 向量做均值池化或低秩融合以压缩空间。但在 RoPE 机制下,每一个 Key 向量都在频域上被施加了对应其时间戳的旋转变换:
\[\bar{K}_{\mathrm{naive}}^{f} = \frac{1}{M}\sum_{m=1}^{M} R(\theta_{f} t_{m}) K_{m}^{f}\]式中 $K_{m}^{f}$ 代表第 $m$ 帧在频率分量 $f$ 下的无偏基准向量,$R(\theta_{f} t_{m})$ 为其旋转算子。当被压缩的多帧时间戳相距甚远时,它们在复平面上的相位角差极大,直接相加平均会导致不同方向的向量在不同频率上互相干涉抵消。这种“在旋转后空间进行粗暴平均”的操作,抹平了高频特征,让压缩后的记忆摘要退化为一团没有表征能力的噪声。
换言之,过往方案在位置寻址与内容压缩两个维度上双重失守:位置越界让远期记忆变成了不可读取的“死数据”,而粗暴的压缩算法又把存下来的内容变成了“假数据”。
WorldTrace:为记忆赋予固定排位的“虚拟坐标”
要恢复长程视觉持久性,必须同时确保两点:记忆必须落在注意力机制能够精确解析的有效区间内;记忆的内容在凝练之后依然保留原始的几何与视觉特征。WorldTrace 的核心构思,正是将显存缓存拆分为近程高保真窗口与远程结构化摘要槽位,并用一种巧妙的虚拟索引机制重新统一它们。
整个缓存被划分为大小为 $N_r$ 的近程直写窗口 $\mathcal{R}$ 和大小为 $N_s$ 的远期摘要缓存 $\mathcal{S}$,总缓存长度维持在模型原生训练长度 $L_{\mathrm{attn}} = N_s + N_r$ 范围内。关键的破局点在于虚拟位置分配(Slot-Rank Virtual Position Assignment)。
针对远期摘要槽位 $s$(其中 $s = 0, \ldots, N_s - 1$),WorldTrace 并不直接使用历史帧发生时的绝对时间戳,而是为其指派一个与当前查询帧 $q$ 保持恒定相对距离的虚拟时间步:
\[t_{s}^{v} = q - (L_{\mathrm{attn}} - 1 - s)\]这一设计的深意在于,它将每个摘要槽位的相对距离硬性锚定在当前时间点之前的合法窗口内。无论自回归模拟进行了几千帧还是上万帧,$t_s^v$ 距离 $q$ 的位移量完全由该槽位在记忆结构中的排位(Rank)决定,绝不会发生越界。
此前有研究尝试使用“块相对截断”(Block-relative RoPE)来解决长视频生成问题,即强制将所有超出训练窗口的历史偏移截断在 $\Delta t_{\mathrm{train}}$。但在压缩缓存场景下,这种简单粗暴的截断会引发严重的“槽位坍塌”(Slot Collapse):所有超过安全时距的远期记忆槽,其虚拟位置全都被强制拍平在同一个位置,使得模型无法在空间和语义上区分不同的摘要。而 WorldTrace 依照槽位排位自定间隔,确保了任意步长下所有 $N_s$ 个摘要槽彼此独立、互不重叠且时刻可被查询。
在解决了寻址路径之后,为了防止频域相位相互抵消,WorldTrace 强制所有压缩计算均在规范化空间(Canonical Space)进行。即在存入历史或聚合特征前,先施加反向旋转算子 $R(-\theta_f t_m)$ 剥离其时间相位,还原出与时间无关的静态 Key;随后完成特定策略的压缩提炼,最后仅在将其注入特定虚拟槽位 $t_s^v$ 时,才按目标槽位的相位实施单次即时重旋转。
场与地标:兼顾时序平滑与情节召回
在确立了可寻址架构之后,核心问题转化为:有限的 $N_s$ 个槽位到底应该记住什么?
论文从理论上将这一问题重构为结构化稀疏注意力(Structured Sparse Attention)对全局全注意力(Full Attention)的最优逼近。如果将历史帧的压缩映射视作一个投影矩阵 $P \in \mathbb{R}^{L \times T}$,那么选择不同的压缩权重本质上就是在求解一个针对注意力权重的非负矩阵分解(NMF)。研究团队观察到,在长程探索中,未来的注意力查询主要分为两类截然不同的形态:一种是关注全局背景与运动演进的平滑扩散式查询,另一种是回到某个特定节点时的强聚焦单点查询。针对这两种需求,WorldTrace 衍生出了两套互补的记忆写入算子。
第一种是面向连续时序一致性的 WorldTrace-Field。它将远期历史按时间先后均匀划分为连续的分组,每个分组对应一个摘要槽位。在规范化空间内,该分组覆盖的所有源帧 Key 向量被进行无偏算术平均:
\[K_{\mathrm{field}}^{f}(t^{v}) = R(\theta_{f} t^{v}) \left[ \frac{1}{M}\sum_{m=1}^{M} R(-\theta_{f} t_{m}) K_{t_{m}}^{f} \right]\]这种做法提供了一个强有力的理论性质:均值注意力保持(Mean Attention Preservation)。数学上可以严格证明,在进入 Softmax 之前,当前查询与这一重构 Key 的内积,精确等于该查询对这组原始帧各自分别计算内积后的算术平均值。这意味着模型在观察该摘要时,不会因为距离远近而无端放大或抑制该时间段的语义强度。
为了防止多轮滚动平均引发数值耗散,WorldTrace-Field 并没有在显存中做迭代式的滑动更新,而是将滑出近程窗口的源帧规范化 Key 转储在主机内存(Host RAM)中。每当边界滑动时,算法直接基于原始帧重新生成各分组的准确平均值。这种设计巧妙地利用了充足的系统内存,将 GPU 显存占用严格锁定在与普通滑动窗口相同的基准线上。
第二种则是专为场景回访打造的 WorldTrace-Landmark。人类在漫游时,对环境的长期记忆往往锚定在关键的转折点和门廊上。WorldTrace-Landmark 引入了场景入口检测机制:通过实时追踪相邻帧在规范化 Key 空间中的余弦距离变化,一旦检测到距离出现突增(超过动态阈值 $\tau$),便判定发生了一个场景切变或空间拐点,并将该时刻的帧打上“地标”(Landmark)标签。
地标帧的内容不会被任何平均算子模糊化,而是以原始的高保真状态直接存入摘要槽位。在长程推理中,随着新的地标不断涌现,最古老的地标将按 FIFO 原则逐级退场。更关键的是,研究团队采用了冻结规范化 Key(Frozen Landmark Keys)的设计:地标在被记录的瞬间,其规范化特征便被一次性固化:
\[K_{\mathrm{land}}^{f}(t_{s}^{v}) = R(\theta_{f} t_{s}^{v}) \left[ R(-\theta_{f} t_{\ell^{*}}) K_{t_{\ell^{*}}}^{f} \right]\]在后续的槽位位移中,系统只按最新槽位赋予的 $t_s^v$ 进行单次纯净旋转,坚决杜绝了反复“反旋转-重旋转”在低精度(如 bfloat16)环境下因浮点截断误差快速累积导致的表示漂移。
LoopBench:检验记忆持久性的严苛试炼
为了系统验证长程环境下的视觉持久性,本文构建了全新的评测协议 LoopBench。传统的视频生成评估多局限于短视频续写或开环外推,无法有效衡量模型对先前探索环境的长期保留能力。
LoopBench 模拟了智能体在三维复杂环境中的典型拓扑闭环:智能体从初始场景 A 出发,经过长距离的转向与漫游,依次穿过途经点 B、C、D,最终回到场景 A 的精确起始视角。如果在绕行数十秒后,模型重新生成的场景 A 依然能够完美再现最初的墙体纹理、陈设几何与光影细节,就证明模型真正具备了情节记忆能力,而非凭空虚构。
实验在开源且具备代表性的先进视频生成基准模型上展开。结果显示,无论是完全基于滑动窗口的方法,还是此前单纯利用双流指数移动平均(EMA)压缩的模型,在面对长程闭环时都出现了严重的记忆衰退。滑动窗口方案在离开场景数秒之后,其生成的回归画面便彻底失去了最初的结构轮廓;即便是使用注意力保留算法的 Baseline,也因为无法在超出长度的相对时间下精确定位,使得场景细节不可逆地退化。
而 WorldTrace 展示出了非凡的鲁棒性:
在时序平滑度与整体连贯性指标上,引入无偏频域聚合的 WorldTrace-Field 带来了 15.5% 的时间一致性提升,生成的长视频在过渡阶段显著减少了闪烁与内容突变。
而在 LoopBench 的长程回归闭环测试中,搭载冻结地标机制的 WorldTrace-Landmark 更是取得了决定性的优势,情节召回指标(Episodic Recall)相比已有基线实现了 19.5% 的大幅跃升。从定性结果中可以清晰观察到,当智能体经历长时间大范围迂回重新推开起始房门时,WorldTrace-Landmark 能够准确将原初场景的色彩排布、物品轮廓从固化的虚拟槽位中调取出来,近乎无损地恢复了场景的真实原貌。
走向具备连续世界认知的模拟系统
从工程落地与系统开销的角度审视,WorldTrace 展现出了极其诱人的实用价值。首先,它是一套完全免训练(Training-free)的即插即用架构。这意味着工业界与学术界现存的昂贵视频大模型、自动驾驶世界模型,无需经历昂贵且容易破坏原有泛化能力的二次微调,便能够通过挂载该记忆读写机制,直接拓展其长程时序视界。
其次,它对显存资源的控制极具现实意义。虽然它借助主机内存以极低开销保管了历史的关键规范化特征,但在运行核心注意力计算的 GPU 设备上,其 KV 缓存尺寸始终被定格在一个安全且恒定的常数级开销之内,峰值显存与最简单的截断滑动窗口完全持平。
更深层次的启示在于,WorldTrace 为世界模型的设计范式提供了一个重要转向:处理超长视频与长程交互,盲目堆砌注意力上下文窗口并非唯一的解法,甚至不是最聪明的解法。位置编码的数学局限性提醒我们,单纯把上下文长度从 4K 暴力拉长到 32K 或 128K,依然会遭遇注意力稀释与几何失真的物理边界。
通过将注意力机制解耦为常态工作区与结构化寻址档案区,并在物理显存与主机空间之间搭建层次化的记忆转运管道,大模型不仅能够更从容地处理即时交互,更能建立起一套稳定、不可篡改的长期情节记忆。对于追求高可靠性的具身机器人仿真环境以及真正意义上能够无限游玩、逻辑自洽的 AI 生成互动游戏而言,这种让记忆既“读得懂”又“找得到”的架构,正是虚拟世界走向真实与坚固不可或缺的底层支柱。