代码Agent找文件太费Token?CodeGrep精准检索缩减19%开销
CodeGrep: An RL-Trained Retrieval Agent for LLM Coding Agents
在目前的大模型代码智能体(Coding Agent)领域,无论是商业化的 Claude Code 还是开源的 OpenHands,工程界在追求更高任务解决率的同时,都在承受着极其沉重的算力与交互开销。以评估真实开源软件修复能力的权威基准 SWE-Bench Verified 为例,一个基于 30B 参数模型的 OpenHands 智能体,在成功修复单个 GitHub Issue 时平均需要经历 23 个交互轮次,并吞吐高达 631K 的上下文 Token。更反直觉的是,消耗这笔庞大算力开销的阶段,往往不是实际修改代码的步骤,而是在庞大的代码仓库中盲目尝试 grep、glob 和 view_file 等指令去“寻找”应当被修改的文件。
ArXiv URL:https://arxiv.org/abs/2608.05886v1
来自网易与独立研究者团队提出了名为 CodeGrep 的专用代码检索智能体,试图从架构层彻底重塑这一交互链路。他们基于 Qwen3-14B 模型,通过 GRPO(Group Relative Policy Optimization)强化学习端到端训练了一个轻量化检索专职模型。在保持下游代码智能体完全冻结不改的前提下,CodeGrep 在 SWE-Bench Verified 全部 500 个测试样例上,不仅将解决率从 25.8% 稳定提升到 27.0%,更在成功修复的案例中将交互轮数减少了 15%,上下文 Token 消耗缩减了 19%。
这项研究不仅公开了一套极具实用价值的工具链,更揭示了一个极具启发性的结论:代码检索对下游智能体的增益并非线性的,而是存在着一个硬性的“精准度阈值(Precision Threshold)”。低精准度的传统检索器非但不能提效,反而会用噪声污染上下文,成为拖慢智能体的负资产。
代码智能体的暗礁:“找文件”为何吞噬了大部分算力?
当前的主流代码智能体大多采用 ReAct 式的多轮循环:模型接收到 Issue 报告后,利用环境工具浏览仓库、定位错误、修改代码并运行测试。然而,真实的工业级软件仓库往往拥有数千个源文件和数十万行代码,Issue 报告中的自然语言描述又常常与具体的代码标识符存在严重的“词汇不匹配(Vocabulary Mismatch)”。用户在描述一个界面卡死或状态未同步的 Bug 时,绝大多数情况下并不会直接提及底层引发该缺陷的具体函数名或文件名。
在这种情况下,传统检索工具的局限暴露无遗。基于关键词匹配的 BM25 面对词汇不匹配几乎束手无策,而静态代码密集向量检索(Dense Code Retriever)又难以捕捉复杂的跨文件调用逻辑。代码智能体只能被迫退化为“试错型工程师”:发起一次粗略的全局搜索,扫过大量无关文件,在错误的探索路径上深入十几轮,直到上下文被冗长的报错和无关代码填满才中途放弃。这正是导致平均每个问题消耗超过 60 万 Token 的主要根源。
面对这种窘境,直觉上的解决方案有两种假设:其一是“提高效果假设(H1)”,即更精准的文件检索能将智能体从错误的探索死胡同中拉回来,从而大幅提升解决率;其二是“提升效率假设(H2)”,即智能体最终解决的问题集合变化不大,但到达终点的路径被大幅缩短。在 CodeGrep 之前,社区鲜有工作将检索器作为一个动态 Agent 置于真实的端到端智能体链路中进行联合检验。
解耦架构与 CATM:教检索模型像资深工程师一样搜代码
为了破解这一难题,作者团队采用了两阶段解耦的设计思想。在推理阶段,CodeGrep 作为前置检索子模块,首先接收 Issue 描述,通过多轮工具交互在目标代码仓库中主动排查,最终输出一份极度精简的候选文件列表。下游的 OpenHands 智能体则完全处于冻结(Frozen)状态,仅在其初始提示词中注入这些候选文件。这种设计保证了下游所测得的任何效率提升与解题增益,都纯粹来自于检索器提供信息的质量。
CodeGrep 本身拥有 14B 参数,暴露了三个只读原生工具:用于正则表达式搜索的 grep、用于路径匹配的 glob 以及用于阅读文件内容的 read。智能体在每个交互轮次最多可以并行发起 8 个工具调用,系统设置了最多 4 轮的交互上限(3 轮探索加 1 轮生成最终候选列表),即每次检索最多触发 24 次有效阅读,防止检索过程本身陷入无限循环。
要让检索智能体学会这一套探索策略,训练数据的监督信号来源是第一个关键障碍。传统做法通常将代码最终提交的 Git Patch 中修改的文件作为“真实标签(Ground Truth)”。但作者团队敏锐地指出,这种标注方法存在严重缺陷:在真实的软件调试中,工程师必须阅读大量辅助定义、接口规范或配置文件才能理解并定位 Bug,这些文件本身并不包含在最终修改的 Patch 中。如果仅仅以 Patch 文件作为奖励目标,强化学习反而会惩罚模型去阅读关键上下文的合理探索行为。
为此,研究团队设计了 CATM(Code Agent Trajectory Mining) 轨迹挖掘流水线,直接从 67,074 条开源 OpenHands 执行轨迹中提炼监督信号:
-
轨迹挖掘与清洗:提取所有读取文件的工具调用,剔除目录、文档以及非代码文件,并记录智能体在阅读该文件后生成的思考内容(Post-reasoning)及其 Token 长度 $l(f)$。
-
LLM 裁判过滤:引入大模型裁判对思考内容进行相关性分类,剔除误打误撞的无效阅读和盲目扫描。
-
强度感知加权:基于阅读后推理文本的长度,采用指数饱和函数计算文件权重:
\[\tilde{w}(f) = 1 - \exp\bigl(-\ln 2 \cdot l(f)/\beta\bigr), \quad w(f) = \tilde{w}(f)/\mu_{\text{raw}}\]其中 $\beta$ 为推理长度的中位数,归一化使得权重的期望值接近 1。经过阈值过滤后,最终将 CATM 挖掘出的高价值阅读文件与 SWE-Bench 的原始 Patch 文件合并,构成了真正贴合调试行为的强化学习目标集合。该流水线最终保留了 31,977 个高质量训练样本。
与数据流水线并行的另一项关键工程突破是沙盒基础设施。由于强化学习中的 Rollout 需要频繁执行真实的 grep 和 read 操作,如果像评测环境那样为每个样本启动完整的 SWE-Bench Docker 镜像,光是拉取环境和启动容器就需要耗费数分钟,单机多卡训练在工程上根本无法落地。作者团队观察到,CodeGrep 在检索阶段只需要只读访问代码文本,Python 运行时和依赖库完全是多余的。他们基于 Git-worktree 构建了一套超轻量级沙盒,通过单个裸仓库(Bare Clone)为不同 Commit 快速派生工作树。环境初始化的耗时直接从分钟级压缩到了毫秒级,磁盘占用也断崖式下降,使得整个多轮强化学习能够在单台配备 8 张 B200 的节点上顺畅完成。
GRPO 训练演化:为什么效率惩罚必须放在优势层?
在利用 GRPO 进行多轮强化学习的过程中,研究团队遇到了强化学习在工具调用场景中的经典痛点:当目标函数同时混合了“任务准确率”与“探索效率”时,策略极易出现非预期的退化。论文详尽记录了从 $v_1$ 到 $v_3$ 三个版本的演进历程,为多轮 Agent 的奖励设计提供了极其宝贵的实证经验。
系统在每个轮次根据总调用次数与轮次比例计算平均并发度 $\bar{c}$:
\[\bar{c} := C_{\text{total}}/T \quad (T \ge 1, \ 0 \le \bar{c} \le 8)\]在最初的 $v_1$ 版本中,团队将效率惩罚直接置于奖励层(Reward Layer)。基础分为预测文件与黄金标签之间的偏向精准率的 $F_\beta$ 值($\beta=0.5$,强调查准率胜过查全率),并在其上直接乘以基于并发度的惩罚因子:
\[R^{v_1} = \frac{1}{2}\bigl(F_\beta^{\text{file}} + F_\beta^{\text{lr}}\bigr) \cdot \sigma^{v_1}(\bar{c}), \quad \sigma^{v_1}(\bar{c}) = \frac{1}{\max(1, \bar{c}/4)}\]然而,这种在奖励层直接缩放的做法引发了严重的策略漂移。由于 GRPO 的优势估计是组内相对计算的,直接在奖励上进行乘法缩放会大幅扭曲组内样本的方差与符号结构。训练监控显示,$v_1$ 的策略与参考模型之间的 KL 散度迅速攀升至 0.31,模型虽然学会了压缩单轮调用,但在推理时却需要反复拖延到平均 3.8 轮,下游的 Token 节省几乎为零。
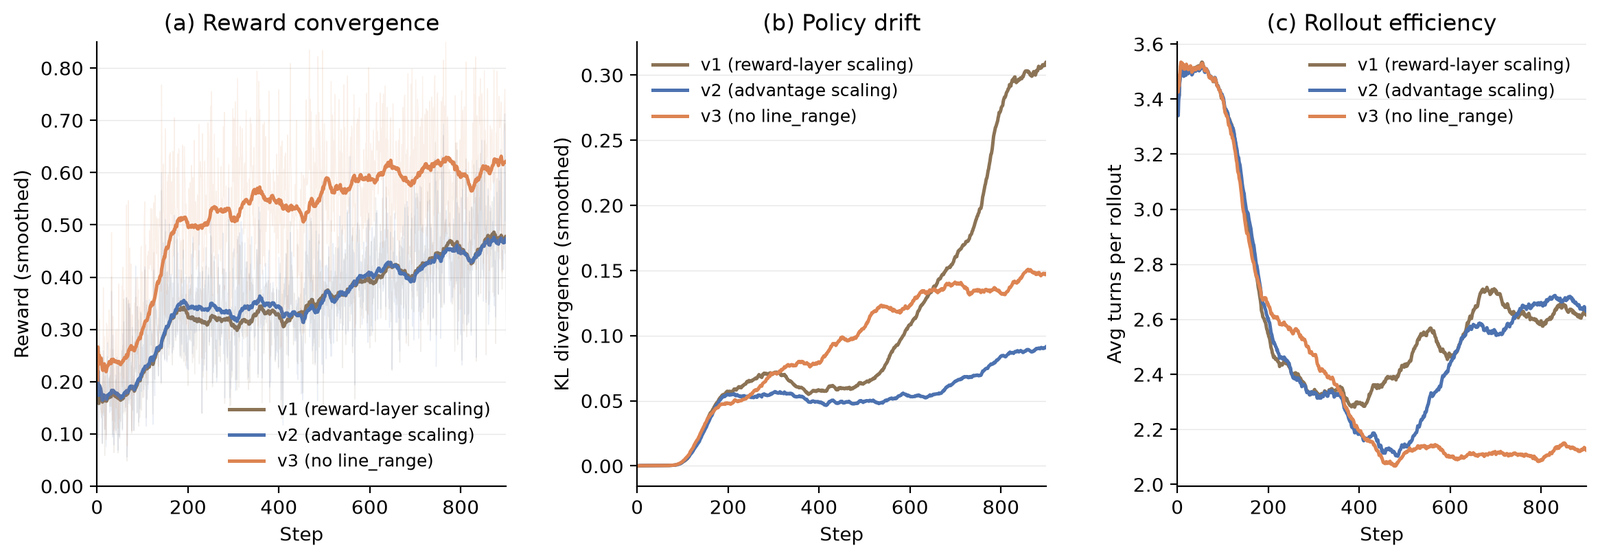
在 $v_2$ 版本中,作者做出了关键调整:将效率信号从奖励层剥离,下沉到优势估计层(Advantage Layer)。奖励本身仅保留基础性能分数与防止极端退化的硬掩码,而优势值则通过软化的折扣函数进行重权:
\[R^{v_2} = \frac{1}{2}\bigl(F_\beta^{\text{file}} + F_\beta^{\text{lr}}\bigr) \cdot \mathbf{1}_{\bar{c}>0}\] \[A^{v_2}_i = A_i \cdot s(\bar{c}_i), \quad s(\bar{c}) = \sqrt{\min(\bar{c}/4, 1)}\]这一改动的效果立竿见影。将效率折扣放在优势层不仅完整保留了组内样本的基础排序(确保好解依然优于坏解),而且避免了干扰其他组员的奖励标定。如上图所示,$v_2$ 的最终 KL 散度稳定在 0.09 左右,仅有 $v_1$ 的三分之一,训练稳定性获得了质的提升。
在最终的 $v_3$ 版本中,团队进一步做了精简。他们移除了最初为了追求细粒度而在奖励中加入的代码行范围(Line Range)匹配项 $F_\beta^{\text{lr}}$。实验发现,下游的 OpenHands 代码编辑工具在接收上下文时,实际上只需要文件路径级别的定位,具体的代码行完全可以由下游模型在阅读文件时自行处理。强行要求检索器精准预测行范围,不仅消耗了模型的优化容量,还诱发了模型为了凑行数而产生的长度利用漏洞。移除非必要目标后的 $v_3$ 表现出了最健康的训练动态:奖励收敛值显著提升至 0.60–0.65,推理工具轮数迅速下降并稳定在 2.1 轮附近,平均每轮搜索耗时更短、动作更为果断。
颠覆直觉的“精准度阈值”:检索不当反而成为负资产
在完整的 SWE-Bench Verified 基准评测中,研究团队将无检索基线、BM25、Jina-1.5B 向量检索以及三个版本的 CodeGrep 进行了严格的横向对比,下游均采用 Qwen3-30B 模型。实验数据不仅验证了 CodeGrep 的优越性,更打破了以往关于检索增强的线性认知。
从内在检索质量(Retrieval Evaluation)来看,不同方案呈现出明确的梯度:
-
BM25 的 $F_\beta$ 为 0.359,查准率仅有 0.375,能够达到高质量检索($F_\beta \ge 0.8$)的样本比例只有 7.0%;
-
Jina-1.5B 表现稍好,$F_\beta$ 达到 0.427,查准率为 0.445,高质量检索比例同样停留在 7.0%;
-
CodeGrep $v_3$ 展现出断层式领先,$F_\beta$ 飙升至 0.576(中位数高达 0.714),查准率突破至 0.677,更关键的是,其高质量检索比例跃升到了 43.0%,是传统方案的 6.1 倍,且平均仅需 2.3 个工具轮次即可完成探索。
当这些检索结果注入给下游冻结的代码智能体时,下游的任务完成度与资源消耗呈现出惊人的对比。
首先是 BM25 带来的负优化效应。将 BM25 检索到的文件喂给下游后,整体解决率不升反降,从基线的 25.8% 跌落至 25.2%;在成功解决的实例中,消耗的 Token 反而从 631K 暴增到 763K(激增 21%)。特别是在两套系统都能成功解决的 94 个共有样本中,引入 BM25 的智能体交互轮数增加了 6.6%,Token 暴涨了 38.6%。这证明低精度的检索器注入的充其量只是上下文干扰噪声,下游模型为了甄别并排除这些无关文件,被迫发起了更多的反思与工具交互。
其次是 密集向量检索 Jina 的中性表现。Jina-1.5B 注入后,下游解决率维持在原地的 25.8%,解决问题的 Token 消耗微弱下降 7%(降至 587K)。这说明 0.445 附近的查准率仅仅处于打平成本的临界点上,它带来的微弱线索几乎完全被伴随引入的噪声所抵消。
最后是 CodeGrep $v_3$ 跨越阈值后的双重红利。在将查准率推高至 0.677 后,CodeGrep 成为唯一一个成功跨越“精准度阈值”的系统:
-
解决率实现了可复现的正向提升,从 25.8% 增加到 27.0%(+1.2 个百分点);
-
解决问题所需的交互轮次从 23.0 轮削减至 19.6 轮(减少 15%);
-
解决单个 Issue 的 Token 消耗从 631K 大幅下降至 514K(缩减 19%)。
实验数据明确揭示了一条规律:检索增强在代码智能体中绝非线性收益,而是呈现阶梯式的阈值效应。在精准度达到约 0.45 之前,检索结果是负资产;在 0.45 到 0.68 之间,检索系统才真正越过盈亏平衡点,开始显现出为智能体节省算力、加速收敛的工程价值。
模块化分工:大模型智能体走向高效落地的必由之路
CodeGrep 的探索为当前大模型系统的架构演进提供了一个极其清晰的信号:让通才做通才的事,让专才做专才的事。
在过去很长一段时间里,社区倾向于依赖单一的超大模型或强推理模型从头到尾包揽全部工作——从最初在数百个文件中定位 Bug,到中间推导业务逻辑,再到最后编写补丁代码。这种“巨石型(Monolithic)”的智能体设计在遇到大规模代码库时,必然导致高昂且低效的上下文膨胀。
CodeGrep 证明,通过多轮工具强化学习,用一个相对较小(14B)的模型专门扮演“领航员(Navigator)”角色,依靠极其精简的交互指令先一步在代码树中穿梭排查,能够以极低的成本替后方昂贵的“主程序员”扫清迷雾。更重要的是,这一探索不仅给出了具体的开源权重与极其轻量的毫秒级 Git-worktree 训练环境,其在 GRPO 优势层引入效率约束、剔除冗余监督信号的奖励设计哲学,也为未来所有从事多轮工具调用强化学习(Tool-use RL)的研究者与工程师提供了一份极具参考价值的实战指南。