CRPO:用对比自蒸馏重构智能体强化学习,8B模型跨级超越32B基准30个点
Contrastive Reinforced Policy Optimization via Privileged Self-Distillation
在大模型后训练(Post-Training)的演进脉络中,强化学习正在分裂为两条泾渭分明的技术路径。一条是以 DeepSeek-R1 为代表、依赖可验证奖励的强化学习(RLVR),它利用最终答案的对错给出稀疏但准确的标量奖励,却受制于长链路中间步骤的信用分配难题;另一条则是同策略自蒸馏(On-Policy Self-Distillation, OPSD),让同一个模型兼任学生与教师,利用包含成功参考轨迹或工具执行报错的特权信息构建“自教师”(Self-Teacher),在 Token 级别提供密集的 Logit 监督。
ArXiv URL:https://arxiv.org/abs/2607.28026
然而,当自蒸馏被引入需要调用外部工具的多轮智能体(Agent)场景时,特权信息反而成了致命毒药。研究团队在这项最新工作中指出,自教师凭借特权提示词产生了严重的“曝光偏差”(Exposure Bias):在外部工具返回全新环境观测、学生模型本应深入探索的关键节点,自教师却因走惯了提示词中的现成捷径而表现出虚假的过度自信。这种特权误导导致学生模型的推理路径迅速收敛,并在多轮迭代中彻底丢失优化方向。
针对这一本质缺陷,本文提出了对比强化策略优化(Contrastive Reinforced Policy Optimization,简称 CRPO)。CRPO 彻底跳出传统蒸馏单纯拟合分布的旧思路,将智能体自蒸馏重构为一个对比学习问题。它通过预测熵的动态差值自动区分有效探索与曝光偏差,在奖励相对优势位置强化蒸馏,在偏差位置施加排斥惩罚。在跨越数学推理与深度搜索的 13 项极具挑战性的基准测试中,结合了该机制的 CRPO* 展现出惊人的长程交互能力,不仅全线超越现有强化学习与蒸馏基线,其 8B 与 14B 模型在 GAIA 深度搜索基准上更是大幅超越 32B 的主流推理基线超过 30 个绝对百分点。
特权自教师的双刃剑:多轮交互中的熵坍塌与方向迷失
同策略自蒸馏之所以在单轮推理中有效,是因为模型通过将“带有特权反馈的自身输出”作为软标签,无须额外引入外部大教师即可低成本获得密集的梯度指引。但在多轮智能体环境中,模型每执行一次工具调用,真实物理世界或外部搜索引擎就会返回不可预测的新信息。此时,智能体究竟面临着怎样的优化危机?
论文通过细粒度的位置级熵(Position-level Entropy)监测揭示了第一个关键现象:推理路径的虚假收敛。如下图所示,在 GAIA 深度搜索任务的一条真实轨迹中,每当外部工具调用结束、引入大段未知的上下文时,学生模型的预测熵会急剧飙升,这意味着模型遭遇了高度不确定性,亟须开展发散性反思与长程探索。
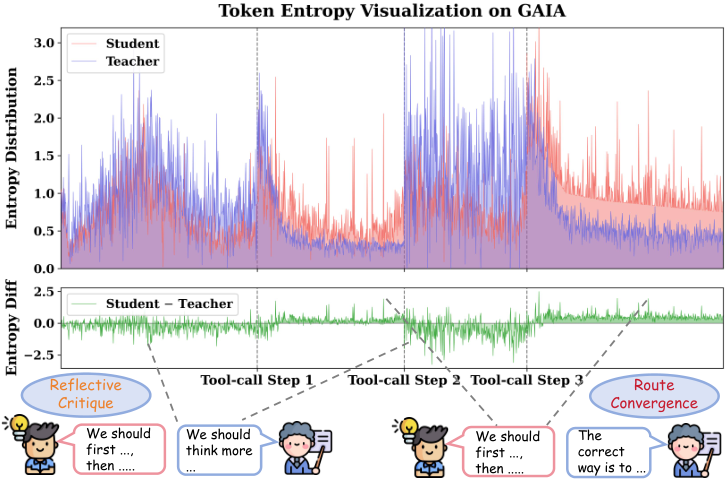
然而,同策略自教师的表现却走向了另一个极端。因为自教师的输入中拼接了同批次内成功的参考轨迹或历史编译反馈,这种特权提示让自教师产生了一种“先验作弊”式的自信。自教师并没有结合当前具体的复杂情境重新规划,而是机械地复用示例中的推理模板,导致其在极高不确定性的位置熵值断崖式下跌。如果学生模型在这一阶段不加甄别地全盘模仿自教师的 Logit 分布,就会过早放弃独立探索,最终丧失泛化到未见复杂任务的能力。
这就引出了第二个更为严重的现象:多轮蒸馏中的优化方向迷失。传统的 OPSD 采用逆向 KL 散度来对齐学生与教师的分布。在单轮任务中,特权信息相对静态,KL 散度能够稳定收缩;但在多轮深度搜索任务中,由于外部环境反馈不断累积,自教师在大量位置给出的监督信号本就带有偏差。实验监测显示,纯 OPSD 在训练中后期,奖励曲线剧烈震荡且无法稳步上升,而学生与教师之间的 Token 平均 KL 散度却呈爆发式失控增长。这表明学生模型已被特权自教师带入歧途,既学不会正确的环境交互,又无法从稀疏的终局结果中获得有效指引。
现有的修补方案往往试图用自蒸馏信号来缩放 RLVR 的更新步长,或者直接将二者的损失函数强行加权相加。这类做法割裂了稠密信号与稀疏奖励的内在联系,往往需要维护两套独立的计算图,带来了高昂的显存与计算开销。研究团队的核心洞察在于:根本不必引入额外的复杂判别模型,而是应当重构自蒸馏自身的优化范式,让模型自主识别哪些位置应当靠近自教师,哪些位置必须远离特权偏差。
对比自蒸馏:CRPO 的形式化与算法架构
为了在保留密集监督优势的同时剔除特权偏差,本文提出了 CRPO。其核心突破在于将同策略自蒸馏问题全面映射为对比学习框架。
在 CRPO 的设定中,策略模型 $\pi_{\theta}$ 本身充当特征编码器(Encoder);原始上下文 $S_{i,t}=(x, y_{i,<t})$ 与注入了特权反馈的上下文 $T_{i,t}=(x, f, y_{i,<t})$ 被分别视作输入的原始视图与增强视图;模型在位置 $t$ 输出的未归一化对数几率(Logits)构成了表征;而学生与自教师预测分布之间的负 KL 散度,则天然对应于表征空间中的相似度函数。
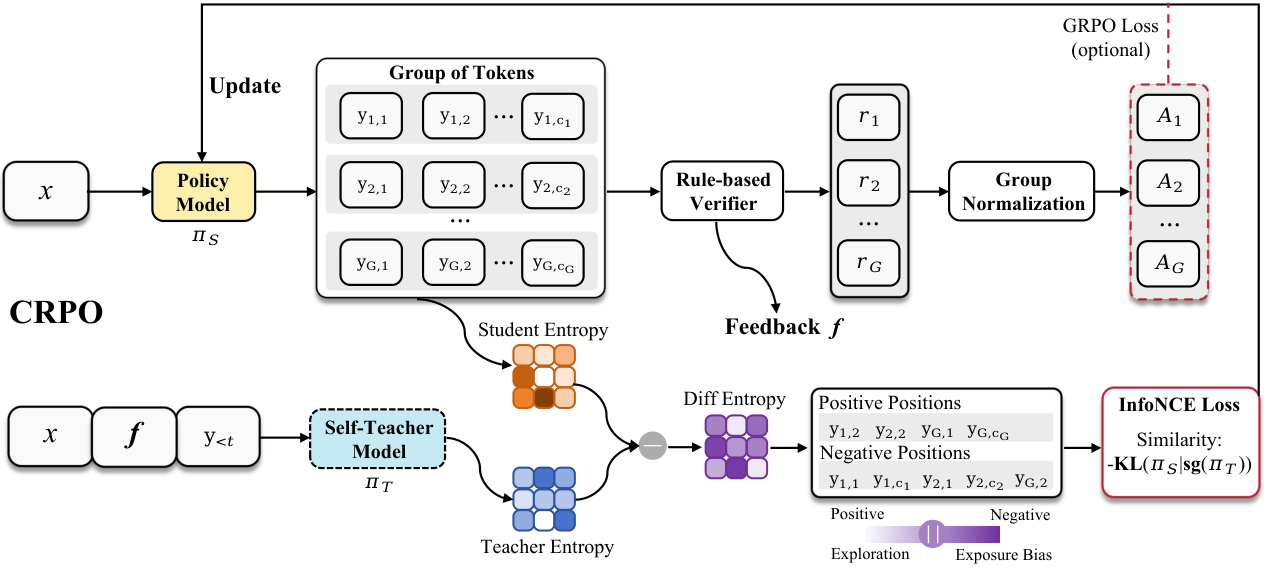
上图完整展示了 CRPO 的算法流水线。在多轮交互中,输入问题 $x$ 引导智能体生成响应序列,期间穿插着与沙箱解释器、搜索引擎等外部工具的交互。收集到轨迹与环境反馈后,同一组权重在带有特权信息的条件下生成自教师的表征。随后,算法并不进行无差别的全局拉近,而是通过一组精心设计的正负样本门控,实现精准的对比排斥与吸引。
要让对比学习成立,最关键的一步是如何在不引入外部判别器的情况下,自动化、无监督地找出“哪些位置应当蒸馏、哪些位置应当排斥”。CRPO 巧妙地利用学生与教师在对应位置的预测熵之差构建了判定准则。具体而言,定义学生与教师在位置 $(i,t)$ 的预测熵分别为:
\[\mathrm{E}^{\text{S}}_{i,t} = \sum_{\hat{y}_t} \pi_{\theta}(\hat{y}_t\vert{}S_{i,t}) \log \pi_{\theta}(\hat{y}_t\vert{}S_{i,t})\] \[\mathrm{E}^{\text{T}}_{i,t} = \sum_{\hat{y}_t} \pi_{\theta}(\hat{y}_t\vert{}T_{i,t}) \log \pi_{\theta}(\hat{y}_t\vert{}T_{i,t})\]两者之差记为 $\Delta\mathrm{E}{i,t} = \mathrm{E}^{\text{S}}{i,t} - \mathrm{E}^{\text{T}}_{i,t}$。由此,所有响应位置被划分为三种典型的动态场景,如下图所示:
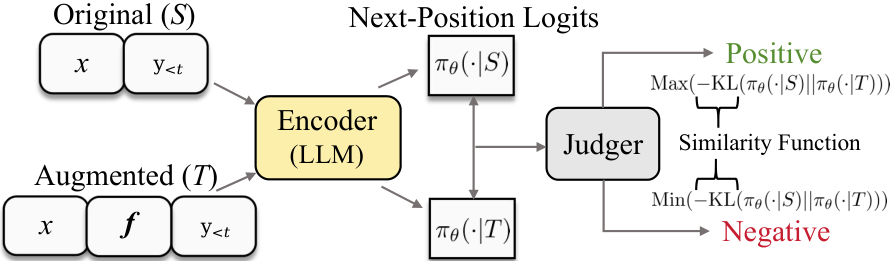
第一种情况是 $\mathrm{E}^{\text{S}}{i,t} \ll \mathrm{E}^{\text{T}}{i,t}$,即学生模型的确定性显著高于自教师。这表明学生在没有特权信息的情况下已经形成了明确的认知,而自教师在融入外部反馈后反而激发了更广泛的假设与反思性探索。这种位置被视为高价值的“反思性探索”(Reflective Exploration),学生应当主动向教师的分布靠拢,从而拓展探索边界。
第二种情况是 $\mathrm{E}^{\text{S}}{i,t} \approx \mathrm{E}^{\text{T}}{i,t}$,说明特权信息的引入并未显著改变模型的置信度,多为常规推理或语法性过渡。
第三种情况则是最危险的 $\mathrm{E}^{\text{S}}{i,t} \gg \mathrm{E}^{\text{T}}{i,t}$,即前文观察到的“熵坍塌”。在外部工具刚返回信息、学生极度迷茫时,教师凭借特权捷径给出了极其武断的低熵预测。这种位置存在极高的曝光偏差风险,教师的行为本质上是盲目模仿参考答案,绝不能让学生照单全收。
基于此,CRPO 在同一批次的所有位置中,按 $\Delta\mathrm{E}_{i,t}$ 的分位数进行筛选。选取差值最低的前 $p\%$ 位置构建正样本集合 $\mathcal{P}$,其余位置则被划入负样本集合 $\mathcal{N}$:
\[\mathcal{P} = \{(i,t) \mid \Delta\mathrm{E}_{i,t} \leq \text{Bottom}_{p\%}(\{\Delta\mathrm{E}_{i,t}\}) \}, \quad \mathcal{N} = \{(i,t) \mid (i,t) \notin \mathcal{P}\}\]定义相似度度量为学生与截断梯度(Stop-gradient)教师分布的负 KL 散度:
\[\text{sim}(i,t) = -\text{KL}(\pi_{\theta}(\cdot\vert{}S_{i,t}) \,\|\, \text{sg}(\pi_{\theta}(\cdot\vert{}T_{i,t})))\]最终的 CRPO 对比损失函数被形式化为一组位置维度的 InfoNCE 变体:
\[\mathcal{L}_{\text{CRPO}}(\theta) = -\log \frac{\sum_{(i,t)\in\mathcal{P}} \exp(\text{sim}(i,t)/\tau)}{\sum_{(i,t)\in\mathcal{P}\cup\mathcal{N}} \exp(\text{sim}(i,t)/\tau)}\]其中 $\tau$ 为温度超参数。最小化该损失函数的物理意义非常清晰:它强制模型在正样本位置最小化与自教师的 KL 散度,充分汲取高质量的反思性探索能力;同时在负样本位置最大化 KL 散度,惩罚对曝光偏差的盲目模仿。更具理论美感的是,论文在附录中给出了严格推导,证明 CRPO 的梯度在数学上等价于带有软门控(Soft Gate)的 Logit 级别信用分配策略梯度,完全契合强化学习的理论基石。
为了兼顾终局目标的正确性,论文进一步将 CRPO 与成熟的组相对策略优化(GRPO)结合,形成终极方案 $\text{CRPO}^*$:
\[\mathcal{L}_{\text{CRPO}^*}(\theta) = \mathcal{L}_{\text{GRPO}}(\theta) + \lambda \mathcal{L}_{\text{CRPO}}(\theta)\]这种设计极其优雅:它完整保留了 GRPO 基于结果奖励的轨迹级信用分配机制,但将其原本锚定在静态基线模型上的散度约束,无缝替换为了具有位置感知能力、与自教师动态博弈的对比正则化项。
13 项基准全线突破:从数学解题到深度搜索的跨级跃迁
为了全面检验 CRPO 的有效性,研究人员在数学与知识密集型推理(如 AIME24、AIME25、MATH500、HotpotQA 等)以及极其严苛的多轮深度搜索(如 GAIA、HLE、WebWalkerQA、xbench-DeepSearch)共计 13 个主流基准上展开了系统性评测。所有对比均在 Qwen2.5、Llama3.1 以及最新的 Qwen3 等统一骨干网络下进行,并严格对齐冷启动 SFT 数据与强化学习探索环境。
核心实验结果呈现出以下几个具有高度说服力的技术结论:
在整体表现上,$\text{CRPO}^*$ 在所有骨干模型、所有基准任务的平均分上无一例外地夺得第一。与经典的 GRPO 相比,引入对比自蒸馏正则项为各个模型带来了稳健的增益;在深度搜索任务中,单项任务的绝对提升最高达到了 $2.9\%$。这一提升直接证明了稠密对比信号与稀疏结果奖励之间的正交互补性:结果级奖励把控大方向,而对比自蒸馏则在微观上规范了中间每一步工具调用的置信度分布。
更引人瞩目的一项发现在于参数效率的跃升。在难度极高、极度依赖外部搜索引擎与 Python 交互的 GAIA 深度搜索基准上,基于 $\text{CRPO}^*$ 训练的 Qwen3-8B 与 14B 模型,其平均得分不仅大幅击败了同尺寸的强化学习模型,更是以超过 30 个绝对百分点的巨大优势,直接碾压了参数量高达 32B 的主流推理基线(包括 Qwen3-32B-thinking、QwQ-32B 以及 DeepSeek-R1-32B)。在需要数十轮工具调用、处理大量不可靠外部信息的复杂场景下,盲目堆叠模型参数量无法解决深层交互中的错误累积,而通过对比自蒸馏获得的精准决策能力,能让较小参数量的模型爆发出远超大尺寸模型的执行效能。
与同类蒸馏方法的横向对比进一步坐实了传统自蒸馏在智能体场景下的水土不服。传统的 OPSD、SDPO 以及 RLSD 尽管拥有稠密的 Logit 监督,但在 GAIA 和 HLE 这类长程多轮交互任务中,其最终表现均明显落后于纯基于结果奖励的 GRPO 和 ARPO。这一现象彻底打破了“有稠密信号就一定优于稀疏信号”的经验主义迷思,印证了论文最初的判断:未经修正的特权自教师所带来的曝光偏差,足以在多轮交互中彻底毁掉策略的泛化性。
训练动态与超参数消融:稳定性的底层来源
除了最终跑分的领先,训练过程的动态监测指标进一步解释了为什么 CRPO 能够克服多轮交互中的退化问题。
在对 Qwen3-8B 进行 100 步优化轨迹的连续追踪中,纯 OPSD 暴露出了致命的训练不稳定:在第 60 至 100 步之间,OPSD 出现了极为剧烈的熵坍塌,策略模型的预测熵骤降至极低区间,与此同时其 KL 损失剧烈上扬,表明模型已经完全被有偏差的教师带偏,无法独立生成高质量的推理轨迹。相比之下,CRPO 与 $\text{CRPO}^*$ 的预测熵和 KL 散度在整个训练周期内始终维持在一个极窄且稳定的带状区间内,走势与探索表现优异的 ARPO 保持一致,但准确率曲线却全程压制所有基线。
与稳定性相伴的是卓越的工具调用效率。在未施加任何显式工具调用预算惩罚的前提下,CRPO 训练出的模型在总工具调用次数上远低于 GRPO 与 OPSD,仅略高于以节制著称的 ARPO。这表明对比机制有效抑制了无意义的重复搜索或盲目试错,促使智能体在关键转折点展开真正有价值的反思性检索。
在采样扩展性(Scaling Sampling)方面,针对深度搜索任务固有的动态性与长程性,研究团队进一步评测了模型在 Pass@1 到 Pass@5 的性能扩展。以 Qwen3-14B 上的 $\text{CRPO}^*$ 为例,当采样预算从 Pass@1 提升至 Pass@5 时:
-
GAIA 上的准确率从 $50.5\%$ 飙升至 $70.7\%$,绝对提升达 $20.2\%$;
-
人类终极考试 HLE 从 $14.6\%$ 攀升至 $35.0\%$,提升达 $20.4\%$;
-
WebWalkerQA 与 xbench 同样录得了超过 23 个绝对百分点的爆发式增长。
这种近乎线性的采样扩展能力在多轮智能体模型中极为罕见。它从侧面证明,CRPO 的正负样本对比机制并没有以牺牲多样性为代价换取确定性,反而通过在关键位置排斥曝光偏差,大幅扩展了策略在解空间中的有效探索边界,使得模型在多路采样时能展现出极高质量的推理多样性。
在针对关键超参数的消融实验中,正样本比例 $p$ 与对比权重 $\lambda$ 的表现呈现出典型的倒 U 型曲线,峰值稳定出现在 $p=30$ 与 $\lambda=5$ 附近。当 $p \to 100$ 时,模型不再区分正负样本,退化为无差别蒸馏的 OPSD,四个深度搜索基准的成绩全线溃败;而当 $\lambda \to 0$ 时,对比自蒸馏项彻底消失,模型退化为经典的 GRPO,性能同样出现系统性滑坡。两个边界极端工况的性能骤降,从正反两方面确立了“基于熵差识别曝光偏差”以及“对比排斥负样本”在算法结构中的绝对必要性。
智能体后训练范式的新启发
CRPO 的提出不仅是一套算法工程上的成功,更为智能体后训练领域提供了一个极具启发性的理论视角。
在过去很长一段时间里,大语言模型的强化学习几乎被“生成轨迹—标量判别—策略梯度更新”的单一范式所垄断。当研究人员试图引入密集的中间监督时,又极易陷入对外部更强模型(如商业闭源模型)的严重依赖,或者在自身特权蒸馏中遭遇严峻的曝光偏差陷阱。
CRPO 证明了:不需要额外引入庞大的判别网络,也不需要外部高阶教师模型,仅仅利用模型自身在不同信息视图下的预测熵动态演变,就足以解构出高质量的内在奖励与监督梯度。将同策略自蒸馏与对比学习原理深度绑定的构想,不仅成功破解了特权信息在多轮交互中的“毒性”,还为多轮复杂智能体系统提供了一种计算开销极低、收敛极其稳健且易于并入现有 RL 框架的后训练方案。随着大模型在深层推理与自主环境交互领域的持续深入,这种兼具密集信号精度与探索鲁棒性的对比自进化范式,或将成为构建可靠智能体系统的核心基石。