CoSA:协同设计打破稀疏注意力瓶颈,128K长文本TTFT缩减2.53倍
CoSA: Accelerating Long-Context Inference via Proxy-Kernel Co-Designed Sparse Attention
在大语言模型向十万乃至百万级长上下文演进的过程中,计算效率的“灰犀牛”始终盘旋在首字生成延迟(Time-to-First-Token, TTFT)之上。自注意力机制(Self-Attention)所固有的二次方计算复杂度,使得模型在长文本预填充(Prefill)阶段的显存访问与计算吞吐面临严峻考验。为了压低计算成本,基于代理评分(Proxy-based)的块稀疏注意力(Block-Sparse Attention)成为了工业界和学术界的主流方案,诸如 MInference、FlexPrefill 和 XAttention 等工作均沿着这一路线推进。
ArXiv URL:https://arxiv.org/abs/2607.25291v1
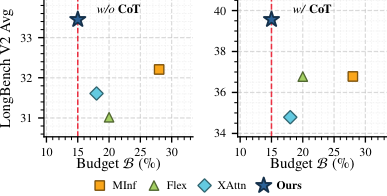
然而,现存的稀疏注意力机制在逼近极限性能时,几乎都会陷入一个两难境地:若分配较为宽裕的稀疏计算预算,代理模块能较准确地预测关键注意力块,但加速比极其有限;若为了追求高加速而收紧预算,前置代理不可避免地会误删关键上下文,导致模型在复杂长文本理解和推理任务中出现断崖式性能下跌。
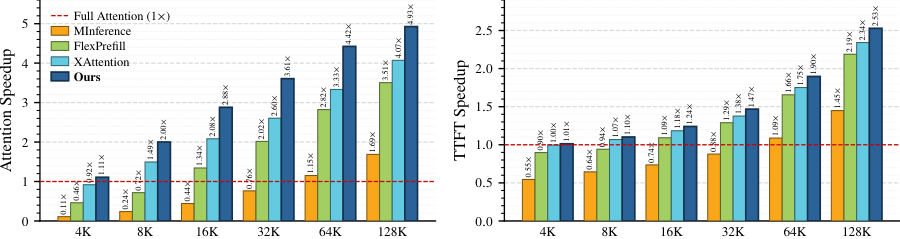
香港科技大学与腾讯的研究团队提出了 CoSA(Proxy-Kernel Co-Designed Sparse Attention),直接指出了这种困境的症结所在:以往的优化将“上层算法代理”与“底层计算核函数(Kernel)”割裂开来。代理算法只负责输出一张非黑即白的静态二值掩码(Binary Mask),而底层的硬件 Kernel 只能机械地消费这张掩码。CoSA 创新性地采用“代理-内核协同设计”范式,将静态掩码升级为带有优先执行顺序的“计算顺序掩码”,并结合硬件层面的在线 Softmax 统计量实现两阶段稀疏。在 128K 上下文长度下,CoSA 实现了 4.93 倍的注意力算子加速与 2.53 倍的端到端预填充延迟缩减,同时在长文本任务上几乎保持无损表现。
割裂的现状:算力与精度的隐形拉扯
要理解 CoSA 为什么有效,必须先厘清现有稀疏注意力的两套主流流派及其深层瓶颈。
第一种流派是前置代理掩码驱动(Mask-Driven)。它的核心逻辑是在进入重型注意力计算之前,先通过对 Query 和 Key 进行步长降采样(Downsampling)或均值池化,计算出一个小维度的粗糙注意力图,挑选出 Top-$K$ 最关键的块生成二值掩码,再交由底层块稀疏 Kernel 执行。这种做法的优势在于彻底阻断了非重要块的 Query-Key(QK)乘法与 Softmax 计算。然而,实验表明,前置代理的保真度与计算预算高度正相关。在宽松预算下,代理掩码与全量注意力的交并比(IoU)极高;一旦预算被大幅压缩,粗粒度估计的固有误差就会导致最显著的 Query-Key 交互块被误杀,从而导致模型准确率大幅下降。
第二种流派是硬件内部的在线跳过(In-Kernel Skipping),以 FlashAttention-4 衍生出的 BLASST 等方案为代表。这类方法无需前置代理,而是在 Kernel 内部利用 FlashAttention 的在线 Softmax(Online-Softmax, OSM)统计量,动态判断当前计算块的局部最大值与当前累积最大值之差。如果当前块对全局 Softmax 分母与分子的贡献在数学上可忽略不计,就直接跳过后续的 Value 乘法与内存写入。
这种机制虽然保证了数学上的高保真度,却面临两个致命限制。首先,为了获取真实的 Softmax Logits,它必须对每一个块都实打实地完成完整的 $\mathbf{Q}_i \mathbf{K}_j^\top$ 矩阵乘法,因此对于占据长上下文主要开销的 QK 阶段,它完全无法降低计算量。其次,这类跳过规则非常保守。在 GPU 流式计算过程中,当前维护的局部最大值只是“已访问块”的历史最大值,而非全局最大值。在遍历真正重要的核心块之前,累积最大值一直维持在较低水平,导致大量无关紧要的块被判定为“不可跳过”;再加上硬件 Warp 线程内部的木桶效应,整块线程束只要有一行需要计算,整个计算块就必须执行,大量算力因而被白白浪费。
核心观察:在线 Softmax 的“顺序无关性”与先行最大值
CoSA 团队发现,破局的关键隐藏在底层硬件与算法特性的交汇点上。
首先是 FlashAttention 依赖的核心算法——在线 Softmax(Online-Softmax)。FlashAttention 将 Query 对应的 Key/Value 划分为多个块,流式累加注意力输出并实时动态更新缩放系数。在线 Softmax 在数学上具备严格的“顺序无关性”(Order-Invariance):无论硬件以何种顺序遍历处理 Key-Value 块,最终收敛出的注意力数值结果是严格一致的。
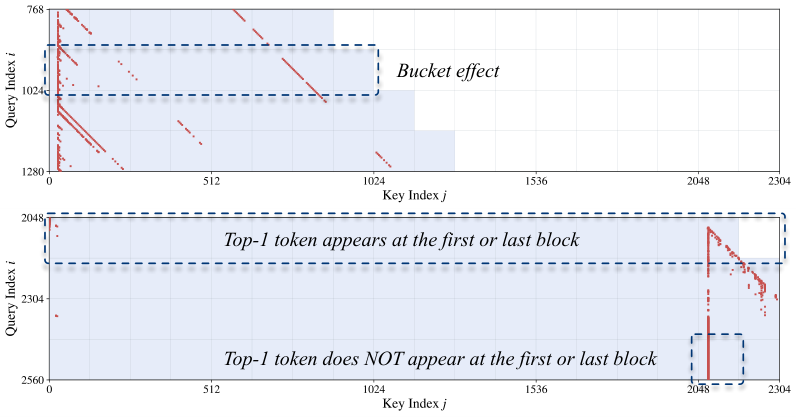
其次,在典型的长文本注意力图分布中,产生行最大值(Rowmax)的核心块往往并非均匀分布,但在特定头上具有显著的集中模式。如果在计算之初就能够“优先”访问包含全局行最大值的块,系统的累积最大值就会在第一时间被拉升到极高水平。一旦累积最大值被迅速垫高,后续紧接着遍历的普通甚至低权重的 Key-Value 块,其局部数值与累积最大值的差距就会迅速放大,从而触发硬件底层的在线跳过条件。
这就引出了协同设计的核心思想:前置代理不应直接给出决定生死的二值判断,而应给出一个“带有优先级建议”的访问顺序列表;后端的稀疏 Kernel 也不应机械地按物理连续地址顺序读取,而应遵循代理给出的优先级动态访问,进而用真实的硬件统计量实现第二阶段的安全剪枝。
机制解析:KAP 代理与 OSK 计算内核的双向奔赴
基于上述理论支撑,CoSA 构建了一个两阶段稀疏注意力系统,主要由内核感知代理(Kernel-Aware Proxy, KAP)与有序跳过内核(Ordered-Skipping Kernel, OSK)两部分紧密协同构成。
1. 内核感知代理(KAP):从单纯筛选到结构化排序
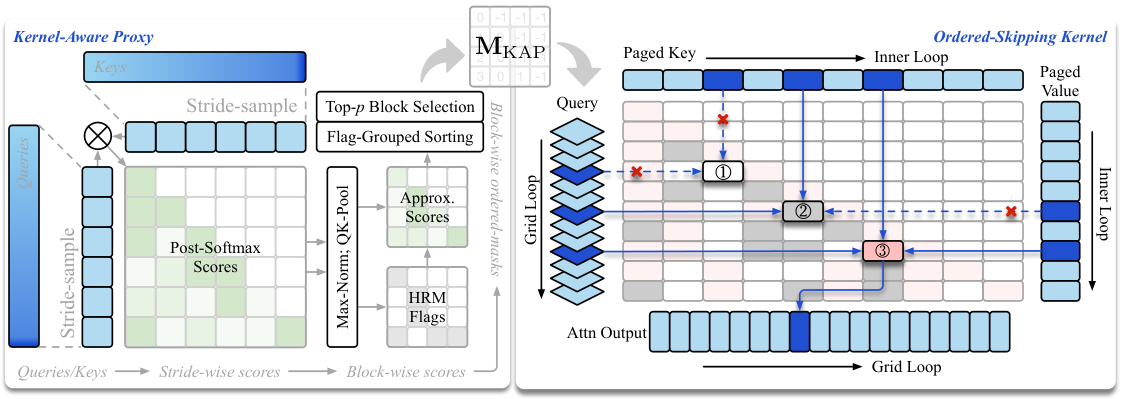
KAP 在正式进入 Kernel 前运行,执行开销极低。它首先对输入的 Query 和 Key 进行跨步降采样,构建出低维度的近似注意力图。通过在近似图上执行 MaxPool 与 MaxNorm 操作,KAP 不仅能估算出每个块的重要性得分,还能为每个 Query 块打上一个专属的 HRM 标志(Have RowMax Flag),用以标记该 Query 的局部最大得分究竟落在了哪一个 Key 块中。
获得粗粒度得分与 HRM 标志后,KAP 不再只是像传统方法那样切一刀 Top-$K$ 就了事,而是执行“分组排序”(Flag-Grouped Sorting)。算法强制将所有带有 HRM 标记的关键块排在最前列,随后按照估计分数的高低依次排列其他保留块。在此基础上,KAP 施加第一阶段的温和预算筛选(例如保留 50% 左右的候选块)。此时被过滤掉的块将在后续完全不参与计算,彻底规避了无用块的 QK 乘法开销。
最终,KAP 输出的不再是传统的布尔矩阵,而是一个计算顺序掩码(Computation-Order Mask,记作 $\mathbf{M}_{\text{KAP}}$)。这一掩码向底层硬件明确下达了两项指令:一是本轮到底计算哪些块,二是硬件内核在内层循环中必须按照什么物理先后顺序去依次访问它们。
2. 有序跳过内核(OSK):轻量分页重映射与深层剪枝
在接收到 $\mathbf{M}{\text{KAP}}$ 后,后端的 OSK 内核开始接管并执行物理计算。现代大模型推理框架(如 vLLM)普遍采用 PagedAttention 机制,将显存中的 KV 缓存切分成不连续的物理页面进行管理。OSK 巧妙地复用了这一特性,无需做任何物理显存数据的重排或搬运,仅仅通过一个极轻量的页表索引映射,就能让硬件按照 $\mathbf{M}{\text{KAP}}$ 指示的顺序跳跃遍历 KV 页面。
在 OSK 的内层执行循环中,整个计算过程被细化为三类块的处理:
-
掩码跳过块(Mask-Skipped): 已经在第一阶段被 KAP 过滤的非核心块,OSK 借助页表直接跳过,连同 QK 乘法、内存加载和同步指令彻底消除。这从根本上打破了传统 In-Kernel Skipping 必须算满全局 QK 矩阵的算力束缚。
-
内核在线跳过块(In-Kernel Skipped): 对于进入计算列表的块,OSK 实时计算真实的小矩阵 Logits,并评估 Softmax 阈值。由于在 KAP 的指引下,包含行最大值的 HRM 块在第一批次就被全部算完,此时的累积最大值处于全局高位,绝大多数次要块能够极度激进且安全地触发跳过判定,直接免去后续的 Value 加载与点乘累加。
-
完整计算块(Computed): 仅有真正对上下文输出产生显著注意力权重的极少数核心块,会完整跑完加载、点乘、更新与写回的全部流水线。
通过这种“上层宏观剪除 + 顺序引导”与“下层微观依据真实物理值二次过滤”的闭环,CoSA 在极度压缩计算总量的同时,避免了单一前置代理误删重要信息导致的精度灾难。
实验印证:提速近5倍,长文本推理无损
实验评测在配备 NVIDIA H20 的硬件节点上展开,模型底座涵盖了开源界极具代表性的 Llama-3.1-8B-Instruct 以及 Qwen3-8B(拓展至 128K 上下文)。对比基线包括密集计算的 FlashAttention-2,以及目前业界领先的稀疏预填充方案 MInference、FlexPrefill 和 XAttention。
评测选用了合成长文本检索基准 RULER 与极其贴近真实深层理解与长链条推理的 LongBench-v2。在 LongBench-v2 上,测试不仅包含常规的无思维链(w/o CoT)模式,更考察了开启长思维链(w/ CoT)的思考模式,以验证稀疏预填充是否会破坏大模型的深层推理链条。
测试结果呈现出几个清晰的结论:
首先,在长文本极限检索与理解基准上,CoSA 在所有主流稀疏方法中实现了最高的平均准确率,同时占用了最低的计算预算。在 RULER 测试中,随着长度从 4K 提升到 128K,传统稀疏基准的精度均出现了明显衰减,而 CoSA 在 128K 的 Qwen3-8B 上依然保持着极高的任务完成度。在挑战性极大的 LongBench-v2 评测中,无论是否开启 CoT 思考模式,CoSA 均稳居稀疏方案的第一梯队,证明其保留的上下文语义具有极高的保真度。
其次,在算子级与端到端实际延迟方面,CoSA 展现出了显著优势。在 4K 这一传统稀疏方法往往因为代理开销而“反向减速”的中短长度下,CoSA 就已经实现了 1.11 倍的正向加速;而在上下文扩展到 128K 时,注意力算子本身的加速比达到了惊人的 4.93 倍。更为关键的是,这种算子级收益无缝传导至了整个预填充阶段——128K 下的首字生成延迟(TTFT)缩减了 2.53 倍,性能表现大幅优于其余同类基线。
拆解消融:重排如何实现“1+1 > 2”
为了厘清各个设计组件在整体性能中所扮演的角色,研究团队在 LongBench-v2 上进行了递进式消融实验(如材料中 Table 3 所示)。
当系统仅使用基础的二值掩码跳过(Base)时,模型准确率处于基线状态;引入 KAP 代理后,由于其能更好地识别并保留显著块,模型精度在同等预算下出现提升;随后若仅仅在底层叠加未经重排的常规内核跳过(In-Kernel Skipping),虽然稀疏度有所上升,但模型在 Qwen 上的准确率出现了一定幅度的回退。
转折点发生在最后一步:当正式启用基于页表重映射的“访问重排(KV Page Remapping)”机制后,趋势发生了戏剧性的反转。模型的准确率不仅彻底恢复,甚至在更紧凑的总体预算下反超了基线。这一现象直观地验证了协同设计的必要性:单靠底层硬件跳过,会受困于保守的运行最大值;单靠上层代理,又无法做出精准的微观过滤。只有当代理给出的优先级序列与内核的跳过条件咬合在一起时,硬件才能以最激进的姿态跳过冗余,同时绝不伤及重要语义。
对大模型长文本推理部署的启示
在大模型系统优化的演进历史中,算法研究者往往专注于设计更巧妙的采样与相似度度量网络,而系统工程师则专注于在 Triton 或 CUDA 层面将硬件张量核心的搬运流水线压榨到极致。两者之间长期隔着一道简单的二值交互屏障。
CoSA 的突破提供了一种新的范式参考:在大模型长文本推理领域,软硬件的单向优化正在逼近边际效益的红线。未来的高性能注意力后端,必然需要向算法层暴露更多的执行自由度(如动态遍历顺序与页表重构能力);而前置的高层策略,也必须深刻理解硬件执行在线统计量时的物理特性,以最低的元数据交换成本为硬件扫清执行障碍。随着长上下文与多 Agent 系统的持续铺开,这种代理与内核协同设计的架构思路,有望成为新一代大模型推理引擎的标准底层组件。