Context Compaction:Agent上下文压缩等价单向通信,实测Anthropic近乎盲猜
Context Compaction Theory
当现代 AI Agent 被赋予写代码、排查系统故障乃至自动完成科研任务的重变职责时,它们正在遭遇一个隐秘却致命的瓶颈:长会话导致的记忆过载。大语言模型无论宣称支持 100 万还是 200 万 Token 的上下文,其单次推理的计算与注意力容量终归有界。更糟糕的是,学术界早已观察到“上下文腐化”(Context Rot)现象——即便输入没有超出理论上限,随着上下文变长,模型的推理质量也会发生肉眼可见的衰退。
ArXiv URL:https://arxiv.org/abs/2608.01326
为了让 Agent 在数百轮的复杂交互中继续运转,工程界不约而同地采用了一种妥协策略:上下文压缩(Context Compaction)。当累积状态即将塞满窗口时,系统会自动抛弃一部分历史,或者调用大模型写一段摘要来代替完整记录。尽管 Claude Code、Cursor、OpenAI Codex 等主流系统全面部署了这项机制,但它究竟丢失了多少信息、理论极限在哪里,此前从未有人进行过严格的理论刻画。
这篇名为《Context Compaction Theory》的研究首次打破了这一盲区。作者将工程界混乱的启发式压缩实践抽象为两套严格的数学博弈,并给出了一个极具洞察力的结论:上下文生成式压缩在数学上完全等价于经典理论计算机科学中的“单向通信复杂度”(One-Way Communication Complexity)。这意味着数十年来理论通信领域积累的所有上下界定理,可以直接迁移到 Agent 的设计中。更具警示意味的是,作者将该理论作为标尺去测试 Anthropic 生产级的上下文压缩接口,发现在判断“某个条目之前是否出现过”这一极其基础的任务上,大模型压缩后的表现竟然跌落到了接近抛硬币盲猜的水平。
Agent 永续运行的阿喀琉斯之踵
在探究理论之前,必须先厘清为什么当代 Agent 无法回避上下文压缩。
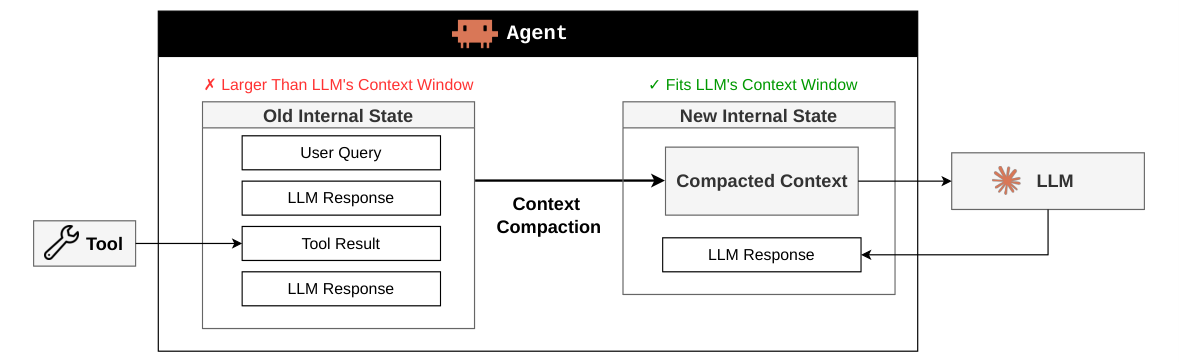
如上图所示,一个标准的 Agent 包含三项核心操作:调用大模型推理、执行外部工具、更新内部状态。内部状态中不仅记载了用户指令,还包含了每一轮大模型的思考、工具调用的返回内容以及中间执行的报错日志。当这些内容不断累加,它迟早会撞上模型输入长度的物理墙。
有人会提出质疑:现代存储介质极其廉价,Agent 难道不能把全部历史完整保存在本地数据库中,每次需要调用大模型时,再重新对全量历史做一次检索或动态摘要吗?
这在工程经济学和系统延迟上是一笔注定破产的账。论文以 Claude 3.5 级别的模型给出了一个真实的测算:假设一个长代码重构任务累积了 80 万 Token 的历史,为了向模型发起下一次决策请求,系统如果每次都基于这 80 万 Token 重新提炼一份 10 万 Token 的摘要,按行业公开的 Token 计价,单次提炼仅输入与输出费用就高达 13 美元。更致命的是速度——大模型以每秒约 65 个 Token 的速度输出,生成 10 万 Token 的摘要单项耗时就长达 26 分钟。哪怕利用 Prompt Caching(提示词缓存)压低输入成本,高昂的生成耗时也注定让实时交互化为泡影。
因此,所有生产级 Agent 实际采用的都是“覆水难收”的不可逆状态更新:一旦触发阈值(例如占用窗口达到 95%),Agent 就会执行一次上下文压缩,用压缩后的精简文本永久替换掉工作内存里的原始历史。在后续轮次中,大模型只能看到压缩后的切片。这就带来了一个严峻问题:一旦压缩算法在此刻扔掉了某条关键线索,这条线索就在大模型的认知世界里彻底蒸发了。
两种博弈模型:选择与生成
为了在数学上严谨度量信息的去留,论文没有将上下文简单视作一段平铺直叙的 Token 流,而是将其抽象为一个由离散“信息项”(Items)组成的集合 $\mathcal{X}={x_1, \dots, x_N}$。这些项可以是函数声明、局部报错堆栈、设计决策,或是某条特定的用户约束。每个项占据一定的空间大小 $s(x_i)$,而整个压缩结果必须受到严格的预算 $B$ 的限制。
基于工业界的具体做法,作者构建了两个与环境对抗的决策博弈:
第一类是上下文选择博弈(Context Selection Game)。这对应了最直观的剪裁算法:选择器(Selector)必须从原始集合 $\mathcal{X}$ 中挑出一个子集 $S \subseteq \mathcal{X}$ 加以保留,使得子集总大小不超过 $B$。在此之后,外部环境(或对抗者)会发起一个查询 $q$,系统必须仅凭留下的子集 $S$ 计算出答案。这类算法的典型代表包括 LangChain 的历史消息截断、OpenAI Assistants API 的滑动窗口截断,以及 Aider 基于 PageRank 挑选关键符号表的图选择方案。在这类方案中,算法只能做“全有或全无”的保全,且保留各项的代价是简单的线性累加 $\sum_{x_i \in S} s(x_i)$。
第二类是上下文生成博弈(Context Generation Game)。选择算法的限制在于它不能改变表达方式,但人类和现代 LLM 更擅长的是重写与提炼。在生成博弈中,算法被放宽为一对编码器与解码器(Condenser 与 Interpreter)。生成算法被允许输出任意长度不超过 $B$ 的新消息,这段消息甚至可以包含原始历史中从未出现过的全新 Token。当代最核心的大模型摘要压缩(LLM-based Summarization),例如 Codex 与 Claude Code 的总结机制,本质上都属于这一范畴。
作者特别指出,生成算法在信息表达上具有天然的降维优势。举个简单的例子,如果算法决定保留绝大部分条目,选择算法必须原封不动地付出全部条目的长度代价,而生成算法理论上只需要使用一个长度为 $N$ 的 0-1 掩码比特串,就能以极小的开销指示集合归属。这种形式化的切分,为后续证明两种策略的能力鸿沟奠定了基石。
核心定理:压缩与单向通信复杂度的严密等价
论文最硬核的理论贡献,在于揭示了上下文生成博弈与分布式计算理论中经典“单向通信复杂度”之间的同构关系。
在单向通信模型中,有两个参与者:爱丽丝(Alice)持有输入 $X$,鲍勃(Bob)持有输入 $Y$;爱丽丝只能向鲍勃发送一条单向消息 $M$,随后鲍勃必须根据消息 $M$ 和自己的输入 $Y$ 计算出目标函数的值。在此过程中,满足一定误差容忍度下所必须发送的最短消息长度,即为该问题的单向通信复杂度。
论文通过严密推导证明:上下文生成博弈中满足特定误差上限所必需的最小上下文预算 $B$,与该问题诱导出的单向通信复杂度完全相等。 在这个映射中:
-
压缩器扮演了爱丽丝,它审视整个上下文历史 $\mathcal{X}$,并将其压缩为一条受限消息;
-
解释器扮演了鲍勃,它接收压缩消息,并在未来遭遇未知的查询 $q$ 时尝试给出回答;
-
上下文窗口的物理限制,本质上就是信道单向传输的带宽瓶颈。
这个看似抽象的等价定理带来了极其重大的理论红利:大模型研究者不再需要从零发明分析工具,通信复杂度领域数十年来针对各种查询任务所证明的数学下界、信息论不等式,可以一字不差地直接搬来作为上下文压缩的物理铁律。
顺着这一定理,论文进一步证明:上下文选择算法所构成的集合 $\mathsf{SELECT}$,仅仅是单向通信协议中极其狭窄的一个受限子集。更关键的是,作者在理论上构造了一类具体的查询任务,证明了生成算法所需的预算严格小于选择算法,其渐进差距可以达到 $\Theta(\log n)$ 级别。也就是说,在数学层面上,“总结重写”相对于“机械剪裁”确实存在不可逾越的信息压缩优势。
照妖镜:Anthropic 生产级端点实测失灵
既然大模型生成的压缩摘要在理论上具备更高的信息密度上限,那么今天顶尖 AI 实验室在生产环境中交付的上下文压缩能力,究竟发挥出了理论上限的几成?
作者设计了一个兼具理论优雅与工程严酷度的对比实验:集合成员查询(Set Membership Queries)。
在计算机科学中,如果任务目标仅仅是记录一组条目并在未来回答“某元素是否在集合内”,理论最优的通信方案是大家耳熟能详的经典数据结构——布隆过滤器(Bloom Filter)。布隆过滤器可以在极小的空间开销下,以恒定的假阳性率(False Positive Rate)完美完成单向通信。按照论文确立的等价性,布隆过滤器的大小就是该任务上下文压缩的理论最优基准线。
研究团队调用了 Anthropic 部署的上下文压缩端点,在其上下文中注入了 15,000 个离散条目,并明确在系统提示中告知该压缩端点:“后续将仅对该上下文进行集合成员归属查询”,给予模型最充分的针对性优化空间。压缩完成后,研究者针对集合内的元素与集合外的干扰项发起大量归属测试,并将模型的表现与相同压缩体积的布隆过滤器进行横向对比。
实验结果令人大跌眼镜:
-
在消耗相同上下文预算的情况下,布隆过滤器能够保持极低的判定错误率,稳定区分已知元素与未知元素;
-
而 Anthropic 的生产级上下文压缩端点,在经过多轮信息浓缩后,面对成员查询时的错误率竟然一路飙升到了接近 50%——这意味着模型的判定水准已经与抛硬币的随机猜测别无二致。
为了排除“大模型只是没有理解查询语义”这一干扰因素,作者还布置了严格的对照实验:如果直接把未压缩的原始上下文输入给大模型,模型能够以极高的精度识别元素是否存在。这决定性地证明,精度的灾难性垮塌并非源于模型的推理或指令遵循短板,而完全源于上下文压缩算法在大步幅删减信息时,发生了严重的、不可逆的信息蒸发。大模型在输出洋洋洒洒、看似语义通顺的高层概括文本时,实际上已经把底层具体的实体细节丢失殆尽。
重新审视长上下文与 Agent 系统架构
这项理论工作对当下大模型行业火热的 Agent 架构演进,泼了一记清醒的冷水,同时也指明了未来的演进路径。
首先,它破除了对“大模型端到端自总结”的盲目迷信。目前工业界无论是代码助手还是日常对话 Agent,在面临窗口溢出时,最偷懒也最普遍的做法就是调用自身写一段 Summary。然而实验表明,大语言模型生成的自然语言摘要极度偏向高层抽象语义,对离散、精确细节的保留能力极其匮乏。如果 Agent 正在执行的是大型代码重构、变量交叉依赖追踪或精密数据分析,这种“看似写得很好、实则细节全无”的摘要会在随后的执行步中瞬间诱发幻觉与断流。
其次,它为 Agent 的混合记忆系统(Hybrid Memory Architecture)提供了严谨的理论支撑。未来的上下文压缩绝不可能依靠单一的大模型生成来包打天下。既然布隆过滤器等经典数据结构在特定通信子任务上已经达到了渐进最优,那么一个成熟的 Agent 系统应当将状态细分为不同类型:对于宏观意图与架构规划,采用大模型的语义压缩生成;对于变量表、调用痕迹、状态集合等确定性信息,应当退行到专用数据结构或受限选择器,将其序列化为极致紧凑的专用格式后再送入上下文。
从混乱的启发式 Prompt 调优,到将其严格映射为理论计算机科学的成熟分支,《Context Compaction Theory》为 Agent 系统的底层工程划定了一条清晰的物理边界。在通往更长、更复杂的自主执行道路上,我们不仅需要更大的上下文窗口,更需要在每一轮压缩中清醒地知道:为了留住明天的思考,我们今天究竟在以何种代价抛弃过去。